जो कुछ आप देखते, सुनते और पढ़ते हैं, वह सब एक साथ आपके दिमाग तक पहुँचता है। मल्टीमोडल AI मॉडल भी इसी तरह काम करते हैं। एक समय में एक ही तरह का इनपुट प्रोसेस करने की बजाय, वे टेक्स्ट, इमेज, ऑडियो और कभी-कभी वीडियो को एक साथ ग्रहण करते हैं और सब कुछ मिलाकर रीज़निंग करते हैं। यह एक बदलाव असल दुनिया में AI की क्षमताओं को पूरी तरह बदल देता है।
एक मॉडल, कई इंद्रियाँ
ज़्यादातर लोगों का AI से पहला परिचय एक टेक्स्ट टूल के रूप में हुआ: सवाल पूछें, जवाब में टेक्स्ट पाएँ। लिखने के कामों के लिए यह अच्छा तरीका है। लेकिन असली दुनिया टेक्स्ट से नहीं बनी है। यह तस्वीरों, आवाज़ों, दस्तावेज़ों, चार्ट, चेहरों और दृश्यों से बनी है। जो मॉडल सिर्फ़ शब्द पढ़ सकता है, वह हमेशा आधा अंधा रहता है।
मल्टीमोडल AI इस समस्या को हल करता है। यह अलग-अलग तरह के इनपुट से मिलने वाली जानकारी को एक साथ जोड़ता है, ताकि एक ही मॉडल वे सभी संकेत संभाल सके जिन्हें इंसान स्वाभाविक रूप से इस्तेमाल करते हैं।
टेक्स्ट तो बस शुरुआत है
सिर्फ़ टेक्स्ट वाले मॉडल (जैसे शुरुआती GPT-2 या BERT) वाक्य पढ़ते हैं और जवाब बनाते हैं। भाषा के भीतर पैटर्न पहचानने में वे शक्तिशाली हैं। लेकिन उनकी सीमा कठोर है: उन्हें तस्वीर दिखाएँ तो वे उसे देख नहीं सकते।
मल्टीमोडल मॉडल अलग-अलग फ़ॉर्मेट के इनपुट स्वीकार करते हैं। वे आपका सवाल पढ़ सकते हैं, आपकी अटैच की गई इमेज देख सकते हैं, आपकी रिकॉर्ड की गई ऑडियो क्लिप सुन सकते हैं, और तीनों को ध्यान में रखते हुए एक सुसंगत, संदर्भ-आधारित जवाब दे सकते हैं।
यह बदलाव सिर्फ़ नए फ़ीचर जोड़ने का नहीं है। इससे बदल जाता है कि मॉडल असल में क्या समझता है।
"मोडैलिटी" का असली मतलब
AI रिसर्च में, "मोडैलिटी" डेटा का एक प्रकार है जिसकी अपनी सांख्यिकीय संरचना होती है। हर मोडैलिटी का एक अलग प्रतिनिधित्व होता है:
| मोडैलिटी | फ़ॉर्मेट | AI इसे कैसे पढ़ता है |
|---|
| टेक्स्ट | टोकन / शब्द | टोकनाइज़ेशन + एम्बेडिंग |
| इमेज | पिक्सल ग्रिड | पैच-आधारित विज़ुअल एन्कोडिंग |
| ऑडियो | वेवफ़ॉर्म / स्पेक्ट्रोग्राम | फ़्रीक्वेंसी फ़ीचर एक्सट्रैक्शन |
| वीडियो | फ़्रेम सीक्वेंस | टेम्पोरल + स्पेशियल एन्कोडिंग |
| दस्तावेज़ | टेक्स्ट + लेआउट + इमेज | संयुक्त OCR + विज़ुअल रीज़निंग |
जब कोई मॉडल "मल्टीमोडल" होता है, तो उसने इनमें से दो या अधिक मोडैलिटी प्रोसेस करना सीखा होता है और, सबसे अहम बात, उनके बीच अर्थ को आपस में जोड़ना सीखा होता है।
यह कई इनपुट कैसे प्रोसेस करता है
मल्टीमोडल AI के पीछे की इंजीनियरिंग सुनने में लगने से ज़्यादा दिलचस्प है। यह सिर्फ़ "टेक्स्ट मॉडल में कैमरा जोड़ देना" नहीं है। आर्किटेक्चर ऐसा बनाना पड़ता है कि अलग-अलग मोडैलिटी के प्रतिनिधित्व एक-दूसरे से बात कर सकें।
केंद्र में ट्रांसफ़ॉर्मर
आज के लगभग सभी मल्टीमोडल मॉडल ट्रांसफ़ॉर्मर आर्किटेक्चर पर बने हैं, जिसे पहली बार 2017 के पेपर "Attention Is All You Need" में पेश किया गया था। ट्रांसफ़ॉर्मर किसी सीक्वेंस के अलग-अलग हिस्सों पर ध्यान देने में माहिर हैं। पता चला है कि "सीक्वेंस" का मतलब शब्द ही हो, ज़रूरी नहीं। इसका मतलब इमेज पैच, ऑडियो फ़्रेम या वीडियो सेगमेंट भी हो सकता है।
GPT-4o जैसे विज़न-लैंग्वेज मॉडल में, ट्रांसफ़ॉर्मर एक संयुक्त सीक्वेंस लेता है जिसमें टेक्स्ट टोकन और एन्कोड की गई इमेज पैच दोनों शामिल होते हैं। अटेंशन मैकेनिज़्म टेक्स्ट टोकन को इमेज टोकन को "देखने" देता है और इसका उल्टा भी होता है। यही क्रॉस-अटेंशन वह जगह है जहाँ मल्टीमोडल रीज़निंग असल में होती है।
हर इंद्रिय के लिए एन्कोडर
ट्रांसफ़ॉर्मर डेटा देखने से पहले, हर मोडैलिटी एक मोडैलिटी-विशिष्ट एन्कोडर से गुजरती है:
- इमेज एक विज़ुअल एन्कोडर से गुजरती हैं (अक्सर ViT, यानी Vision Transformer पर आधारित), जो इमेज को 16x16 पिक्सल के पैच में तोड़ता है और हर पैच को एम्बेडिंग वेक्टर में बदलता है।
- ऑडियो एक स्पेक्ट्रोग्राम एन्कोडर से गुजरता है, जो ध्वनि तरंगों को फ़्रीक्वेंसी-टाइम प्रतिनिधित्व में बदलता है।
- टेक्स्ट मानक टोकनाइज़ेशन इस्तेमाल करता है: शब्दों को सबवर्ड टोकन में बाँटा जाता है और एम्बेडिंग वेक्टर से मैप किया जाता है।
ये सभी एम्बेडिंग एक ही डायमेंशनल स्पेस में पहुँच जाती हैं। उसके बाद ट्रांसफ़ॉर्मर उन्हें बराबर मानकर चलता है। मॉडल को पता नहीं होता कि वह "देख" रहा है या "पढ़" रहा है। वह बस एक एकीकृत सीक्वेंस में पैटर्न पर ध्यान दे रहा होता है।
टेक्स्ट, इमेज और ऑडियो एक साथ
जब कोई मल्टीमोडल मॉडल मिला-जुला इनपुट पाता है, तो वह हर मोडैलिटी को अलग-अलग क्रम में प्रोसेस करके बाद में नतीजे नहीं जोड़ता। वह सब कुछ संदर्भ में प्रोसेस करता है, जिससे हर मोडैलिटी बाकी की व्याख्या को प्रभावित कर सके।
विज़न और लैंग्वेज साथ-साथ
मल्टीमोडल AI की यह सबसे विकसित शाखा है। विज़न-लैंग्वेज मॉडल (VLMs) इमेज-टेक्स्ट जोड़ियों के विशाल डेटासेट पर प्रशिक्षित होते हैं। यह प्रशिक्षण मॉडल को विज़ुअल कंटेंट को भाषाई विवरणों से जोड़ना सिखाता है।
इस प्रशिक्षण के व्यावहारिक नतीजों में शामिल हैं:
- इमेज कैप्शनिंग: मॉडल जो देखता है उसका स्वाभाविक भाषा में वर्णन करता है।
- विज़ुअल क्वेश्चन आंसरिंग (VQA): किसी इमेज के बारे में सवाल पूछें, और एक ठोस जवाब पाएँ।
- दस्तावेज़ की व्याख्या: चार्ट और टेबल वाली PDF पढ़ें और उसके डेटा को समझाएँ।
- दृश्य-आधारित रीज़निंग: "इस फ़ैक्टरी की तस्वीर में आपको कौन-सी सुरक्षा समस्याएँ दिखती हैं?"
Gemini 3 Pro और Claude Opus 4.7 दोनों विज़न-लैंग्वेज सक्षम मॉडल हैं जो PicassoIA पर उपलब्ध हैं। वे बातचीत के हिस्से के रूप में इमेज स्वीकार करते हैं और उसकी सामग्री पर गहराई से रीज़निंग करते हैं।
💡 टिप: विज़न-लैंग्वेज मॉडल इस्तेमाल करते समय अपने सवाल में साफ़-साफ़ बताएँ। "इस इमेज में क्या है?" एक सामान्य कैप्शन देगा। "इस इमेज में दिख रहे फ़र्नीचर में किन मटीरियल का इस्तेमाल हुआ है?" एक सटीक, काम आने लायक जवाब देगा।
ऑडियो एक प्रमुख इनपुट के रूप में
ऑडियो मोडैलिटी का सपोर्ट विज़न जितना सार्वभौमिक नहीं है, लेकिन तेज़ी से बढ़ रहा है। जिन मॉडल में स्पीच-टू-टेक्स्ट बना होता है, वे बोले गए सवाल रियल टाइम में ट्रांसक्राइब कर सकते हैं। नए आर्किटेक्चर कच्ची ऑडियो वेवफ़ॉर्म को सीधे प्रोसेस करते हैं, और शब्दों के साथ लहजा, भावना और बोलने वाले की पहचान भी पकड़ते हैं।
यह फ़र्क मायने रखता है। जो टेक्स्ट-only सिस्टम पहले ऑडियो ट्रांसक्राइब करता है, वह शब्दों के अलावा सब कुछ खो देता है: झिझक, ज़ोर, आसपास का संदर्भ। एक सच्चा मल्टीमोडल ऑडियो मॉडल वह समृद्धि बनाए रखता है।
मल्टीमोडल AI कहाँ दिखता है
सिंगल-मोडल से मल्टीमोडल AI की ओर बदलाव कोई अमूर्त बात नहीं है। यह पहले से ही वे टूल बदल रहा है जिन्हें लोग रोज़ इस्तेमाल करते हैं।
हेल्थकेयर और रेडियोलॉजी
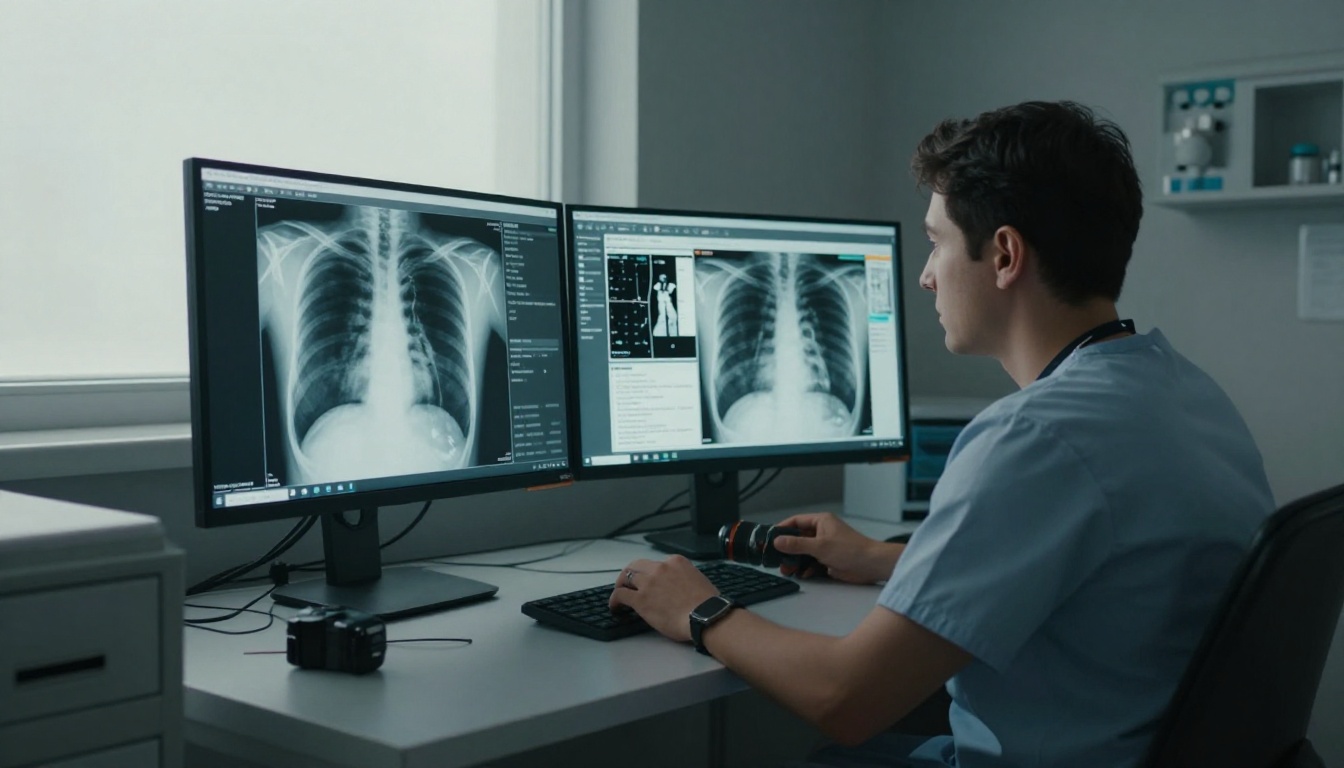
रेडियोलॉजिस्ट हर हफ़्ते हज़ारों मेडिकल इमेज देखते हैं। मल्टीमोडल AI मरीज़ के लिखित क्लिनिकल नोट्स को X-ray या MRI स्कैन के साथ पढ़ सकता है और विसंगतियों या संभावित निदान को चिह्नित कर सकता है। मॉडल इमेज और टेक्स्ट दोनों पर एक साथ रीज़निंग करता है, और ठीक इसी तरह एक कुशल डॉक्टर काम करता है।
Granite Vision 3.3 2B एक कॉम्पैक्ट विज़न-लैंग्वेज मॉडल है जो चार्ट और टेबल पढ़ता है, जिससे यह इंश्योरेंस, लीगल और क्लिनिकल रिसर्च जैसे दस्तावेज़-भारी उद्योगों के लिए एक व्यावहारिक शुरुआती विकल्प बनता है।
क्रिएटिव टूल्स और डिज़ाइन
टेक्स्ट-टू-इमेज जनरेशन क्रिएटिव पेशेवरों के लिए मल्टीमोडल AI का सबसे दिखने वाला रूप है। PicassoIA Image, GPT Image 2 और Seedream 4.5 जैसे मॉडल एक टेक्स्ट प्रॉम्प्ट इनपुट के रूप में लेते हैं और आउटपुट में फोटोरियलिस्टिक इमेज बनाते हैं। परिभाषा के हिसाब से यह मल्टीमोडल है: भाषा विज़ुअल जनरेशन को चलाती है।
इससे आगे, Qwen Image Edit Plus जैसे टूल इमेज और टेक्स्ट निर्देश, दोनों स्वीकार करते हैं, फिर इमेज को उसी के अनुसार बदलते हैं। यह मल्टीमोडल इनपुट से मल्टीमोडल आउटपुट चलाने वाला पूरा चक्र है।
फ़ोन पर रोज़मर्रा के ऐप
किसी विदेशी भाषा के रेस्टोरेंट मेन्यू की ओर अपना फ़ोन कैमरा तानें। एक मल्टीमोडल AI इमेज पढ़ता है, टेक्स्ट पहचानता है, उसका अनुवाद करता है और व्यंजनों के बारे में समझाता है। यह एक रियल-टाइम क्रॉस-मोडल पाइपलाइन है: विज़न इनपुट, भाषा आउटपुट।
यही तकनीक इन कामों में भी इस्तेमाल होती है:
- एक्सेसिबिलिटी टूल्स जो दृष्टिहीन उपयोगकर्ताओं के लिए विज़ुअल दृश्यों का वर्णन करते हैं।
- शॉपिंग ऐप जो फ़ोटो से प्रोडक्ट पहचानते हैं।
- सर्च जो टाइप किए गए कीवर्ड की जगह अपलोड की गई इमेज को क्वेरी के रूप में स्वीकार करता है।
Kimi K2.5 को "Chat AI That Reads Text and Images" के रूप में वर्णित किया गया है, जो इसे रोज़मर्रा के कामों के लिए एक व्यावहारिक मल्टीमोडल असिस्टेंट बनाता है। Gemini 3 Flash मोबाइल-स्पीड इंटरैक्शन के लिए विज़न के साथ तेज़ AI चैट देता है।
सिंगल-मोडल बनाम मल्टीमोडल: असली फ़र्क
यह देखना कि मल्टीमोडल AI क्या कर सकता है, तब ज़्यादा साफ़ होता है जब आप इसकी सीधी तुलना सिंगल-मोडल विकल्पों से करते हैं।
| क्षमता | सिर्फ़ टेक्स्ट वाला AI | मल्टीमोडल AI |
|---|
| टेक्स्ट सवालों के जवाब देना | हाँ | हाँ |
| इमेज का वर्णन करना | नहीं | हाँ |
| ऑडियो ट्रांसक्राइब करना | नहीं (अतिरिक्त टूल के बिना) | हाँ |
| चार्ट पर रीज़निंग करना | नहीं | हाँ |
| टेक्स्ट से इमेज एडिट करना | नहीं | हाँ |
| वीडियो कंटेंट की व्याख्या करना | नहीं | कुछ मॉडल |
| स्कैन किया हुआ दस्तावेज़ पढ़ना | नहीं | हाँ |
| क्रॉस-मोडल रीज़निंग | नहीं | हाँ |
दाईं ओर का कॉलम सिर्फ़ "ज़्यादा फ़ीचर" नहीं दर्शाता। यह AI और दुनिया के बीच एक गुणात्मक रूप से अलग रिश्ते को दर्शाता है।
अभी के शीर्ष मल्टीमोडल मॉडल
मल्टीमोडल AI की दुनिया बहुत तेज़ी से बदलती है। ये वे आर्किटेक्चर हैं जो अभी सबसे उन्नत स्थिति को परिभाषित करते हैं।
GPT-4o और OpenAI का तरीका
GPT-4o ("o" का मतलब omni) OpenAI का पहला नेटिव रूप से मल्टीमोडल मॉडल था: इसे अलग-अलग कंपोनेंट जोड़कर नहीं, बल्कि टेक्स्ट, विज़न और ऑडियो पर एंड-टू-एंड प्रशिक्षित किया गया था। इस एंड-टू-एंड प्रशिक्षण का मतलब है कि मोडैलिटी बदलते समय मॉडल को "ट्रांसलेशन बॉटलनेक" का सामना नहीं करना पड़ता। इसका उत्तराधिकारी, GPT-5, सभी मोडैलिटी पर बेहतर रीज़निंग के साथ इस आर्किटेक्चर को और आगे ले जाता है।
इमेज जनरेशन के लिए, GPT Image 2 उसी गहरी भाषा क्षमता को विज़ुअल आउटपुट की तरफ़ लाता है, और जटिल टेक्स्ट विवरणों को सटीकता से दर्शाने वाली इमेज बनाता है।
💡 टिप: जब आपका इमेज प्रॉम्प्ट कई सब्जेक्ट के बीच जटिल संबंध बताता हो, तब GPT Image 2 इस्तेमाल करें। इस मॉडल का भाषा आधार कंपोज़िशनल निर्देशों को ज़्यादातर शुद्ध डिफ़्यूज़न मॉडल से बेहतर संभालता है।
Gemini का आर्किटेक्चर
Google का Gemini परिवार शुरू से ही मल्टीमोडल बनाया गया था। Gemini 3 Pro एक ही कॉन्टेक्स्ट विंडो में टेक्स्ट, इमेज, ऑडियो और कोड संभालता है। इसका मतलब है कि आप एक ही संदेश में एक फ़ोटो, डेटा की एक टेबल और टेक्स्ट का एक पैराग्राफ़ साझा कर सकते हैं और उनकी संयुक्त व्याख्या माँग सकते हैं।
Gemini 3 Flash कुछ क्षमता की कीमत पर गति को चुनता है, जिससे यह उन रियल-टाइम ऐप्स के लिए व्यावहारिक बनता है जहाँ लेटेंसी मायने रखती है।
Claude की विज़ुअल रीज़निंग
Claude Opus 4.7 को "AI That Codes, Sees, and Reasons" के रूप में वर्णित किया गया है। Anthropic के मॉडल कॉन्ट्रैक्ट, तकनीकी डायग्राम और रिसर्च पेपर जैसे विज़ुअल दस्तावेज़ों को सावधानी और बारीकी से पढ़ने में खास तौर पर मज़बूत हैं, इसलिए जब जटिल सामग्री पर सटीकता कच्ची रफ़्तार से ज़्यादा मायने रखती है, तब यह एक ठोस विकल्प है।
Claude 4 Sonnet एक तेज़, हल्के फ़ॉर्म फ़ैक्टर में वही विज़न क्षमताएँ देता है।
PicassoIA पर मल्टीमोडल मॉडल कैसे इस्तेमाल करें
PicassoIA आपको टेक्स्ट-प्लस-विज़न रीज़निंग और टेक्स्ट-टू-इमेज जनरेशन, दोनों के लिए पूरी रेंज के मल्टीमोडल AI मॉडल का सीधा एक्सेस देता है। इन्हें काम में लगाने का तरीका यह है:
विज़न-लैंग्वेज मॉडल इस्तेमाल करना:
- PicassoIA पर Large Language Models कलेक्शन खोलें।
- विज़न सपोर्ट वाला मॉडल चुनें: GPT-4o, Gemini 3 Pro, या Claude Opus 4.7।
- प्रॉम्प्ट एरिया में अपने टेक्स्ट संदेश के साथ एक इमेज फ़ाइल अटैच करें।
- इमेज, दस्तावेज़ या चार्ट के बारे में एक साफ़ सवाल पूछें। मॉडल दोनों इनपुट पर रीज़निंग करता है।
टेक्स्ट-टू-इमेज जनरेशन इस्तेमाल करना:
- PicassoIA पर Text to Image सेक्शन खोलें।
- एक मॉडल चुनें: सामान्य उपयोग के लिए PicassoIA Image, कंपोज़िशनल प्रॉम्प्ट के लिए GPT Image 2, या 4K आउटपुट के लिए Seedream 4.5।
- अपने दृश्य, रोशनी, सब्जेक्ट और स्टाइल का वर्णन करता एक विस्तृत टेक्स्ट प्रॉम्प्ट लिखें।
- मॉडल आपके टेक्स्ट को एक फोटोरियलिस्टिक इमेज में बदल देता है, जो मल्टीमोडल प्रक्रिया का एक आदर्श उदाहरण है।
खास पैरामीटर टिप्स:
- विज़न-लैंग्वेज कामों के लिए, सबसे तेज़ प्रोसेसिंग के लिए इमेज 5MB से छोटी रखें।
- टेक्स्ट-टू-इमेज के लिए, फ़ोटोरियलिज़्म बेहतर करने के लिए कैमरा और रोशनी के खास वर्णन जोड़ें ("85mm lens, f/1.8, golden hour light")।
- Wan 2.7 Image Pro प्लेटफ़ॉर्म पर सबसे ज़्यादा रिज़ॉल्यूशन वाला विकल्प है, जो प्रिंट-क्वालिटी आउटपुट के लिए उपयुक्त है।
अब खुद आज़माएँ
मल्टीमोडल AI के बारे में पढ़ना एक बात है। जब आप सच में किसी मॉडल को एक इमेज दिखाकर कुछ ग़ैर-मामूली सवाल पूछते हैं, तब कॉन्सेप्ट जल्दी समझ आते हैं। Gemini 3 Pro से फ़ोटो में किसी न्यूट्रिशन लेबल को पढ़ने को कहें। GPT-4o से PDF के किसी चार्ट की व्याख्या करवाएँ। PicassoIA Image से एक ही वाक्य को विस्तृत फ़ोटोरियलिस्टिक दृश्य में बदलवाएँ।
इनमें से हर बातचीत आपको दिखाती है कि "मल्टीमोडल" का व्यवहार में असल मतलब क्या है: यह कोई बज़वर्ड नहीं, बल्कि इस बात में एक बुनियादी बदलाव है कि AI दुनिया को कैसे देखता और उस पर कैसे प्रतिक्रिया देता है। टूल मौजूद हैं, एक्सेस मुफ़्त है, और सीखने का सफ़र उसी पल शुरू हो जाता है जब आप अपनी पहली इमेज अपलोड करते हैं।