Todo equipo que lanza una función de IA choca con el mismo muro en pocas semanas. Un proveedor te limita las peticiones a las 2 a. m., otro cambia el nombre de un modelo, finanzas pregunta por qué la factura se duplicó y tu código ya arrastra cuatro SDK distintos. Un gateway de API de IA soluciona esto al colocarse entre tu app y todos los proveedores de modelos, de modo que el enrutamiento, los reintentos, los presupuestos y los logs estén centralizados en un solo lugar en vez de repartirse entre servicios.
Este artículo compara las mejores opciones de gateway de API de IA de código abierto con Vercel AI Gateway, la opción alojada a la que muchos equipos recurren primero. Verás qué hace bien cada una, dónde flaquea y cómo elegir sin dedicarle un mes a probarlas. Todo lo que aquí se describe refleja la documentación de sus mantenedores, así que revisa las páginas actuales de licencia y precios antes de comprometerte.
Qué hace realmente un gateway de IA
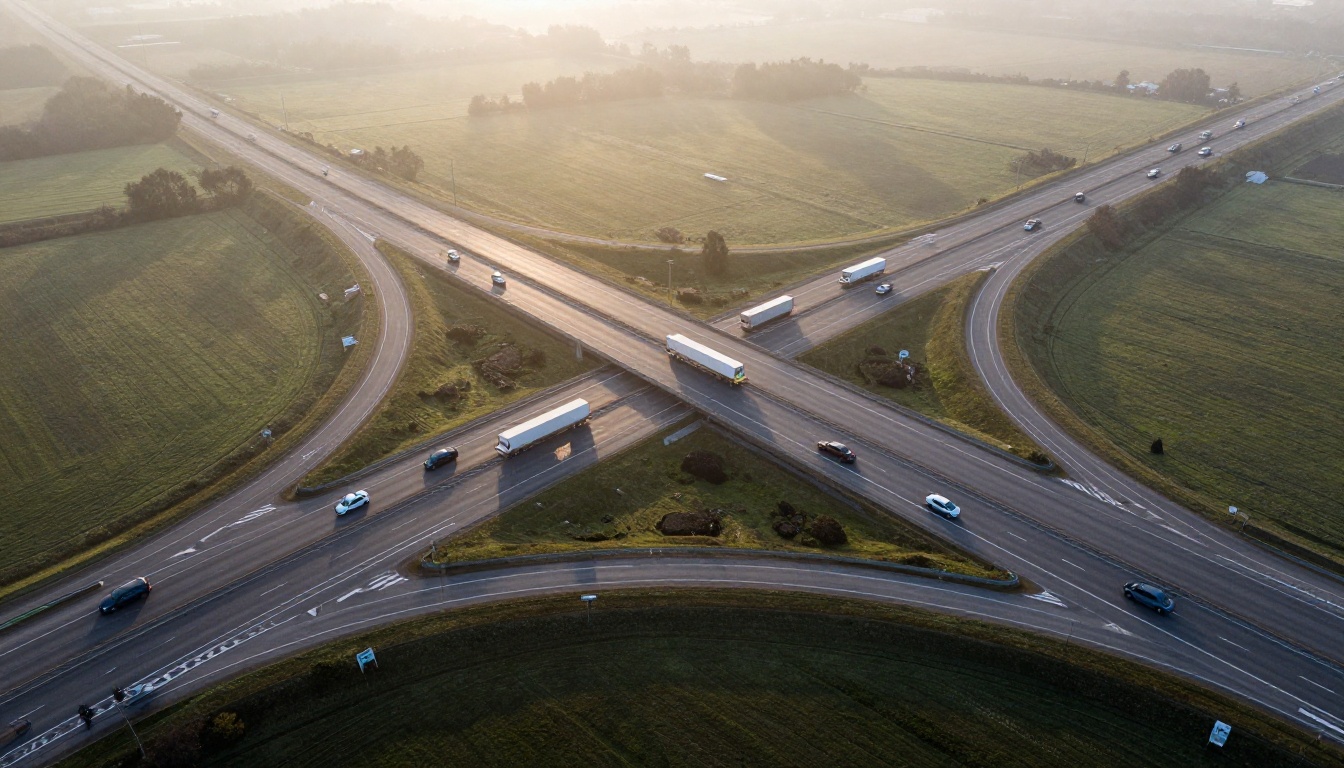
Piensa en un gateway como un cruce de tráfico para las peticiones a modelos. Tu aplicación envía una sola petición en un único formato, normalmente con la misma forma que la API de chat de OpenAI. El gateway decide qué proveedor y qué modelo deben responder, reenvía la llamada y devuelve una respuesta normalizada. Tu código nunca necesita saber quién la atendió.
Por eso también verás esta capa llamada LLM gateway, LLM proxy o API unificada. Los nombres cambian, pero la función es la misma: una puerta de entrada y muchos proveedores en la salida.
Un solo endpoint, muchos proveedores
Sin un gateway, cada proveedor trae su propio SDK, su esquema de autenticación, sus códigos de error y su formato de streaming. Añadir un segundo proveedor supone una segunda integración, y un tercero, una tercera. Con un gateway cambias una URL base y un nombre de modelo. Por eso, la mayoría de gateways anuncian un endpoint compatible con OpenAI: las librerías cliente existentes siguen funcionando, y el proveedor que está detrás puede cambiar un martes por la tarde sin necesidad de desplegar nada.
Las funciones que cumple
Un gateway sólido cumple seis funciones:
- Enrutamiento: envía cada petición al proveedor, modelo o región adecuados, con balanceo de carga entre varios despliegues.
- Fallbacks: cambia a un respaldo cuando la primera opción falla o agota el tiempo de espera.
- Presupuestos y limitación de tasa: fija topes de gasto y de peticiones por equipo, proyecto o usuario.
- Caché: devuelve respuestas almacenadas para prompts repetidos, para reducir costo y latencia.
- Observabilidad: registra el uso de tokens, la latencia, el costo y los errores de cada llamada.
- Guardrails: filtra o redacta la información sensible, tanto de entrada como de salida, antes de que salga de tu red.
💡 Consejo: no necesitas las seis desde el primer día. La mayoría de equipos empieza con enrutamiento, fallbacks y logs, y añade presupuestos después de la primera factura que los sorprenda.
¿Código abierto o gateway alojado?
Esta es la primera bifurcación del camino, y pesa más que cualquier tabla de funciones.
Cuándo gana el código abierto
Los gateways de código abierto se ejecutan en tu propia infraestructura, así que los prompts y las respuestas pasan por máquinas que controlas. Esa es la razón principal por la que los equipos sujetos a regulación eligen un proxy autoalojado. Puedes leer el código, corregir un error, añadir un proveedor que nadie soporta todavía y evitar una tarifa por petición cobrada por el propio gateway. La contrapartida es el trabajo operativo: tú te encargas de las actualizaciones, el escalado, el almacenamiento de secretos y la alerta de las 3 a. m. cuando el proxy se cae.
Las credenciales merecen un cuidado especial. Un gateway guarda las credenciales de todos los proveedores que usas, y eso lo convierte en un objetivo muy valioso. Guárdalas en un gestor de secretos en lugar de archivos de entorno, rótalas según un calendario y da a cada equipo interno una credencial virtual, para que las credenciales reales del proveedor nunca salgan del gateway.
Cuándo sale mejor un servicio alojado
Un gateway alojado elimina ese trabajo. No hay nada que desplegar, ninguna base de datos que respaldar ni ningún clúster que parchear. Si tu equipo son tres desarrolladores que sacan un producto, una hora dedicada a un gateway gestionado vale más que una semana afinando un proxy. El costo es depender de la disponibilidad, las políticas de datos y los precios de un proveedor, además de tener menos margen para adaptar el comportamiento a tus necesidades.
| Pregunta | Código abierto, autoalojado | Servicio alojado |
|---|
| ¿Quién lo gestiona? | Tu equipo | El proveedor |
| ¿Por dónde viajan los prompts? | Dentro de tu red | A través del proveedor |
| Tiempo de configuración | Horas o días | Minutos |
| Comportamiento personalizado | Editar código o plugins | Solo ajustes |
| Trabajo continuo | Actualizaciones, escalado, monitorización | Casi nada |
💡 Revisa la licencia: que un repositorio sea público no significa siempre que sea de código abierto en su totalidad. Varios gateways mantienen funciones como el inicio de sesión único, el control de acceso basado en roles o los logs de auditoría bajo una licencia comercial aparte. Lee el archivo de licencia, no solo el README.
Los mejores gateways de API de IA de código abierto
Estos son los proyectos que la mayoría de equipos incluye en su lista corta. Las licencias y el número de proveedores cambian con frecuencia, así que considera esta sección un mapa, no un contrato.
LiteLLM: el mayor soporte de proveedores
LiteLLM suele ser el primer nombre que aparece. Se distribuye como librería de Python y como servidor proxy, habla el formato de OpenAI y soporta una larga lista de proveedores, lo que la convierte en la vía más rápida para tener un gateway funcionando. El núcleo tiene licencia MIT. El inicio de sesión único para más de unos pocos usuarios, el control de acceso basado en roles, los logs de auditoría y algunos callbacks de moderación están detrás de una licencia empresarial aparte, así que revisa esa frontera antes de planificar con ellos. Como se ejecuta sobre Python, los equipos con un volumen muy alto de peticiones suelen hacer benchmarks con cuidado y escalan horizontalmente.
Portkey y Bifrost, comparados
Portkey Gateway tiene licencia MIT y mantiene los fallbacks, los reintentos y los guardrails en el núcleo de código abierto. Encaja con equipos que quieren controles de políticas sin comprar una plataforma completa desde el primer día.
Bifrost está escrito en Go, se publica bajo Apache 2.0 y anuncia una sobrecarga inferior al milisegundo. Las pruebas independientes no siempre coinciden con esa cifra destacada, así que haz tu propia prueba de carga con el tamaño de tus prompts antes de confiar en cualquier afirmación sobre latencia. Su lista de proveedores es más corta que la de LiteLLM, lo cual está bien si solo necesitas los grandes proveedores.
Envoy, Helicone y Kong
Envoy AI Gateway está construido sobre Envoy y tiene licencia Apache 2.0. Encaja con equipos que ya usan Kubernetes y tratan Envoy como su capa de tráfico, ya que el tráfico de modelos sigue entonces las mismas políticas, el mismo trazado y las mismas costumbres de despliegue que cualquier otro servicio.
Helicone tiene licencia Apache 2.0 y nació como herramienta de observabilidad, así que sus vistas de logs y de costos son un punto fuerte. Kong añade enrutamiento de IA mediante plugins sobre su gateway de API de código abierto, lo cual resulta cómodo si Kong ya gestiona el acceso a tus otras APIs. Revisa qué plugins de IA incluye la edición gratuita antes de depender de ellos.
| Gateway | Licencia | Mejor opción para |
|---|
| LiteLLM | Núcleo MIT, nivel empresarial de pago | Arranque rápido, muchos proveedores |
| Portkey Gateway | MIT | Guardrails y reintentos |
| Bifrost | Apache 2.0 | Baja sobrecarga, stack en Go |
| Envoy AI Gateway | Apache 2.0 | Plataformas Kubernetes |
| Helicone | Apache 2.0 | Visibilidad de costos y uso |
| Kong | Núcleo Apache 2.0, algunos plugins de pago | Equipos que ya usan Kong |
Vercel AI Gateway de cerca
Vercel AI Gateway es la contraparte alojada, y el planteamiento honesto es sencillo: no es de código abierto. El AI SDK que lo rodea sí lo es, pero el gateway en sí es un servicio gestionado. Estás eligiendo comodidad frente a control, y para muchísimos equipos esa es la contrapartida correcta.
Qué obtienes
Una credencial y un endpoint te dan acceso a modelos de muchos proveedores. Expone endpoints compatibles con OpenAI y compatibles con Anthropic, así que los clientes existentes normalmente solo necesitan una nueva URL base. Además, obtienes enrutamiento entre proveedores, reintentos automáticos, fallbacks de modelo, logs de gasto y latencia, y presupuestos por credencial.
En cuanto al costo, Vercel afirma que cobra el precio de lista del proveedor sin recargo sobre los tokens, también cuando traes tus propias credenciales de proveedor (a menudo llamadas BYOK). Los equipos nuevos reciben un pequeño crédito mensual gratuito, de $5 según figura al escribir este artículo. Consulta la página de precios actual, porque los importes de los créditos cambian.
Vercel también informa de que, en su tráfico de producción hasta abril de 2026, el fallback automático salvó aproximadamente el 3,5 % de las peticiones que habían fallado por un error, un límite de tasa o un tiempo de espera en la primera ruta. Esa cifra procede del proveedor, así que léela como una señal de lo habituales que son los problemas con los proveedores, no como una promesa para tu carga de trabajo.
Dónde se queda corto
- No se puede autoalojar. Los prompts pasan por un proveedor, lo que puede descartarlo bajo políticas de datos estrictas.
- Basado en créditos. Los créditos prepagados encajan con equipos pequeños, pero los departamentos financieros a veces quieren facturas y gasto comprometido.
- Menos personalización. Ajustas la configuración, no modificas el código.
- Dependencia leve. Como la API es compatible con OpenAI, irse suele implicar solo cambiar la URL base, pero tus logs y presupuestos se quedan atrás.
Enrutamiento, fallbacks y reintentos
Los fallbacks son la función que por sí sola justifica un gateway. Una cadena de fallbacks enumera modelos en orden: prueba el principal y, si devuelve un error 5xx, un límite de tasa 429 o agota el tiempo de espera, pasa al siguiente. Una cadena razonable mezcla proveedores, no solo modelos, porque una caída del proveedor tumba todos los modelos que aloja.
Una cadena práctica para una función de chat podría verse así:
- Principal: Claude Sonnet 5 para respuestas donde la calidad es lo más importante.
- Primer respaldo: GPT 5.6 Terra en un proveedor distinto.
- Último recurso: Gemini 3.5 Flash por velocidad cuando todo lo demás va mal.
Cada gateway de este artículo puede expresar una cadena así en su configuración. Lo que cambia es cuánto control tienes sobre cuándo se activa: por código de estado, por umbral de latencia, por el resultado de un filtro de contenido o por una regla personalizada.
El balanceo de carga es el hermano discreto de los fallbacks. Si tienes dos despliegues del mismo modelo, por ejemplo en regiones distintas o con cuentas diferentes, el gateway puede repartir el tráfico entre ambos según un peso y dejar de enviarle tráfico al que vaya lento. Esto también eleva tu límite de tasa efectivo, ya que cada cuenta tiene su propio techo.
Los reintentos necesitan límites
Los reintentos ayudan con errores de corta duración, pero conllevan riesgos. Una petición reintentada puede cobrarse dos veces si la primera llamada terminó tarde, y una tormenta de reintentos puede hundir aún más a un proveedor que ya va mal. Mantén estos hábitos:
- Usa dos o tres reintentos como máximo, con backoff exponencial y jitter aleatorio.
- Fija los tiempos de espera por modelo. Un modelo de razonamiento puede pensar legítimamente durante un minuto, mientras que un modelo de chat pequeño debería responder en segundos.
- Planifica el streaming. Una vez que los primeros tokens han llegado al usuario, un fallback a mitad de stream no puede reiniciar la respuesta sin que se note, así que decide pronto cómo lo gestionará tu interfaz.
Controlar el costo y el uso
Las facturas de los modelos crecen en silencio. Un gateway convierte el gasto en algo que puedes fijar y vigilar.
Presupuestos por equipo y proyecto
Emite una credencial virtual por equipo, proyecto o cliente y asígnale un presupuesto mensual y un límite de tasa. Cuando un script desbocado entra en bucle, agota su propio presupuesto y se detiene, en lugar de vaciar la cuenta compartida. Etiqueta cada petición para que el log responda a "quién gastó qué" sin una hoja de cálculo de por medio. Tanto LiteLLM como Vercel AI Gateway ofrecen presupuestos, y con cualquier herramienta autoalojada debes confirmar si la función de presupuestos está incluida en la edición gratuita.
Después, usa el gateway para asignar cada modelo a su tarea:
- Envía la clasificación, el etiquetado y los resúmenes cortos a un modelo pequeño y rápido, como Gemini 3.5 Flash o Qwen3.7-Plus.
- Reserva los modelos de gama alta para código, razonamiento y textos de cara al cliente, por ejemplo Kimi K2.6 para trabajo de estilo agente.
- Ejecuta modelos de pesos abiertos como Llama 4 Maverick Instruct, Deepseek v3.1 o GPT OSS 120B detrás del mismo endpoint que las APIs de pago, lo que te da un nivel de costo bajo.
- Guarda en caché los prompts repetidos, como las respuestas de preguntas frecuentes, y avisa al 80 % de un presupuesto en lugar de al 100 %.
💡 Registra con cuidado: Guardar cada prompt facilita la depuración, pero también puede almacenar datos personales. Decide las reglas de retención y de redacción antes de activar el registro completo del contenido.
Cómo elegir en una tarde
No necesitas un mes de investigación. Necesitas una imagen clara de tus restricciones y una prueba corta.
Una tabla de decisión sencilla
| Tu situación | Empieza por |
|---|
| Equipo pequeño, quiere tenerlo funcionando hoy | Vercel AI Gateway |
| Los prompts deben quedarse dentro de tu red | LiteLLM o Portkey Gateway, autoalojados |
| Ya usas Kubernetes y Envoy | Envoy AI Gateway |
| Lo que más importa es la latencia añadida por petición | Haz un benchmark de Bifrost frente a LiteLLM |
| Kong ya gestiona tus APIs | Plugins de IA de Kong |
| La visibilidad de costos y uso es lo primero | Helicone |
Después, ejecuta la misma prueba de cinco pasos con tus dos mejores opciones:
- Apunta una app de pruebas a la URL base del gateway.
- Envía mil prompts realistas, no ejemplos de juguete.
- Revoca las credenciales del proveedor principal y confirma que el fallback se activa.
- Comprueba que los logs muestran tokens, costo y errores por petición.
- Mide la latencia añadida frente a llamar al proveedor directamente.
Tres errores que conviene evitar
- Elegir solo por benchmarks. Un gateway que añade un milisegundo en el laboratorio puede añadir más una vez que se activan los logs, la autenticación y los guardrails.
- Saltarse la prueba de fallback. Desconecta el proveedor principal y observa qué pasa. Una cadena sin probar es una suposición.
- Tratar el gateway como único punto de fallo. Ejecuta al menos dos instancias detrás de un balanceador de carga, o mantén en tu código una ruta directa al proveedor como interruptor de emergencia.
Olvídate de la fontanería y crea
No todo proyecto necesita un gateway. Si tu objetivo es producir texto, imágenes o video en lugar de operar infraestructura, PicassoIA te ofrece los modelos directamente en el navegador, sin proxy que desplegar ni credenciales que rotar.
En el terreno del lenguaje puedes probar Claude Sonnet 5, GPT 5.6 Terra y Gemini 3.5 Flash uno al lado del otro, la misma comparación que un gateway te permitiría automatizar con un script. Para imágenes, envía un mismo prompt por Seedream 5 Pro, GPT Image 2 y Flux 2 Max y quédate con el resultado que más te guste. Para movimiento, Seedance 2.0 convierte texto en video con audio integrado, Veo 3.1 Fast genera clips rápidos en 1080p y Kling v3 Video busca planos de estilo cinematográfico.
Elige un prompt que de verdad necesites, ejecútalo en tres modelos y compara los resultados. Ese hábito te enseña más sobre la calidad y el costo de los modelos que cualquier tabla de benchmarks. Abre Picasso IA, elige un modelo y crea tu primera imagen o video hoy mismo.


