Chaque équipe qui livre une fonctionnalité d’IA se heurte au même mur en quelques semaines. Un fournisseur vous impose une limite de débit à 2 h du matin, un autre renomme un modèle, la finance demande pourquoi la facture a doublé, et votre base de code embarque désormais quatre SDK différents. Une passerelle d’API IA règle ce problème en se plaçant entre votre application et chaque fournisseur de modèles : le routage, les nouvelles tentatives, les budgets et les logs sont regroupés en un seul endroit au lieu d’être dispersés entre plusieurs services.
Cet article compare les meilleures options de passerelle d’API IA open source avec Vercel AI Gateway, le choix hébergé que beaucoup d’équipes privilégient en premier. Vous verrez ce que fait bien chacune, où elle pèche, et comment choisir sans mener un comparatif d’un mois. Tout ce qui figure ici reflète la documentation de leurs mainteneurs : vérifiez donc les pages de licence et de tarifs actuelles avant de vous engager.
Ce que fait réellement une passerelle IA
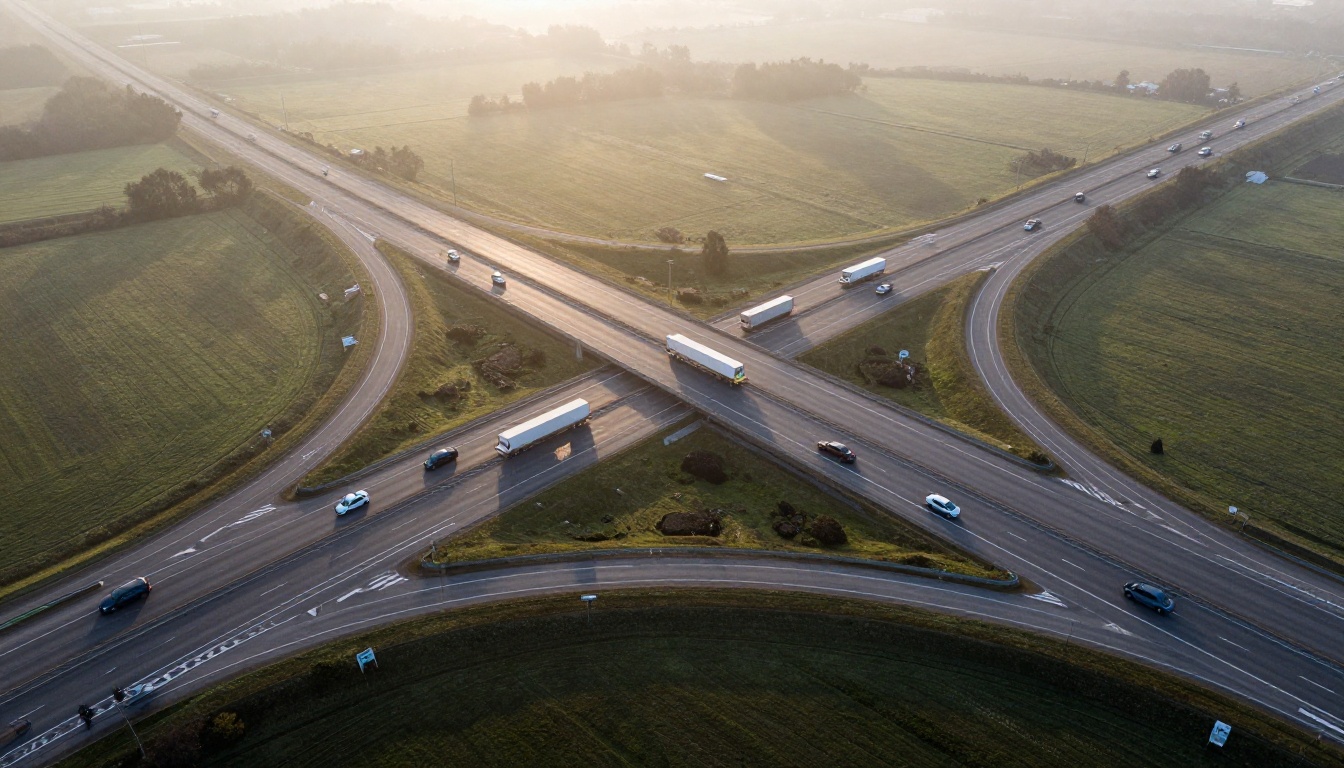
Imaginez une passerelle comme un échangeur de trafic pour les requêtes vers les modèles. Votre application envoie une seule requête dans un format unique, généralement la même structure que l’API de chat d’OpenAI. La passerelle décide quel fournisseur et quel modèle doivent répondre, transmet l’appel et renvoie une réponse normalisée. Votre code n’a jamais besoin de savoir qui a traité la requête.
C’est pourquoi cette couche est aussi appelée passerelle LLM, proxy LLM ou API unifiée. Les noms diffèrent, le rôle reste le même : une seule entrée, plusieurs fournisseurs en sortie.
Un seul point d’accès, plusieurs fournisseurs
Sans passerelle, chaque fournisseur apporte son propre SDK, son propre schéma d’authentification, ses propres codes d’erreur et son propre format de streaming. Ajouter un deuxième fournisseur implique une deuxième intégration, et un troisième, une troisième. Avec une passerelle, vous modifiez une URL de base et un nom de modèle. La plupart des passerelles annoncent pour cette raison un point d’accès compatible OpenAI : les bibliothèques clientes existantes continuent de fonctionner, et le fournisseur derrière peut changer un mardi après-midi sans déploiement.
Les tâches qu’elle prend en charge
Une passerelle solide assure six tâches :
- Routage : envoyer chaque requête au bon fournisseur, modèle ou région, avec répartition de charge entre plusieurs déploiements.
- Fallbacks : basculer sur une solution de secours quand le premier choix renvoie une erreur ou dépasse le délai.
- Budgets et limitation de débit : plafonner les dépenses et le nombre de requêtes par équipe, projet ou utilisateur.
- Mise en cache : renvoyer des réponses stockées pour les prompts répétés afin de réduire les coûts et la latence.
- Observabilité : journaliser l’usage des tokens, la latence, le coût et les erreurs pour chaque appel.
- Garde-fous : filtrer ou masquer les données sensibles en entrée et en sortie avant qu’elles ne quittent votre réseau.
💡 Conseil : Inutile de tout activer dès le premier jour. La plupart des équipes commencent par le routage, les fallbacks et les logs, puis ajoutent les budgets après la première facture surprenante.
Open source ou passerelle hébergée ?
C’est le premier embranchement, et il pèse plus que n’importe quel tableau de fonctionnalités.
Quand l’open source l’emporte
Les passerelles open source tournent sur votre propre infrastructure : les prompts et les réponses transitent donc par des machines que vous contrôlez. C’est la principale raison pour laquelle les équipes soumises à une réglementation choisissent un proxy auto-hébergé. Vous pouvez lire le code, corriger un bug, ajouter un fournisseur que personne ne prend encore en charge, et éviter des frais par requête facturés par la passerelle elle-même. Le compromis est un travail opérationnel : vous gérez les mises à jour, la montée en charge, le stockage des secrets et l’astreinte de 3 h du matin quand le proxy tombe.
Les identifiants demandent une attention particulière. Une passerelle détient les identifiants de chaque fournisseur que vous utilisez, ce qui en fait une cible de grande valeur. Stockez-les dans un gestionnaire de secrets plutôt que dans des fichiers d’environnement, renouvelez-les selon un calendrier, et attribuez à chaque équipe interne un identifiant virtuel afin que les vrais identifiants des fournisseurs ne sortent jamais de la passerelle.
Quand l’hébergement est plus malin
Une passerelle hébergée supprime ce travail. Rien à déployer, pas de base de données à sauvegarder, pas de cluster à mettre à jour. Si votre équipe compte trois développeurs qui livrent un produit, une heure passée sur une passerelle gérée vaut mieux qu’une semaine à régler un proxy. Le coût : dépendre de la disponibilité, des politiques de données et des tarifs d’un éditeur, et disposer de moins de marge pour adapter le comportement à vos besoins.
| Question | Open source, auto-hébergée | Service hébergé |
|---|
| Qui l’exploite ? | Votre équipe | L’éditeur |
| Où transitent les prompts ? | Dans votre réseau | Chez l’éditeur |
| Temps de mise en place | De quelques heures à quelques jours | Quelques minutes |
| Comportement personnalisé | Modifier le code ou les plugins | Réglages uniquement |
| Travail continu | Mises à jour, montée en charge, supervision | Presque aucun |
💡 Vérification de la licence : un dépôt public ne signifie pas toujours un open source complet. Plusieurs passerelles réservent des fonctionnalités comme l’authentification unique (SSO), le contrôle d’accès basé sur les rôles ou les journaux d’audit à une licence commerciale distincte. Lisez le fichier de licence, pas seulement le README.
Meilleures passerelles API IA open source
Ce sont les projets que la plupart des équipes présélectionnent. Les licences et le nombre de fournisseurs changent souvent : considérez cette section comme une carte, pas comme un contrat.
LiteLLM : la plus large prise en charge des fournisseurs
LiteLLM est généralement le premier nom qui vient à l’esprit. Il se présente sous forme de bibliothèque Python et de serveur proxy, parle le format OpenAI et prend en charge une longue liste de fournisseurs, ce qui en fait la voie la plus rapide vers une passerelle fonctionnelle. Le cœur est sous licence MIT. L’authentification unique au-delà d’un petit nombre d’utilisateurs, le contrôle d’accès basé sur les rôles, les journaux d’audit et certains callbacks de modération relèvent d’une licence entreprise distincte : vérifiez cette frontière avant de vous appuyer dessus. Comme il tourne sur Python, les équipes au volume de requêtes très élevé ont tendance à le soumettre à un benchmark rigoureux et à le monter en charge horizontalement.
Portkey et Bifrost comparés
Portkey Gateway est sous licence MIT et conserve les fallbacks, les nouvelles tentatives et les garde-fous dans son cœur open source. Il convient aux équipes qui veulent des contrôles de politique sans acheter une plateforme complète dès le premier jour.
Bifrost est écrit en Go, publié sous Apache 2.0 et annonce une surcharge inférieure à la milliseconde. Les tests indépendants ne concordent pas toujours avec ce chiffre annoncé : lancez donc votre propre test de charge avec la taille de vos prompts avant de vous fier à une affirmation sur la latence. Sa liste de fournisseurs est plus courte que celle de LiteLLM, ce qui convient si les grands éditeurs suffisent à vos besoins.
Envoy, Helicone et Kong
Envoy AI Gateway est construit sur Envoy et publié sous Apache 2.0. Il convient aux équipes qui exploitent déjà Kubernetes et considèrent Envoy comme leur couche de trafic, puisque le trafic des modèles suit alors les mêmes politiques, le même traçage et les mêmes habitudes de déploiement progressif que tous leurs autres services.
Helicone est sous licence Apache 2.0 et est issu de l’observabilité : ses vues sur les logs et les coûts constituent donc un point fort. Kong ajoute le routage IA via des plugins au-dessus de sa passerelle API open source, ce qui est pratique si Kong gère déjà vos autres API. Vérifiez quels plugins IA sont inclus dans l’édition gratuite avant de vous y fier.
| Passerelle | Licence | Idéale pour |
|---|
| LiteLLM | Cœur MIT, offre entreprise payante | Démarrage rapide, nombreux fournisseurs |
| Portkey Gateway | MIT | Garde-fous et nouvelles tentatives |
| Bifrost | Apache 2.0 | Faible surcharge, environnement Go |
| Envoy AI Gateway | Apache 2.0 | Plateformes Kubernetes |
| Helicone | Apache 2.0 | Visibilité sur les coûts et l’usage |
| Kong | Apache 2.0 pour le cœur, quelques plugins payants | Équipes déjà sur Kong |
Zoom sur Vercel AI Gateway
Vercel AI Gateway est l’équivalent hébergé, et pour être franc : il n’est pas open source. Le SDK d’IA qui l’entoure est open source, mais la passerelle elle-même est un service géré. Vous choisissez le confort plutôt que le contrôle, et pour bon nombre d’équipes c’est le bon compromis.
Ce que vous obtenez
Un seul identifiant et un seul point d’accès vous donnent accès aux modèles de nombreux fournisseurs. Il expose des points d’accès compatibles OpenAI et compatibles Anthropic, si bien que les clients existants n’ont généralement besoin que d’une nouvelle URL de base. Par-dessus, vous bénéficiez du routage entre fournisseurs, des nouvelles tentatives automatiques, des fallbacks de modèles, des logs de dépenses et de latence, et des budgets par identifiant.
Côté coût, Vercel indique appliquer le tarif public du fournisseur sans majoration sur les tokens, y compris lorsque vous apportez vos propres identifiants fournisseur (souvent appelés BYOK). Les nouvelles équipes reçoivent un petit crédit mensuel gratuit, affiché à $5 au moment de la rédaction. Consultez la page tarifaire actuelle, car les montants de crédit changent.
Vercel indique aussi que, sur l’ensemble de son trafic de production jusqu’en avril 2026, le fallback automatique a permis de sauver environ 3,5 % des requêtes qui avaient rencontré une erreur, une limite de débit ou un dépassement de délai sur la première route. Ce chiffre vient de l’éditeur : lisez-le comme un indicateur de la fréquence des incidents chez les fournisseurs, pas comme une promesse pour votre charge de travail.
Ses limites
- Non auto-hébergeable. Les prompts transitent par un éditeur, ce qui peut l’exclure sous des politiques de données strictes.
- Basé sur des crédits. Les crédits prépayés conviennent aux petites équipes, mais les services financiers réclament parfois des factures et des engagements de dépenses.
- Personnalisation réduite. Vous ajustez des réglages, vous ne modifiez pas le code.
- Enfermement léger. L’API étant compatible OpenAI, en partir se résume surtout à changer l’URL de base, mais vos logs et vos budgets restent sur place.
Routage, fallbacks et nouvelles tentatives
Les fallbacks sont la fonctionnalité qui justifie à elle seule une passerelle. Une chaîne de fallbacks liste des modèles dans l’ordre : essayez le principal et, s’il renvoie une erreur 5xx, une limite de débit 429 ou un dépassement de délai, passez au suivant. Une chaîne judicieuse mélange les fournisseurs, pas seulement les modèles, car une panne de fournisseur met hors service tous les modèles qu’il héberge.
Voici à quoi pourrait ressembler une chaîne pratique pour une fonctionnalité de chat :
- Principal : Claude Sonnet 5 pour les réponses sensibles à la qualité.
- Premier secours : GPT 5.6 Terra chez un autre fournisseur.
- Dernier recours : Gemini 3.5 Flash pour la rapidité quand tout le reste peine.
Toutes les passerelles de cet article peuvent exprimer une chaîne de ce type dans leur configuration. Ce qui varie, c’est le contrôle sur le moment où elle se déclenche : selon le code de statut, un seuil de latence, le résultat d’un filtre de contenu ou une règle personnalisée.
La répartition de charge est le discret cousin des fallbacks. Si vous disposez de deux déploiements du même modèle, par exemple dans des régions différentes ou sous des comptes différents, la passerelle peut répartir le trafic entre eux selon des poids et s’éloigner de celui qui ralentit. Cela relève aussi votre limite de débit effective, puisque chaque compte a son propre plafond.
Les nouvelles tentatives ont besoin de limites
Les nouvelles tentatives aident face aux erreurs passagères, mais elles comportent un risque. Une requête relancée peut être facturée deux fois si le premier appel s’est terminé tardivement, et une avalanche de relances peut enfoncer davantage un fournisseur en difficulté. Adoptez ces habitudes :
- Limitez-vous à deux ou trois nouvelles tentatives au maximum, avec un backoff exponentiel et un jitter aléatoire.
- Définissez des délais d’expiration par modèle. Un modèle de raisonnement peut légitimement réfléchir pendant une minute, alors qu’un petit modèle de chat doit répondre en quelques secondes.
- Anticipez le streaming. Dès que les premiers tokens sont parvenus à l’utilisateur, un fallback en cours de flux ne peut pas relancer discrètement la réponse : décidez donc tôt comment votre interface le gère.
Maîtriser les coûts et l’usage
Les factures des modèles grossissent silencieusement. Une passerelle transforme les dépenses en quelque chose que vous pouvez définir et surveiller.
Budgets par équipe et par projet
Attribuez un identifiant virtuel par équipe, projet ou client, et associez-lui un budget mensuel et une limite de débit. Quand un script qui s’emballe tourne en boucle, il épuise son propre budget et s’arrête, au lieu de vider le compte partagé. Étiquetez chaque requête pour que le journal réponde à « qui a dépensé quoi » sans exercice sur tableur. LiteLLM et Vercel AI Gateway proposent tous deux des budgets ; avec tout outil auto-hébergé, vérifiez si la fonctionnalité de budget fait partie de l’édition gratuite.
Utilisez ensuite la passerelle pour associer chaque modèle à sa tâche :
- Confiez la classification, l’étiquetage et les résumés courts à un petit modèle rapide comme Gemini 3.5 Flash ou Qwen3.7-Plus.
- Réservez les modèles haut de gamme au code, au raisonnement et aux textes destinés aux clients, par exemple Kimi K2.6 pour le travail de type agent.
- Faites tourner des modèles à poids ouverts comme Llama 4 Maverick Instruct, Deepseek v3.1 ou GPT OSS 120B derrière le même point d’accès que les API payantes, ce qui vous offre un palier à faible coût.
- Mettez en cache les prompts répétés, comme les réponses de FAQ, et déclenchez une alerte à 80 % d’un budget plutôt qu’à 100 %.
💡 Journalisez avec précaution : stocker chaque prompt facilite le débogage, mais peut aussi conserver des données personnelles. Définissez des règles de conservation et de masquage avant d’activer la journalisation complète du corps des requêtes.
Pas besoin d’un mois de recherche. Il vous faut une vision claire de vos contraintes et un seul test court.
Un tableau de décision simple
| Votre situation | Commencez par |
|---|
| Petite équipe, veut que ça marche aujourd’hui | Vercel AI Gateway |
| Les prompts doivent rester dans votre réseau | LiteLLM ou Portkey Gateway, auto-hébergés |
| Vous exploitez déjà Kubernetes et Envoy | Envoy AI Gateway |
| La latence ajoutée par requête compte avant tout | Lancer un benchmark de Bifrost face à LiteLLM |
| Kong gère déjà vos API | Plugins IA de Kong |
| La visibilité sur les coûts et l’usage passe en premier | Helicone |
Exécutez ensuite le même test en cinq étapes sur vos deux choix favoris :
- Pointez une application de test vers l’URL de base de la passerelle.
- Envoyez mille prompts réalistes, pas de simples exemples.
- Révoquez les identifiants du fournisseur principal et vérifiez que le fallback se déclenche.
- Vérifiez que les logs affichent les tokens, le coût et les erreurs pour chaque requête.
- Mesurez la latence ajoutée par rapport à un appel direct au fournisseur.
Trois erreurs à éviter
- Choisir uniquement sur des benchmarks. Une passerelle qui ajoute une milliseconde en laboratoire peut en ajouter davantage une fois la journalisation, l’authentification et les garde-fous activés.
- Sauter le test de fallback. Coupez l’accès au fournisseur principal et observez ce qui se passe. Une chaîne non testée reste une supposition.
- Faire de la passerelle un point de défaillance unique. Faites tourner au moins deux instances derrière un répartiteur de charge, ou gardez dans votre code un chemin direct vers le fournisseur comme bouton d’urgence.
Oubliez l’infrastructure et créez
Tous les projets n’ont pas besoin d’une passerelle. Si votre objectif est de produire du texte, des images ou des vidéos plutôt que d’exploiter une infrastructure, Picasso IA vous donne directement accès aux modèles dans le navigateur, sans proxy à déployer ni identifiant à renouveler.
Côté texte, vous pouvez essayer Claude Sonnet 5, GPT 5.6 Terra et Gemini 3.5 Flash côte à côte, la même comparaison qu’une passerelle vous permettrait d’automatiser. Pour les images, lancez un même prompt sur Seedream 5 Pro, GPT Image 2 et Flux 2 Max et gardez le résultat qui vous plaît le plus. Pour le mouvement, Seedance 2.0 transforme le texte en vidéo avec audio intégré, Veo 3.1 Fast produit des clips rapides en 1080p, et Kling v3 Video vise des plans cinématographiques.
Choisissez un prompt dont vous avez réellement besoin, testez-le sur trois modèles et comparez les résultats. Cette seule habitude vous en apprendra plus sur la qualité et le coût des modèles que n’importe quel tableau de benchmarks. Ouvrez Picasso IA, choisissez un modèle et créez dès aujourd’hui votre première image ou vidéo.


