हर वह टीम जो AI फ़ीचर लॉन्च करती है, कुछ हफ़्तों में एक ही दीवार से टकराती है। एक प्रोवाइडर रात 2 बजे आपकी रेट लिमिट कर देता है, दूसरा किसी मॉडल का नाम बदल देता है, फ़ाइनेंस टीम पूछती है कि इनवॉइस दोगुना क्यों हो गया, और आपके कोडबेस में अब चार अलग-अलग SDK हैं। AI API गेटवे आपके ऐप और हर मॉडल प्रोवाइडर के बीच बैठकर इस समस्या को हल करता है, ताकि रूटिंग, रीट्राई, बजट और लॉग सेवाओं में बिखरे रहने के बजाय एक ही जगह रहें।
यह लेख सबसे अच्छे AI API गेटवे ओपन सोर्स विकल्पों की तुलना Vercel AI Gateway से करता है, जो कई टीमों की पहली पसंद होता है। आप देखेंगे कि हर टूल किस काम में अच्छा है, कहाँ दिक्कत देता है, और एक महीने लंबी परीक्षा चलाए बिना कैसे चुनें। यहाँ की सारी जानकारी इन टूल्स के मेंटेनर्स द्वारा दिए गए डॉक्युमेंटेशन पर आधारित है, इसलिए चुनने से पहले मौजूदा लाइसेंस और प्राइसिंग पेज ज़रूर जाँच लें।
AI गेटवे असल में क्या करता है
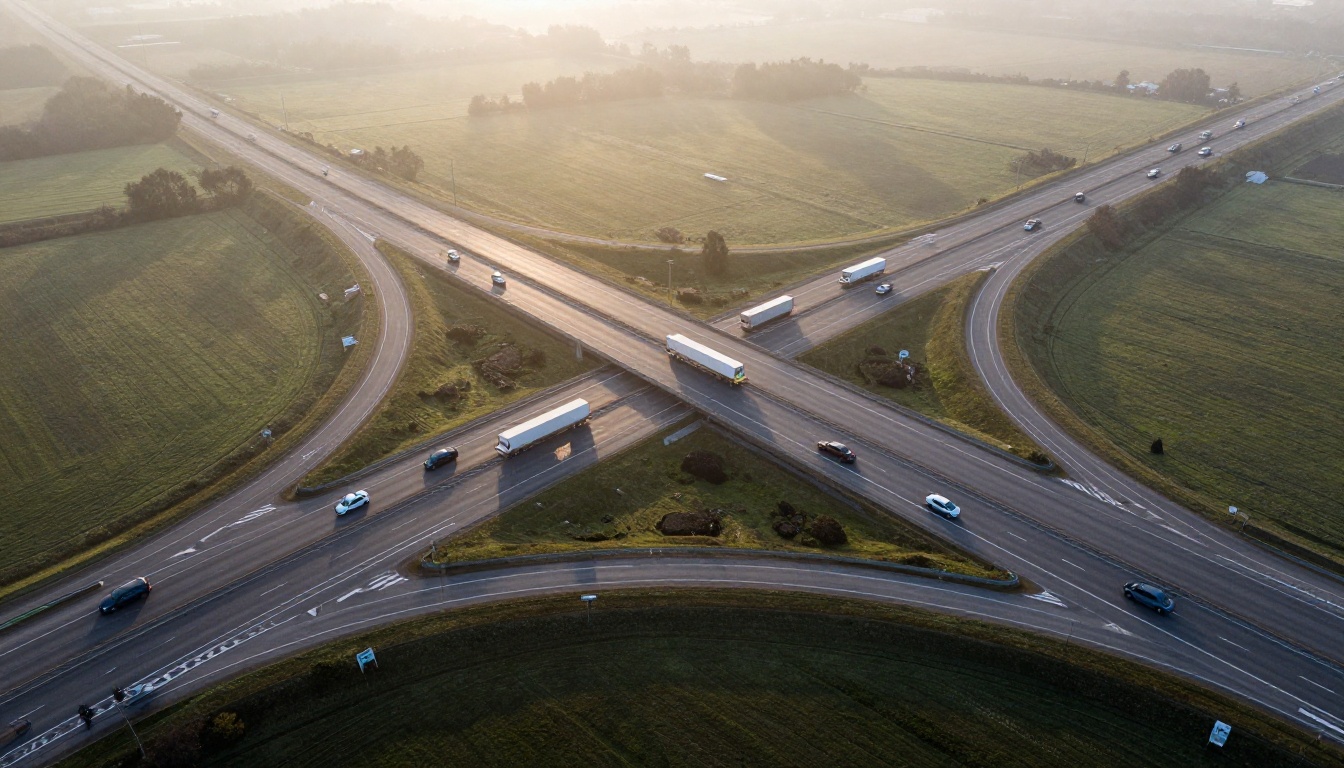
गेटवे को मॉडल रिक्वेस्ट के लिए ट्रैफ़िक इंटरचेंज की तरह सोचें। आपका एप्लिकेशन एक ही फ़ॉर्मेट में एक रिक्वेस्ट भेजता है, आमतौर पर OpenAI chat API जैसे ढाँचे में। गेटवे तय करता है कि कौन-सा प्रोवाइडर और कौन-सा मॉडल जवाब देगा, कॉल आगे भेजता है और एक नॉर्मलाइज़्ड रिस्पॉन्स लौटाता है। आपके कोड को यह जानने की ज़रूरत नहीं पड़ती कि रिक्वेस्ट किसने संभाली।
इसीलिए इस परत को LLM गेटवे, LLM प्रॉक्सी या unified API भी कहा जाता है। नाम अलग हैं, काम एक ही है: एक दरवाज़ा अंदर, कई प्रोवाइडर बाहर।
एक एंडपॉइंट, कई प्रोवाइडर
गेटवे के बिना हर प्रोवाइडर अपना SDK, अपनी ऑथेंटिकेशन स्कीम, अपने एरर कोड और अपना स्ट्रीमिंग फ़ॉर्मेट लेकर आता है। दूसरा प्रोवाइडर जोड़ने का मतलब दूसरा इंटीग्रेशन है, और तीसरे का मतलब तीसरा। गेटवे के साथ आप केवल बेस URL और मॉडल का नाम बदलते हैं। इसी वजह से ज़्यादातर गेटवे OpenAI compatible एंडपॉइंट का दावा करते हैं: मौजूदा क्लाइंट लाइब्रेरी चलती रहती हैं, और उनके पीछे का प्रोवाइडर किसी मंगलवार दोपहर को बदल सकता है, बिना डिप्लॉय किए।
यह किन कामों को संभालता है
एक मज़बूत गेटवे छह काम संभालता है:
- रूटिंग: हर रिक्वेस्ट को सही प्रोवाइडर, मॉडल या रीजन तक भेजना, और कई डिप्लॉयमेंट के बीच लोड बैलेंसिंग करना।
- फ़ॉलबैक: पहला विकल्प एरर देने या टाइम आउट होने पर बैकअप पर जाना।
- बजट और रेट लिमिटिंग: हर टीम, प्रोजेक्ट या यूज़र के लिए खर्च और रिक्वेस्ट दर की सीमा तय करना।
- कैशिंग: बार-बार आने वाले प्रॉम्प्ट के लिए सेव किए गए जवाब लौटाना, ताकि लागत और लेटेंसी घटे।
- ऑब्ज़र्वेबिलिटी: हर कॉल के लिए टोकन उपयोग, लेटेंसी, लागत और एरर लॉग करना।
- गार्डरेल: संवेदनशील इनपुट और आउटपुट को आपके नेटवर्क से बाहर जाने से पहले फ़िल्टर या रिडैक्ट करना।
💡 टिप: पहले दिन छहों की ज़रूरत नहीं है। ज़्यादातर टीमें रूटिंग, फ़ॉलबैक और लॉग से शुरू करती हैं, और पहले चौंकाने वाले इनवॉइस के बाद बजट जोड़ती हैं।
ओपन सोर्स या होस्टेड गेटवे?
यह पहला मोड़ है, और यह किसी भी फ़ीचर टेबल से ज़्यादा मायने रखता है।
ओपन सोर्स कब जीतता है
ओपन सोर्स गेटवे आपके अपने इंफ़्रास्ट्रक्चर पर चलते हैं, इसलिए प्रॉम्प्ट और रिस्पॉन्स उन मशीनों से गुज़रते हैं जिन्हें आप नियंत्रित करते हैं। रेगुलेटेड टीमें सेल्फ़-होस्टेड प्रॉक्सी सर्वर चुनने का यही मुख्य कारण मानती हैं। आप कोड पढ़ सकते हैं, बग ठीक कर सकते हैं, ऐसा प्रोवाइडर जोड़ सकते हैं जिसे अभी कोई सपोर्ट नहीं करता, और गेटवे की अपनी प्रति-रिक्वेस्ट फ़ीस से बच सकते हैं। इसकी कीमत ऑपरेशनल काम है: अपग्रेड, स्केलिंग, सीक्रेट्स का स्टोरेज और रात 3 बजे का वह पेज भी आपका है जब प्रॉक्सी गिर जाता है।
क्रेडेंशियल्स पर खास ध्यान देना चाहिए। गेटवे आपके इस्तेमाल किए गए हर वेंडर के प्रोवाइडर क्रेडेंशियल्स रखता है, इसलिए यह एक बड़ा टारगेट बन जाता है। इन्हें environment फ़ाइलों के बजाय सीक्रेट्स मैनेजर में रखें, समय-समय पर रोटेट करें, और हर इंटरनल टीम को एक वर्चुअल क्रेडेंशियल दें, ताकि असली प्रोवाइडर वाले क्रेडेंशियल कभी गेटवे से बाहर न जाएँ।
होस्टेड कब बेहतर है
होस्टेड गेटवे वह काम हटा देता है। कुछ डिप्लॉय नहीं करना होता, कोई डेटाबेस बैकअप नहीं लेना होता और कोई क्लस्टर पैच नहीं करना होता। अगर आपकी टीम में तीन डेवलपर हैं जो एक प्रोडक्ट शिप कर रहे हैं, तो मैनेज्ड गेटवे पर एक घंटा लगाना, प्रॉक्सी को ट्यून करने में एक हफ़्ता लगाने से बेहतर है। कीमत यह है कि आप वेंडर के अपटाइम, डेटा पॉलिसी और प्राइसिंग पर निर्भर हो जाते हैं, और व्यवहार को अपनी ज़रूरत के हिसाब से मोड़ने की गुंजाइश कम होती है।
| सवाल | ओपन सोर्स, सेल्फ़-होस्टेड | होस्टेड सेवा |
|---|
| इसे कौन चलाता है? | आपकी टीम | वेंडर |
| प्रॉम्प्ट कहाँ से गुज़रते हैं? | आपके नेटवर्क के अंदर | वेंडर के ज़रिए |
| सेटअप में समय | घंटे से दिन | मिनट |
| कस्टम व्यवहार | कोड या प्लगइन बदलें | केवल सेटिंग्स |
| लगातार चलने वाला काम | अपग्रेड, स्केलिंग, मॉनिटरिंग | लगभग कुछ नहीं |
💡 लाइसेंस जाँच: सार्वजनिक रिपॉज़िटरी का मतलब हमेशा पूरी तरह ओपन सोर्स नहीं होता। कई गेटवे सिंगल साइन-ऑन, रोल-आधारित एक्सेस कंट्रोल या ऑडिट लॉग जैसे फ़ीचर अलग कमर्शियल लाइसेंस के तहत रखते हैं। सिर्फ़ README नहीं, लाइसेंस फ़ाइल पढ़ें।
सर्वश्रेष्ठ ओपन सोर्स AI API गेटवे
ये वे प्रोजेक्ट हैं जिन्हें ज़्यादातर टीमें शॉर्टलिस्ट करती हैं। लाइसेंस और प्रोवाइडर की संख्या अक्सर बदलती है, इसलिए इस सेक्शन को एक नक्शे की तरह देखें, अनुबंध की तरह नहीं।
LiteLLM: सबसे व्यापक प्रोवाइडर सपोर्ट
LiteLLM अक्सर सबसे पहले सामने आने वाला नाम होता है। यह Python लाइब्रेरी और प्रॉक्सी सर्वर दोनों के रूप में आता है, OpenAI फ़ॉर्मेट बोलता है, और प्रोवाइडरों की लंबी सूची सपोर्ट करता है, जिससे यह एक काम करने वाले गेटवे तक सबसे तेज़ रास्ता बनता है। इसका कोर MIT लाइसेंस के तहत है। छोटी संख्या में उपयोगकर्ताओं से आगे का single sign-on, role-based access control, audit logs और कुछ moderation callbacks अलग enterprise लाइसेंस के पीछे हैं, इसलिए योजना बनाने से पहले वह सीमा जाँच लें। चूँकि यह Python पर चलता है, बहुत ज़्यादा रिक्वेस्ट वॉल्यूम वाली टीमें अक्सर इसका बेंचमार्क ध्यान से करती हैं और इसे हॉरिज़ॉन्टली स्केल करती हैं।
Portkey और Bifrost की तुलना
Portkey Gateway MIT लाइसेंस के तहत है और fallbacks, retries और guardrails को अपने ओपन सोर्स कोर में रखता है। यह उन टीमों के लिए ठीक है जो पूरा प्लेटफ़ॉर्म पहले दिन खरीदे बिना पॉलिसी कंट्रोल चाहती हैं।
Bifrost Go में लिखा गया है, Apache 2.0 के तहत जारी है, और sub-millisecond ओवरहेड का दावा करता है। स्वतंत्र परीक्षण हमेशा इस मुख्य आँकड़े से सहमत नहीं होते, इसलिए किसी भी लेटेंसी दावे पर भरोसा करने से पहले अपने प्रॉम्प्ट आकार के साथ अपना लोड टेस्ट चलाएँ। इसकी प्रोवाइडर सूची LiteLLM से छोटी है, जो ठीक है अगर आपको बस प्रमुख वेंडर चाहिए।
Envoy, Helicone और Kong
Envoy AI Gateway Envoy पर बना है और Apache 2.0 के तहत लाइसेंस्ड है। यह उन टीमों के लिए फ़िट बैठता है जो पहले से Kubernetes चलाती हैं और Envoy को अपनी ट्रैफ़िक परत मानती हैं, क्योंकि तब मॉडल ट्रैफ़िक भी बाकी हर सर्विस जैसी ही पॉलिसी, tracing और rollout आदतों का पालन करता है।
Helicone Apache 2.0 लाइसेंस्ड है और ऑब्ज़र्वेबिलिटी से विकसित हुआ है, इसलिए इसके लॉगिंग और लागत व्यू मज़बूत पक्ष हैं। Kong अपने ओपन सोर्स API गेटवे के ऊपर प्लगइन के ज़रिए AI routing जोड़ता है, जो सुविधाजनक है अगर Kong पहले से आपकी बाकी APIs के सामने है। किसी भी AI प्लगइन पर भरोसा करने से पहले जाँच लें कि कौन-से AI प्लगइन फ़्री एडिशन में मिलते हैं।
| गेटवे | लाइसेंस | सबसे उपयुक्त |
|---|
| LiteLLM | MIT कोर, पेड enterprise टियर | तेज़ शुरुआत, कई प्रोवाइडर |
| Portkey Gateway | MIT | गार्डरेल और रीट्राई |
| Bifrost | Apache 2.0 | कम ओवरहेड, Go-आधारित टूल्स |
| Envoy AI Gateway | Apache 2.0 | Kubernetes प्लेटफ़ॉर्म |
| Helicone | Apache 2.0 | लागत और उपयोग की दृश्यता |
| Kong | Apache 2.0 कोर, कुछ पेड प्लगइन | जो टीमें पहले से Kong पर हैं |
Vercel AI Gateway को करीब से देखें
Vercel AI Gateway होस्टेड विकल्प है, और ईमानदार परिचय सीधा है: यह ओपन सोर्स नहीं है। इसके आसपास का AI SDK ओपन सोर्स है, लेकिन गेटवे खुद एक मैनेज्ड सेवा है। आप नियंत्रण के बदले सुविधा चुन रहे हैं, और कई टीमों के लिए यह सही सौदा है।
आपको क्या मिलता है
एक क्रेडेंशियल और एक एंडपॉइंट से आपको कई प्रोवाइडरों के मॉडलों तक पहुँच मिलती है। यह OpenAI compatible और Anthropic compatible एंडपॉइंट देता है, इसलिए मौजूदा क्लाइंट्स को आमतौर पर सिर्फ़ नए बेस URL की ज़रूरत होती है। इसके ऊपर आपको प्रोवाइडर रूटिंग, अपने-आप होने वाले रीट्राई, मॉडल फ़ॉलबैक, खर्च और लेटेंसी लॉग, और हर क्रेडेंशियल के लिए बजट मिलते हैं।
लागत के बारे में, Vercel कहता है कि वह प्रोवाइडर की लिस्ट प्राइस लेता है और उस पर कोई टोकन मार्कअप नहीं लगाता, जिसमें तब भी यही लागू है जब आप अपने प्रोवाइडर क्रेडेंशियल लाते हैं (जिसे अक्सर BYOK कहा जाता है)। नई टीमों को हर महीने एक छोटा फ़्री क्रेडिट मिलता है, जो लिखे जाने के समय $5 सूचीबद्ध है। मौजूदा प्राइसिंग पेज देखें, क्योंकि क्रेडिट की राशि बदलती रहती है।
Vercel यह भी बताता है कि अप्रैल 2026 तक के अपने प्रोडक्शन ट्रैफ़िक में, ऑटोमैटिक फ़ॉलबैक ने उन रिक्वेस्ट्स में से लगभग 3.5% को बचाया जो पहले रूट पर एरर, रेट लिमिट या टाइम आउट से टकराई थीं। यह आँकड़ा वेंडर का है, इसलिए इसे इस बात का संकेत मानें कि प्रोवाइडर में गड़बड़ियाँ कितनी आम हैं, न कि आपके वर्कलोड के लिए कोई वादा।
जहाँ यह कमज़ोर पड़ता है
- सेल्फ़-होस्ट नहीं किया जा सकता। प्रॉम्प्ट एक वेंडर से होकर गुज़रते हैं, जो सख्त डेटा पॉलिसी के तहत इसे बाहर कर सकता है।
- क्रेडिट आधारित। प्रीपेड क्रेडिट छोटी टीमों के लिए ठीक हैं, लेकिन फ़ाइनेंस विभाग कभी-कभी इनवॉइस और प्रतिबद्ध खर्च चाहते हैं।
- कम कस्टमाइज़ेशन। आप सेटिंग्स ट्यून करते हैं, कोड पैच नहीं करते।
- हल्का लॉक-इन। चूँकि API OpenAI compatible है, छोड़ना ज़्यादातर बेस URL बदलने जितना है, लेकिन आपके लॉग और बजट पीछे रह जाते हैं।
रूटिंग, फ़ॉलबैक और रीट्राई
फ़ॉलबैक वह फ़ीचर है जो अकेले ही गेटवे को सही ठहराता है। फ़ॉलबैक चेन मॉडलों को क्रम में सूचीबद्ध करती है: पहले प्राइमरी आज़माएँ, और अगर वह 5xx एरर, 429 रेट लिमिट या टाइम आउट देता है, तो अगले पर जाएँ। एक समझदार चेन प्रोवाइडरों को मिलाती है, केवल मॉडलों को नहीं, क्योंकि किसी प्रोवाइडर की आउटेज उसके होस्ट किए हर मॉडल को बंद कर देती है।
चैट फ़ीचर के लिए एक व्यावहारिक चेन कुछ ऐसी दिख सकती है:
- प्राइमरी: गुणवत्ता-संवेदनशील जवाबों के लिए Claude Sonnet 5।
- पहला बैकअप: किसी अलग प्रोवाइडर पर GPT 5.6 Terra।
- आख़िरी विकल्प: जब बाकी सब दिक्कत में हों, तब गति के लिए Gemini 3.5 Flash।
इस लेख में हर गेटवे ऐसी चेन को कॉन्फ़िगरेशन में व्यक्त कर सकता है। अंतर इस बात में है कि कब यह ट्रिगर होती है, इस पर आपका कितना नियंत्रण है: स्टेटस कोड से, लेटेंसी सीमा से, कंटेंट फ़िल्टर के नतीजे से, या कस्टम नियम से।
लोड बैलेंसिंग फ़ॉलबैक का शांत भाई है। अगर एक ही मॉडल के दो डिप्लॉयमेंट हैं, मान लीजिए अलग-अलग रीजन या अलग-अलग अकाउंट में, तो गेटवे ट्रैफ़िक को वेट के हिसाब से बाँट सकता है और धीमे डिप्लॉयमेंट से दूर हट सकता है। इससे आपकी प्रभावी रेट लिमिट भी बढ़ती है, क्योंकि हर अकाउंट की अपनी सीमा होती है।
रीट्राई की सीमाएँ ज़रूरी हैं
रीट्राई छोटी अवधि की गड़बड़ियों में मदद करते हैं, लेकिन उनमें जोखिम भी है। अगर पहली कॉल देर से पूरी हुई, तो रीट्राई की गई रिक्वेस्ट का दो बार बिल बन सकता है, और रीट्राई का तूफ़ान संघर्ष कर रहे प्रोवाइडर को और नीचे धकेल सकता है। ये आदतें रखें:
- ज़्यादा से ज़्यादा दो या तीन रीट्राई रखें, एक्सपोनेंशियल बैकऑफ़ और रैंडम जिटर के साथ।
- हर मॉडल के लिए अलग टाइम आउट सेट करें। एक रीज़निंग मॉडल वाजिब तौर पर एक मिनट तक सोच सकता है, जबकि एक छोटे चैट मॉडल को सेकंडों में जवाब देना चाहिए।
- स्ट्रीमिंग की योजना बनाएँ। एक बार पहले टोकन यूज़र तक पहुँच जाएँ, तो बीच स्ट्रीम में फ़ॉलबैक चुपचाप जवाब दोबारा शुरू नहीं कर सकता, इसलिए पहले से तय करें कि आपका इंटरफ़ेस इसे कैसे संभालेगा।
लागत और उपयोग को नियंत्रित करना
मॉडल के बिल चुपचाप बढ़ते हैं। गेटवे खर्च को ऐसी चीज़ में बदल देता है जिसे आप सेट कर सकें और देख सकें।
टीम और प्रोजेक्ट के हिसाब से बजट
हर टीम, प्रोजेक्ट या ग्राहक के लिए एक वर्चुअल क्रेडेंशियल दें और उससे एक मासिक बजट और रेट लिमिट जोड़ें। जब कोई बेकाबू स्क्रिप्ट लूप में चलती है, तो वह अपना बजट खत्म करके रुक जाती है, न कि साझा अकाउंट को खाली करती है। हर रिक्वेस्ट पर टैग लगाएँ, ताकि लॉग बिना स्प्रेडशीट की मेहनत के बता सके कि "किसने कितना खर्च किया"। LiteLLM और Vercel AI Gateway दोनों बजट देते हैं, और किसी भी सेल्फ़-होस्टेड टूल के साथ आपको पुष्टि करनी चाहिए कि बजट फ़ीचर फ़्री एडिशन में है या नहीं।
इसके बाद गेटवे का उपयोग करके हर काम के लिए सही मॉडल चुनें:
- वर्गीकरण, टैगिंग और छोटे सारांश किसी छोटे, तेज़ मॉडल पर भेजें, जैसे Gemini 3.5 Flash या Qwen3.7-Plus।
- कोड, रीज़निंग और ग्राहकों के सामने वाले टेक्स्ट के लिए टॉप टियर मॉडल सुरक्षित रखें, उदाहरण के लिए एजेंट जैसे काम के लिए Kimi K2.6।
- Llama 4 Maverick Instruct, Deepseek v3.1 या GPT OSS 120B जैसे ओपन वेट्स मॉडल उसी एंडपॉइंट के पीछे चलाएँ जहाँ पेड APIs हैं, जिससे आपको एक कम लागत वाला टियर मिलता है।
- FAQ जवाब जैसे दोहराए जाने वाले प्रॉम्प्ट कैश करें, और बजट के 100% के बजाय 80% पर अलर्ट सेट करें।
💡 लॉग सावधानी से रखें: हर प्रॉम्प्ट स्टोर करने से डिबगिंग आसान होती है, लेकिन इससे निजी डेटा भी स्टोर हो सकता है। पूरी बॉडी लॉगिंग चालू करने से पहले रिटेंशन और रिडैक्शन नियम तय करें।
एक दोपहर में कैसे चुनें
आपको एक महीने की रिसर्च की ज़रूरत नहीं है। आपको अपनी सीमाओं की साफ़ तस्वीर और एक छोटे परीक्षण की ज़रूरत है।
एक सरल निर्णय तालिका
| आपकी स्थिति | यहाँ से शुरू करें |
|---|
| छोटी टीम, आज ही चालू चाहिए | Vercel AI Gateway |
| प्रॉम्प्ट आपके नेटवर्क के अंदर रहने चाहिए | LiteLLM या Portkey Gateway, सेल्फ़-होस्टेड |
| पहले से Kubernetes और Envoy चलाते हैं | Envoy AI Gateway |
| प्रति रिक्वेस्ट जुड़ी लेटेंसी सबसे ज़रूरी है | Bifrost की तुलना LiteLLM से करें |
| Kong पहले से आपकी APIs के सामने है | Kong AI plugins |
| लागत और उपयोग की दृश्यता सबसे पहले चाहिए | Helicone |
फिर अपने दो शीर्ष विकल्पों पर यही पाँच चरण का परीक्षण चलाएँ:
- एक सैंडबॉक्स ऐप को गेटवे के बेस URL पर भेजें।
- एक हज़ार वास्तविक प्रॉम्प्ट भेजें, खिलौना उदाहरण नहीं।
- प्राइमरी प्रोवाइडर के क्रेडेंशियल रद्द करें और पुष्टि करें कि फ़ॉलबैक चालू होता है।
- जाँचें कि लॉग में हर रिक्वेस्ट के लिए टोकन, लागत और एरर दिख रहे हैं।
- सीधे प्रोवाइडर को कॉल करने की तुलना में जुड़ी लेटेंसी मापें।
तीन गलतियाँ जिनसे बचें
- सिर्फ़ बेंचमार्क देखकर चुनना। एक गेटवे जो लैब में एक मिलीसेकंड जोड़ता है, वह लॉगिंग, ऑथेंटिकेशन और गार्डरेल चालू होने पर उससे ज़्यादा जोड़ सकता है।
- फ़ॉलबैक परीक्षण छोड़ना। प्राइमरी प्रोवाइडर का कनेक्शन काटें और देखें क्या होता है। बिना परखी चेन एक अनुमान भर है।
- गेटवे को एकमात्र विफलता बिंदु मानना। लोड बैलेंसर के पीछे कम से कम दो इंस्टेंस चलाएँ, या अपने कोड में सीधे प्रोवाइडर का रास्ता आपातकालीन स्विच के रूप में रखें।
प्लंबिंग छोड़ें और बनाना शुरू करें
हर प्रोजेक्ट को गेटवे की ज़रूरत नहीं होती। अगर आपका लक्ष्य इन्फ़्रास्ट्रक्चर चलाने के बजाय टेक्स्ट, इमेज या वीडियो बनाना है, तो Picasso IA आपको सीधे ब्राउज़र में मॉडल देता है, जिसमें न कोई प्रॉक्सी डिप्लॉय करना पड़ता है, न कोई क्रेडेंशियल रोटेट करना।
भाषा के मोर्चे पर आप Claude Sonnet 5, GPT 5.6 Terra और Gemini 3.5 Flash को साथ-साथ आज़मा सकते हैं, ठीक वैसी ही तुलना जो एक गेटवे आपको स्क्रिप्ट करने देता। तस्वीरों के लिए एक ही प्रॉम्प्ट Seedream 5 Pro, GPT Image 2 और Flux 2 Max पर चलाएँ और जो नतीजा सबसे अच्छा लगे उसे रखें। मूविंग इमेज के लिए, Seedance 2.0 अंतर्निहित ऑडियो के साथ टेक्स्ट को वीडियो में बदलता है, Veo 3.1 Fast तेज़ 1080p क्लिप बनाता है, और Kling v3 Video सिनेमाई शॉट्स का लक्ष्य रखता है।
ऐसा प्रॉम्प्ट चुनें जिसकी आपको सच में ज़रूरत है, उसे तीन मॉडलों पर चलाएँ, और नतीजों की तुलना करें। यह एक आदत मॉडल की गुणवत्ता और लागत के बारे में किसी भी बेंचमार्क टेबल से ज़्यादा सिखाती है। Picasso IA खोलें, एक मॉडल चुनें, और आज ही अपनी पहली इमेज या वीडियो बनाएँ।


