Diez agentes, cuarenta herramientas, cinco servidores MCP y una credencial filtrada esperando a ocurrir. Así suele ser la configuración de un equipo unas tres semanas después de la primera demo exitosa. Cada cual conectó su servidor a su cliente, nadie lleva la cuenta de quién puede llamar a qué, y un bucle descontrolado agota una cuota del proveedor antes de mediodía. El mejor gateway MCP para tu equipo es el que pone una única puerta controlada delante de todo eso. Este artículo compara las opciones de código abierto, el costo que nadie incluye en la página de precios, cómo diseñar límites de tasa que aguanten el tráfico real y qué revisar antes de confiar en ellos en producción.
💡 Nota rápida sobre las fuentes: la mayoría de las comparativas públicas de gateways MCP las escriben proveedores que colocan su propio producto en primer lugar. Toma cualquier ranking, incluido el mío, como punto de partida y haz tu propia prueba con tus herramientas antes de comprometerte.
Qué hace un gateway MCP
El Model Context Protocol permite que un modelo de IA llame a herramientas: consultar una base de datos, abrir un ticket, buscar en un repositorio, enviar un mensaje. Cada herramienta vive en un servidor MCP. Sin gateway, cada cliente habla directamente con cada servidor. Con un gateway, los clientes hablan con un solo endpoint, y el gateway decide qué servidor atiende la llamada, quién tiene permiso para hacerla y con qué frecuencia.
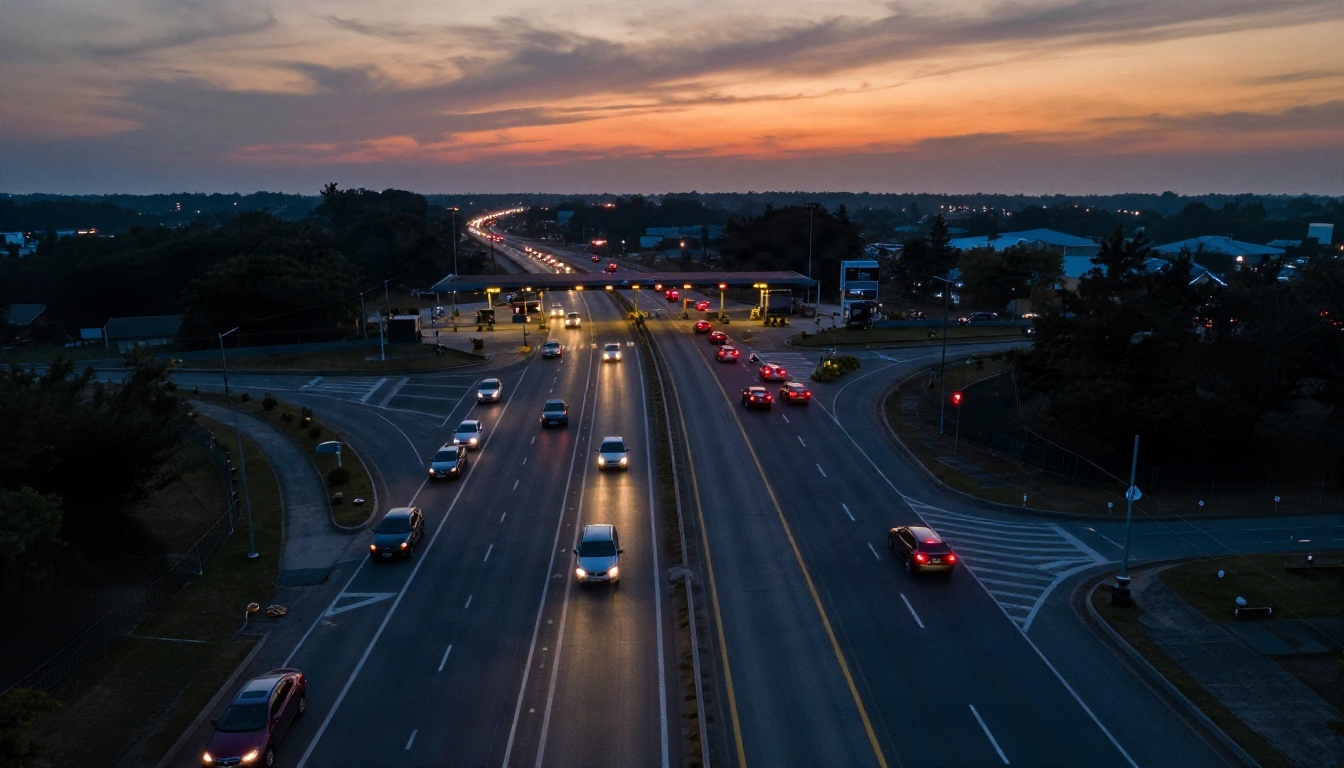
Una puerta para muchos servidores
Piensa en la caseta de peaje de arriba. Decenas de carreteras desembocan en un único punto controlado. Un gateway te da la misma forma para el tráfico de herramientas:
- Enrutamiento: una URL para los clientes, muchos servidores detrás.
- Autenticación: usuarios y agentes inician sesión una vez, no una vez por servidor.
- Políticas: permitir o denegar herramientas concretas por equipo, por agente y por entorno.
- Límites de tasa: proteger las APIs upstream y tu propio presupuesto.
- Registro: un único rastro de auditoría de quién llamó a qué herramienta y con qué argumentos.
Los modelos de lenguaje que están al otro lado de esta puerta importan menos de lo que la gente cree. Ya sea que el que llama sea Claude Sonnet 5, GPT 5.6 Sol o Kimi K2.6, el gateway ve lo mismo: un flujo de llamadas a herramientas que hay que autenticar, limitar y registrar.
Cuándo puedes prescindir de uno
No todos los proyectos necesitan esta capa. Si tienes un solo desarrollador, dos servidores MCP y todo corre en un equipo portátil, un gateway añade complejidad sin quitar riesgo. El punto de inflexión suele llegar cuando se cumple alguna de estas condiciones:
- Más de un equipo o agente comparte las mismas herramientas.
- Una herramienta toca datos de producción o gasta dinero real.
- Tienes que responder a un auditor, a un cliente o a tu propio responsable de seguridad.
- Las APIs upstream tienen cuotas que no puedes permitirte agotar.
Opciones de código abierto comparadas
Los principales contendientes
El ámbito del código abierto se ha asentado en unos cuantos proyectos. La tabla siguiente resume lo que dicen las comparativas públicas y las descripciones de los proyectos. Los detalles cambian rápido, así que confirma las licencias y funciones en el repositorio de cada proyecto antes de construir sobre uno.
| Gateway | Licencia y modelo | Mejor opción para | Ojo con |
|---|
| IBM ContextForge | Apache 2.0, gratuito, autoalojado | Equipos que quieren funciones de gobernanza y pueden ejecutar servicios en Python | Tú cargas con todo el trabajo de alojamiento y operaciones |
| Docker MCP Gateway | MIT, versión de código abierto gratuita | Equipos que ya trabajan con contenedores y herramientas de Docker | Una variante empresarial con gobernanza se vende a través del equipo comercial, no es de autoservicio |
| Microsoft MCP Gateway | Proxy inverso de código abierto para Kubernetes | Empresas que usan Azure y Kubernetes | Lo que cuesta son los recursos de Azure que hay debajo |
| Bifrost | Núcleo de código abierto con un nivel empresarial | Equipos que quieren un gateway de LLM y enrutamiento MCP juntos | Sus cifras de rendimiento provienen del proveedor |
| Obot | Código abierto con una oferta comercial | Equipos que se preocupan por un catálogo y el control de acceso para ingenieros | Revisa qué funciones están en el plan de pago |
| Agentgateway | Proyecto de proxy de código abierto | Equipos cómodos con proxies a nivel de infraestructura | Ecosistema más joven, menos casos de uso en producción |
Las estrellas no equivalen a profundidad
Un error habitual es elegir por la popularidad en GitHub. Un análisis público señaló que Apache APISIX tiene muchas más estrellas que IBM ContextForge, pero ContextForge documenta muchas más funciones de gobernanza específicas de MCP. APISIX es un excelente gateway de API general, pero las fortalezas de un gateway general (enrutamiento, plugins, límites de tasa) no equivalen a entender las sesiones MCP, los catálogos de herramientas y los permisos por herramienta.
💡 Prueba rápida: abre la documentación del proyecto y busca "tool allowlist", "session" y "per user". Si ninguno aparece, estás ante un proxy general con una etiqueta MCP, no ante un gateway MCP.
El costo real de ejecutar uno
La licencia no es la factura
"Gratuito y de código abierto" describe la licencia, no tu factura. Un costo mensual realista de un gateway autoalojado tiene cinco partes:
- Cómputo: al menos dos instancias para disponibilidad, más una base de datos o caché para las sesiones y los contadores de tasa.
- Almacenamiento de observabilidad: los logs y las trazas crecen rápido, porque cada llamada a herramienta genera varios registros.
- Tiempo de ingeniería: actualizaciones, parches de seguridad, revisiones de configuración. Suele ser la partida más grande y la que más se pasa por alto.
- Integración de identidad: conectar tu proveedor de inicio de sesión único, grupos y cuentas de servicio.
- Uso upstream: las herramientas detrás del gateway siguen costando lo que cuestan. Un gateway que funciona perfectamente puede seguir reenviando un bucle muy caro.
En un equipo pequeño, la parte de infraestructura puede ser modesta. El tiempo de ingeniería es lo que separa un piloto barato de un hábito caro. La comparativa de Traefik apunta algo parecido: los gateways de código abierto convienen a equipos sensibles al costo que tienen capacidad de ingeniería de plataforma para operarlos.
Niveles de pago y gestionados
Los precios en esta categoría son irregulares, y las cifras publicadas difieren entre fuentes, así que toma lo siguiente solo como orientación y comprueba tú mismo los precios actuales:
| Opción | Qué dicen las fuentes públicas |
|---|
| IBM ContextForge | Uso gratuito; tu costo es el alojamiento y las operaciones |
| Docker MCP Gateway | La versión de código abierto es gratuita; la versión con gobernanza se cotiza a través de ventas |
| Microsoft MCP Gateway | Código abierto; pagas los recursos de Azure en los que se ejecuta |
| Kong AI Gateway | Las fuentes no coinciden: una indica un nivel de entrada desde unos $25 al mes más el uso, y otra describe el proxy MCP como exclusivo de la versión empresarial |
| Cloudflare MCP Server Portals | En beta abierta para clientes de Cloudflare One, con una asignación gratuita de plazas; la plataforma Workers tiene un nivel diario gratuito de solicitudes, y los planes de pago empiezan con una tarifa mensual baja para millones de solicitudes |
💡 Regla general: si un proveedor dice "contáctanos" para el precio de un gateway MCP, prevé un proceso de ventas de semanas, no de días, y pide por escrito las funciones de límite de tasa y de registro de auditoría.
Límites de tasa que aguantan
Las recopilaciones públicas dicen sorprendentemente poco sobre cómo se comportan los gateways cuando se alcanzan los límites, así que aquí es donde debes hacer tus propias pruebas. Un límite de tasa delante de herramientas no es lo mismo que un límite delante de una API web. Los agentes reintentan, entran en bucle y se multiplican de formas que los usuarios humanos nunca hacen.
Limita por cliente y por herramienta
Un único contador global es el diseño más débil. Prefiere límites que combinen varias dimensiones:
- Por identidad: cada usuario y cada agente tiene su propio presupuesto.
- Por herramienta: una herramienta de búsqueda de solo lectura puede aguantar cientos de llamadas por minuto, mientras que una herramienta de "enviar correo" debería admitir unas pocas.
- Por upstream: protege la API de terceros detrás de la herramienta con un techo propio, por debajo de la cuota del proveedor.
- Por sesión: limita cuántas llamadas puede hacer una conversación, para que un bucle se detenga solo.
Una política inicial razonable para un equipo nuevo:
| Tipo de herramienta | Límite inicial | Por qué |
|---|
| Búsqueda de solo lectura | 120 llamadas por minuto por usuario | Barata y segura |
| Consulta a base de datos | 30 llamadas por minuto por usuario | Protege la base de datos |
| Escritura o actualización | 10 llamadas por minuto por usuario | Limita el daño de los errores |
| Envío de dinero o mensajes | 3 llamadas por minuto por usuario, con aprobación | Difícil de deshacer |
Estas cifras son orientativas. Empieza estricto, revisa los logs durante dos semanas y luego afloja lo que esté claramente a salvo.
Gestiona las ráfagas y los reintentos
Los agentes suelen lanzar varias llamadas a herramientas a la vez. Un límite estricto por segundo rechaza las ráfagas legítimas, mientras que un token bucket con una capacidad de ráfaga moderada las absorbe. Comprueba tres comportamientos en cualquier gateway que pruebes:
- ¿Qué recibe el cliente? Una respuesta clara de "demasiadas solicitudes" con una pista para reintentar permite que el modelo espere. Un timeout silencioso hace que reintente con más insistencia.
- ¿Los contadores se comparten entre instancias? Si cada réplica cuenta por su cuenta, tu límite real es el configurado multiplicado por el número de réplicas.
- ¿Qué pasa cuando el almacén de contadores cae? Decide si el gateway falla abierto (riesgo de sobrecarga) o falla cerrado (riesgo de caída del servicio), y haz de esa decisión una elección consciente.
Seguridad antes que escala
Una llamada a herramienta es ejecución de código con pasos extra. La inyección de prompts, en la que un texto dentro de un documento o una página web convence al modelo de llamar a una herramienta que no debería, es el riesgo principal. El gateway es el mejor lugar para aplicar reglas que no dependen de que el modelo se comporte bien.
Autenticación y listas de herramientas permitidas
- Inicio de sesión único: cada llamada corresponde a una persona real o a una cuenta de servicio con nombre.
- Listas de permitidos: un agente solo ve las herramientas que necesita. Un agente de soporte no tiene motivo para listar tus herramientas de despliegue.
- Credenciales con alcance limitado: el gateway guarda los secretos de los servicios upstream, así que los clientes nunca los tienen. Rótalos de forma centralizada.
- Pasos de aprobación: exige confirmación humana para las acciones destructivas.
Auditoría y tratamiento de datos
Registra el nombre de la herramienta, quién llama, la marca de tiempo, el resultado y un hash o una versión redactada de los argumentos. Los argumentos en bruto suelen contener datos personales, así que decide de antemano qué guardas y durante cuánto tiempo. Si diriges llamadas a modelos para clasificar o moderar, un modelo de seguridad pequeño como Llama Guard 4 12B es una elección habitual para filtrar el contenido antes de que llegue a una herramienta.
Lista de comprobación para producción
Observabilidad que de verdad vas a usar
La persona de guardia a las 2 de la madrugada necesita cuatro respuestas rápido: qué herramienta falla, qué cliente lo provoca, qué cambió y si el upstream está caído. Asegúrate de que el gateway emite:
- Métricas: tasa de solicitudes, tasa de errores y latencia por herramienta y por servidor.
- Trazas: un ID de traza que sigue una llamada desde el cliente, pasando por el gateway, hasta el servidor MCP.
- Logs estructurados: legibles por máquina, con campos de cliente y herramienta.
- Alertas: cuando se disparen los rechazos por límite de tasa, cuando fallen las autenticaciones y cuando un servidor deje de responder.
Trata con cuidado las cifras de latencia
Algunas páginas de proveedores citan la sobrecarga en microsegundos con miles de solicitudes por segundo. Otro proveedor se negó a publicar cifras de latencia en absoluto, porque los números medidos en condiciones distintas no son comparables. Ambas posturas son razonables. En las llamadas a herramientas, la sobrecarga propia del gateway casi siempre queda eclipsada por la herramienta: una consulta a base de datos o un viaje de ida y vuelta a una API tarda de milisegundos a segundos. Mide tu latencia de extremo a extremo con tus herramientas reales y tamaños de carga reales, no con el benchmark del proveedor.
Prepárate para los fallos
- Ejecuta al menos dos réplicas detrás de un balanceador de carga.
- Guarda el estado de las sesiones fuera del proceso para que un reinicio no tire las conversaciones activas.
- Define timeouts por herramienta, más cortos para las lecturas y más largos para las herramientas de lotes lentas.
- Añade circuit breakers para que un servidor que falla no paralice a todos los agentes.
- Prueba las actualizaciones en staging con tráfico reproducido de tus logs reales.
Cómo elegir el tuyo
Ajusta el gateway a tu stack
La respuesta correcta depende menos de las funciones y más de lo que tu equipo ya ejecuta y mantiene bien:
| Tu situación | Punto de partida probable |
|---|
| Uso intensivo de Docker, equipo pequeño | Docker MCP Gateway |
| Kubernetes en Azure | Microsoft MCP Gateway |
| Gobernanza y auditoría son la prioridad, con equipo de plataforma disponible | IBM ContextForge |
| Quieres enrutamiento de LLM y de MCP en un mismo lugar | Bifrost |
| Ya usas un gateway de API grande para todo lo demás | Revisa su plugin MCP y luego compáralo con un gateway dedicado |
| Cloudflare ya es tu borde de red | Las opciones de portales y Workers de Cloudflare |
Haz una prueba de una semana
Preselecciona dos gateways y ejecuta la misma prueba con cada uno:
- Pon tres servidores MCP reales detrás del gateway.
- Conecta dos clientes distintos, por ejemplo un asistente de programación y un agente de chat impulsado por Gemini 3.5 Flash.
- Fija los límites de tasa de la tabla anterior y supéralos a propósito.
- Apaga un servidor MCP y observa qué ve el cliente.
- Lee el registro de auditoría como lo haría un auditor.
- Anota cuántas horas tardó la configuración, porque ese número es tu costo real.
Un gateway que supera esta prueba en una semana suele seguir superándola con diez veces más volumen. Uno que necesita un esfuerzo heroico en la primera semana no se volverá más fácil.
Errores comunes que conviene evitar
- Elegir solo por el número de estrellas.
- Usar una única cuenta de servicio compartida para todos los agentes.
- Fijar los límites una vez y no volver a revisar los logs.
- Exponer todas las herramientas a todos los agentes "por ahora".
- Saltarse el entorno de staging porque el gateway es "solo un proxy".
Crea agentes más inteligentes en PicassoIA
Un gateway controla la puerta, pero los agentes que hay detrás siguen necesitando un modelo capaz. En PicassoIA puedes probar varios modelos de lenguaje lado a lado antes de decidir cuál dirige tus llamadas a herramientas: Claude Sonnet 5 para trabajo de programación cuidadoso de varios pasos, GPT 5.6 Terra para tareas de texto en producción, Qwen3.7-Plus cuando necesitas entrada de texto e imagen, o Granite 4.1 8B como modelo ligero para pasos de clasificación y enrutamiento.
Elige un prompt que refleje uno de tus flujos de trabajo reales con herramientas, pásalo por dos o tres modelos y compara cómo elige cada uno las herramientas y gestiona los errores. Ese experimento de diez minutos te dice más sobre lo que necesita tu gateway que cualquier tabla de benchmarks.
¿Listo para probarlo? Explora todos los modelos de lenguaje, imagen y video en picassoia.com/en/all-models y empieza a experimentar con tus propias ideas hoy mismo.


