Dix agents, quarante outils, cinq serveurs MCP et un identifiant qui risque de fuiter. C’est à peu près ce que devient l’installation d’une équipe trois semaines après la première démo réussie. Chacun a connecté son propre serveur à son propre client, personne ne sait qui peut appeler quoi, et une boucle incontrôlée consomme le quota d’une API amont avant midi. La meilleure passerelle MCP pour votre équipe est celle qui place une porte unique et contrôlée devant tout cela. Cet article compare les options open source, le coût que personne n’affiche sur une page tarifaire, la manière de concevoir des limites de débit qui tiennent face au trafic réel, et ce qu’il faut vérifier avant de la faire confiance en production.
💡 Remarque sur les sources : la plupart des comparaisons publiques de passerelles MCP sont rédigées par des éditeurs qui classent leur propre produit en tête. Considérez tout classement, y compris le mien, comme un point de départ, et testez vous-même avec vos propres outils avant de vous engager.
Ce que fait une passerelle MCP
Le Model Context Protocol permet à un modèle d’IA d’appeler des outils : interroger une base de données, ouvrir un ticket, chercher dans un dépôt, envoyer un message. Chaque outil vit sur un serveur MCP. Sans passerelle, chaque client parle directement à chaque serveur. Avec une passerelle, les clients parlent à un seul point d’accès, et la passerelle décide quel serveur traite l’appel, qui est autorisé à le lancer et à quelle fréquence.
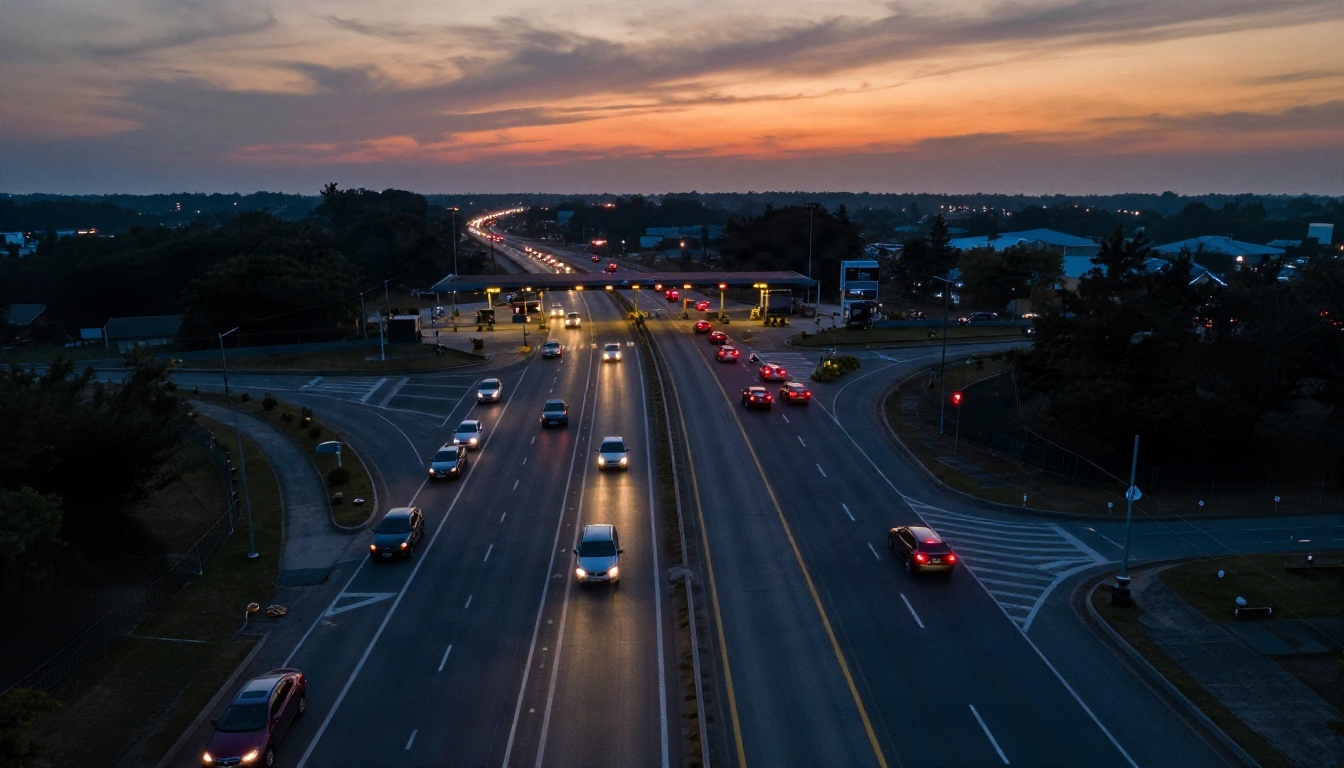
Une seule porte pour plusieurs serveurs
Pensez au péage ci-dessus. Des dizaines de routes convergent vers un point de contrôle unique. Une passerelle vous offre la même architecture pour le trafic d’outils :
- Routage : une seule URL pour les clients, plusieurs serveurs derrière.
- Authentification : les utilisateurs et les agents se connectent une fois, et non une fois par serveur.
- Politique : autoriser ou refuser des outils précis par équipe, par agent, par environnement.
- Limitation de débit : protéger les API amont et votre propre budget.
- Journalisation : une piste d’audit unique indiquant qui a appelé quel outil et avec quels arguments.
Les modèles de langage placés de l’autre côté de cette porte comptent moins qu’on ne le pense. Que l’appelant soit Claude Sonnet 5, GPT 5.6 Sol ou Kimi K2.6, la passerelle voit la même chose : un flux d’appels d’outils qu’il faut authentifier, limiter et enregistrer.
Quand on peut s’en passer
Tous les projets n’ont pas besoin de cette couche. Si vous avez un seul développeur, deux serveurs MCP et tout tourne sur un ordinateur portable, une passerelle ajoute des pièces mobiles sans supprimer de risque. Le point de bascule arrive généralement quand l’une de ces situations se présente :
- Plusieurs équipes ou agents partagent les mêmes outils.
- Un outil touche à des données de production ou dépense de l’argent réel.
- Vous devez répondre à un auditeur, à un client ou à votre responsable sécurité.
- Les API amont ont des quotas que vous ne pouvez pas vous permettre d’épuiser.
Comparatif des options open source
Les principaux concurrents
Le paysage open source s’est stabilisé autour de quelques projets. Le tableau ci-dessous résume ce que disent les comparatifs publics et les descriptions des projets. Les détails évoluent vite : vérifiez les licences et les fonctionnalités sur le dépôt de chaque projet avant de vous appuyer dessus.
| Passerelle | Licence et modèle | Usage idéal | Points de vigilance |
|---|
| IBM ContextForge | Apache 2.0, gratuite, auto-hébergée | Équipes qui veulent des fonctions de gouvernance et peuvent exploiter des services Python | Vous assumez tout le travail d’hébergement et d’exploitation |
| Docker MCP Gateway | MIT, version open source gratuite | Équipes déjà installées dans les conteneurs et l’outillage Docker | Une variante entreprise gouvernée se vend via les commerciaux, pas en libre-service |
| Microsoft MCP Gateway | Reverse proxy open source pour Kubernetes | Structures sur Azure et Kubernetes | Le coût correspond aux ressources Azure sous-jacentes |
| Bifrost | Cœur open source avec une offre entreprise | Équipes qui veulent une passerelle LLM et le routage MCP réunis | Ses chiffres de performance proviennent de l’éditeur |
| Obot | Open source avec une offre commerciale | Équipes qui tiennent à un catalogue et au contrôle d’accès pour les ingénieurs | Vérifiez quelles fonctions sont dans l’offre payante |
| Agentgateway | Projet de proxy open source | Équipes à l’aise avec les proxys au niveau de l’infrastructure | Écosystème plus jeune, moins de retours d’expérience en production |
Le nombre d’étoiles ne garantit pas la profondeur
Une erreur courante consiste à choisir selon la popularité sur GitHub. Une analyse publique a relevé qu’Apache APISIX totalise bien plus d’étoiles qu’IBM ContextForge, alors que ContextForge documente beaucoup plus de fonctions de gouvernance propres à MCP. APISIX est une excellente passerelle d’API générale, mais les points forts d’une passerelle générale (routage, plugins, limitation de débit) ne reviennent pas à comprendre les sessions MCP, les catalogues d’outils et les permissions par outil.
💡 Test rapide : ouvrez la documentation du projet et recherchez « tool allowlist », « session » et « per user ». Si aucun de ces termes n’apparaît, vous avez affaire à un proxy général avec une étiquette MCP, et non à une véritable passerelle MCP.
Le coût réel d’une passerelle
La licence n’est pas la facture
« Gratuit et open source » décrit la licence, pas votre facture. Le coût mensuel réaliste d’une passerelle auto-hébergée comporte cinq éléments :
- Calcul : au moins deux instances pour la disponibilité, plus une base de données ou un cache pour les sessions et les compteurs de débit.
- Stockage d’observabilité : les journaux et les traces grossissent vite, car chaque appel d’outil génère plusieurs enregistrements.
- Temps d’ingénierie : mises à jour, correctifs de sécurité, revues de configuration. C’est généralement le poste le plus lourd, et celui qu’on oublie le plus souvent.
- Intégration de l’identité : raccorder votre fournisseur d’authentification unique, les groupes et les comptes de service.
- Usage amont : les outils derrière la passerelle coûtent toujours ce qu’ils coûtent. Une passerelle qui fonctionne parfaitement peut tout de même transmettre une boucle très coûteuse.
Pour une petite équipe, la partie infrastructure peut rester modeste. Le temps d’ingénierie est ce qui sépare un pilote peu coûteux d’une habitude onéreuse. Le comparatif de Traefik va dans le même sens : les passerelles open source conviennent aux équipes sensibles aux coûts qui disposent des compétences en ingénierie de plateforme pour les faire tourner.
Offres payantes et services managés
Les tarifs de cette catégorie sont incohérents, et les chiffres publiés divergent d’une source à l’autre. Considérez donc ce qui suit comme une simple indication et vérifiez vous-même les prix actuels :
| Option | Ce que disent les sources publiques |
|---|
| IBM ContextForge | Gratuite à l’usage ; votre coût correspond à l’hébergement et à l’exploitation |
| Docker MCP Gateway | La version open source est gratuite ; la version gouvernée s’obtient sur devis auprès des commerciaux |
| Microsoft MCP Gateway | Open source ; vous payez les ressources Azure sur lesquelles elle tourne |
| Kong AI Gateway | Les sources divergent : l’une cite une offre d’entrée à partir d’environ 25 $ par mois plus l’usage, une autre décrit le proxy MCP comme réservé à l’entreprise |
| Cloudflare MCP Server Portals | En bêta ouverte pour les clients Cloudflare One, avec une allocation gratuite de sièges ; la plateforme Workers propose un palier gratuit de requêtes quotidiennes, et des offres payantes à partir d’un faible montant mensuel pour des millions de requêtes |
💡 Règle empirique : si un éditeur répond « contactez-nous » pour le tarif d’une passerelle MCP, prévoyez un cycle commercial de plusieurs semaines, et non de quelques jours, et demandez par écrit les fonctions de limitation de débit et de journal d’audit.
Des limites de débit qui tiennent
Les synthèses publiques en disent étonnamment peu sur le comportement des passerelles lorsque les limites sont atteintes. C’est donc là qu’il faut faire vos propres tests. Une limite de débit devant des outils n’est pas la même chose qu’une limite devant une API web. Les agents relancent, bouclent et se dupliquent d’une façon que ne font jamais les utilisateurs humains.
Limiter par appelant et par outil
Un compteur global unique est le pire des choix. Privilégiez des limites qui combinent plusieurs dimensions :
- Par identité : chaque utilisateur et chaque agent dispose de son propre budget.
- Par outil : un outil de recherche en lecture seule peut enchaîner des centaines d’appels par minute, alors qu’un outil « envoyer un e-mail » ne devrait en faire qu’une poignée.
- Par amont : protégez l’API tierce derrière l’outil avec son propre plafond, fixé sous le quota du fournisseur.
- Par session : plafonnez le nombre d’appels d’une même conversation, pour qu’une boucle s’arrête d’elle-même.
Une politique de départ raisonnable pour une nouvelle équipe :
| Type d’outil | Limite de départ | Pourquoi |
|---|
| Recherche en lecture seule | 120 appels par minute et par utilisateur | Peu coûteux et sans risque |
| Requête de base de données | 30 appels par minute et par utilisateur | Protège la base de données |
| Écriture ou mise à jour | 10 appels par minute et par utilisateur | Limite les dégâts des erreurs |
| Envoi d’argent ou de messages | 3 appels par minute et par utilisateur, avec validation | Difficile à annuler |
Ces chiffres sont indicatifs. Commencez strictement, surveillez les journaux pendant deux semaines, puis assouplissez ce qui est manifestement sûr.
Gérer les rafales et les relances
Les agents déclenchent souvent plusieurs appels d’outils en même temps. Une limite stricte par seconde rejette des rafales légitimes, alors qu’un seau à jetons avec une marge de rafale modeste les absorbe. Vérifiez trois comportements dans toute passerelle que vous testez :
- Que reçoit le client ? Une réponse claire « trop de requêtes » accompagnée d’un délai de nouvelle tentative permet au modèle de ralentir. Un délai d’attente silencieux le pousse à réessayer plus fort.
- Les compteurs sont-ils partagés entre les instances ? Si chaque réplique compte de son côté, votre limite réelle correspond à la limite configurée multipliée par le nombre de répliques.
- Que se passe-t-il quand le magasin de compteurs est indisponible ? Décidez si la passerelle laisse passer (risque de surcharge) ou bloque (risque d’interruption), et faites de ce choix un acte délibéré.
La sécurité avant la montée en charge
Un appel d’outil revient à de l’exécution de code, avec quelques étapes en plus. L’injection de prompt, où un texte contenu dans un document ou une page web convainc le modèle d’appeler un outil qu’il ne devrait pas appeler, constitue le risque principal. La passerelle est le meilleur endroit pour appliquer des règles qui ne dépendent pas du bon comportement du modèle.
Authentification et listes d’outils autorisés
- Authentification unique : chaque appel correspond à une vraie personne ou à un compte de service nommé.
- Listes d’autorisation : un agent ne voit que les outils dont il a besoin. Un agent de support n’a aucune raison de lister vos outils de déploiement.
- Identifiants à portée limitée : la passerelle détient les secrets des API amont, pour que les clients n’en aient jamais. Renouvelez-les de façon centralisée.
- Étapes de validation : exigez une confirmation humaine pour les actions destructrices.
Audit et traitement des données
Journalisez le nom de l’outil, l’appelant, l’horodatage, le résultat et un hachage ou une version expurgée des arguments. Les arguments bruts contiennent souvent des données personnelles : décidez donc à l’avance ce que vous stockez et pendant combien de temps. Si vous acheminez des appels vers des modèles de classification ou de modération, un petit modèle de sécurité comme Llama Guard 4 12B est un choix courant pour filtrer le contenu avant qu’il n’atteigne un outil.
Liste de contrôle pour la production
Une observabilité que vous utiliserez vraiment
La personne d’astreinte à 2 h du matin a besoin de quatre réponses rapidement : quel outil défaille, quel appelant en est la cause, ce qui a changé, et si l’amont est en panne. Assurez-vous que la passerelle produit :
- Métriques : taux de requêtes, taux d’erreur et latence par outil et par serveur.
- Traces : un identifiant de trace unique qui suit un appel du client jusqu’au serveur MCP, en passant par la passerelle.
- Journaux structurés : lisibles par une machine, avec des champs pour l’appelant et l’outil.
- Alertes : en cas de hausse des rejets pour limite de débit, d’échecs d’authentification ou de serveur devenu silencieux.
Prenez les annonces de latence avec prudence
Certaines pages d’éditeurs affichent un surcoût en microsecondes à plusieurs milliers de requêtes par seconde. Un autre éditeur a refusé de publier le moindre chiffre de latence, car des mesures réalisées dans des conditions différentes ne sont pas comparables. Les deux positions se défendent. Pour les appels d’outils, le surcoût propre à la passerelle est presque toujours éclipsé par celui de l’outil : une requête en base ou un aller-retour vers une API prend de quelques millisecondes à quelques secondes. Mesurez votre latence de bout en bout avec vos outils réels et la taille réelle de vos charges utiles, et non avec le benchmark de l’éditeur.
Anticiper les pannes
- Faites tourner au moins deux répliques derrière un répartiteur de charge.
- Gardez l’état des sessions hors du processus pour qu’un redémarrage ne fasse pas tomber les conversations en cours.
- Définissez des délais d’attente par outil, plus courts pour les lectures et plus longs pour les outils de traitement par lots lents.
- Ajoutez des disjoncteurs pour qu’un serveur défaillant ne bloque pas tous les agents.
- Testez les mises à jour en préproduction avec un trafic rejoué à partir de vos journaux réels.
Adapter la passerelle à votre stack
Le bon choix dépend moins des fonctions que de ce que votre équipe fait déjà tourner et maîtrise bien :
| Votre situation | Point de départ probable |
|---|
| Usage intensif de Docker, petite équipe | Docker MCP Gateway |
| Kubernetes sur Azure | Microsoft MCP Gateway |
| Gouvernance et audit prioritaires, équipe plateforme disponible | IBM ContextForge |
| Vous voulez le routage LLM et le routage MCP au même endroit | Bifrost |
| Vous utilisez déjà une grande passerelle d’API pour tout le reste | Vérifiez son plugin MCP, puis comparez-le à une passerelle dédiée |
| Cloudflare est déjà votre point d’entrée | Les options Cloudflare Portal et Workers |
Lancer un essai d’une semaine
Retenez deux passerelles et menez le même essai sur chacune :
- Placez trois vrais serveurs MCP derrière la passerelle.
- Connectez deux clients différents, par exemple un assistant de code et un agent de discussion propulsé par Gemini 3.5 Flash.
- Appliquez les limites de débit du tableau ci-dessus et dépassez-les volontairement.
- Coupez un serveur MCP et observez ce que voit le client.
- Lisez le journal d’audit comme si vous étiez auditeur.
- Notez le nombre d’heures de mise en place, car ce chiffre représente votre coût réel.
Une passerelle qui réussit cet essai en une semaine continuera généralement à tenir avec dix fois plus de volume. Celle qui exige des efforts héroïques dès la première semaine ne deviendra pas plus simple avec le temps.
Erreurs courantes à éviter
- Choisir uniquement sur le nombre d’étoiles.
- Utiliser un seul compte de service partagé pour tous les agents.
- Fixer les limites une fois pour toutes et ne jamais consulter les journaux.
- Exposer chaque outil à chaque agent « pour le moment ».
- Sauter l’environnement de préproduction parce que la passerelle n’est « qu’un proxy ».
Construisez des agents plus efficaces sur PicassoIA
Une passerelle contrôle la porte, mais les agents derrière elle ont toujours besoin d’un modèle capable. Sur PicassoIA, vous pouvez tester plusieurs modèles de langage côte à côte avant de décider lequel pilotera vos appels d’outils : Claude Sonnet 5 pour un travail de code rigoureux en plusieurs étapes, GPT 5.6 Terra pour les tâches de texte en production, Qwen3.7-Plus lorsque vous avez besoin d’une entrée texte et image, ou Granite 4.1 8B comme modèle léger pour les étapes de classification et de routage.
Choisissez un prompt qui reproduit l’un de vos flux de travail d’outils réels, passez-le dans deux ou trois modèles, et comparez la manière dont chacun choisit ses outils et gère les erreurs. Cette expérience de dix minutes vous en apprendra plus sur les besoins de votre passerelle que n’importe quel tableau de benchmarks.
Prêt à essayer ? Parcourez tous les modèles de langage, d’image et de vidéo sur picassoia.com/en/all-models et commencez dès aujourd’hui à expérimenter avec vos propres idées.


