No todos los modelos de Stable Diffusion manejan bien los prompts NSFW. Algunos producen tonos de piel turbios, anatomía distorsionada o una iluminación plana que arruina el realismo que buscas. En 2027, la diferencia entre los modelos más destacados y los del montón se ha ampliado mucho. Este análisis separa lo útil del ruido y clasifica los modelos que de verdad funcionan, con notas claras sobre cuándo usar cada uno.
Qué hace que un modelo sea bueno para NSFW
No todos los checkpoints de Stable Diffusion se entrenan igual. Un modelo que destaca con paisajes puede fallar por completo al generar figuras humanas. Para el contenido NSFW en concreto, necesitas que varias cosas funcionen juntas:
- Precisión en el render de la piel: Textura de poros realista, subtonos naturales, dispersión subsuperficial creíble
- Coherencia anatómica: Proporciones correctas, colocación coherente de las extremidades, sin mutaciones en los dedos
- Respuesta a la luz: Cómo interactúan la tela, la piel y el cabello con las fuentes de luz direccionales
- Adherencia al prompt: ¿Hace lo que pides sin alucinar elementos aleatorios?
💡 El modelo es solo la mitad de la ecuación. La escala CFG, los pasos de muestreo y los prompts negativos importan tanto como él. Un modelo mediocre con buenos ajustes suele superar a uno excelente con prompts descuidados.
Los modelos que aparecen a continuación están ordenados según resultados reales, no según promesas de marketing.
SD 3.5 Large: el referente de realismo
Stable Diffusion 3.5 Large ocupa el primer puesto del ranking de 2027 por una razón: maneja escenas complejas con varios sujetos sin desmoronarse. La arquitectura de tercera generación introdujo un enfoque distinto para la compresión del espacio latente, que se traduce directamente en una mejor textura de la piel y proporciones corporales más naturales.
Por qué lidera en 2027
El modelo responde muy bien a los descriptores de iluminación en los prompts. Si escribes "luz lateral de hora dorada", la produce de verdad, no una aproximación vaga. En el contenido NSFW, Stable Diffusion 3.5 Large maneja mejor que cualquier versión anterior de Stability AI las telas transparentes, el agua sobre la piel y las interacciones complejas de tejidos.
| Característica | SD 3.5 Large | SD 3.5 Medium | SD 3.5 Large Turbo |
|---|
| Realismo | ★★★★★ | ★★★★☆ | ★★★★☆ |
| Velocidad | Lenta | Media | Rápida |
| Necesidad de VRAM | Alta | Media | Alta |
| Ideal para | Renders finales | Borradores | Iteraciones rápidas |
Stable Diffusion 3.5 Large Turbo es la variante destilada de mayor velocidad, que sacrifica algo de fidelidad en el detalle a cambio de tiempo de generación. Sigue siendo excelente, pero el Stable Diffusion 3.5 Large completo gana cuando la prioridad es la calidad. Stable Diffusion 3.5 Medium es el punto ideal para quienes tienen hardware de gama media.
Mejores ajustes para este modelo
- Escala CFG: 6-7 para un resultado natural, 4-5 para una interpretación más creativa
- Pasos: 30-40 para calidad completa
- Muestreador: DPM++ 2M Karras o Euler a
- Prompt negativo: incluye siempre
deformed, blurry, bad anatomy, poorly drawn face, mutation, extra limbs
RealVisXL v3.0 Turbo: velocidad que aguanta
RealVisXL v3.0 Turbo se creó específicamente para generar humanos fotorrealistas. La base "XL" le da margen de resolución, y la destilación Turbo mantiene los tiempos de generación razonables.
Dónde brilla
Este modelo destaca especialmente en el renderizado de rostros. Donde muchos ajustes finos de SDXL producen un efecto de valle inquietante, RealVisXL v3.0 Turbo genera rostros que se leen de verdad como fotográficos. El detalle de los ojos ya es impresionante: reflejos en la córnea, variación natural del iris y una estructura realista de los párpados. Para el trabajo de retratos NSFW, probablemente sea el mejor generador de rostros del ecosistema SD en este momento.
Lo que maneja bien:
- Retratos en primer plano con textura de piel visible
- Varios sujetos en un mismo encuadre
- Escenas interiores con iluminación artificial
- Trajes de baño y lencería sobre fondos neutros
Donde tiene dificultades:
- Fondos exteriores muy complejos
- Rasgos faciales no europeos (ligero sesgo del entrenamiento)
- Planos muy abiertos
💡 Para mejores resultados, usa una resolución de 1024x576 o 1216x832 en salidas 16:9. Si hace falta, aumenta la resolución después con un modelo de superresolución.
Realistic Vision v5.1: el veterano que sigue rindiendo
Realistic Vision v5.1 es de esos modelos que se niegan a retirarse. Se lanzó hace varios años y se ha mantenido con regularidad, y cada versión corrige los problemas de la anterior.
Lo que hace bien
El conjunto de entrenamiento de Realistic Vision v5.1 está muy inclinado hacia la fotografía real y no hacia los renders artísticos. Esto da como resultado un modelo que genera imágenes fotográficas por defecto, sin que tengas que pelear con él. Frente a los modelos más nuevos, produce una piel algo más suave que a algunos usuarios les gusta para resultados de estilo glamour. Resulta menos clínico que los renders hiperdetallados de SD 3.5 Large y se parece más a la salida retocada de un fotógrafo profesional.
Puntos fuertes concretos:
- Escenas de dormitorio e interiores
- Lencería y trajes de baño sobre tipos de cuerpo realistas
- Anatomía de manos coherente (algo raro en los modelos SD)
- Generación rápida incluso en equipos con base SD 1.5
La contrapartida es el límite de resolución. v5.1 funciona con la arquitectura SD 1.5, que limita la salida nativa a 512x512 antes del escalado. Para los renders finales, pasa las imágenes por una fase de superresolución.
SDXL y sus mejores variantes
SDXL fue el cambio de arquitectura que lo cambió todo. El paso de 512 px a una resolución nativa de 1024 px dio a quienes hacen ajuste fino un lienzo mucho mejor con el que trabajar, y los resultados son evidentes.
SDXL Lightning 4Step
SDXL Lightning 4Step es una destilación de SDXL de ByteDance que genera imágenes de calidad completa en solo 4 pasos de muestreo. Suena demasiado bueno para ser verdad, pero los resultados compiten de verdad con SDXL estándar de 30 pasos. Para flujos de trabajo NSFW en los que iteras mucho, esta ventaja de velocidad es significativa. Puedes probar 20 prompts en el tiempo que tardas en hacer 5 con un checkpoint estándar.
💡 Con modelos de 4 pasos, mantén la escala CFG entre 1,5 y 2,5. Valores más altos generan artefactos y una saturación de color excesiva con tan pocos pasos.
SDXL Multi ControlNet LoRA
SDXL Multi ControlNet LoRA te da control estructural sobre tus generaciones. En el trabajo NSFW, esto importa más de lo que la mayoría cree. ControlNet te permite definir la pose, la posición del cuerpo y la composición antes de que el modelo complete los detalles. La combinación de ControlNet para el control de la pose con un checkpoint de SDXL ajustado para el realismo es una de las configuraciones más potentes de todo el ecosistema SD.
DreamShaper XL Turbo: el más versátil
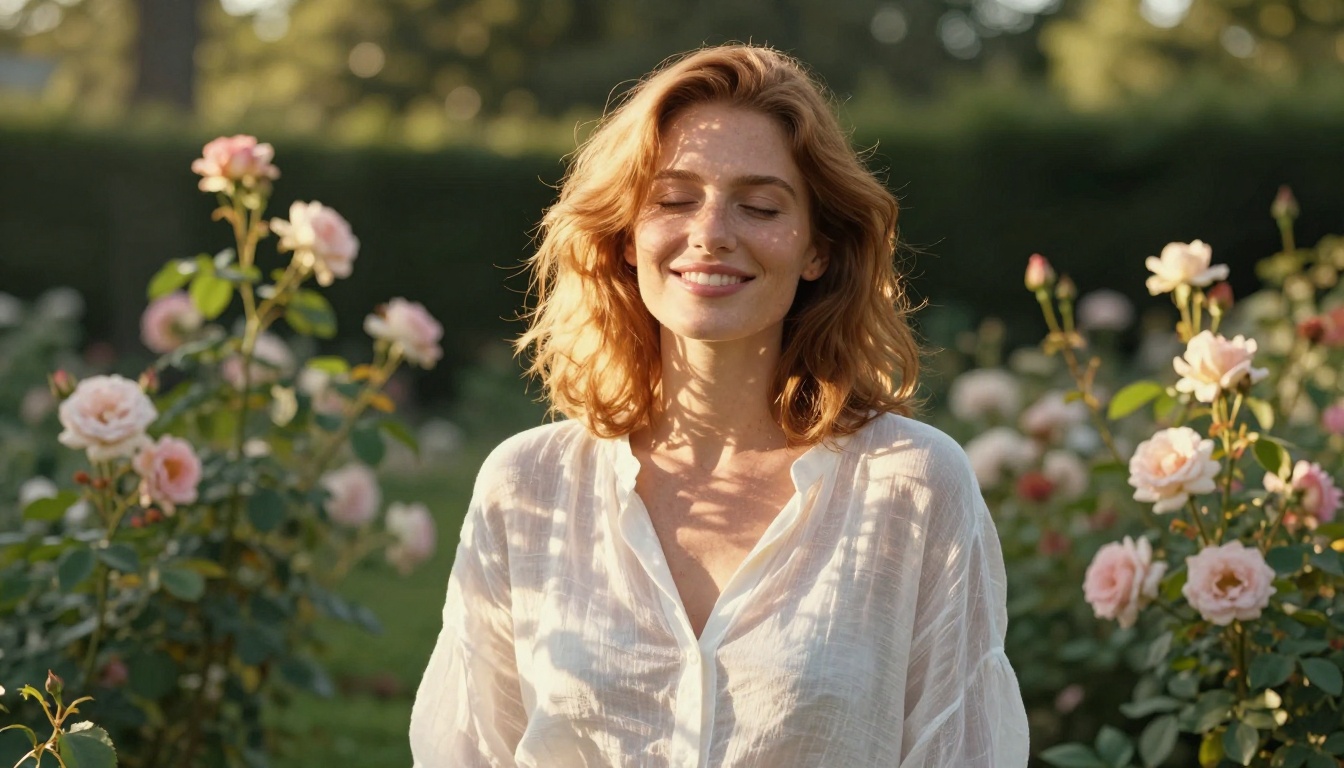
DreamShaper XL Turbo se sitúa en la intersección entre fotorrealismo y calidad artística, con imágenes que parecen salidas de una sesión de moda de alta gama y no de un fotógrafo documental.
La diferencia de DreamShaper
Donde modelos como Realistic Vision resultan fríos y clínicos, DreamShaper XL Turbo aplica una curva de calidez y saturación que favorece los tonos de piel. Esto no es un truco de filtro. Los datos de entrenamiento se seleccionaron para captar esta estética, lo que significa que el modelo la produce con regularidad en prompts distintos. Para el contenido NSFW de estilo glamour, los retratos al aire libre y el contenido con trajes de baño, DreamShaper a menudo supera a modelos más "precisos" técnicamente, simplemente porque el resultado resulta más atractivo visualmente.
Casos de uso ideales:
- Retratos a la hora dorada
- Imágenes NSFW cercanas a la moda
- Glamour artístico más que realismo clínico
- Cualquier escenario en el que la calidez y la estética importen más que la precisión técnica
| Modelo | Realismo | Estética | Velocidad | Resultado NSFW |
|---|
| SD 3.5 Large | 5/5 | 4/5 | 2/5 | Excelente |
| RealVisXL v3.0 Turbo | 5/5 | 4/5 | 4/5 | Excelente |
| Realistic Vision v5.1 | 4/5 | 4/5 | 5/5 | Muy bueno |
| SDXL Lightning 4Step | 4/5 | 3/5 | 5/5 | Bueno |
| DreamShaper XL Turbo | 4/5 | 5/5 | 4/5 | Muy bueno |
| Flux 1.1 Pro | 5/5 | 5/5 | 3/5 | Excelente |
Flux Dev y Flux 1.1 Pro: el nuevo estándar
Flux Dev de Black Forest Labs representa un enfoque distinto. En lugar de ajustar el ecosistema de Stability AI, la arquitectura Flux se construyó desde cero con prioridades de entrenamiento diferentes. El resultado es un modelo que sigue los prompts como ningún otro. Pides una prenda concreta, una pose concreta y una configuración de luz concreta, y Flux realmente lo entrega.
Flux 1.1 Pro
Flux 1.1 Pro es la versión de grado comercial, con mayor fidelidad y mejor renderizado de los detalles finos. En el trabajo NSFW concretamente, la mejora en el renderizado de tejidos es notable. El encaje, la seda, la tela mojada y los materiales transparentes se renderizan de forma más convincente en Flux 1.1 Pro que en la mayoría de las alternativas SD.
La arquitectura también maneja mejor los escenarios de luz mixta. Cuando hay luz cálida interior compitiendo con luz fría de ventana en una misma escena, Flux mantiene una interacción realista de la temperatura de color en lugar de mezclarlas en un promedio plano.
💡 Los modelos Flux responden mejor a descripciones en lenguaje natural que a prompts de SD cargados de palabras clave. En lugar de beautiful woman, 8k, photorealistic, bokeh, prueba a woman sitting by a window in the early morning, soft light on her face, quiet mood. La diferencia en la calidad del resultado se nota.
Flux 2 Pro es la última iteración, con un seguimiento de instrucciones aún mejor, y merece la pena probarlo para tus prompts más exigentes.
Proteus v0.3: cuando lo que buscas es anime
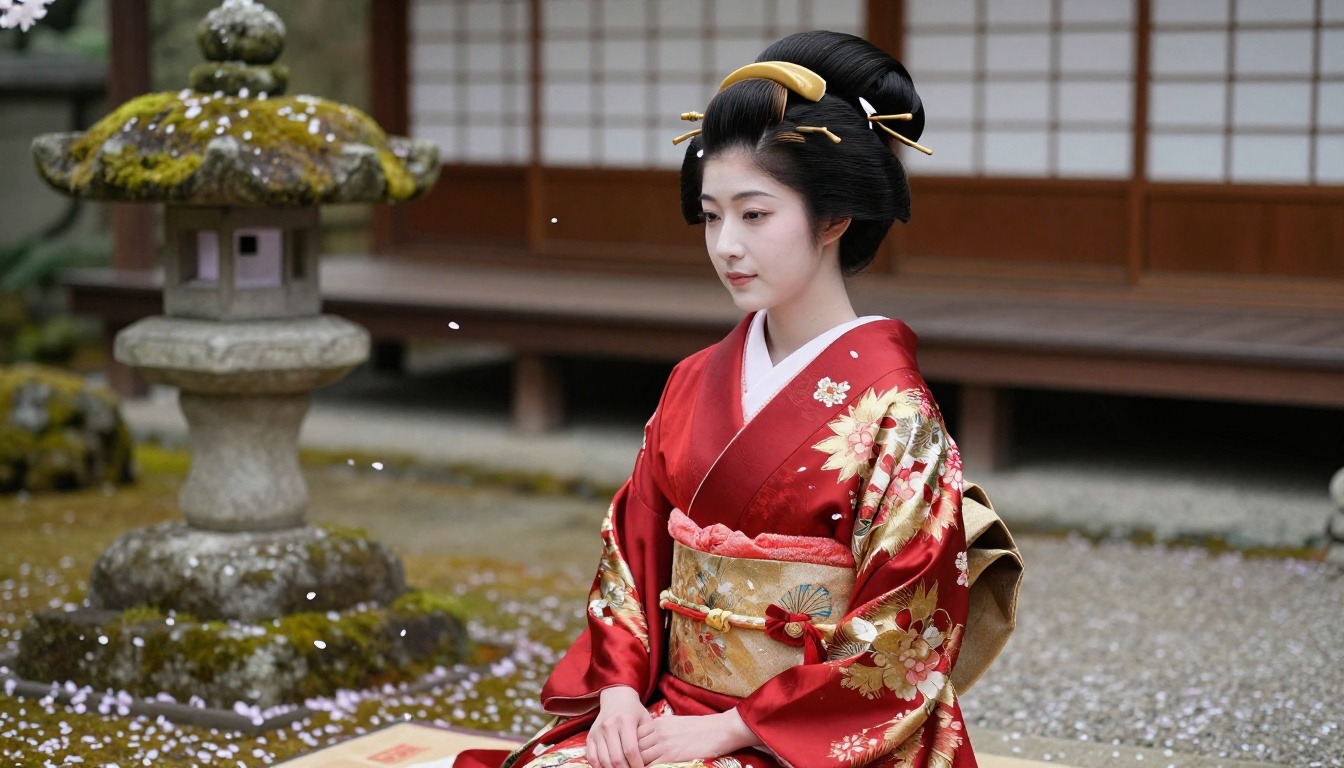
No todo el contenido NSFW busca el fotorrealismo. Proteus v0.3 ocupa el espacio del anime y lo semirrealista, generando resultados de estilo personaje con líneas limpias y proporciones estilizadas.
Si tu estética objetivo es el anime japonés, el arte de personajes de videojuegos o el glamour ilustrado, Proteus v0.3 supera a todos los modelos fotorrealistas de esta lista en ese tipo de salida. Los personajes se ven estilizados a propósito, lo que evita el problema de "casi humano pero no del todo" que aparece en los modelos fotorrealistas cuando se les lleva un poco fuera de su distribución. Proteus v0.2 es la versión anterior, con una paleta de color algo distinta que a algunos usuarios les gusta más.
Cómo elegir el modelo adecuado
La decisión se reduce a tres preguntas:
1. ¿Qué estilo de salida quieres?
2. ¿Cuánto hardware tienes?
3. ¿Qué contrapartida aceptas, velocidad o calidad?
💡 Ejecutar ControlNet junto con tu checkpoint principal añade una sobrecarga de VRAM considerable. Si estás cerca de tu límite de VRAM, SDXL Multi ControlNet LoRA está optimizado para esta configuración de varios modelos.
Mejores resultados con cualquier modelo
El modelo importa, pero la estrategia de prompts importa igual. Estas son algunas cosas que mejoran la calidad del resultado de forma constante en todos los modelos de esta lista:
La luz primero: empieza el prompt con tu configuración de iluminación. Los modelos responden a los descriptores de luz con mejoras dramáticas. "soft morning light from the left window" produce mejores resultados que no mencionar la luz en absoluto.
Sé específico con los materiales: en lugar de wearing a dress, escribe wearing a silk slip dress with thin straps. La especificidad del material ayuda a cualquier modelo a renderizar mejor los tejidos.
Usa los modificadores fotográficos con criterio: términos como Kodak Portra 400, 85mm f/1.4, film grain activan los datos de entrenamiento fotográfico de estos modelos. Funcionan porque los conjuntos de entrenamiento incluían metadatos de fotografía.
Los prompts negativos no son opcionales: todo flujo de trabajo NSFW necesita una lista sólida de prompts negativos. Como mínimo, incluye: deformed anatomy, extra fingers, blurry, watermark, text, bad proportions, distorted face, mutation.
Fijar la semilla: cuando consigas una composición que te gusta pero quieres variar la luz o el atuendo, fija la semilla y cambia solo un elemento del prompt cada vez. Así evitas cambios no deseados en las partes que ya funcionaban.
El modelo Playground v2.5 también merece una prueba si buscas un modelo centrado en la estética que prioriza una salida bonita sobre el realismo clínico.
Empieza a crear en PicassoIA
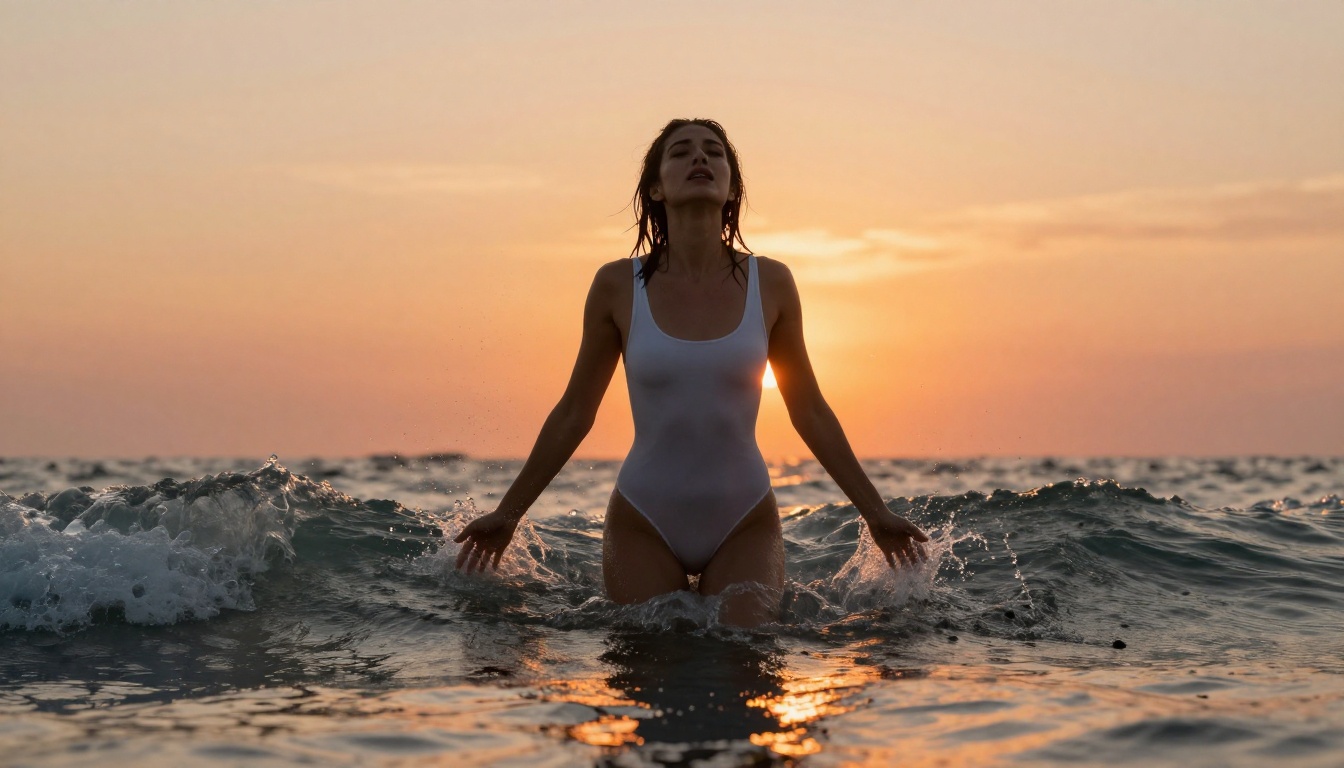
No necesitas una instalación local de ComfyUI ni descargar modelos para usar cualquiera de los modelos de esta lista. PicassoIA los ejecuta todos en la nube, sin requisitos de hardware por tu parte. La plataforma te permite cambiar de checkpoint al instante, lo que hace que comparar modelos sea realmente práctico. Puedes lanzar el mismo prompt con SD 3.5 Large, Flux 1.1 Pro y RealVisXL v3.0 Turbo en minutos y ver las diferencias una al lado de la otra.
Si quieres control de la pose, SDXL Multi ControlNet LoRA está disponible directamente. Para escalar la salida cuando ya tengas una imagen que te guste, los modelos de superresolución de la plataforma hacen escalados de 2x a 4x sin el emborronado de detalles que producen las herramientas más baratas.
Empieza con Stable Diffusion 3.5 Large si no sabes por dónde empezar. Es el modelo de esta lista más tolerante con prompts imperfectos y, aun así, produce resultados realmente impresionantes. Cuando tengas una fórmula de prompt que funcione, pásala por dos o tres de los otros modelos de la lista. El mismo prompt interpretado por DreamShaper XL Turbo frente a Flux 1.1 Pro te mostrará muy rápido qué dirección estética encaja con tu trabajo.


