Nem todo modelo de Stable Diffusion lida bem com prompts NSFW. Alguns produzem tons de pele barrentos, anatomia distorcida ou iluminação chapada que destrói o realismo que você busca. Em 2027, a diferença entre os de ponta e os medianos aumentou bastante. Esta análise corta o ruído e ranqueia os modelos que realmente entregam, com notas claras sobre quando usar cada um.
O que torna um modelo bom para NSFW
Nem todos os checkpoints de Stable Diffusion são treinados da mesma forma. Um modelo que se sai bem com paisagens pode desmoronar completamente ao gerar figuras humanas. Para conteúdo NSFW especificamente, você precisa de algumas coisas funcionando juntas:
- Precisão na renderização da pele: textura realista dos poros, subtons naturais, dispersão subsuperficial crível
- Consistência anatômica: proporções corretas, posicionamento coerente dos membros, sem mutações nos dedos
- Resposta à iluminação: como tecido, pele e cabelo interagem com fontes de luz direcionais
- Aderência ao prompt: ele faz o que você pede sem alucinar elementos aleatórios?
💡 O modelo é só metade da equação. A escala CFG, os passos de amostragem e os prompts negativos importam tanto quanto. Um modelo medíocre com ótimas configurações costuma superar um modelo excelente com prompts preguiçosos.
Os modelos abaixo foram ranqueados com base em resultados reais, não em promessas de marketing.
SD 3.5 Large: o padrão de realismo
Stable Diffusion 3.5 Large está no topo do ranking de 2027 por um motivo: ele lida com cenas complexas com vários sujeitos sem desmoronar. A arquitetura de terceira geração trouxe uma abordagem fundamentalmente diferente para a compressão do espaço latente, o que se traduz diretamente em melhor textura de pele e proporções corporais mais naturais.
Por que ele lidera em 2027
O modelo responde muito bem a descritores de iluminação nos prompts. Diga "luz lateral de hora dourada" e ele realmente a produz, não uma aproximação vaga. Para conteúdo NSFW, o Stable Diffusion 3.5 Large lida com tecidos transparentes, água sobre a pele e interações complexas de tecido melhor do que qualquer lançamento anterior da Stability AI.
| Recurso | SD 3.5 Large | SD 3.5 Medium | SD 3.5 Large Turbo |
|---|
| Realismo | ★★★★★ | ★★★★☆ | ★★★★☆ |
| Velocidade | Lenta | Média | Rápida |
| Necessidade de VRAM | Alta | Média | Alta |
| Melhor para | Renderizações finais | Rascunhos | Iterações rápidas |
Stable Diffusion 3.5 Large Turbo é a variante destilada de velocidade que troca um pouco de fidelidade de detalhes por tempo de geração. Continua excelente, mas o Stable Diffusion 3.5 Large completo vence quando a qualidade é a prioridade. O Stable Diffusion 3.5 Medium é o ponto ideal para quem tem hardware intermediário.
Melhores configurações para este modelo
- CFG Scale: 6-7 para resultados naturais, 4-5 para interpretação mais criativa
- Passos: 30-40 para qualidade total
- Amostrador: DPM++ 2M Karras ou Euler a
- Prompt negativo: sempre inclua
deformed, blurry, bad anatomy, poorly drawn face, mutation, extra limbs
RealVisXL v3.0 Turbo: velocidade que se sustenta
O RealVisXL v3.0 Turbo foi criado especificamente para a geração de humanos fotorrealistas. A base "XL" lhe dá margem de resolução, e a destilação Turbo mantém os tempos de geração razoáveis.
Onde ele brilha
Este modelo tem um ponto forte particular na renderização de rostos. Onde muitos fine-tunes de SDXL produzem um efeito de vale da estranheza, o RealVisXL v3.0 Turbo gera consistentemente rostos que parecem genuinamente fotográficos. O detalhe dos olhos já impressiona: brilhos de catchlight, variação natural da íris e estrutura realista da pálpebra. Para trabalhos de retrato NSFW, este é possivelmente o melhor gerador de rostos do ecossistema SD neste momento.
O que ele lida bem:
- Retratos em close com textura de pele visível
- Vários sujeitos em um único quadro
- Cenas internas com iluminação artificial
- Roupas de banho e lingerie sobre fundos neutros
Onde ele tem dificuldade:
- Fundos externos muito complexos
- Traços faciais não europeus (leve viés de treinamento)
- Planos abertos extremos
💡 Para melhores resultados, mantenha a resolução em 1024x576 ou 1216x832 para saídas 16:9. Faça upscaling depois com um modelo de super-resolução, se necessário.
Realistic Vision v5.1: o veterano que ainda entrega
O Realistic Vision v5.1 é um desses modelos que se recusa a sair de cena. Foi lançado há alguns anos e vem sendo mantido de forma consistente, com cada versão corrigindo os problemas da anterior.
O que ele acerta
O conjunto de dados de treinamento do Realistic Vision v5.1 é fortemente ponderado para fotografia real em vez de renderizações artísticas. Isso cria um modelo que tende ao resultado fotográfico sem que você precise lutar contra ele. Comparado a modelos mais novos, ele produz uma pele levemente mais suave, que alguns usuários preferem para resultados em estilo glamour. Ele parece menos clínico que as renderizações hiperdetalhadas do SD 3.5 Large e mais como a foto editada de um fotógrafo profissional.
Pontos fortes específicos:
- Quartos e cenas internas
- Lingerie e roupas de banho em tipos de corpo realistas
- Anatomia consistente das mãos (uma raridade em modelos SD)
- Geração rápida, mesmo em hardware com base SD 1.5
A contrapartida é o teto de resolução. A v5.1 roda na arquitetura SD 1.5, que limita a saída nativa a 512x512 antes do upscaling. Para renderizações finais, passe as saídas por uma etapa de super-resolução.
SDXL e suas melhores variantes
O SDXL foi a mudança de arquitetura que mudou tudo. A passagem de 512px para resolução nativa de 1024px deu aos fine-tuners uma tela muito melhor para trabalhar, e os resultados são evidentes.
SDXL Lightning 4Step
O SDXL Lightning 4Step é uma destilação do SDXL feita pela ByteDance que gera imagens de qualidade total em apenas 4 passos de amostragem. Isso parece bom demais para ser verdade, mas os resultados são genuinamente competitivos com o SDXL padrão de 30 passos. Para fluxos de geração NSFW em que você faz muita iteração, essa vantagem de velocidade é significativa. Você consegue testar 20 prompts no tempo que levaria para fazer 5 com um checkpoint padrão.
💡 Com modelos de 4 passos, mantenha a escala CFG entre 1,5 e 2,5. Valores mais altos criam artefatos e estouro de cor nessa contagem de passos.
SDXL Multi ControlNet LoRA
O SDXL Multi ControlNet LoRA lhe dá controle estrutural sobre suas gerações. Para trabalhos NSFW, isso importa mais do que a maioria das pessoas percebe. O ControlNet permite definir pose, posição do corpo e composição antes de o modelo preencher os detalhes. A combinação do ControlNet para controle de pose com um checkpoint SDXL ajustado para realismo é uma das configurações mais poderosas de todo o ecossistema SD.
DreamShaper XL Turbo: o rei da versatilidade
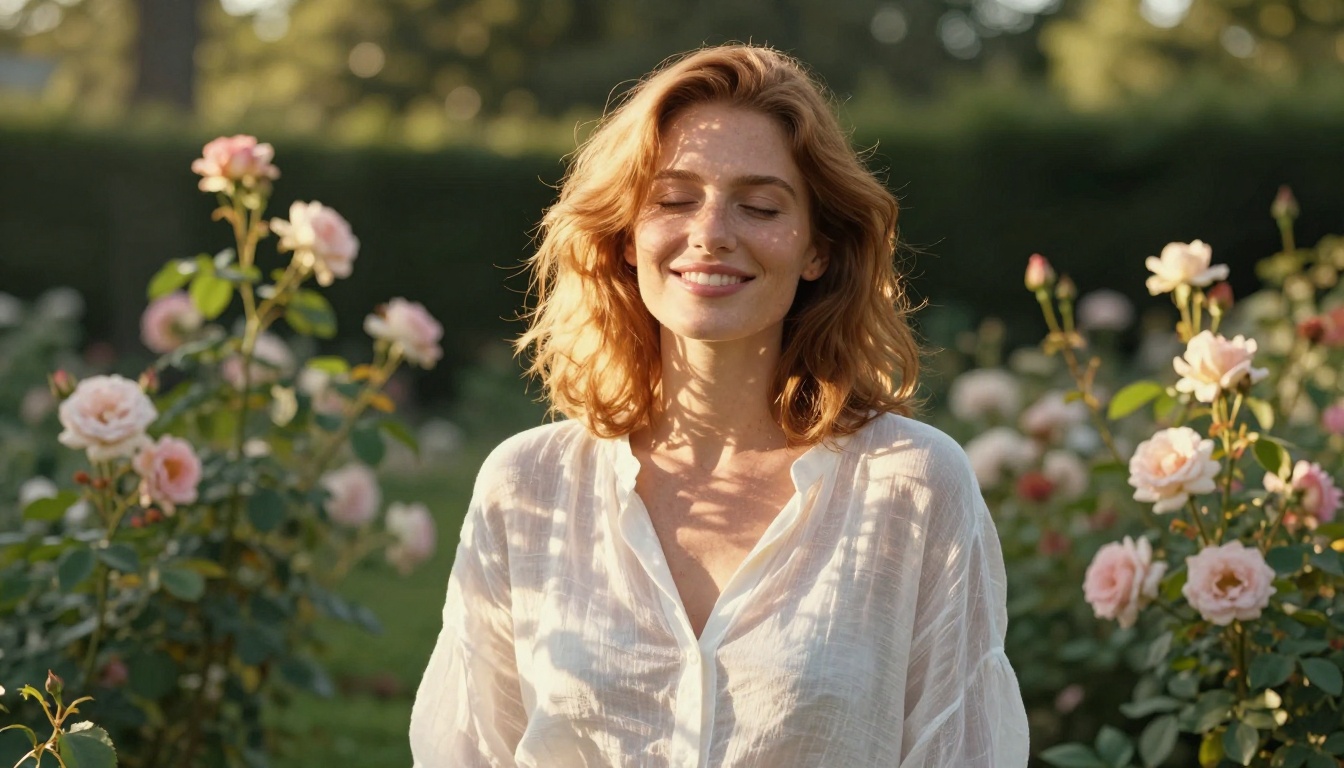
O DreamShaper XL Turbo fica na interseção entre fotorrealismo e qualidade artística, produzindo imagens que parecem ter saído de uma sessão de moda de alto nível, e não de um fotógrafo documental.
A diferença do DreamShaper
Onde modelos como o Realistic Vision tendem a ser frios e clínicos, o DreamShaper XL Turbo aplica uma curva de calor e saturação que favorece os tons de pele. Isso não é truque de filtro. Os dados de treinamento foram selecionados para capturar essa estética, o que significa que o modelo a produz de forma consistente em prompts variados. Para trabalhos NSFW em estilo glamour, retratos externos e conteúdo de roupas de banho, o DreamShaper frequentemente supera modelos tecnicamente mais "precisos", simplesmente porque o resultado é mais agradável visualmente.
Melhores casos de uso:
- Trabalhos de retrato na hora dourada
- Imagens NSFW de estilo próximo à moda
- Glamour artístico em vez de realismo clínico
- Qualquer cenário em que calor e estética importam mais que precisão técnica
| Modelo | Realismo | Estética | Velocidade | Resultado NSFW |
|---|
| SD 3.5 Large | 5/5 | 4/5 | 2/5 | Excelente |
| RealVisXL v3.0 Turbo | 5/5 | 4/5 | 4/5 | Excelente |
| Realistic Vision v5.1 | 4/5 | 4/5 | 5/5 | Muito bom |
| SDXL Lightning 4Step | 4/5 | 3/5 | 5/5 | Bom |
| DreamShaper XL Turbo | 4/5 | 5/5 | 4/5 | Muito bom |
| Flux 1.1 Pro | 5/5 | 5/5 | 3/5 | Excelente |
Flux Dev e Flux 1.1 Pro: o novo padrão
O Flux Dev, da Black Forest Labs, representa uma abordagem diferente. Em vez de fazer fine-tuning sobre o ecossistema da Stability AI, a arquitetura Flux foi construída do zero com outras prioridades de treinamento. O resultado é um modelo que segue o prompt como nenhum outro. Você pede uma roupa específica, uma pose específica, uma configuração de iluminação específica, e o Flux realmente entrega.
Flux 1.1 Pro
O Flux 1.1 Pro é a versão de nível comercial, com maior fidelidade e melhor renderização de detalhes finos. Para trabalhos NSFW especificamente, a melhora na renderização de tecidos é notável. Renda, seda, tecido molhado e materiais transparentes são todos renderizados de forma mais convincente no Flux 1.1 Pro do que na maioria das alternativas SD.
A arquitetura também lida melhor com cenários de iluminação mista. Quando há luz interna quente disputando com luz fria de janela em uma mesma cena, o Flux mantém uma interação realista de temperatura de cor, em vez de misturá-las em uma média chapada.
💡 Modelos Flux respondem melhor a descrições em linguagem natural do que a prompts SD carregados de palavras-chave. Em vez de beautiful woman, 8k, photorealistic, bokeh, experimente a woman sitting by a window in the early morning, soft light on her face, quiet mood. A diferença de qualidade do resultado é perceptível.
O Flux 2 Pro é a iteração mais recente, com seguimento de instruções ainda melhor. Vale a pena testar para seus prompts mais exigentes.
Proteus v0.3: quando o anime é o foco
Nem todo conteúdo NSFW busca fotorrealismo. O Proteus v0.3 ocupa o espaço do anime e do semirrealismo, produzindo saídas em estilo de personagem com traço limpo e proporções estilizadas.
Se seu estilo-alvo é a animação japonesa, a arte de personagens de jogos ou o glamour ilustrado, o Proteus v0.3 supera todos os modelos fotorrealistas desta lista para esse tipo de saída. Os personagens parecem estilizados de propósito, o que evita o problema do "quase humano, mas errado" que modelos fotorrealistas criam quando são levados um pouco para fora de sua distribuição. O Proteus v0.2 é a versão anterior, com uma paleta de cores ligeiramente diferente que alguns usuários preferem.
Como escolher o modelo certo
A decisão se resume a três perguntas:
1. Qual estilo de saída você quer?
2. Quanto hardware você tem?
3. Contrapartida entre velocidade e qualidade?
💡 Rodar o ControlNet junto com seu checkpoint principal adiciona muita sobrecarga de VRAM. Se você estiver perto do limite de VRAM, o SDXL Multi ControlNet LoRA é otimizado para essa configuração com vários modelos.
O modelo importa, mas a estratégia de prompt importa tanto quanto. Algumas coisas que melhoram de forma consistente a qualidade do resultado em todos os modelos desta lista:
Iluminação primeiro: comece o prompt pela sua configuração de iluminação. Os modelos respondem a descritores de iluminação com melhorias dramáticas de qualidade. "soft morning light from the left window" produz resultados melhores do que nenhuma menção à iluminação.
Seja específico com os materiais: em vez de wearing a dress, escreva wearing a silk slip dress with thin straps. A especificidade do material ajuda todos os modelos a produzir melhor renderização de tecidos.
Use modificadores fotográficos estrategicamente: termos como Kodak Portra 400, 85mm f/1.4, film grain ativam os dados de treinamento fotográfico desses modelos. Eles funcionam porque os conjuntos de treinamento incluíram metadados de fotografia.
Prompts negativos não são opcionais: todo fluxo de geração NSFW precisa de uma lista sólida de prompt negativo. No mínimo, inclua: deformed anatomy, extra fingers, blurry, watermark, text, bad proportions, distorted face, mutation.
Fixe a seed: quando você obtiver uma composição de que gosta, mas quiser variar a iluminação ou a roupa, fixe a seed e altere apenas um elemento do prompt por vez. Isso evita mudanças indesejadas nas partes que estavam funcionando.
O modelo Playground v2.5 também vale a tentativa se você quer um modelo focado em estética, que prioriza resultados bonitos em vez de realismo clínico.
Comece a criar no PicassoIA
Você não precisa de uma instalação local do ComfyUI nem de downloads de modelos para usar qualquer um dos modelos desta lista. O PicassoIA roda todos na nuvem, sem requisitos de hardware do seu lado. A plataforma permite trocar de checkpoint instantaneamente, o que torna a comparação de modelos genuinamente prática. Você pode rodar o mesmo prompt pelo SD 3.5 Large, pelo Flux 1.1 Pro e pelo RealVisXL v3.0 Turbo em minutos e ver as diferenças lado a lado.
Se você quer controle de pose, o SDXL Multi ControlNet LoRA está disponível diretamente. Para o upscaling de saída depois que você tiver uma imagem de que gosta, os modelos de super-resolução da plataforma fazem upscaling de 2x a 4x sem o borrão de detalhes que as ferramentas mais baratas produzem.
Comece pelo Stable Diffusion 3.5 Large se não tiver certeza por onde começar. Ele é o modelo mais tolerante desta lista para prompts imperfeitos e, ao mesmo tempo, produz saídas genuinamente impressionantes. Depois que tiver uma fórmula de prompt que funcione, passe-a por dois ou três outros modelos desta lista. O mesmo prompt interpretado pelo DreamShaper XL Turbo versus pelo Flux 1.1 Pro mostrará muito rapidamente qual direção estética é a certa para o seu trabalho.


