GPT Image 2 llegó sin hacer mucho ruido, pero su impacto en la creación visual con IA es de todo menos discreto. El último modelo de generación de imágenes de OpenAI supone el salto de calidad más notable que la compañía ha lanzado desde el DALL-E original, y si has usado antes cualquier generador de imágenes, notarás la diferencia enseguida. Las mejoras afectan a las tres áreas que históricamente han lastrado a las imágenes de IA: el renderizado de texto, el fotorrealismo y la fidelidad al prompt. Hoy las tres están resueltas, y las consecuencias prácticas son importantes.
Qué es GPT Image 2 realmente
GPT Image 2 es el modelo independiente de síntesis de imágenes de segunda generación de OpenAI, diseñado para producir imágenes fotorrealistas a partir de prompts en lenguaje natural. Funciona de forma distinta a las capacidades de imagen integradas en GPT-4o: es un modelo visual creado con ese fin, no un módulo de visión acoplado a un modelo de lenguaje.
El modelo acepta prompts de texto y devuelve imágenes de alta resolución en varias relaciones de aspecto. Admite flujos de edición como el inpainting (rellenar zonas de una imagen), el outpainting (ampliar el lienzo más allá de sus límites originales) y el reemplazo de objetos, por lo que es mucho más que una simple herramienta de texto a imagen. Piensa en él como un sistema completo de creación y manipulación de imágenes que se controla con lenguaje natural.
De GPT Image 1 a GPT Image 2
El GPT Image 1 original ya competía con Midjourney y Stable Diffusion en su lanzamiento. Pero tenía debilidades bien documentadas: el renderizado de texto no era fiable, el fotorrealismo se desmoronaba en escenas complejas con varios sujetos y la fidelidad al prompt era irregular en cualquier composición que fuera más allá de lo simple.
GPT Image 2 resuelve los tres problemas con mejoras de arquitectura que se notan de inmediato en los resultados. No es un parche menor. El modelo se reentrenó con un conjunto de datos mucho más grande y más cuidado, con un enfoque específico en la tipografía legible, la anatomía humana coherente y la fidelidad compositiva. En la práctica, los resultados que antes requerían 20 intentos ahora llegan en la primera o la segunda generación.
La arquitectura multimodal nativa
A diferencia de su predecesor, GPT Image 2 usa una arquitectura visión-lenguaje profundamente integrada, en lugar de tratar la imagen y el texto como flujos separados. Esto significa que el modelo interpreta tu prompt a nivel semántico, no solo emparejando palabras clave con un espacio latente de imágenes.
Cuando escribes "una mujer segura de sí misma en una cafetería con luz de tarde", el modelo procesa a la vez el estado de ánimo, la hora del día, el contexto atmosférico y las decisiones de composición implícitas. Esa interpretación global es la razón por la que los prompts complejos y por capas ahora producen resultados coherentes, en lugar de imágenes fragmentadas donde algunos elementos del prompt aparecen y otros desaparecen por completo.
Las novedades que importan
Tres novedades destacan como verdaderamente nuevas frente a la generación anterior. Cada una resuelve un problema que ha frustrado durante años a quienes usan IA para imágenes y abre flujos de trabajo que antes no eran viables.
Un texto que parece escrito por una persona
Todos los generadores de imágenes anteriores a GPT Image 2 han tenido alguna versión del mismo fallo: el texto de las imágenes generadas se ve deformado. Carteles con letras revueltas. Menús que se difuminan hasta convertirse en ruido visual. Camisetas con caracteres tipográficos que no pertenecen a ningún alfabeto conocido.
GPT Image 2 lo resuelve. El modelo renderiza el texto legible de forma nativa, lo que significa que puedes especificar palabras o frases en tu prompt y aparecerán correctamente en el resultado. Esto abre una gama enorme de casos de uso comerciales y creativos: maquetas de producto con nombres de marca reales, gráficos para redes sociales con titulares legibles, imágenes de marca en las que la tipografía forma parte de la composición e ilustraciones editoriales donde las palabras tienen significado.
Consejo: Mantén el texto solicitado corto y concreto. Prompts como "un letrero de tienda que dice OPEN" funcionan mejor que párrafos largos. El modelo maneja de 1 a 4 palabras con una precisión casi perfecta y funciona bien con frases cortas de 8 a 10 palabras.
Fotorrealismo a un nuevo nivel
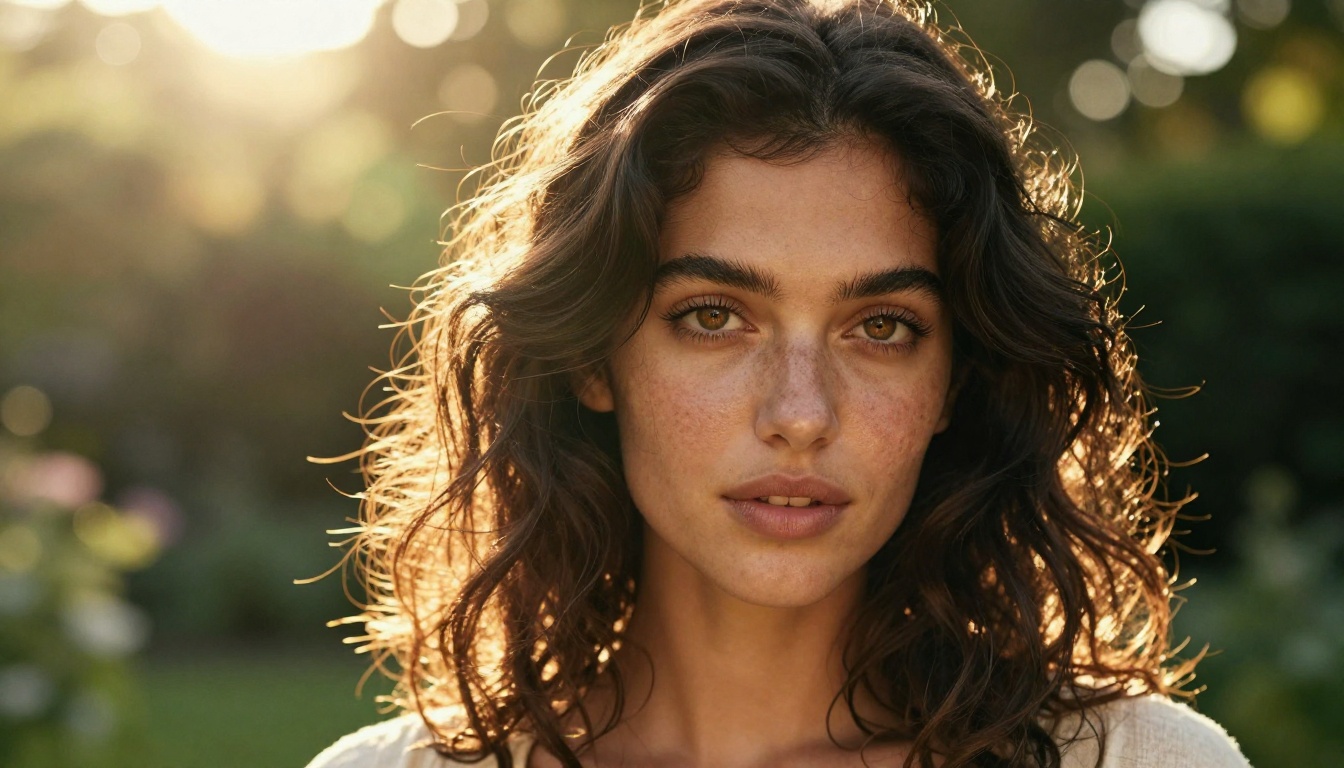
Las mejoras de fotorrealismo de GPT Image 2 se notan sobre todo en retratos y fotografía de primer plano. La textura de la piel, el detalle del cabello y la respuesta a la luz se renderizan con una fidelidad que, en una inspección visual rápida, pasa por fotografía. Los iris muestran variaciones de color realistas. Los mechones de pelo captan la luz uno a uno. La piel presenta microdetalles, como los poros y la textura fina, en lugar de las superficies suavizadas y con aspecto de plástico que son habituales en modelos anteriores.
Esto no significa que el modelo produzca resultados perfectos siempre. Las escenas complejas con varios sujetos humanos todavía generan de vez en cuando pequeñas incoherencias. Pero en retratos de un solo sujeto, fotografía de producto y paisajes, el techo de calidad es mucho más alto que en GPT Image 1.
El modelo también maneja la luz con mucha más precisión. Indica "luz dorada de última hora de la tarde desde la izquierda" y las sombras, las luces altas, la temperatura de color y los reflejos especulares de todos los elementos de la escena responderán correctamente. La luz ya no es un mero trámite en el resultado; es un elemento compositivo activo que el modelo realmente controla.
Un seguimiento del prompt que cumple
La tercera mejora importante es menos visible, pero igual de relevante: GPT Image 2 es significativamente más preciso al interpretar y ejecutar prompts complejos con varias cláusulas.
Los modelos anteriores solían fijarse en una o dos palabras dominantes del prompt e ignorar el resto. Pedías una mujer con un abrigo rojo caminando por una calle empedrada bajo la lluvia y obtenías una mujer de pie en algún interior, con ropa corriente. GPT Image 2 procesa el prompt completo de forma jerárquica, dando peso a los modificadores, al contexto de la escena y a las instrucciones de estilo con más fidelidad. Los prompts más largos y descriptivos producen con regularidad mejores resultados, en lugar de confundir al modelo de vez en cuando.
Cómo se compara con la competencia
GPT Image 2 entra en un terreno muy competido. Los modelos Flux, Stable Diffusion y otros tienen comunidades sólidas y flujos de trabajo consolidados. Así se compara en las dimensiones que más importan a los creadores profesionales.
| Característica | GPT Image 2 | Flux Kontext Fast | Flux Redux Dev |
|---|
| Renderizado de texto | Excelente | Bueno | Aceptable |
| Fotorrealismo de retrato | Excelente | Muy bueno | Muy bueno |
| Precisión del prompt | Excelente | Bueno | Bueno |
| Edición de imagen (inpaint/outpaint) | Sí | Sí | Limitada |
| Velocidad | Rápida | Muy rápida | Rápida |
| Variedad de estilos | Moderada | Alta | Alta |
| Texto nativo en el resultado | Sí | Parcial | Parcial |
GPT Image 2 frente a Flux Kontext Fast
Flux Kontext Fast es uno de los modelos de edición de imagen más rápidos disponibles y destaca en flujos de manipulación fotográfica. Si trabajas con imágenes existentes y necesitas modificar elementos concretos con rapidez, Flux Kontext Fast tiene una ventaja real y útil en velocidad e iteración.
GPT Image 2 tiene ventaja para generar imágenes desde cero, sobre todo cuando el fotorrealismo y la precisión del prompt son prioritarios. En cuanto al renderizado de texto nativo, la comparación no tiene discusión: GPT Image 2 lo maneja de forma fiable, mientras que Flux Kontext Fast trata el texto como un añadido.
Elegir la herramienta adecuada para cada tarea
- Usa GPT Image 2 para: retratos fotorrealistas, fotos de producto, imágenes con texto legible, visuales de marketing que requieran composiciones concretas, imágenes editoriales
- Usa Flux Kontext Fast para: edición fotográfica rápida, transferencias de estilo rápidas, flujos de variaciones iterativas, proyectos en los que la velocidad es crítica
- Usa Flux Redux Dev para: generar variaciones de imagen a partir de una referencia, explorar estilos creativos, crear series de imágenes con un ADN visual coherente
La buena noticia es que no tienes que elegir solo uno. En PicassoIA, los tres están disponibles en la misma interfaz, así que cambiar entre ellos según la tarea lleva segundos.
Cómo usar GPT Image 2 en PicassoIA
PicassoIA te da acceso directo a GPT Image 2 sin necesidad de una cuenta de API de OpenAI ni de ninguna configuración técnica. Este es el proceso exacto, desde abrir la página hasta tu primer resultado.
Paso 1: Abre la página del modelo
Ve a GPT Image 2 en PicassoIA. Verás el campo para escribir el prompt, el selector de relación de aspecto y los parámetros avanzados opcionales. Sin configurar claves de API, sin CLI y sin más configuración de cuenta que crear tu cuenta de PicassoIA.
Paso 2: Escribe tu prompt
Escribe tu prompt en el campo de entrada. Sé descriptivo y concreto. Cada detalle relevante que añadas le da más información al modelo con la que trabajar. Incluye:
- Sujeto: quién o qué aparece en la imagen, con detalles físicos concretos
- Escenario: ubicación, entorno, contexto arquitectónico, hora del día
- Iluminación: dirección, calidad (suave, dura), temperatura de color (hora dorada, nublado, sol de mediodía)
- Ángulo de cámara: primer plano, plano general, aérea, contrapicado, a la altura de los ojos
- Objetivo y profundidad: distancia focal, apertura para la sensación de profundidad de campo
- Textura y atmósfera: grano de película, acabados de materiales, ambiente
Ejemplo de prompt: "Una mujer con una chaqueta de lino color crema sentada en una terraza soleada de una cafetería de París, luz matinal natural desde la izquierda que crea sombras suaves, objetivo de retrato de 85mm, profundidad de campo reducida con bokeh de una calle de fondo, textura de piel visible y detalle fino del cabello, grano de película Kodak Portra 400, RAW 8K fotorrealista"
Paso 3: Ajusta los parámetros
GPT Image 2 en PicassoIA ofrece controles clave que modifican el resultado de forma notable:
| Parámetro | Qué hace | Punto de partida recomendado |
|---|
| Relación de aspecto | Define las dimensiones de la imagen | 16:9 para paisaje, 1:1 para redes sociales, 9:16 para historias y reels |
| Calidad | Controla el nivel de detalle del render | Alta para resultados finales, Estándar para borradores |
| Número de imágenes | Genera varias variaciones | 3-4 para la exploración inicial de un prompt nuevo |
Paso 4: Descarga y usa tu imagen
Cuando la imagen se genere (normalmente entre 10 y 25 segundos según la configuración), haz clic en descargar. El resultado es una imagen de alta resolución lista para usar directamente en presentaciones, publicaciones en redes, sitios web, plataformas de anuncios o impresión. No hace falta posprocesado en la mayoría de los casos.
Consejo: Genera 3-4 variaciones de tu primer prompt antes de refinar la redacción. Las distintas semillas aleatorias producen interpretaciones notablemente diferentes, y a menudo encontrarás una que se ajusta a tu visión mejor de lo que esperabas en la primera pasada.
Prompts que de verdad funcionan
La diferencia entre un resultado mediocre y uno espectacular con GPT Image 2 casi siempre depende de la calidad del prompt. El modelo responde bien a descripciones concretas y por capas. Los prompts vagos producen resultados genéricos y olvidables.
La anatomía de un prompt sólido
Piensa en tu prompt como un encargo a un fotógrafo. No le darías un encargo de una sola palabra. Describirías el sujeto, el lugar, la luz, el ángulo, el ambiente y el estilo. Aplica esa misma precisión a los prompts de texto a imagen.
Estructura a seguir: [Subject with physical details] [Environment and setting] [Lighting direction and quality] [Camera angle and lens] [Texture and atmosphere] [Style reference]
Prompt débil: "Una mujer en una cafetería"
Prompt sólido: "Una mujer con el pelo castaño oscuro por los hombros leyendo un libro de bolsillo en una mesa pequeña y redonda de una cafetería tranquila de París, luz matinal cálida desde una gran ventana a su derecha, 50mm f/1.8, profundidad de campo reducida, bokeh suave de una calle de fondo, textura de papel visible en las páginas del libro, detalle de los poros de la piel, grano de película Kodak Portra 400, fotorrealista"
La versión sólida aporta al modelo información sobre el sujeto, el escenario, la luz, el objetivo, la profundidad de campo, la textura y el estilo. Cada cláusula reduce el espacio de resultados hacia lo que realmente quieres.
5 plantillas de prompt listas para usar
1. Fotografía de retrato
"Retrato en primer plano de [descripción de la persona] en [escenario], luz [dirección de la luz] desde la [izquierda/derecha], objetivo de 85mm f/1.8, profundidad de campo reducida con fondo bokeh, textura de piel visible y detalle fino del cabello, fotorrealista, grano de película Kodak Portra 400, RAW 8K"
2. Foto de producto
"Fotografía profesional de producto de [descripción del producto] sobre [material de la superficie], ángulo [cenital/lateral/de 45 grados], iluminación de estudio suave y difusa con sombras uniformes, fondo [blanco/oscuro/de mármol], objetivo de 50mm, fotografía comercial, mucho detalle"
3. Paisaje
"Fotografía de paisaje gran angular de [descripción del lugar], [hora del día], luz volumétrica de [hora dorada/mañana/hora azul], 24mm f/8, profundidad de campo amplia, tonos de color naturales, sin aumento de saturación, RAW 8K, fotorrealista"
4. Interior
"Fotografía de interior de un [tipo de habitación] con [rasgos de diseño clave], luz natural desde [dirección de la ventana], objetivo gran angular de 35mm, estilo de fotografía de arquitectura, tonos [cálidos/fríos], texturas de madera y tela visibles, composición limpia"
5. Imagen con texto (especialidad de GPT Image 2)
"Un [objeto: escaparate/etiqueta de producto/valla publicitaria] con el texto [tu texto exacto] escrito en [sans serif limpia/caligrafía manuscrita/fuente display en negrita], [descripción del escenario], [iluminación], fotorrealista, mucho detalle, tipografía nítida"
Dónde encaja GPT Image 2 en el trabajo real
Las mejoras de fotorrealismo y precisión del prompt de GPT Image 2 se traducen directamente en flujos de trabajo profesionales concretos. Tres áreas en particular son las que más rápido se están adoptando en el mundo real.
Publicidad y creatividades de marketing
Las imágenes de campaña son uno de los casos de uso inmediatos más claros. Los directores de arte usan GPT Image 2 para generar imágenes principales para anuncios digitales, hacer pruebas A/B con distintos conceptos visuales sin programar una sesión de fotos y producir imágenes de temporada o de campaña bajo demanda.
La capacidad de renderizar texto nativo es especialmente valiosa en anuncios conceptuales donde el titular aparece sobre la imagen. Antes, ese flujo requería que un diseñador gráfico superpusiera el texto sobre un fondo generado en otra herramienta. Ahora ocurre en un único prompt, en un solo paso de generación.
Combinado con las herramientas de eliminación de fondo y de superresolución de PicassoIA, el paso de resultado a material listo para usar se reduce de días a minutos.
Contenido para redes sociales
Los feeds de Instagram, LinkedIn y Pinterest favorecen mucho las imágenes fotorrealistas y aspiracionales. GPT Image 2 genera ese contenido a escala sin que una marca tenga que mantener una suscripción a bancos de imágenes ni programar sesiones de fotos recurrentes para cada campaña.
Para las marcas que necesitan una identidad visual coherente en todas sus publicaciones, la mejor adherencia al prompt permite describir con precisión una estética recurrente, como tonos cálidos de la mañana, un estilo de encuadre concreto y un carácter de iluminación coherente, y reproducirla de forma fiable en decenas de imágenes distintas sin empezar de cero cada vez.
Maquetas de producto y comercio electrónico
Mostrar un producto en un contexto de estilo de vida exigía tradicionalmente una fotografía de producto física. GPT Image 2 puede colocar descripciones de producto en escenas fotorrealistas creíbles, con la iluminación, el comportamiento de las sombras y la interacción con las superficies correctos. La capacidad de renderizar texto se encarga de las etiquetas de envase y los nombres de marca de los productos, algo que era un obstáculo insalvable para los modelos de imagen anteriores en este flujo.
Para las marcas en fase inicial que todavía no han fabricado su producto físico, esto significa generar recursos visuales convincentes para presentaciones a inversores, campañas de preventa y validación del concepto antes de que exista una sola unidad.
Empieza a crear ahora mismo
GPT Image 2 es una de esas herramientas en las que la forma más rápida de entenderla es escribir algo en el campo del prompt y ver qué sale. Las mejoras frente a los modelos de generación anterior se notan en el primer resultado, no después de semanas aprendiendo el sistema.
GPT Image 2 está disponible directamente en PicassoIA junto con más de 90 otros modelos de texto a imagen. Si quieres comparar resultados entre modelos, puedes lanzar el mismo prompt en Flux Kontext Fast y Flux Redux Dev en minutos y ver la diferencia por ti mismo.
Cuando tengas imágenes que te gusten, las herramientas de superresolución de PicassoIA pueden escalarlas a dimensiones listas para imprimir, y la función de eliminación de fondo quita los fondos para hacer composiciones limpias con un solo clic. Todo el flujo, desde la idea hasta el recurso visual listo para producción, cabe en una sola plataforma.
Elige una de las plantillas de prompt de este artículo, cambia el sujeto y el escenario por los tuyos y mira qué genera GPT Image 2. La primera imagen que generes no será la última.


