O GPT Image 2 chegou sem alarde, mas seu impacto na criação visual com IA não tem nada de discreto. O modelo de geração de imagens mais recente da OpenAI representa o salto de qualidade mais expressivo que a empresa lançou desde o DALL-E original, e se você já usou qualquer gerador de imagens, vai notar a diferença de imediato. As melhorias atacam as três áreas que historicamente seguraram as imagens feitas por IA: renderização de texto, fotorrealismo e fidelidade ao prompt. As três estão resolvidas agora, e as implicações práticas são substanciais.
O que é o GPT Image 2, de fato
O GPT Image 2 é o modelo independente de síntese de imagens de segunda geração da OpenAI, criado para produzir imagens fotorrealistas a partir de prompts em linguagem natural. Ele funciona de forma diferente dos recursos de imagem embutidos no GPT-4o: trata-se de um modelo visual construído com esse propósito, e não de um módulo de visão acoplado a um modelo de linguagem.
O modelo aceita prompts de texto e devolve imagens em alta resolução em várias proporções. Ele oferece suporte a fluxos de edição, incluindo inpainting (preencher áreas de uma imagem), outpainting (expandir a tela além dos limites originais) e substituição de objetos, o que o torna muito mais do que uma simples ferramenta de texto para imagem. Pense nele como um sistema completo de criação e manipulação de imagens acessado por linguagem comum.
Do GPT Image 1 ao GPT Image 2
O GPT Image 1 original já era competitivo com o Midjourney e o Stable Diffusion no lançamento. Mas tinha fraquezas bem documentadas: a renderização de texto não era confiável, o fotorrealismo se desfazia em cenas complexas com vários sujeitos, e a aderência ao prompt era inconsistente em qualquer coisa além de composições simples.
O GPT Image 2 resolve os três com melhorias de arquitetura que aparecem de imediato nos resultados. Não é um simples ajuste menor. O modelo foi retreinado com um conjunto de dados substancialmente maior e mais curado, com foco específico em tipografia legível, anatomia humana coerente e fidelidade de composição. Na prática, resultados que antes exigiam 20 tentativas para acertar agora saem na primeira ou na segunda geração.
A arquitetura multimodal nativa
Diferentemente do antecessor, o GPT Image 2 usa uma arquitetura visão-linguagem profundamente integrada, em vez de tratar imagem e texto como pipelines separados. Isso significa que o modelo interpreta seu prompt em nível semântico, e não apenas associando palavras-chave da superfície a um espaço de imagem latente.
Quando você escreve "uma mulher confiante em um café sob luz da tarde", o modelo processa ao mesmo tempo o humor, a hora do dia, o contexto atmosférico e as escolhas de composição implícitas. Essa interpretação holística é o motivo pelo qual prompts complexos e em camadas agora produzem resultados coerentes, em vez de imagens fragmentadas nas quais alguns elementos do prompt aparecem e outros desaparecem por completo.
Os novos recursos que importam
Três recursos se destacam como verdadeiramente novos em relação à geração anterior. Cada um resolve um problema que frustra os usuários de IA para imagens há anos e destrava fluxos de trabalho que antes simplesmente não eram viáveis.
Texto que parece ter sido escrito por uma pessoa
Todo gerador de imagens anterior ao GPT Image 2 tinha alguma versão da mesma falha: o texto nas imagens geradas saía embaralhado. Placas com letras misturadas. Cardápios que se transformam em ruído visual. Camisetas com caracteres tipográficos que não pertencem a nenhum alfabeto conhecido.
O GPT Image 2 resolve isso. O modelo renderiza texto legível de forma nativa, o que significa que você pode especificar palavras ou frases no prompt e elas aparecerão corretamente no resultado. Isso abre uma enorme gama de casos de uso comerciais e criativos: mockups de produtos com nomes de marcas reais, gráficos para redes sociais com manchetes legíveis, imagens de marca em que a tipografia faz parte da composição e ilustrações editoriais em que as palavras carregam significado.
Dica: Mantenha curto e específico o texto que você pede. Prompts como "uma fachada de loja com uma placa escrita OPEN" funcionam melhor do que parágrafos longos. O modelo lida com 1 a 4 palavras com precisão quase perfeita e tem bom desempenho com frases curtas de 8 a 10 palavras.
Fotorrealismo em um novo patamar
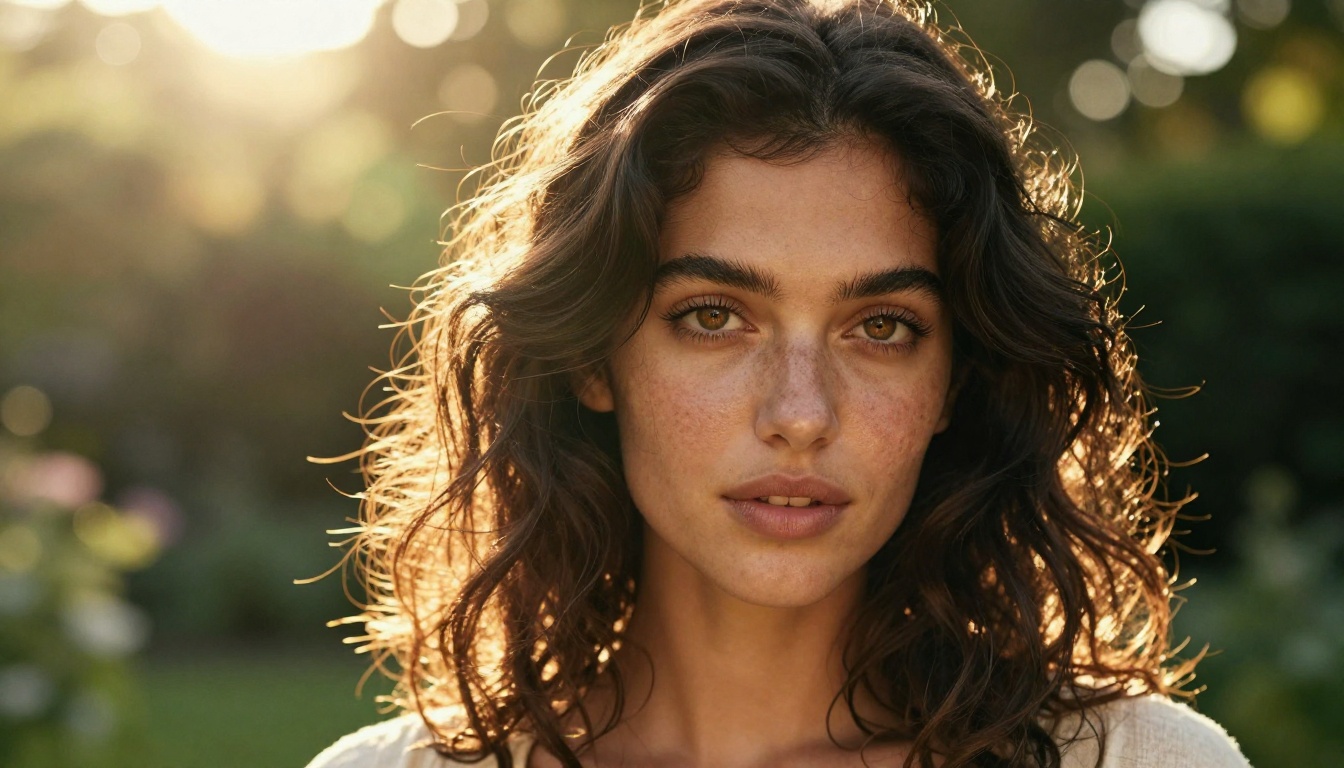
As melhorias de fotorrealismo do GPT Image 2 são mais evidentes em retratos e fotografias em close. A textura da pele, os detalhes do cabelo e a resposta à luz são renderizados com uma fidelidade que de fato passa numa inspeção visual rápida como fotografia. As íris mostram variação realista de cor. Os fios de cabelo captam a luz individualmente. A pele apresenta microdetalhes, incluindo poros e textura fina, em vez das superfícies suavizadas e com aparência de plástico comuns em modelos anteriores.
Isso não significa que o modelo produza resultados perfeitos todas as vezes. Cenas complexas com vários sujeitos humanos ainda produzem, ocasionalmente, pequenas inconsistências. Mas, em retratos com um único sujeito, fotografia de produto e paisagens, o teto de qualidade é dramaticamente mais alto do que no GPT Image 1.
O modelo também trata a iluminação com muito mais precisão. Especifique "luz dourada do fim da tarde vindo da esquerda" e as sombras, os realces, a temperatura de cor e os reflexos especulares de todos os elementos da cena vão responder corretamente. A iluminação deixa de ser apenas um item de checklist no resultado; ela se torna um elemento de composição ativo que o modelo de fato controla.
Seguir o prompt, de verdade
A terceira grande melhoria é menos visível, mas igualmente impactante: o GPT Image 2 é significativamente mais preciso ao interpretar e executar prompts complexos, com várias orações.
Modelos anteriores costumavam se agarrar a uma ou duas palavras dominantes do prompt e ignorar o restante. Você pedia uma mulher com casaco vermelho caminhando por uma rua de paralelepípedos na chuva e recebia uma mulher parada em algum ambiente interno, com roupas comuns. O GPT Image 2 processa o prompt inteiro de forma hierárquica, atribuindo peso aos modificadores, ao contexto da cena e às instruções de estilo com mais fidelidade. Prompts mais longos e descritivos produzem resultados consistentemente melhores, em vez de confundir o modelo de vez em quando.
Como ele se sai diante da concorrência
O GPT Image 2 entra num campo competitivo. Os modelos Flux, o Stable Diffusion e outros têm comunidades fortes e fluxos de trabalho consolidados. Veja como ele se compara nas dimensões que mais importam para criadores que trabalham com isso.
| Recurso | GPT Image 2 | Flux Kontext Fast | Flux Redux Dev |
|---|
| Renderização de texto | Excelente | Bom | Razoável |
| Fotorrealismo de retrato | Excelente | Muito bom | Muito bom |
| Precisão do prompt | Excelente | Bom | Bom |
| Edição de imagem (inpaint/outpaint) | Sim | Sim | Limitado |
| Velocidade | Rápida | Muito rápida | Rápida |
| Variedade de estilos | Moderada | Alta | Alta |
| Texto nativo na saída | Sim | Parcial | Parcial |
GPT Image 2 ou Flux Kontext Fast
Flux Kontext Fast é um dos modelos de edição de imagem mais rápidos disponíveis e se destaca em fluxos de manipulação de fotos. Se você trabalha com imagens existentes e precisa modificar elementos específicos com rapidez, o Flux Kontext Fast tem uma vantagem de velocidade e de iteração que é real e útil.
O GPT Image 2 leva vantagem para gerar imagens do zero, sobretudo quando fotorrealismo e precisão do prompt são prioridades. Para a renderização nativa de texto, a comparação nem é disputada: o GPT Image 2 lida com isso de forma confiável, enquanto o Flux Kontext Fast trata o texto como um complemento.
Escolhendo a ferramenta certa para cada tarefa
- Use o GPT Image 2 para: retratos fotorrealistas, fotos de produtos, imagens com texto legível, visuais de marketing que exigem composições específicas, imagens editoriais
- Use o Flux Kontext Fast para: edição rápida de fotos, transferências de estilo ágeis, fluxos de variação iterativa, projetos em que a velocidade é crítica
- Use o Flux Redux Dev para: gerar variações de imagem a partir de uma referência, explorar estilos criativos, construir séries de imagens com um DNA visual consistente
A boa notícia é que você não precisa escolher apenas um. No PicassoIA, os três estão disponíveis na mesma interface, então alternar entre eles conforme a tarefa leva segundos.
Como usar o GPT Image 2 no PicassoIA
O PicassoIA dá acesso direto ao GPT Image 2 sem precisar de uma conta de API da OpenAI nem de qualquer configuração técnica. Veja o processo exato, da abertura da página até a sua primeira imagem.
Passo 1: abra a página do modelo
Acesse o GPT Image 2 no PicassoIA. Você verá o campo de prompt, o seletor de proporção e os parâmetros avançados opcionais. Nada de configuração de chave de API, nada de CLI, nenhuma configuração de conta além de criar sua conta no PicassoIA.
Passo 2: escreva seu prompt
Digite seu prompt no campo de entrada. Seja descritivo e específico. Cada detalhe relevante que você acrescenta dá ao modelo mais sinal para trabalhar. Inclua:
- Sujeito: quem ou o que está na imagem, com detalhes físicos específicos
- Cenário: local, ambiente, contexto arquitetônico, hora do dia
- Iluminação: direção, qualidade (suave, dura), temperatura de cor (luz dourada, céu nublado, sol do meio-dia)
- Ângulo da câmera: close, plano aberto, aéreo, contra-plongée, altura dos olhos
- Lente e profundidade: distância focal, abertura para a sensação de profundidade de campo
- Textura e atmosfera: granulação de filme, acabamentos de materiais, humor
Exemplo de prompt: "Uma mulher com jaqueta de linho creme sentada em um café de terraço ensolarado em Paris, luz natural da manhã vinda da esquerda criando sombras suaves, lente de retrato de 85mm, profundidade de campo rasa com cena de rua em bokeh ao fundo, textura visível da pele e detalhes finos do cabelo, granulação de filme Kodak Portra 400, RAW 8K fotorrealista"
Passo 3: ajuste os parâmetros
O GPT Image 2 no PicassoIA oferece controles principais que moldam bastante o resultado:
| Parâmetro | O que faz | Ponto de partida recomendado |
|---|
| Proporção | Define as dimensões da imagem | 16:9 para paisagem, 1:1 para redes sociais, 9:16 para stories/reels |
| Qualidade | Controla o nível de detalhe da renderização | Alta para resultados finais, Padrão para rascunhos |
| Número de imagens | Gera várias variações | 3 a 4 para a exploração inicial de um novo prompt |
Passo 4: baixe e use sua imagem
Quando a imagem terminar de ser gerada (normalmente entre 10 e 25 segundos, dependendo das configurações), clique em baixar. O resultado é uma imagem em alta resolução, pronta para uso direto em apresentações, posts, sites, plataformas de anúncios ou impressão. Na maioria dos casos, não é necessário nenhum pós-processamento.
Dica: Gere de 3 a 4 variações do seu primeiro prompt antes de refinar a redação. Seeds aleatórias diferentes produzem interpretações bem distintas, e você costuma encontrar uma que corresponde à sua visão melhor do que o esperado já na primeira rodada.
Prompts que realmente funcionam
A diferença entre uma imagem medíocre e uma imagem impressionante do GPT Image 2 quase sempre depende da qualidade do prompt. O modelo responde bem a descrições específicas e em camadas. Prompts vagos produzem resultados genéricos e esquecíveis.
A anatomia de um prompt forte
Pense no seu prompt como um briefing para um fotógrafo. Você não entregaria a um fotógrafo uma tarefa de uma palavra só. Você descreveria o sujeito, o local, a luz, o ângulo, o humor e o estilo. Aplique essa mesma especificidade aos prompts de texto para imagem.
Estrutura a seguir: [Subject with physical details] [Environment and setting] [Lighting direction and quality] [Camera angle and lens] [Texture and atmosphere] [Style reference]
Prompt fraco: "Uma mulher em um café"
Prompt forte: "Uma mulher de cabelo escuro na altura dos ombros lendo um livro de capa mole em uma mesinha redonda de um café francês tranquilo, luz quente da manhã vinda de uma janela grande à direita dela, 50mm f/1.8, profundidade de campo rasa, cena de rua em bokeh suave ao fundo, textura de papel visível nas páginas do livro, detalhe dos poros da pele, granulação de filme Kodak Portra 400, fotorrealista"
A versão forte dá ao modelo informações sobre sujeito, cenário, iluminação, lente, profundidade de campo, textura e estilo. Cada oração restringe o espaço de resultados na direção do que você realmente quer.
5 modelos de prompt prontos para uso
1. Fotografia de retrato
"Retrato em close de [descrição da pessoa] em [cenário], [direção da luz] vinda da [esquerda/direita], lente de 85mm f/1.8, profundidade de campo rasa com fundo em bokeh, textura visível da pele e detalhes finos do cabelo, fotorrealista, granulação de filme Kodak Portra 400, RAW 8K"
2. Foto de produto
"Fotografia profissional de produto de [descrição do produto] sobre [material da superfície], ângulo [de cima/lateral/45 graus], iluminação de estúdio suave e difusa com sombras uniformes, fundo [branco/escuro/mármore], lente de 50mm, fotografia comercial, muito detalhe"
3. Paisagem
"Fotografia de paisagem em grande angular de [descrição do local], [hora do dia], luz [dourada/da manhã/azul] volumétrica, 24mm f/8, profundidade de campo ampla, tons de cor naturais, sem aumento de saturação, RAW 8K, fotorrealista"
4. Interior
"Fotografia de interior de um [tipo de cômodo] com [principais características de design], luz natural vinda da [direção da janela], lente grande angular de 35mm, estilo de fotografia de arquitetura, tons [quentes/frios], texturas de madeira e tecido visíveis, composição limpa"
5. Imagem com texto (especialidade do GPT Image 2)
"Um [objeto: vitrine/rótulo de produto/outdoor] com o texto [seu texto exato] escrito em [sans-serif limpa/letra cursiva manuscrita/fonte de display em negrito], [descrição do cenário], [iluminação], fotorrealista, muito detalhe, tipografia nítida"
Onde o GPT Image 2 se encaixa no trabalho real
As melhorias de fotorrealismo e de precisão do prompt no GPT Image 2 se traduzem diretamente em fluxos de trabalho profissionais específicos. Três áreas, em particular, estão sendo adotadas no mundo real mais rapidamente.
Marketing e criativos de anúncios
As imagens de campanha são um dos casos de uso imediatos mais claros. Diretores de arte estão usando o GPT Image 2 para gerar imagens de destaque para anúncios digitais, testar diferentes conceitos visuais em A/B sem agendar um ensaio fotográfico e produzir imagens sazonais ou específicas de campanha sob demanda.
A capacidade nativa de renderização de texto é especialmente valiosa para anúncios conceituais em que o texto da manchete aparece sobre a imagem. Esse é um fluxo que antes exigia um designer gráfico para compor o texto sobre um fundo gerado, em uma ferramenta separada. Agora acontece em um único prompt, em uma única etapa de geração.
Combinado com as ferramentas de remoção de fundo e de super resolução do PicassoIA, o caminho do resultado até o material pronto para uso é reduzido de dias para minutos.
Conteúdo para redes sociais
Os feeds do Instagram, do LinkedIn e do Pinterest favorecem fortemente imagens fotorrealistas e aspiracionais. O GPT Image 2 gera esse conteúdo em escala, sem que a marca precise manter uma assinatura de banco de imagens nem agendar ensaios fotográficos recorrentes para cada campanha.
Para marcas que precisam de uma identidade visual consistente entre os posts, a melhor aderência ao prompt significa que você pode descrever com precisão uma estética recorrente, como tons quentes da manhã, um estilo específico de enquadramento e um caráter de luz consistente, e reproduzi-la de forma confiável em dezenas de imagens diferentes, sem começar do zero a cada vez.
Mockups de produtos e e-commerce
Mostrar um produto em contexto de estilo de vida exigia, tradicionalmente, fotografia física do produto. O GPT Image 2 consegue colocar descrições de produtos em cenas fotorrealistas críveis, com iluminação correta, comportamento de sombras e interação com superfícies. A renderização de texto dá conta de rótulos de embalagem e nomes de marca nos produtos, o que era um impedimento total para modelos de imagem anteriores nesse fluxo.
Para marcas em estágio inicial que ainda não fabricaram o produto físico, isso significa gerar ativos visuais convincentes para apresentações a investidores, campanhas de pré-venda e validação de conceito antes que exista uma única unidade.
Comece a criar agora mesmo
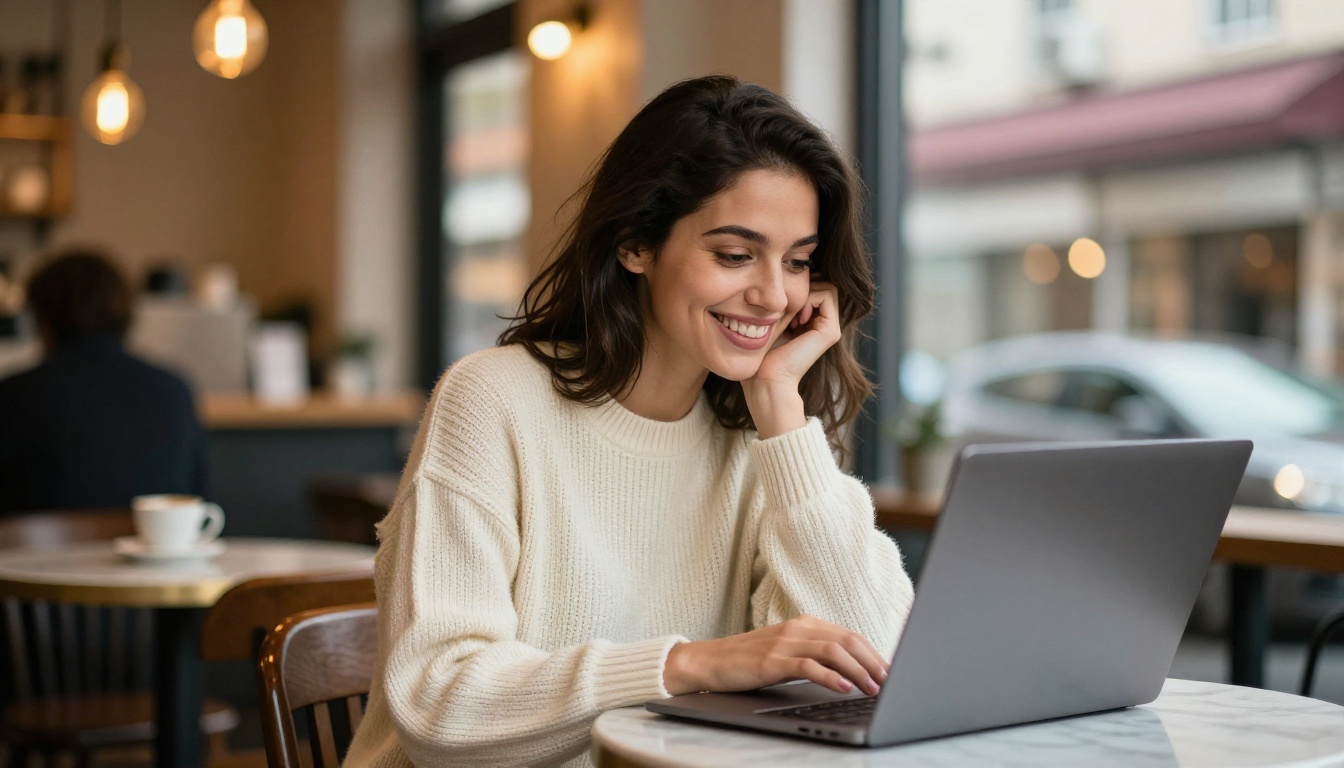
O GPT Image 2 é uma dessas ferramentas em que a forma mais rápida de entendê-lo é colocar algo na caixa de prompt e ver o que volta. As melhorias em relação aos modelos da geração anterior aparecem já no primeiro resultado, não depois de semanas aprendendo o sistema.
O GPT Image 2 está disponível diretamente no PicassoIA junto com mais de 90 outros modelos de texto para imagem. Se você quiser comparar resultados entre modelos, pode rodar o mesmo prompt no Flux Kontext Fast e no Flux Redux Dev em minutos e ver a diferença por conta própria.
Quando você tiver imagens de que gosta, as ferramentas de super resolução do PicassoIA podem aumentá-las para dimensões prontas para impressão, e o recurso de remoção de fundo tira os fundos para composições limpas num clique. Todo o fluxo, da ideia ao ativo visual pronto para produção, cabe em uma única plataforma.
Escolha um dos modelos de prompt deste artigo, troque pelo seu próprio sujeito e cenário e veja o que o GPT Image 2 produz. A primeira imagem que você gerar não será a última.


