Dos de los generadores de imágenes con IA más comentados de 2025 se enfrentan, y la diferencia en la calidad de los resultados es más matizada de lo que sugieren la mayoría de comparativas. Grok Imagine Image, desarrollado por xAI, llegó con afirmaciones técnicas audaces: una arquitectura de difusión nativa llamada Aurora, mayor precisión compositiva y conciencia contextual en tiempo real gracias a su profunda integración con el modelo de lenguaje de Grok. DALL-E, el sistema visual de IA de OpenAI, ya probado, responde con años de refinamiento, una amplia gama de estilos y una de las mejores fidelidades de prompt a imagen de la industria. La pregunta real no es cuál tiene la mejor historia. Es cuál ofrece mejores resultados cuando de verdad te sientas a crear.
Qué hace realmente Grok Imagine Image
Grok Imagine Image es el modelo de texto a imagen de xAI, construido sobre una arquitectura de difusión propia llamada Aurora. A diferencia de la mayoría de generadores de imágenes, que funcionan al margen de la comprensión del lenguaje, Grok Imagine Image se diseñó desde cero para trabajar junto a la inteligencia conversacional de Grok. Esto significa que el modelo comprende mejor el significado contextual de tus prompts y capta matices que los sistemas más simples suelen reducir a interpretaciones visuales genéricas.
Los resultados parecen pensados. Cuando pides un estado de ánimo concreto, Grok Imagine Image tiende a alcanzarlo en lugar de recurrir al cliché visual más cercano. El modelo Aurora también genera salidas nativas en 4K sin los artefactos de escalado que afectan a muchos sistemas rivales, lo que da a las imágenes finales una calidad táctil que aguanta bien en tamaño impreso.
La arquitectura de difusión Aurora
Aurora no es solo un nombre nuevo para una arquitectura ya existente. Se construyó con un enfoque en la coherencia espacial, es decir, en que los objetos de una escena se relacionen entre sí de forma físicamente plausible. Las sombras caen como deben. Los reflejos se comportan como reflejos. Las telas tienen peso y caen de forma natural. Es un terreno en el que muchos generadores de imágenes con IA todavía tienen problemas, con escenas que parecen armadas en lugar de fotografiadas.
La arquitectura también se beneficia del acceso de xAI a datos web en tiempo real a través del ecosistema de Grok, lo que permite al modelo tener una comprensión inusualmente actual de la cultura visual, las tendencias y las referencias, sin necesidad de actualizaciones manuales del conjunto de datos.
Cómo se diferencia Grok de la competencia
Lo que distingue a Grok Imagine Image de modelos como SDXL o Stable Diffusion 3.5 Large no es solo la calidad bruta de imagen, sino la forma en que interpreta el lenguaje. La mayoría de los modelos de difusión convierten los prompts en embeddings de tokens que se asocian a conceptos visuales. Grok Imagine Image usa una capa de comprensión del lenguaje más rica, lo que le permite manejar prompts complejos de varias cláusulas sin perder la pista de cada elemento. Si pides una escena con cinco elementos distintos, tiende a incluir los cinco en lugar de elegir los dos más fáciles de renderizar.
Lo que aporta DALL-E
DALL-E es el sistema de generación visual de OpenAI, y ha pasado por varias iteraciones importantes desde su debut. El estándar actual para la mayoría de usuarios es DALL-E 3, integrado en ChatGPT, mientras que GPT Image 1.5 representa el modelo de imagen independiente más refinado de OpenAI, disponible a través de la API y en plataformas como PicassoIA. Ambas versiones comparten la misma fortaleza principal: una capacidad extraordinaria para traducir prompts conversacionales e imprecisos en resultados visualmente coherentes.
DALL-E se entrenó con mucho énfasis en la coherencia del contenido y la precisión proporcional, lo que lo ha beneficiado y también lo ha limitado. En el lado positivo, los resultados son fiablemente pulidos, anatómicamente precisos en sujetos humanos y estilísticamente coherentes en distintos tipos de petición. La contrapartida es un techo creativo que puede resultar artificial cuando buscas algo más crudo o atmosférico.
DALL-E 3 frente a GPT Image 1.5
DALL-E 3 es lo que la mayoría ha probado a través de ChatGPT, donde se beneficia de la capacidad del modelo de lenguaje para interpretar y ampliar tu prompt antes de enviarlo al generador de imágenes. El resultado es que incluso las entradas vagas suelen producir imágenes sorprendentemente específicas y bien compuestas.
GPT Image 1.5 va más allá, con un renderizado de texturas mejorado, mejor gestión de escenarios de iluminación complejos y relaciones proporcionales más precisas entre los sujetos y su entorno. Es la versión que merece la pena comparar directamente con Grok Imagine Image en cualquier evaluación de calidad seria.
Las fortalezas visuales de OpenAI
Donde DALL-E lidera siempre en el renderizado de texto dentro de las imágenes. Históricamente, este ha sido uno de los problemas más difíciles para los modelos de difusión, y OpenAI invirtió mucho en resolverlo. DALL-E 3 y GPT Image 1.5 producen texto legible y bien formado dentro de las imágenes a un ritmo que todavía supera a la mayoría de competidores. Para quien crea contenido que necesita etiquetas, señales, títulos o pies de foto legibles dentro de la propia imagen generada, DALL-E mantiene una ventaja real que aún no se ha igualado del todo.
Calidad de imagen cara a cara
Aquí es donde la comparativa se vuelve concreta. Ambos modelos son capaces de producir imágenes impresionantes, pero destacan en categorías distintas. La tabla siguiente recoge las diferencias generales en las dimensiones de calidad más importantes.
| Dimensión de calidad | Grok Imagine Image | DALL-E (GPT Image 1.5) |
|---|
| Fotorrealismo | Excelente, textura de grano de película | Muy bueno, algo clínico |
| Precisión en retratos | Mucho detalle, piel natural | Bueno, a veces con suavizado idealizado |
| Profundidad en paisajes | Fuerte coherencia espacial | Sólido, menos atmosférico |
| Texto en imágenes | Moderado | Excelente |
| Gama estilística | Amplia, incluidas estéticas crudas | Amplia, con límites de contenido |
| Resolución nativa | Salida en 4K | 1024 px, escalable |
| Escenas complejas con varios elementos | Las maneja bien | Fuerte con prompts centrados |
Fotorrealismo y detalle
En pruebas directas de fotorrealismo, Grok Imagine Image saca ventaja cuando los prompts piden texturas naturales, entornos orgánicos y escenas que deberían parecer fotografiadas en lugar de renderizadas. El modelo Aurora produce una calidad sutil de grano de película en las sombras y las luces que se percibe como genuinamente fotográfica y no artificialmente suave.
Los resultados de DALL-E tienden a una estética más limpia, técnicamente impresionante pero que puede parecer algo procesada. Es la diferencia entre una fotografía RAW con grano visible y un JPEG muy retocado al que se le ha quitado todo lo imperfecto. Ninguna de las dos está mal, pero se adaptan a intenciones creativas distintas.
Rostros y anatomía humana
Ambos modelos manejan los rostros humanos con una precisión impresionante, algo que no siempre ocurría con las generaciones anteriores de generadores de imágenes con IA. Grok Imagine Image produce rostros con más detalle visible de poros, variación natural de la piel y geometría ocular precisa incluso en ángulos no frontales. GPT Image 1.5 produce rostros con una excelente precisión proporcional e iluminación coherente, pero en ocasiones recurre a una suavidad idealizada que hace que los sujetos parezcan ligeramente retocados.
Para generar retratos donde la autenticidad importa, como contenido social pensado para tener un estilo documental o periodístico, Grok Imagine Image tiende a resultar más convincente en una comparación directa.
Paisajes y escenas complejas
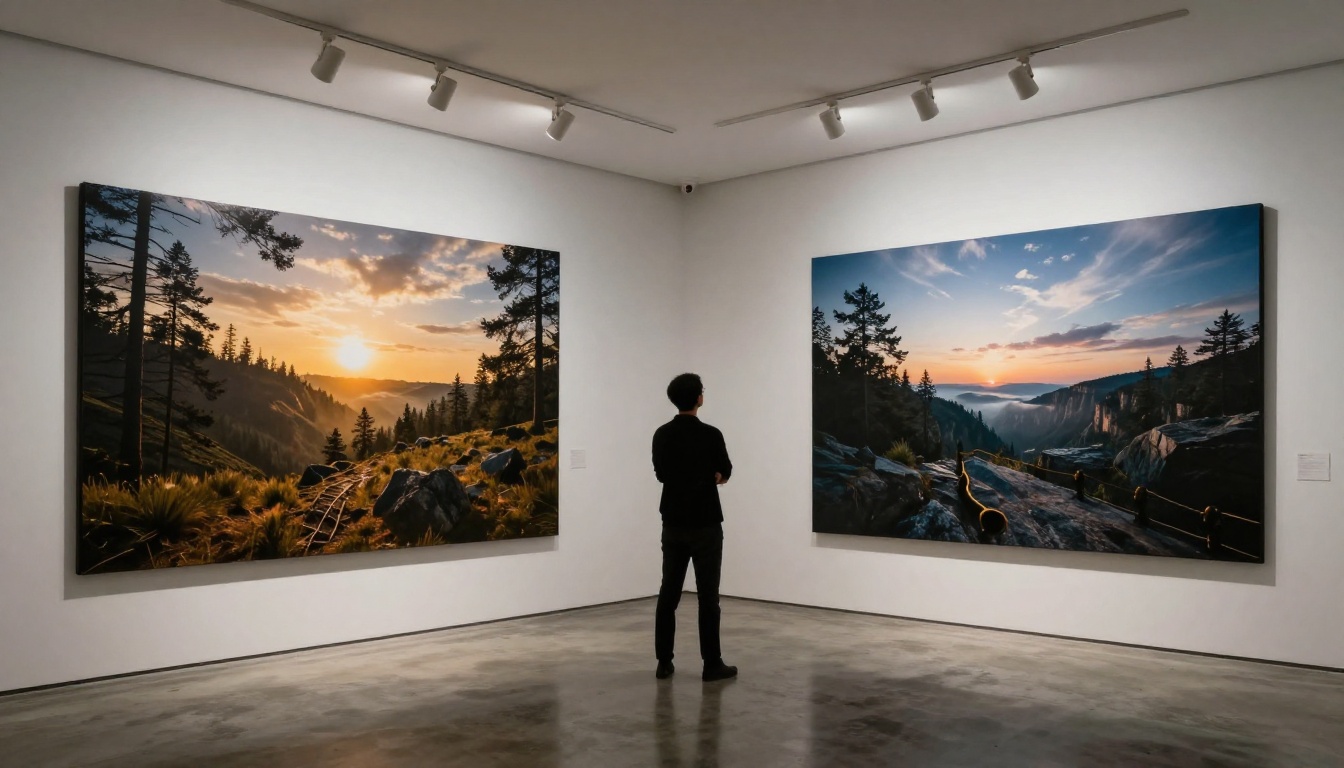
Grok Imagine Image muestra una ventaja notable en entornos exteriores complejos. Las escenas con varias fuentes de luz, neblina atmosférica realista y un renderizado preciso de agua o follaje salen de forma más natural con Aurora que con GPT Image 1.5. DALL-E funciona mejor en escenas arquitectónicamente precisas o en interiores, donde la estructura compositiva importa más que la textura atmosférica.
Precisión del prompt y control
Una salida bonita que no coincide con tu prompt es una salida fallida. Aquí es donde los dos modelos se separan de formas que más importan en el trabajo profesional.
Cómo manejan las instrucciones complejas
Grok Imagine Image gestiona prompts de varias cláusulas con una fiabilidad poco habitual. Puedes especificar sujeto, acción, entorno, iluminación, ángulo de cámara y estado de ánimo en un solo prompt, y el modelo mantiene casi todas las instrucciones a la vez. Los modelos rivales suelen perder elementos de los prompts complejos y se quedan con el concepto más dominante o más fácil de renderizar de la frase.
DALL-E 3 lo maneja bien cuando se usa a través de ChatGPT, donde el modelo de lenguaje reescribe tu prompt de forma más limpia antes de enviarlo al generador. Usado directamente por la API o a través de PicassoIA, rinde de forma similar, aunque es algo menos robusto con prompts muy largos y densamente especificados. Modelos como Imagen 4 de Google o Flux 2 Pro de Black Forest Labs ofrecen opciones adicionales si la fidelidad al prompt es tu prioridad máxima.
Texto dentro de las imágenes
DALL-E mantiene una clara ventaja en este aspecto concreto. Cuando un prompt requiere que el texto aparezca dentro de la imagen, como una etiqueta de producto, una señal de calle con una palabra concreta o un cartel con un título, GPT Image 1.5 lo resuelve con bastantes menos errores y alucinaciones que Grok Imagine Image, que todavía tiene problemas con textos de varias palabras y tipografías no estándar. Si tu flujo de trabajo necesita texto incrustado con regularidad, DALL-E es, por ahora, la opción más fiable.
Cómo usar Grok Imagine Image en PicassoIA
Como Grok Imagine Image está disponible directamente en PicassoIA, puedes ejecutarlo sin necesitar una cuenta de xAI ni una suscripción a Grok. Así se empieza y se saca el máximo partido al modelo Aurora.
Tu primera generación
Paso 1: Abre la página del modelo
Ve a la página de Grok Imagine Image en PicassoIA. Verás el campo para escribir el prompt, las opciones de resolución y los ajustes de salida. No hace falta ninguna configuración adicional.
Paso 2: Escribe un prompt detallado
Aurora premia la especificidad. En lugar de escribir "una mujer en un campo", escribe "una mujer joven de pie en un campo de trigo dorado al atardecer, contraluz cálido que crea un halo natural en su pelo, objetivo de 85 mm, profundidad de campo reducida, grano de película, Kodak Portra 400". Cuanta más información visual proporciones, más fielmente renderizará el modelo lo que quieres, y no lo que supone que quieres.
Paso 3: Ajusta la resolución
Grok Imagine Image admite salidas de alta resolución. Para trabajos con calidad de impresión, elige la resolución más alta disponible. Para contenido web, las resoluciones HD estándar se generan más rápido y suelen bastar para la publicación digital.
Paso 4: Genera e itera
Haz tu primera generación, evalúa qué ha funcionado y qué no, y luego ajusta elementos concretos de tu prompt. No reescribas todo el prompt cuando solo haga falta corregir un elemento. Aísla el problema y modifica esa cláusula. Iterar gana a empezar de cero.
Consejos para mejores prompts
💡 Consejo para prompts: Incluye siempre la dirección de la luz. "Luz cálida desde la izquierda" o "luz difusa nublada desde arriba" cambian por completo el ambiente y son una de las formas más sencillas de mejorar la calidad de salida de inmediato.
- Empieza por el sujeto: Abre el prompt con el elemento visual más importante. El modelo da más peso a los tokens iniciales, así que pon primero lo que más importa.
- Especifica los detalles de cámara: La longitud focal (50 mm, 85 mm, 24 mm), la apertura (f/1.8, f/8) y la película (Kodak Portra, Fuji Velvia) empujan al modelo hacia estéticas fotográficas en lugar de ilustradas.
- Evita los atajos de estilo: "Fotorrealista" a secas no basta. Describe las texturas, fuentes de luz y condiciones atmosféricas concretas que hacen que algo parezca real.
- Describe el fondo: Aunque vaya a quedar muy desenfocado, decirle al modelo qué hay detrás de tu sujeto le da mejor contexto espacial y reduce los errores de composición en primer plano.
- Incluye atmósfera: Palabras como "bruma matinal", "luz volumétrica", "neblina de hora dorada" y "grano de película en las sombras" activan las cualidades visuales más potentes del modelo Aurora.
Velocidad, precio y accesibilidad
Ninguno de los dos modelos es gratuito a gran escala, pero la forma en que se accede a cada uno determina lo útil que resulta en flujos de trabajo creativos reales.
Cuál es más rápido
Grok Imagine Image en PicassoIA genera resultados en unos 15 a 30 segundos para resoluciones estándar, y las salidas de mayor resolución tardan proporcionalmente más. DALL-E a través de ChatGPT suele entregar resultados en 10 a 20 segundos. La diferencia de velocidad es mínima en imágenes individuales, pero se vuelve relevante al ejecutar generaciones por lotes para producción de contenido. Para quienes necesitan velocidad por encima de todo, modelos como Flux Schnell ofrecen una generación casi instantánea con buena calidad en resoluciones estándar.
Costo y acceso
Grok Imagine Image a través de PicassoIA funciona con el sistema de créditos de la plataforma, lo que permite acceder sin comprometerse con una suscripción dedicada a xAI ni con una cuenta de API. DALL-E a través de ChatGPT Plus requiere una suscripción mensual, mientras que el acceso directo a la API de OpenAI tiene un precio por imagen que se acumula rápido para usuarios de alto volumen.
Para creadores que quieren probar varios modelos con el mismo prompt antes de decidirse por un resultado final, la interfaz de PicassoIA es especialmente práctica. Puedes ejecutar Grok Imagine Image, GPT Image 1.5 y modelos como Flux 1.1 Pro Ultra uno al lado del otro desde una sola interfaz, sin gestionar varias cuentas en distintas plataformas.
Elige la herramienta adecuada para tu trabajo
La respuesta honesta a la pregunta original es que ningún modelo gana en todas las categorías. La mejor elección depende por completo de lo que realmente quieras crear.
| Caso de uso | Mejor opción | Por qué |
|---|
| Retratos fotorrealistas | Grok Imagine Image | Textura de piel y detalle natural superiores |
| Contenido con texto incrustado | DALL-E (GPT Image 1.5) | Renderizado de texto más fiable y preciso |
| Escenas de paisaje y naturaleza | Grok Imagine Image | Mejor profundidad atmosférica y coherencia espacial |
| Maquetas de producto | DALL-E | Resultado compositivo más limpio y estructurado |
| Fotogramas cinematográficos | Grok Imagine Image | Calidad de grano de película y amplia gama de iluminación dramática |
| Creación conversacional rápida | DALL-E | Buenos resultados con prompts sueltos y naturales |
| Estéticas experimentales o crudas | Grok Imagine Image | Techo estilístico más amplio con el modelo Aurora |
Para fotógrafos y creativos
Si tu trabajo exige realismo fotográfico, Grok Imagine Image es la herramienta más sólida. La calidad de salida del modelo Aurora en luz natural, texturas orgánicas y autenticidad de retrato supera lo que GPT Image 1.5 ofrece actualmente en la mayoría de casos. Para quien piensa en términos de apertura, distancia focal y película, Grok Imagine Image habla ese lenguaje visual con más fluidez y responde a los prompts fotográficos técnicos con resultados más convincentes.
Para creadores de contenido y especialistas en marketing
DALL-E es la opción más segura para contenido que necesita ser pulido, coherente y ajustado al briefing sin mucha iteración. Su buen renderizado de texto, su proporcionalidad fiable y su estética más limpia lo hacen adecuado para contenido de redes sociales, imágenes de blog y materiales de marketing, donde importa más una salida controlada y predecible que el impacto visual en bruto. El modelo también encaja de forma natural con un enfoque de prompts conversacional, así que los usuarios no técnicos suelen obtener buenos resultados sin tener que aprender las convenciones de la ingeniería de prompts.
Empieza a crear ahora
La forma más rápida de zanjar este debate para tus necesidades creativas concretas es ejecutar ambos modelos con el mismo prompt y comparar los resultados directamente. Ninguna captura de un benchmark de un artículo de reseñas refleja lo que importa en tus proyectos reales.
PicassoIA te da acceso a Grok Imagine Image junto a GPT Image 1.5, Open DALL-E v1.1 y decenas de otros de los mejores modelos de texto a imagen, entre ellos Ideogram v3 Quality, Imagen 4 y Flux 2 Pro. Todo desde una sola plataforma, sin tener que gestionar varias suscripciones.
💡 Empieza aquí: Abre Grok Imagine Image en PicassoIA, pega tu prompt más exigente y mira lo que entrega Aurora. Después ejecuta el mismo prompt con GPT Image 1.5. La diferencia en la salida te dirá exactamente qué modelo encaja con tu flujo de trabajo creativo. Eso vale más que cualquier comparativa escrita.
Las herramientas están ahí. Lo único que queda es empezar a generar.