Deux des générateurs d’images par IA les plus discutés en 2025 s’affrontent, et l’écart de qualité entre les résultats est plus nuancé que ne le laissent entendre la plupart des comparaisons. Grok Imagine Image, développé par xAI, est arrivé avec des promesses techniques ambitieuses : une architecture de diffusion native baptisée Aurora, une précision de composition supérieure et une conscience contextuelle en temps réel grâce à son intégration poussée avec le grand modèle de langage de Grok. DALL-E, le système visuel d’IA éprouvé d’OpenAI, répond avec des années d’amélioration, une grande variété de styles et une fidélité au prompt parmi les meilleures du secteur. La vraie question n’est pas de savoir lequel a le meilleur discours. Il s’agit de savoir lequel offre les meilleurs résultats lorsque vous vous asseyez réellement pour créer.
Ce que fait réellement Grok Imagine Image
Grok Imagine Image est le modèle texte vers image de xAI, bâti sur une architecture de diffusion propriétaire appelée Aurora. Contrairement à la plupart des générateurs d’images qui fonctionnent indépendamment de la compréhension du langage, Grok Imagine Image a été conçu dès le départ pour travailler de pair avec l’intelligence conversationnelle de Grok. Cela signifie que le modèle saisit mieux le sens contextuel de vos prompts et perçoit des nuances que les systèmes plus simples aplatissent souvent en interprétations visuelles génériques.
Les images paraissent travaillées. Lorsque vous demandez une ambiance précise, Grok Imagine Image s’efforce de la rendre plutôt que de retomber sur le cliché visuel le plus proche. Le modèle Aurora gère aussi la sortie native en 4K sans les artefacts d’upscaling (augmentation de la résolution) qui affectent beaucoup de systèmes concurrents, ce qui donne aux images finales une qualité tactile qui tient la route à l’impression en grand format.
L’architecture de diffusion Aurora
Aurora n’est pas simplement un nouveau nom pour une architecture existante. Elle a été construite avec une attention portée à la cohérence spatiale, c’est-à-dire que les objets d’une scène sont liés entre eux de manière physiquement plausible. Les ombres tombent correctement. Les reflets se comportent comme des reflets. Les tissus ont du poids et tombent naturellement. C’est le domaine où de nombreux générateurs d’images par IA peinent encore, en produisant des scènes qui paraissent assemblées plutôt que photographiées.
L’architecture profite aussi de l’accès de xAI aux données web en temps réel via l’écosystème Grok, ce qui permet au modèle de disposer d’une connaissance inhabituellement actuelle de la culture visuelle, des tendances et des références, sans mises à jour manuelles de son jeu de données.
En quoi Grok se distingue de la concurrence
Ce qui distingue Grok Imagine Image de modèles comme SDXL ou Stable Diffusion 3.5 Large, ce n’est pas seulement la qualité brute de l’image, mais la manière dont il interprète le langage. La plupart des modèles de diffusion convertissent les prompts en embeddings de tokens qui correspondent à des concepts visuels. Grok Imagine Image utilise une couche de compréhension du langage plus riche, ce qui lui permet de gérer des prompts complexes à plusieurs propositions sans perdre le fil des éléments individuels. Si vous demandez une scène avec cinq éléments distincts, il tend à les inclure tous, plutôt que de choisir les deux plus faciles à rendre.
Ce que DALL-E apporte
DALL-E est le système de génération visuelle d’OpenAI, et il a connu plusieurs grandes itérations depuis ses débuts. La version actuelle pour la plupart des utilisateurs est DALL-E 3, intégrée à ChatGPT, tandis que GPT Image 1.5 représente le modèle d’image autonome le plus abouti d’OpenAI, disponible via l’API et sur des plateformes comme PicassoIA. Les deux versions partagent la même force principale : une capacité remarquable à transformer des prompts conversationnels et imprécis en résultats visuellement cohérents.
DALL-E a été entraîné avec un fort accent sur la cohérence du contenu et la justesse des proportions, ce qui l’a à la fois aidé et contraint. D’un côté, les résultats sont constamment soignés, anatomiquement justes pour les sujets humains et stylistiquement cohérents d’une demande à l’autre. En contrepartie, son plafond créatif peut paraître artificiel lorsque vous voulez quelque chose de plus brut ou de plus atmosphérique.
DALL-E 3 ou GPT Image 1.5
DALL-E 3 est la version que la plupart des gens ont découverte avec ChatGPT, où elle profite de la capacité du grand modèle de langage à interpréter et à développer votre prompt avant de l’envoyer au générateur d’images. Résultat : même des saisies vagues donnent souvent des images étonnamment précises et bien composées.
GPT Image 1.5 va plus loin, avec un rendu des textures amélioré, une meilleure gestion des éclairages complexes et des rapports de proportion plus justes entre les sujets et leur environnement. C’est la version qu’il faut comparer directement à Grok Imagine Image dans toute évaluation sérieuse de la qualité.
Les atouts visuels d’OpenAI
Là où DALL-E domine systématiquement, c’est dans le rendu du texte à l’intérieur des images. Ce problème a longtemps été l’un des plus difficiles pour les modèles de diffusion, et OpenAI a énormément investi pour le résoudre. DALL-E 3 et GPT Image 1.5 produisent un texte lisible et bien formé dans les images, à un niveau qui dépasse encore la plupart des concurrents. Pour toute personne qui crée du contenu nécessitant des étiquettes, des panneaux, des titres ou des légendes lisibles dans l’image générée elle-même, DALL-E conserve un avantage réel qui n’a pas encore été pleinement égalé.
Qualité d’image face à face
C’est là que la comparaison devient concrète. Les deux modèles sont capables de produire des images saisissantes, mais ils excellent dans des catégories différentes. Le tableau ci-dessous résume les différences principales sur les dimensions de qualité les plus importantes.
| Dimension de la qualité | Grok Imagine Image | DALL-E (GPT Image 1.5) |
|---|
| Photoréalisme | Excellent, texture de grain photographique | Très bon, légèrement clinique |
| Précision des portraits | Détail élevé, peau naturelle | Bon, parfois un lissage idéalisé |
| Profondeur des paysages | Forte cohérence spatiale | Solide, moins atmosphérique |
| Texte dans les images | Moyen | Excellent |
| Variété des styles | Large, esthétiques brutes incluses | Large, avec des limites de contenu |
| Résolution native | Sortie en 4K | 1024 px, upscalable |
| Scènes complexes à plusieurs éléments | Bien géré | Solide avec des prompts ciblés |
Photoréalisme et détails
Dans les tests de photoréalisme face à face, Grok Imagine Image prend l’avantage lorsque les prompts demandent des textures naturelles, des environnements organiques et des scènes qui doivent paraître photographiées plutôt que générées. Le modèle Aurora produit un léger grain photographique dans les ombres et les hautes lumières, qui se lit comme véritablement photographique plutôt qu’artificiellement lissé.
Les sorties de DALL-E tendent vers une esthétique plus propre, techniquement impressionnante, mais qui peut paraître légèrement retouchée. C’est la différence entre une photo RAW avec un grain visible et un JPEG très retouché où toutes les imperfections ont disparu. Aucune des deux options n’est fausse, mais elles conviennent à des intentions créatives différentes.
Visages et anatomie humaine
Les deux modèles gèrent les visages humains avec une précision impressionnante, ce qui n’était pas toujours le cas des premières générations de générateurs d’images par IA. Grok Imagine Image produit des visages avec un détail de pores plus visible, des variations naturelles de la peau et une géométrie des yeux juste, même sur des angles non frontaux. GPT Image 1.5 produit des visages à la précision des proportions excellente et à l’éclairage cohérent, mais retombe parfois sur un lissage idéalisé qui donne aux sujets un aspect légèrement retouché.
Pour générer des portraits où l’authenticité compte, comme un contenu social qui se veut documentaire ou journalistique, Grok Imagine Image paraît plus convaincant en comparaison directe.
Paysages et scènes complexes
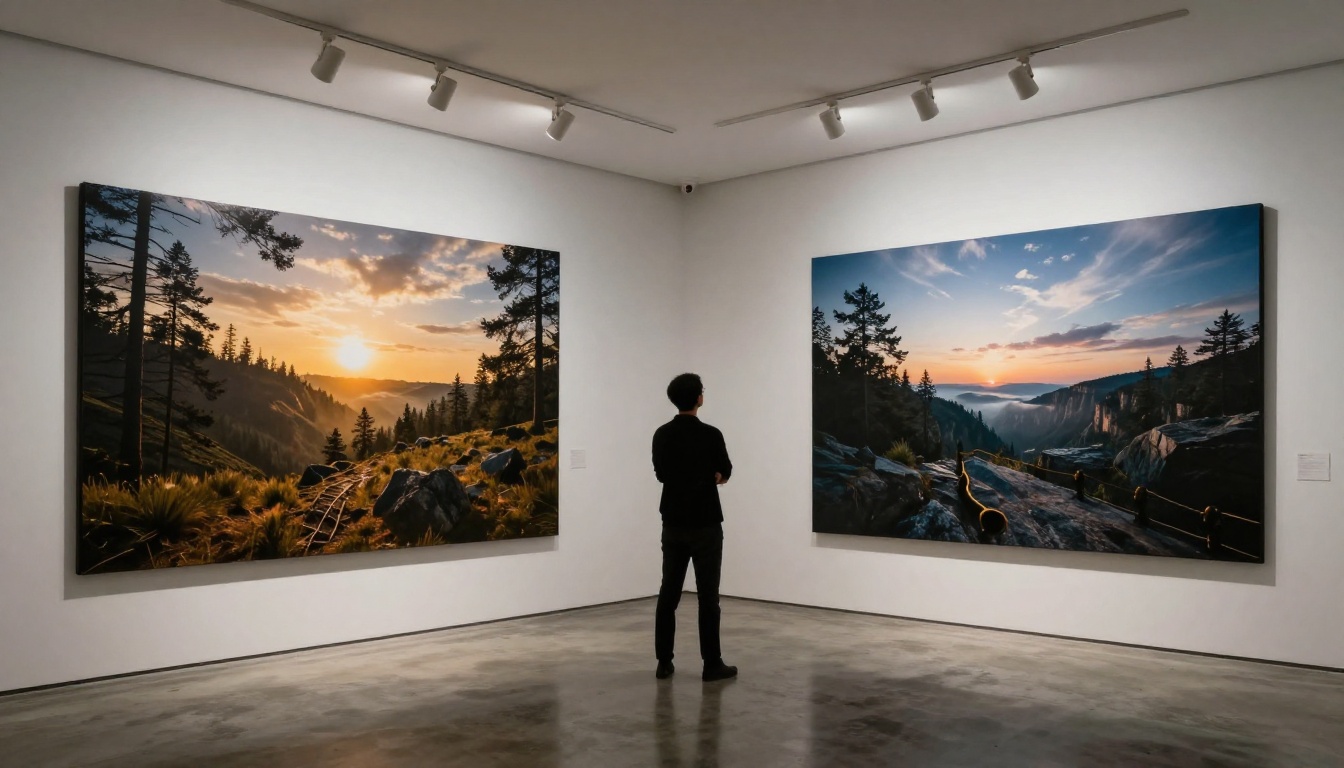
Grok Imagine Image présente un avantage notable dans les environnements extérieurs complexes. Les scènes avec plusieurs sources lumineuses, une brume atmosphérique réaliste et un rendu précis de l’eau ou du feuillage sortent plus naturellement d’Aurora que de GPT Image 1.5. DALL-E fait mieux dans les scènes architecturales précises ou les intérieurs, où la structure de la composition compte davantage que la texture atmosphérique.
Fidélité au prompt et contrôle
Une belle image qui ne correspond pas à votre prompt est une image ratée. C’est là que les deux modèles divergent de la manière la plus importante pour un travail professionnel.
Gérer les instructions complexes
Grok Imagine Image gère les prompts à plusieurs propositions avec une fiabilité peu commune. Vous pouvez préciser le sujet, l’action, l’environnement, l’éclairage, l’angle de prise de vue et l’ambiance dans un seul prompt, et le modèle retient la plupart de ces consignes simultanément. Les modèles concurrents laissent souvent tomber des éléments dans les prompts complexes, en se rabattant sur le concept le plus dominant ou le plus facile à rendre de la phrase.
DALL-E 3 s’en sort bien lorsqu’il est utilisé via ChatGPT, où le grand modèle de langage réécrit votre prompt en une version plus claire avant de l’envoyer au générateur. Utilisé directement via l’API ou via PicassoIA, il fonctionne de façon similaire, mais il est un peu moins robuste avec des prompts très longs et très denses. Des modèles comme Imagen 4 de Google ou Flux 2 Pro de Black Forest Labs offrent des options supplémentaires si la fidélité au prompt est votre priorité absolue.
Le texte dans les images
DALL-E conserve une nette avance sur ce point précis. Lorsqu’un prompt exige que du texte apparaisse dans l’image elle-même, comme une étiquette de produit, un panneau de rue avec un mot précis ou une affiche avec un titre, GPT Image 1.5 gère cela avec nettement moins d’erreurs et d’hallucinations que Grok Imagine Image, qui peine encore avec les textes de plusieurs mots et les polices non standard. Si votre flux de travail requiert régulièrement du texte intégré, DALL-E est pour l’instant le choix le plus fiable.
Utiliser Grok Imagine Image sur PicassoIA
Comme Grok Imagine Image est disponible directement sur PicassoIA, vous pouvez l’utiliser sans compte xAI ni abonnement Grok. Voici exactement comment commencer et tirer le meilleur parti du modèle Aurora.
Lancer votre première génération
Étape 1 : ouvrez la page du modèle
Rendez-vous sur la page Grok Imagine Image de PicassoIA. Vous verrez le champ de saisie du prompt, les options de résolution et les paramètres de sortie. Aucune configuration supplémentaire n’est nécessaire.
Étape 2 : rédigez un prompt détaillé
Aurora récompense la précision. Au lieu d’écrire « une femme dans un champ », écrivez « une jeune femme debout dans un champ de blé doré au crépuscule, un contre-jour chaud qui crée une auréole naturelle dans ses cheveux, objectif 85 mm, faible profondeur de champ, grain photographique, Kodak Portra 400 ». Plus vous fournissez d’informations visuelles, plus le modèle rend ce que vous avez en tête, plutôt que ce qu’il suppose que vous voulez.
Étape 3 : réglez la résolution
Grok Imagine Image prend en charge les sorties haute résolution. Pour un travail destiné à l’impression, choisissez la résolution la plus élevée disponible. Pour un contenu web, les résolutions HD standard se génèrent plus vite et suffisent généralement pour la publication numérique.
Étape 4 : générez et itérez
Lancez votre première génération, évaluez ce qui a fonctionné et ce qui n’a pas fonctionné, puis ajustez des éléments précis de votre prompt. Ne réécrivez pas tout le prompt lorsqu’un seul élément doit être corrigé. Isolez le problème et modifiez cette proposition. Itérer vaut mieux que recommencer.
Astuces pour de meilleurs prompts
💡 Astuce prompt : indiquez toujours la direction de la lumière. « Lumière chaude venant de la gauche » ou « lumière diffuse et couverte venant du haut » change complètement l’ambiance et constitue l’une des façons les plus simples d’améliorer immédiatement la qualité du résultat.
- Commencez par votre sujet : placez en tête de prompt l’élément visuel le plus important. Le modèle accorde plus de poids aux tokens placés en premier, donc mettez l’essentiel au début.
- Précisez les détails de prise de vue : la focale (50 mm, 85 mm, 24 mm), l’ouverture (f/1.8, f/8) et le type de pellicule (Kodak Portra, Fuji Velvia) orientent le modèle vers une esthétique photographique plutôt qu’illustrée.
- Évitez les raccourcis de style : « photoréaliste » seul ne suffit pas. Décrivez les textures, les sources de lumière et les conditions atmosphériques précises qui rendent une scène crédible.
- Décrivez l’arrière-plan : même s’il sera légèrement flouté, indiquer au modèle ce qui se trouve derrière votre sujet lui donne un meilleur contexte spatial et réduit les erreurs de composition au premier plan.
- Ajoutez de l’atmosphère : des mots comme « brume du matin », « lumière volumétrique », « brume de l’heure dorée » et « grain photographique dans les ombres » activent les qualités visuelles les plus fortes du modèle Aurora.
Vitesse, tarifs et accessibilité
Aucun des deux modèles n’est gratuit à grande échelle, mais la manière d’y accéder détermine leur utilité dans les flux de travail créatifs réels.
Lequel est le plus rapide
Sur PicassoIA, Grok Imagine Image génère des résultats en 15 à 30 secondes environ pour les résolutions standard, les sorties en haute résolution prenant proportionnellement plus de temps. DALL-E via ChatGPT livre généralement ses résultats en 10 à 20 secondes. L’écart de vitesse est minime à l’échelle d’une seule image, mais il devient important lorsqu’on lance des générations par lots pour la production de contenu. Pour les utilisateurs qui privilégient avant tout la vitesse, des modèles comme Flux Schnell offrent une génération quasi instantanée avec une bonne qualité de sortie aux résolutions standard.
Coût et accès
Grok Imagine Image via PicassoIA fonctionne avec le système de crédits de la plateforme, ce qui le rend accessible sans abonnement dédié à xAI ni compte API. DALL-E via ChatGPT Plus nécessite un abonnement mensuel, tandis que l’accès direct à l’API d’OpenAI est facturé à l’image, à un tarif qui s’accumule vite pour les utilisateurs à gros volume.
Pour les créateurs qui veulent tester plusieurs modèles avec le même prompt avant de choisir un résultat final, l’interface de PicassoIA est particulièrement pratique. Vous pouvez lancer Grok Imagine Image, GPT Image 1.5 et des modèles comme Flux 1.1 Pro Ultra côte à côte depuis une seule interface, sans gérer plusieurs comptes sur différentes plateformes.
Choisir le bon outil pour votre travail
La réponse honnête à la question de départ est qu’aucun modèle ne l’emporte dans toutes les catégories. Le meilleur choix dépend entièrement de ce que vous cherchez réellement à créer.
| Cas d’usage | Meilleur choix | Pourquoi |
|---|
| Portraits photoréalistes | Grok Imagine Image | Texture de peau et détail naturel supérieurs |
| Contenu avec texte intégré | DALL-E (GPT Image 1.5) | Rendu du texte plus fiable et précis |
| Paysages et scènes naturelles | Grok Imagine Image | Meilleure profondeur atmosphérique et cohérence spatiale |
| Maquettes de produits | DALL-E | Rendu plus propre et plus structuré |
| Images fixes de cinéma | Grok Imagine Image | Grain photographique et large plage d’éclairages dramatiques |
| Création conversationnelle rapide | DALL-E | Bons résultats à partir de prompts libres et naturels |
| Esthétiques expérimentales ou brutes | Grok Imagine Image | Plafond stylistique plus large avec le modèle Aurora |
Pour les photographes et les créatifs
Si votre travail exige un réalisme photographique, Grok Imagine Image est l’outil le plus solide. La qualité de sortie du modèle Aurora en lumière naturelle, en textures organiques et en authenticité des portraits dépasse ce que GPT Image 1.5 offre actuellement dans la plupart des cas. Pour qui raisonne en ouverture, en focale et en type de pellicule, Grok Imagine Image parle plus couramment ce langage visuel et répond à des prompts photographiques techniques avec des résultats plus convaincants.
Pour les créateurs de contenu et les professionnels du marketing
DALL-E est le choix le plus sûr pour un contenu qui doit être soigné, cohérent et conforme au brief sans itérations poussées. Son rendu du texte solide, sa proportionnalité fiable et son esthétique plus propre le rendent bien adapté aux contenus pour les réseaux sociaux, aux visuels de blog et aux supports marketing, où une sortie maîtrisée et prévisible compte davantage que le spectacle visuel brut. Le modèle s’associe aussi naturellement à une approche conversationnelle du prompt, ce qui permet aux utilisateurs non techniques d’obtenir souvent de bons résultats sans apprendre les conventions de l’ingénierie des prompts.
Commencez à créer dès maintenant
Le moyen le plus rapide de trancher ce débat pour vos besoins créatifs précis est de lancer les deux modèles sur le même prompt et de comparer directement les résultats. Aucune capture d’écran de benchmark issue d’un article de test ne rend compte de ce qui compte pour vos projets réels.
PicassoIA vous donne accès à Grok Imagine Image ainsi qu’à GPT Image 1.5, Open DALL-E v1.1 et des dizaines d’autres modèles de texte vers image parmi les meilleurs, dont Ideogram v3 Quality, Imagen 4 et Flux 2 Pro. Le tout depuis une seule plateforme, sans jongler avec plusieurs abonnements.
💡 Commencez ici : ouvrez Grok Imagine Image sur PicassoIA, collez votre prompt le plus exigeant et voyez ce que Aurora produit. Lancez ensuite le même prompt avec GPT Image 1.5. La différence entre les deux résultats vous indiquera exactement quel modèle convient à votre flux de travail créatif. Cela vaut plus que n’importe quelle comparaison écrite.
Les outils sont là. Il ne reste plus qu’à commencer à générer.