Hace dos años, generar una imagen fotorrealista con IA significaba aceptar ciertas contrapartidas. La piel parecía de plástico. El texto dentro de las imágenes era ilegible. Las escenas con varias personas producían rostros fusionados y dedos de más. La resolución rondaba un megapíxel si tenías suerte. En 2026, esa base ha cambiado por completo.
El cambio no llegó con un único lanzamiento. Se fue acumulando a lo largo de decenas de versiones de modelos, experimentos de arquitectura y avances en los datos de entrenamiento. El resultado es un panorama en el que las antiguas limitaciones ya no definen lo que pueden hacer las imágenes generadas por IA generativa. Los modelos disponibles hoy habrían sido considerados herramientas de investigación especializadas hace apenas un par de años. Ahora funcionan en segundos.
Aquí tienes una mirada precisa a lo que realmente cambió y por qué importa.
La brecha entre 2024 y 2026 es mayor de lo que parece
La mayoría de las personas que siguen la generación de imágenes con IA tienden a comparar lanzamientos individuales. Notan que un modelo superó a otro en un benchmark, o que un LoRA concreto produce caras más nítidas. El panorama acumulado es más llamativo. Mirado en conjunto, el salto de capacidad en 24 meses no es incremental; es de otra categoría.
La resolución, el detalle y la velocidad cambiaron a la vez. En la mayoría de los ciclos tecnológicos, se intercambia una cosa por otra. Que las tres mejoraran juntas es lo que hace inusual este periodo. También es lo que dificulta apreciarlo en tiempo real, porque ningún modelo por sí solo lo provocó.
La resolución y el detalle pasaron de impresionantes a inquietantes
A mediados de 2024, se consideraba buena una salida de un megapíxel con pequeños artefactos. Hoy, modelos como Flux 1.1 Pro Ultra generan imágenes de cuatro megapíxeles con un nivel de detalle que resiste los recortes más ajustados. Cada hebra de pelo, la trama de un tejido, la textura del concreto, el microbrillo sobre una superficie de vidrio: ya no hace falta elegir a mano entre decenas de resultados para conseguirlos. Aparecen siempre.
RealVisXL v3.0 Turbo llevó la calidad del render fotorrealista más lejos de lo que se esperaba de los modelos basados en SDXL, con tonos de piel y una precisión en la iluminación ambiental que resisten el escrutinio. La mejora no está solo en el resultado final; se nota en la coherencia entre semillas.
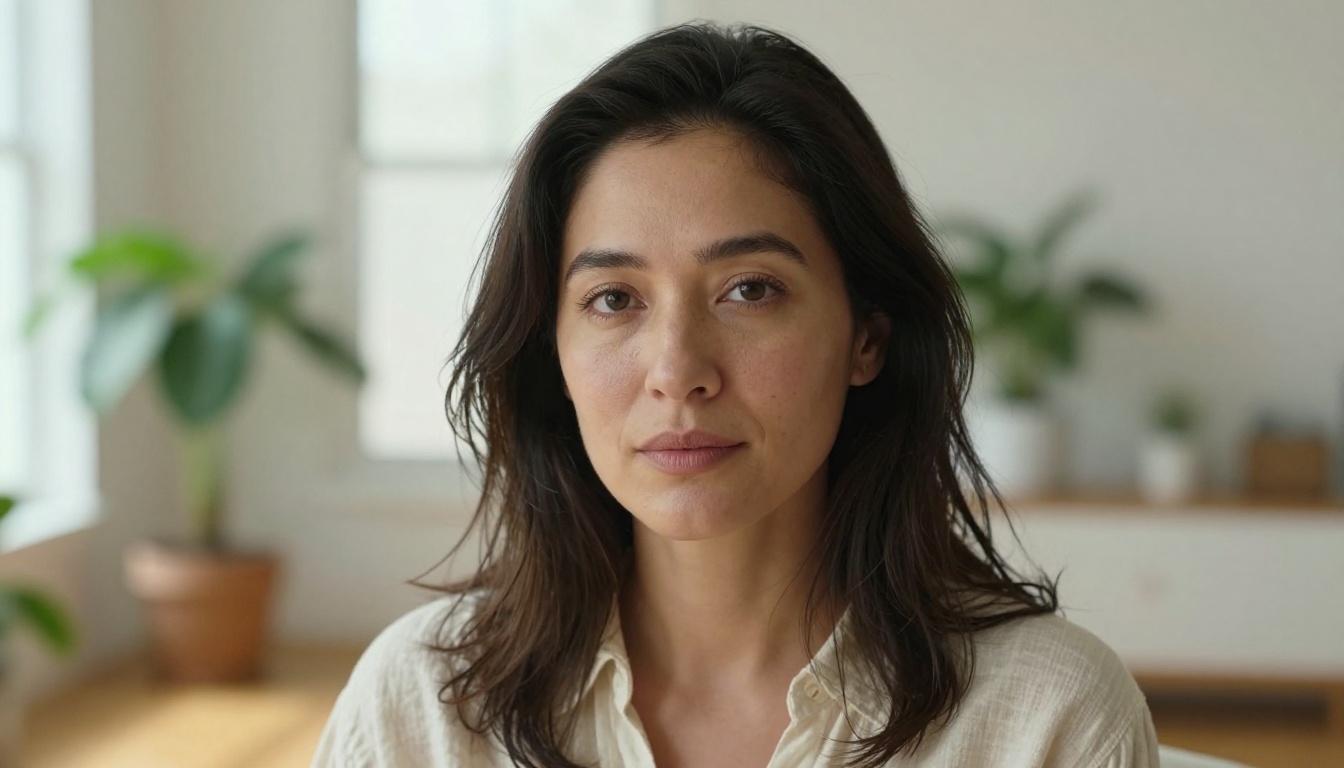
💡 Vale la pena señalarlo: Las mejoras de detalle se notan sobre todo en retratos y en tomas macro. A 4 MP, las imágenes de los modelos punteros actuales requieren un esfuerzo real para distinguirlas de la fotografía profesional en tamaños de visualización normales.
Por fin funciona el render de texto dentro de las imágenes
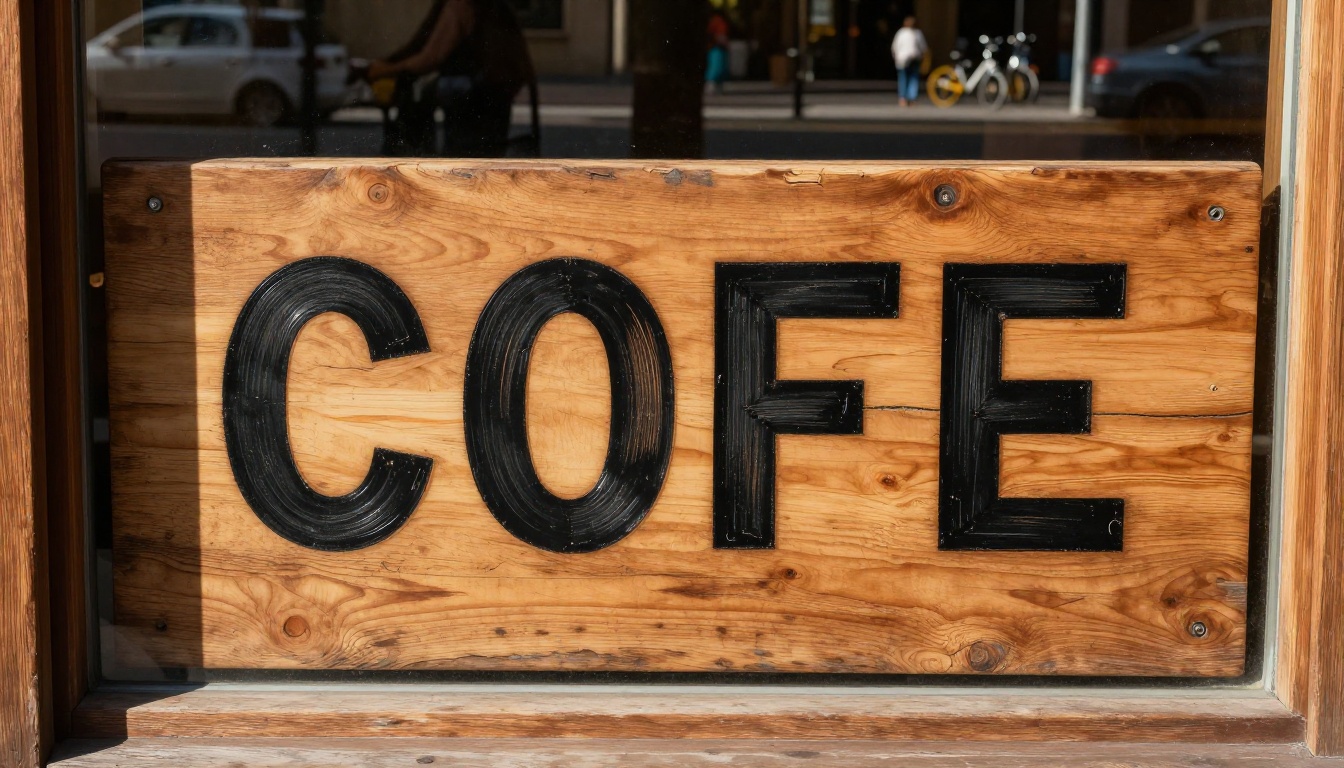
Este fue el problema persistente que definió durante años el "aspecto de IA". Cada imagen generada con texto producía letras deformadas, caracteres fantasma y una tipografía sin sentido. Ver que "COFFEE SHOP" se convertía en "COFFFE SHQP" dentro de una escena generada era una señal fiable de que la IA había hecho la imagen.
Ideogram v3 Quality cambió la expectativa en esta categoría. El texto legible y bien escrito dentro de entornos fotorrealistas es ahora su resultado por defecto, no un caso especial. Ideogram v3 Turbo ofrece una precisión similar en una fracción del tiempo de generación. Recraft v4 Pro va más allá, con imágenes listas para imprimir y un control tipográfico profesional.
Para quien crea contenido con carteles, etiquetas, maquetas de producto o capturas de interfaz, esto no es una mejora menor. Elimina toda una categoría de trabajo de posproducción.
Los modelos que están reescribiendo las reglas ahora mismo
No todos los modelos de imagen con IA de 2026 son iguales. Unos pocos han redefinido de verdad lo que puede hacer la categoría. Estas son las diferencias reales de capacidad que existen hoy.
Flux 2 marca un nuevo referente de velocidad
La familia Flux 2 de Black Forest Labs es la prueba más directa de cuánto ha cambiado todo. Flux 2 Pro produce imágenes detalladas y fotorrealistas, con una gran fidelidad al prompt, en cuestión de segundos. Flux 2 Max lleva la salida a 4 MP. Flux 2 Dev ofrece a investigadores y usuarios avanzados un control más directo sobre el proceso de generación.
Lo que separa estos modelos de las versiones anteriores es la relación entre velocidad y calidad. Los Flux originales hacían explícita la contrapartida: usa Flux Schnell para ganar velocidad y Flux Dev para la calidad. En la generación Flux 2, la diferencia entre ellos es tan pequeña que la mayoría de los casos de uso encajan en el nivel rápido sin un sacrificio visible.
| Modelo | Resolución | Ideal para |
|---|
| Flux 2 Max | 4 MP | Impresiones de alta fidelidad, uso comercial |
| Flux 2 Pro | Alta | Equilibrio entre calidad y velocidad |
| Flux 2 Dev | Alta | Ajuste fino, generación controlada |
| Flux Schnell | Estándar | Prototipado rápido, iteración |
Seedream 4.5 lleva el 4K a todo el mundo
La familia Seedream de ByteDance representa el otro gran cambio de arquitectura en el periodo 2025-2026. Seedream 4.5 genera imágenes en resolución 4K como salida estándar, no como un modo especial de alta resolución. Seedream 4 sentó el formato; la versión 4.5 afinó la ciencia del color y mejoró la precisión compositiva. Seedream 3 sigue siendo útil conocerlo como la base que demostró que el enfoque funcionaba.
En la práctica, ya no necesitas un paso de escalado aparte para obtener resultados de calidad de impresión. Lo que sale del modelo ya viene cargado de detalle.
Ideogram v3 hace que el texto legible sea el valor por defecto
Ideogram v3 Balanced y sus versiones hermanas no solo son "mejores" con el texto que los modelos anteriores. Representan una clase distinta de capacidad. El modelo se entrenó para tratar el renderizado de texto como una tarea de primer nivel, y no como un efecto secundario de la generación general de imágenes. El resultado es un modelo en el que indicas qué texto debe aparecer y aparece, correctamente escrito, en el lugar adecuado y con un estilo acorde a la escena.
Para trabajos de marca, señalización, maquetas de envases o ilustraciones editoriales con textos concretos, esto cambia lo que es posible con solo el prompt.
Recraft v4 Pro se acerca a las herramientas de diseño
Recraft v4 Pro se acerca a lo que los diseñadores gráficos han hecho tradicionalmente con herramientas vectoriales y de mapa de bits. Gestiona el control tipográfico, un resultado de estilo de marca coherente y la exportación vectorial escalable mediante Recraft v4 Pro SVG. También mantiene un estilo visual coherente en un lote de imágenes sin necesitar un LoRA ni una referencia de estilo, lo que importa mucho en los flujos de trabajo de producción.
La precisión de los prompts llegó a un punto de inflexión
Existe un umbral concreto a partir del cual la fidelidad al prompt cambia de naturaleza. Por debajo de él, negocias con el modelo, reintentas prompts y aceptas aproximaciones. Por encima, describes lo que quieres y el modelo lo produce. En 2026, los modelos más avanzados han superado ese umbral en la mayoría de los casos prácticos.
Qué cambió en la forma en que los modelos leen los prompts
Los primeros modelos de difusión ponderaban los tokens del prompt de forma irregular. Los prompts largos y detallados solían producir peores resultados que los cortos, porque los tokens alejados en la secuencia tenían poca influencia en el resultado final. Las arquitecturas modernas lo gestionan de otra forma, con mecanismos de atención que mantienen un peso coherente en cadenas de prompt más largas.
El resultado práctico: un prompt de 150 palabras que describe una escena concreta, una condición de iluminación, un sujeto y un fondo produce hoy una imagen que refleja todos esos detalles a la vez. Esto no era fiable en 2024. Con frecuencia obtenías la luz o el sujeto, pero no ambos, o la escena o el ambiente, pero no el ángulo exacto que habías especificado.
💡 Para fotógrafos que se pasan a la IA: El cambio se parece a la diferencia entre dar una indicación y dar un encargo. Ahora puedes describir el tono emocional de una imagen, el carácter de la luz y las condiciones atmosféricas junto con las especificaciones técnicas, y el modelo los gestiona todos en una sola pasada.
Composiciones con varios sujetos sin soluciones alternativas
Este fue el problema más difícil de resolver en el periodo 2023-2024. Generar una imagen con dos personas distintas, separadas entre sí, con caras, ropa y posturas diferentes, solía requerir ControlNet, imágenes de referencia e inpainting sobre inpainting, y aun así producía resultados irregulares.
Los modelos punteros actuales manejan dos y tres sujetos distintos de forma fiable en una sola pasada. Ideogram v2 y sus sucesores gestionan escenas complejas con varias figuras y relaciones espaciales precisas. Flux 2 Pro mantiene en escenas con varios sujetos los detalles que indica el prompt para cada uno por separado, sin mezclar rasgos entre figuras.
La era de las soluciones alternativas para escenas con varias personas ha quedado en gran medida atrás en composiciones estándar. Los casos extremos con poses muy concretas o diseños de personajes detallados todavía se benefician de ControlNet o de herramientas de referencia de personajes como Ideogram Character, pero la base ha avanzado mucho.
La velocidad ya no es una contrapartida
En 2023 y 2024, generar rápido significaba aceptar menor calidad. Los modelos rápidos eran útiles para iterar, no para los resultados finales. Esa limitación ya no se mantiene igual, y la razón tiene tanto que ver con la metodología de entrenamiento como con el hardware.
Modelos de la clase Schnell en 2026
Flux Schnell sigue siendo un referente de lo rápido que se ha vuelto la generación: imágenes en menos de dos segundos con niveles de calidad que hace dos años se habrían considerado buenos para un modelo lento. La variante Flux Kontext Fast extiende esa velocidad a las tareas de edición con contexto. Ideogram v3 Turbo e Ideogram v2 Turbo aplican la misma lógica a la generación de imágenes con texto preciso.
El efecto en el flujo de trabajo creativo es real. Los ciclos de iteración que antes tardaban minutos ahora tardan segundos. Puedes generar diez variaciones en el tiempo que antes costaba generar una, lo que cambia a fondo la forma de usar la generación como herramienta creativa.
El salto en inferencia que lo hizo posible
Las mejoras de velocidad no son solo de hardware. Provienen de cambios en el propio proceso de difusión: menos pasos por imagen, mejores planificadores de ruido y técnicas de cuantización que conservan la calidad con menor precisión. Los modelos entrenados con conjuntos de datos destilados pueden producir resultados equivalentes o mejores con 4-8 pasos de difusión en lugar de 30-50.
SDXL Lightning 4Step fue una señal temprana de hacia dónde se dirigían las cosas. Funcionaba al nivel de calidad máximo de SDXL en 4 pasos en lugar de 30. Los modelos lanzados en 2025-2026 han integrado ese enfoque en todos los casos, así que la generación rápida ya no es una variante especializada; es la expectativa por defecto.
La edición se integró en la generación
Uno de los cambios menos comentados de 2026 es que la frontera entre generación y edición se ha difuminado hasta casi desaparecer. Las herramientas de edición que antes requerían flujos separados ahora viven dentro del propio paso de generación.
Flux Kontext y el cambio en el inpainting
Flux Kontext Pro y Flux Kontext Max representan un cambio de categoría concreto. No son modelos de generación con funciones de edición añadidas a posteriori. Son modelos sensibles al contexto que pueden modificar cualquier parte de una imagen existente a partir de un prompt de texto, manteniendo el resto de la imagen intacto y sin costuras visibles.
Los flujos de inpainting anteriores exigían un enmascarado cuidadoso, varias iteraciones para igualar la imagen circundante y solían dejar artefactos visibles en los bordes. Los modelos de la clase Kontext entienden el contexto de lo que editan y producen resultados sin costuras en una sola pasada. Las aplicaciones prácticas incluyen:
- Eliminar o reemplazar objetos sin artefactos de enmascarado
- Cambios de ropa y de fondo manteniendo intactos los rostros y las estructuras
- Adición precisa de texto en imágenes existentes (combinada con la precisión tipográfica de estilo Ideogram)
- Relleno ampliado del lienzo con contenido coherente y ajustado al contexto
Ediciones con contexto que mantienen la estructura
Flux Depth Pro y Flux Canny Pro añaden control estructural al proceso de generación. La edición con información de profundidad permite aplicar prompts de estilo o de contenido que respetan la disposición tridimensional de una escena, de modo que las superficies, las sombras y las relaciones espaciales siguen siendo correctas tras la edición. El control basado en bordes (Canny) fija la estructura de los contornos mientras reestiliza por completo el contenido de las superficies.
Para la fotografía de producto, la visualización arquitectónica y los trabajos comerciales que requieren disposiciones espaciales concretas, esto supone una mejora cualitativa frente a lo que se podía lograr con enfoques de ControlNet en 2024. Flux Dev LoRA y Flux Kontext Dev LoRA amplían aún más estas capacidades para escenarios de ajuste fino personalizado.
Cómo se comparan estos modelos de un vistazo
| Capacidad | Modelo punta (2024) | Modelo punta (2026) |
|---|
| Resolución máxima | ~1 MP | 4 MP |
| Texto en imágenes | En su mayoría ilegible | Preciso y con estilo |
| Caras en escenas con varias personas | Un sujeto fiable | 2-3 sujetos como estándar |
| Calidad de la generación rápida | Visiblemente inferior | Casi idéntica a la lenta |
| Integración de la edición | Flujo separado | Integrada en la generación |
| Coherencia de estilo en un lote | Requiere LoRA | Nativa en algunos modelos |
💡 El cambio más importante no es una capacidad concreta. Es la combinación. Un modelo que es rápido, de alta resolución, preciso con el texto y capaz de escenas con varios sujetos a la vez no existía hace dos años. Esa combinación es ahora la expectativa estándar para un modelo de primer nivel, y no una lista de herramientas especializadas por separado.
Los modelos Playground v2.5 Aesthetic y SDXL que definieron la calidad en 2024 siguen disponibles y siguen dando buenos resultados en casos de uso concretos, sobre todo en salidas artísticas y estilizadas. Pero ya no representan el techo de capacidad.
Prueba los modelos de generación de 2026 en PicassoIA
Si quieres ver todo esto en la práctica sin gestionar APIs, cómputo local ni pesos de modelos, PicassoIA aloja la gama completa de modelos que se analizan en este artículo. Escribes un prompt, eliges un modelo y generas.
Para retratos fotorrealistas y escenas con iluminación precisa, empieza con Flux 2 Pro o RealVisXL v3.0 Turbo. Para imágenes con texto legible y bien estilizado, Ideogram v3 Quality es el camino directo. Para una salida en 4K sin un paso de escalado aparte, Seedream 4.5 produce detalle denso de forma nativa. Para editar una foto existente con una instrucción de texto, Flux Kontext Pro lo resuelve en una sola pasada sin herramientas de enmascarado aparte.
La mejor forma de entender cuánto ha cambiado todo es pasar el mismo prompt por un modelo de la era 2024 y en uno actual, uno al lado del otro. La diferencia no es sutil. La colección de 91 modelos de texto a imagen de PicassoIA hace que esa comparación sea inmediata, sin ninguna configuración. Sea cual sea el tipo de imágenes que creas, el techo se movió de forma notable en 2026, y las herramientas para alcanzarlo ya están ahí.