Dois anos atrás, gerar uma imagem fotorrealista com IA significava aceitar certas contrapartidas. A pele parecia de plástico. O texto dentro das imagens era ilegível. Cenas com várias pessoas produziam rostos fundidos e dedos extras. A resolução ficava em torno de um megapixel, se você tivesse sorte. Em 2026, essa base foi completamente redesenhada.
A mudança não aconteceu em um único lançamento. Ela se acumulou em dezenas de versões de modelos, experimentos de arquitetura e avanços nos dados de treinamento. O resultado é um cenário em que as antigas limitações já não definem o que as imagens de IA generativa podem fazer. Os modelos disponíveis hoje seriam considerados ferramentas de pesquisa especializadas há apenas alguns anos. Agora eles rodam em segundos.
Veja a seguir, com precisão, o que realmente mudou e por que isso importa.
A distância entre 2024 e 2026 é maior do que parece
A maioria das pessoas que acompanham a geração de imagens por IA tende a comparar lançamentos individuais. Elas percebem que um modelo superou outro em um benchmark, ou que um LoRA específico produz rostos mais nítidos. O quadro acumulado é mais impressionante. Visto como um todo, o salto de capacidade em 24 meses não é incremental; é de outra categoria.
Resolução, detalhe e velocidade mudaram ao mesmo tempo. Na maioria dos ciclos tecnológicos, você troca um por outro. O fato de os três terem melhorado juntos é o que torna este período incomum. É também o que dificulta perceber isso em tempo real, porque nenhum modelo isolado causou essa mudança.
Resolução e detalhe passaram de impressionantes a perturbadores
Em meados de 2024, uma saída de um megapixel com pequenos artefatos era considerada boa. Hoje, modelos como o Flux 1.1 Pro Ultra geram imagens de quatro megapixels, com níveis de detalhe que resistem a recortes bem fechados. Fios de cabelo individuais, a trama de um tecido, a textura do concreto, o microbrilho em uma superfície de vidro: nada disso exige mais escolher a dedo entre dezenas de resultados. Esses detalhes aparecem de forma consistente.
O RealVisXL v3.0 Turbo levou a renderização fotorrealista além do que se esperava de modelos baseados em SDXL, produzindo tons de pele e precisão de iluminação ambiente que resistem a uma análise minuciosa. A melhora não está só no resultado final; ela aparece na consistência entre seeds.
💡 Vale notar: As melhorias de detalhe são mais visíveis em retratos e em fotos macro. Em 4MP, as imagens dos modelos de ponta atuais exigem esforço real para se distinguir de fotografias profissionais em tamanhos normais de visualização.
A renderização de texto dentro das imagens finalmente funciona
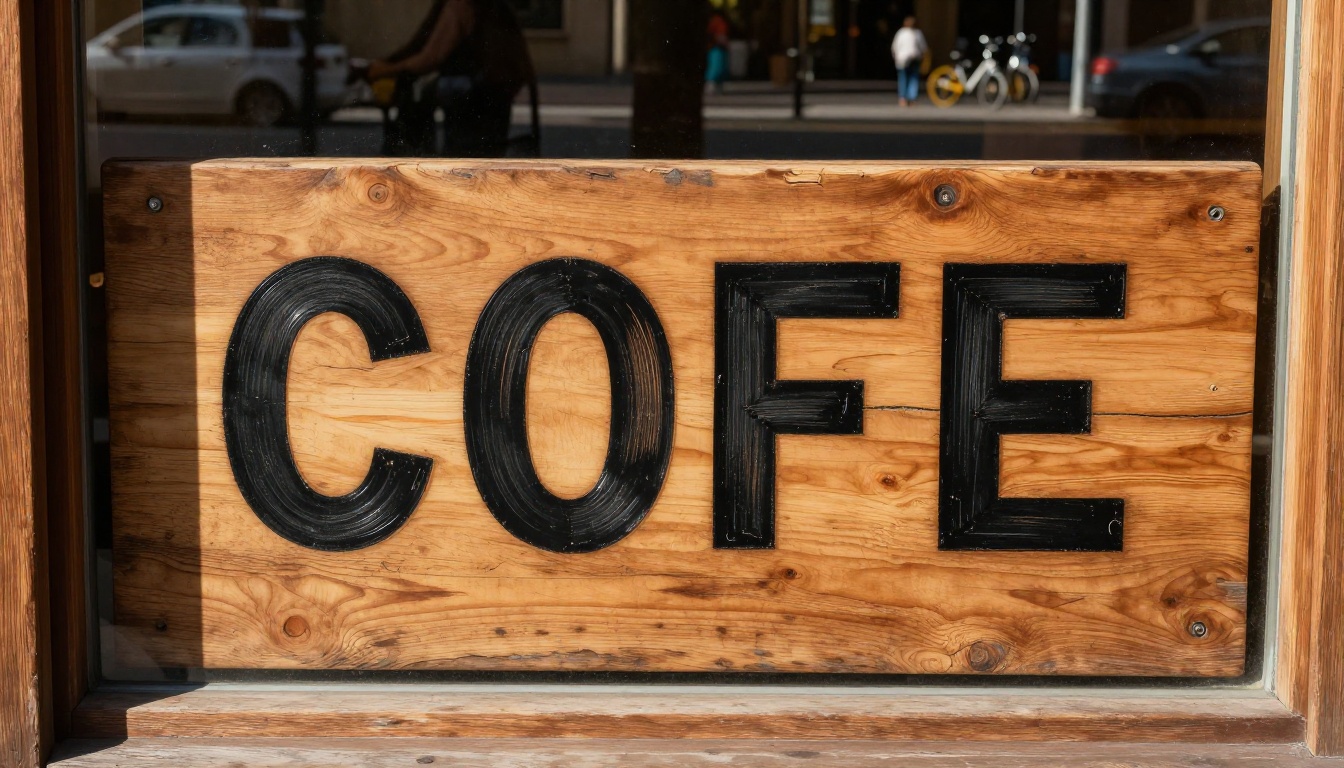
Este foi o problema teimoso que definiu o "visual de IA" por anos. Toda imagem gerada com texto produzia letras distorcidas, caracteres fantasmas e absurdos tipográficos. Ver "COFFEE SHOP" virar "COFFFE SHQP" em uma cena gerada era um sinal certeiro de que a IA tinha feito a imagem.
O Ideogram v3 Quality mudou a expectativa para essa categoria. Texto legível e corretamente escrito dentro de ambientes fotorrealistas é agora o resultado padrão, e não um caso especial. O Ideogram v3 Turbo entrega precisão semelhante em uma fração do tempo de geração. O Recraft v4 Pro vai além, produzindo imagens prontas para impressão com controle tipográfico profissional.
Para quem cria conteúdo com placas, rótulos, mockups de produtos ou capturas de tela de interfaces, isso não é uma melhora pequena. Elimina uma categoria inteira de trabalho de pós-processamento.
Os modelos que estão reescrevendo as regras agora
Nem todos os modelos de imagem por IA em 2026 são iguais. Alguns poucos redefiniram de fato o que a categoria pode fazer. Veja onde estão, hoje, as diferenças reais de capacidade.
O Flux 2 estabelece um novo benchmark de velocidade
A família Flux 2, da Black Forest Labs, é a evidência mais direta de quanto mudou. O Flux 2 Pro produz imagens fotorrealistas detalhadas, com forte aderência ao prompt, em segundos. O Flux 2 Max leva a saída a 4MP. O Flux 2 Dev dá a pesquisadores e usuários avançados mais controle direto sobre o processo de geração.
O que diferencia esses modelos das versões anteriores é a relação entre velocidade e qualidade. Os modelos Flux originais deixavam a troca explícita: use o Flux Schnell para velocidade, use o Flux Dev para qualidade. Na geração Flux 2, a diferença entre eles é pequena o bastante para que a maioria dos casos de uso fique na faixa rápida sem nenhum sacrifício visível.
| Modelo | Resolução | Melhor para |
|---|
| Flux 2 Max | 4MP | Impressões de alta fidelidade, uso comercial |
| Flux 2 Pro | Alta | Qualidade e velocidade equilibradas |
| Flux 2 Dev | Alta | Fine-tuning, geração controlada |
| Flux Schnell | Padrão | Prototipagem rápida, iteração |
O Seedream 4.5 traz 4K para todo mundo
A linha Seedream, da ByteDance, representa a outra grande mudança de arquitetura no intervalo 2025-2026. O Seedream 4.5 gera imagens em resolução 4K como saída padrão, e não como um modo especial de alta resolução. O Seedream 4 estabeleceu o formato; a versão 4.5 refinou a colorimetria e melhorou a precisão de composição. O Seedream 3 ainda vale ser conhecido como a base que provou que a abordagem funcionava.
Na prática, você não precisa mais de uma etapa separada de upscaling para obter saídas com qualidade de impressão. O que sai do modelo já vem denso em detalhe.
O Ideogram v3 torna o texto legível o padrão
O Ideogram v3 Balanced e seus irmãos não são apenas "melhores" em texto do que os modelos anteriores. Eles representam uma classe diferente de capacidade. O modelo foi treinado para tratar a renderização de texto como uma tarefa de primeira linha, e não como efeito colateral da geração de imagens em geral. O resultado é um modelo em que você especifica qual texto deve aparecer e ele aparece, corretamente, no lugar certo, com um estilo que combina com a cena.
Para trabalhos de marca, sinalização, mockups de embalagem ou ilustrações editoriais com textos específicos, isso muda o que é possível só no nível do prompt.
O Recraft v4 Pro reduz a distância para as ferramentas de design
O Recraft v4 Pro se aproxima do que designers gráficos sempre fizeram com ferramentas vetoriais e rasterizadas. Ele cuida do controle tipográfico, da saída de estilo de marca consistente e da exportação vetorial escalável pelo Recraft v4 Pro SVG. Também mantém um estilo visual consistente em um lote de imagens sem exigir um LoRA ou uma referência de estilo, o que importa bastante para fluxos de trabalho de produção.
A precisão dos prompts chegou a um ponto de virada
Existe um limiar específico em que a aderência ao prompt muda de natureza. Abaixo dele, você negocia com o modelo, refaz prompts e aceita aproximações. Acima dele, você descreve o que quer e o modelo produz. Em 2026, os modelos líderes ultrapassaram esse limiar para a maioria dos usos práticos.
O que mudou na forma como os modelos leem prompts
Os primeiros modelos de difusão davam pesos inconsistentes aos tokens do prompt. Prompts longos e detalhados muitas vezes produziam resultados piores do que os curtos, porque tokens distantes na sequência tinham pouca influência sobre o resultado final. As arquiteturas modernas lidam com isso de outra forma, com mecanismos de atenção que mantêm uma ponderação consistente em cadeias de prompt mais longas.
Na prática: um prompt de 150 palavras que descreve uma cena específica, a condição de luz, o sujeito e o fundo agora produz uma imagem que reflete todos esses detalhes ao mesmo tempo. Isso não era confiável em 2024. Muitas vezes você conseguia a luz ou o sujeito, mas não os dois; a cena ou o clima, mas não o ângulo específico que você tinha descrito.
💡 Para fotógrafos que estão recorrendo à IA: A mudança lembra a diferença entre dar uma direção e entregar um briefing. Agora você pode descrever o tom emocional de uma imagem, o caráter da luz e as condições atmosféricas junto com especificações técnicas, e o modelo cuida de todos eles em uma única passagem.
Composições com múltiplos sujeitos sem gambiarras
Este foi o problema mais difícil de resolver no período 2023-2024. Gerar uma imagem com duas pessoas distintas, separadas uma da outra, com rostos, roupas e posições corporais diferentes, costumava exigir ControlNet, imagens de referência e inpainting sobre inpainting, e ainda assim produzia resultados inconsistentes.
Os modelos de ponta atuais lidam com dois e três sujeitos distintos de forma confiável em uma única passagem. O Ideogram v2 e seus sucessores lidam com cenas complexas de várias figuras e com relações espaciais precisas. O Flux 2 Pro gerencia cenas com múltiplos sujeitos mantendo os detalhes especificados no prompt para cada sujeito separadamente, sem misturar características entre as figuras.
A era das gambiarras para cenas com várias pessoas está, em grande parte, encerrada para composições padrão. Casos extremos, com poses muito específicas ou designs de personagens detalhados, ainda se beneficiam do ControlNet ou de ferramentas de referência de personagem, como o Ideogram Character, mas a base avançou bastante.
Velocidade não é mais uma contrapartida
Em 2023 e 2024, gerar rápido significava aceitar qualidade menor. Os modelos rápidos eram úteis para iteração, não para saídas finais. Essa limitação já não vale do mesmo jeito, e o motivo tem tanto a ver com a metodologia de treinamento quanto com o hardware.
Modelos da classe Schnell em 2026
O Flux Schnell continua sendo uma referência de quão rápida ficou a geração: imagens em menos de dois segundos, com níveis de qualidade que seriam considerados bons para um modelo lento dois anos atrás. A variante Flux Kontext Fast estende essa velocidade a tarefas de edição com contexto. O Ideogram v3 Turbo e o Ideogram v2 Turbo aplicam a mesma lógica à geração de imagens com texto preciso.
O efeito no fluxo criativo é real. Ciclos de iteração que levavam minutos agora levam segundos. Você consegue rodar dez variações no tempo que antes era necessário para gerar uma, o que muda fundamentalmente a forma como você usa a geração como ferramenta criativa.
O salto de inferência que tornou isso possível
Os ganhos de velocidade não são apenas melhorias de hardware. Eles vêm de mudanças no próprio processo de difusão: menos passos necessários por imagem, agendadores de ruído melhores e técnicas de quantização que preservam a qualidade em precisão menor. Modelos treinados em conjuntos de dados destilados podem produzir resultados equivalentes ou melhores com 4 a 8 passos de difusão, em vez de 30 a 50.
O SDXL Lightning 4Step foi um primeiro sinal de para onde as coisas estavam indo. Ele rodava no teto de qualidade do SDXL em 4 passos, em vez de 30. Os modelos lançados em 2025-2026 incorporaram essa abordagem em todos eles, então a geração rápida não é mais uma variante especializada; é a expectativa padrão.
A edição de imagens foi absorvida pela geração
Uma das mudanças menos comentadas de 2026 é que a linha entre geração e edição ficou tão borrada que quase desapareceu. As ferramentas de edição que antes exigiam pipelines separados agora vivem dentro da própria etapa de geração.
Flux Kontext e a mudança no inpainting
O Flux Kontext Pro e o Flux Kontext Max representam uma mudança de categoria específica. Não são modelos de geração com recursos de edição acoplados. São modelos sensíveis ao contexto que podem modificar qualquer parte de uma imagem existente com base em um prompt de texto, mantendo o restante da imagem intacto e sem emendas visíveis.
Os pipelines de inpainting anteriores exigiam mascaramento cuidadoso, várias iterações para combinar com a imagem ao redor e, em geral, deixavam artefatos visíveis nas bordas. Modelos da classe Kontext entendem o contexto do que estão editando e produzem resultados sem emendas em uma única passagem. As aplicações práticas incluem:
- Remoção ou substituição de objetos sem artefatos de máscara
- Mudanças de roupa e de fundo mantendo rostos e estruturas intactos
- Adição precisa de texto em imagens existentes (combinada com a precisão de texto no estilo Ideogram)
- Preenchimento de tela estendida com conteúdo coerente e compatível com o contexto
Edições sensíveis ao contexto que mantêm a estrutura
O Flux Depth Pro e o Flux Canny Pro acrescentam controle estrutural ao processo de geração. A edição com percepção de profundidade significa que você pode aplicar prompts de estilo ou de conteúdo que respeitem o layout tridimensional de uma cena, de modo que superfícies, sombras e relações espaciais continuem corretas após a edição. O controle baseado em Canny trava a estrutura das bordas enquanto reestiliza inteiramente o conteúdo da superfície.
Para fotografia de produtos, visualização arquitetônica e trabalhos comerciais que exigem layouts espaciais específicos, isso é uma melhoria qualitativa em relação ao que era possível com abordagens de ControlNet em 2024. O Flux Dev LoRA e o Flux Kontext Dev LoRA ampliam ainda mais essas capacidades para cenários de fine-tuning personalizado.
Como esses modelos se comparam num relance
| Capacidade | Modelo de ponta (2024) | Modelo de ponta (2026) |
|---|
| Resolução máxima | ~1MP | 4MP |
| Texto nas imagens | Em sua maioria ilegível | Preciso e estilizado |
| Rostos em cenas com várias pessoas | Um sujeito confiável | 2-3 sujeitos como padrão |
| Qualidade da geração rápida | Visivelmente inferior | Quase idêntica à lenta |
| Integração da edição | Pipeline separado | Integrada à geração |
| Consistência de estilo em um lote | Exige LoRA | Nativa em alguns modelos |
💡 A mudança mais importante não é nenhuma capacidade isolada. É a combinação. Um modelo rápido, de alta resolução, preciso com texto e capaz de cenas com múltiplos sujeitos ao mesmo tempo não existia dois anos atrás. Essa combinação é agora a expectativa padrão para um modelo de ponta, e não uma lista de ferramentas especializadas separadas.
Os modelos Playground v2.5 Aesthetic e SDXL que definiram a qualidade em 2024 ainda estão disponíveis e continuam produzindo resultados fortes para casos de uso específicos, sobretudo saídas artísticas e estilizadas. Mas eles já não representam o teto de capacidade.
Experimente a geração de modelos de 2026 no PicassoIA
Se você quer ver tudo isso na prática sem gerenciar APIs, computação local ou pesos de modelos, o PicassoIA hospeda a linha completa de modelos discutida neste artigo. Você digita um prompt, escolhe um modelo e gera.
Para retratos fotorrealistas e cenas com iluminação precisa, comece com o Flux 2 Pro ou o RealVisXL v3.0 Turbo. Para imagens com texto legível e corretamente estilizado, o Ideogram v3 Quality é o caminho direto. Para saída em 4K sem uma etapa separada de upscaling, o Seedream 4.5 produz detalhes densos nativamente. Para editar uma foto existente com uma instrução de texto, o Flux Kontext Pro resolve em uma única passagem, sem ferramentas de mascaramento separadas.
A melhor forma de entender o quanto mudou é rodar o mesmo prompt em um modelo da era de 2024 e em um modelo atual, lado a lado. A diferença não é sutil. A coleção de 91 modelos de texto para imagem do PicassoIA torna essa comparação imediata, sem nenhuma configuração. Seja qual for o tipo de imagem que você cria, o teto subiu muito em 2026, e as ferramentas para alcançá-lo já estão aí.