La deriva de personajes en el video con IA no es una molestia menor. Pasas horas creando una historia atractiva y, a partir de la tercera escena, tu protagonista parece una persona completamente distinta: toda la producción se viene abajo. Seedance 2.0 de ByteDance aborda este problema a nivel de arquitectura, y los resultados son llamativos. Así funciona en realidad.
El verdadero problema del video con IA de varias escenas
La mayoría de las personas que han intentado crear narrativas de varias escenas con generadores de video con IA se han topado con el mismo muro. La primera escena queda exactamente como quieres. La segunda se parece bastante. En la quinta, tu héroe tiene otra estructura ósea, otra nariz y una prenda que, de alguna forma, pasó de azul a gris. No es un error menor. Es un desafío fundamental de cómo los modelos de video basados en difusión procesan la información.
Por qué los personajes derivan entre escenas
Cada escena de video con IA se genera como un resultado en gran medida independiente. Sin una representación persistente del personaje, el modelo vuelve a muestrear los rasgos relacionados con la identidad desde cero cada vez que genera un nuevo clip. Piensa en pedirle a un artista distinto que dibuje al mismo personaje usando solo una descripción de texto como referencia. Los rasgos generales sobreviven, pero los micro-detalles, como la curva exacta de la mandíbula, la separación concreta de los ojos o el tono preciso del cabello, se pierden en la traducción.
El nombre técnico de esto es erosión de identidad. Se acumula escena tras escena, y es una de las razones principales por las que los cortometrajes generados con IA han parecido fragmentados históricamente, aunque los planos en sí sean individualmente bellos.
Por qué la coherencia temporal es tan difícil
La coherencia temporal significa que la información visual se mantiene estable a lo largo del tiempo. En el cine real, un actor humano resuelve esto automáticamente. En el video con IA, el modelo debe aprender a conservar:
- Geometría facial: estructura ósea, posición de los ojos, forma de la nariz
- Detalles de textura: tono de piel, pecas, cicatrices, tatuajes
- Ropa: color, textura, ajuste, patrones de desgaste
- Cabello: longitud, color, patrón de rizo, dirección natural del movimiento
- Proporciones corporales: relaciones de altura, ancho de hombros, postura
Mantener todo esto a la vez entre escenas generadas en pasadas de inferencia separadas es realmente difícil. Exige que el modelo conserve una representación persistente del sujeto en lugar de regenerarlo desde cero.
Cómo Seedance 2.0 resuelve esto
Seedance 2.0 aborda la coherencia de personajes mediante varios sistemas entrelazados que funcionan tanto en el entrenamiento como en la inferencia. En lugar de tratar cada clip como una tarea de generación independiente, el modelo mantiene lo que puede describirse como un vector de estado del personaje, una representación comprimida de la identidad del sujeto que persiste a lo largo del pipeline de generación.
Anclaje de identidad mediante fotogramas de referencia
El mecanismo más importante de Seedance 2.0 es la inyección de fotogramas de referencia. Cuando proporcionas una imagen junto con tu prompt de texto, el modelo no usa esa imagen como una simple sugerencia de estilo. Realiza una codificación profunda de la identidad visual del sujeto, extrayendo:
- Posiciones de puntos de referencia faciales con precisión de subpíxel
- Mapas de textura para las superficies de piel, cabello y tela
- Perfiles de color normalizados por iluminación que pueden volver a aplicarse bajo otra iluminación
- Datos de silueta y proporción del cuerpo completo
Estas características extraídas se inyectan después en el proceso de generación en varias capas de atención, no solo al principio. Esto significa que la influencia de la identidad se aplica de forma continua durante toda la inferencia, devolviendo el resultado hacia el personaje de referencia incluso cuando cambian el entorno, la iluminación y la acción de la escena.
Mecanismos de atención entre escenas
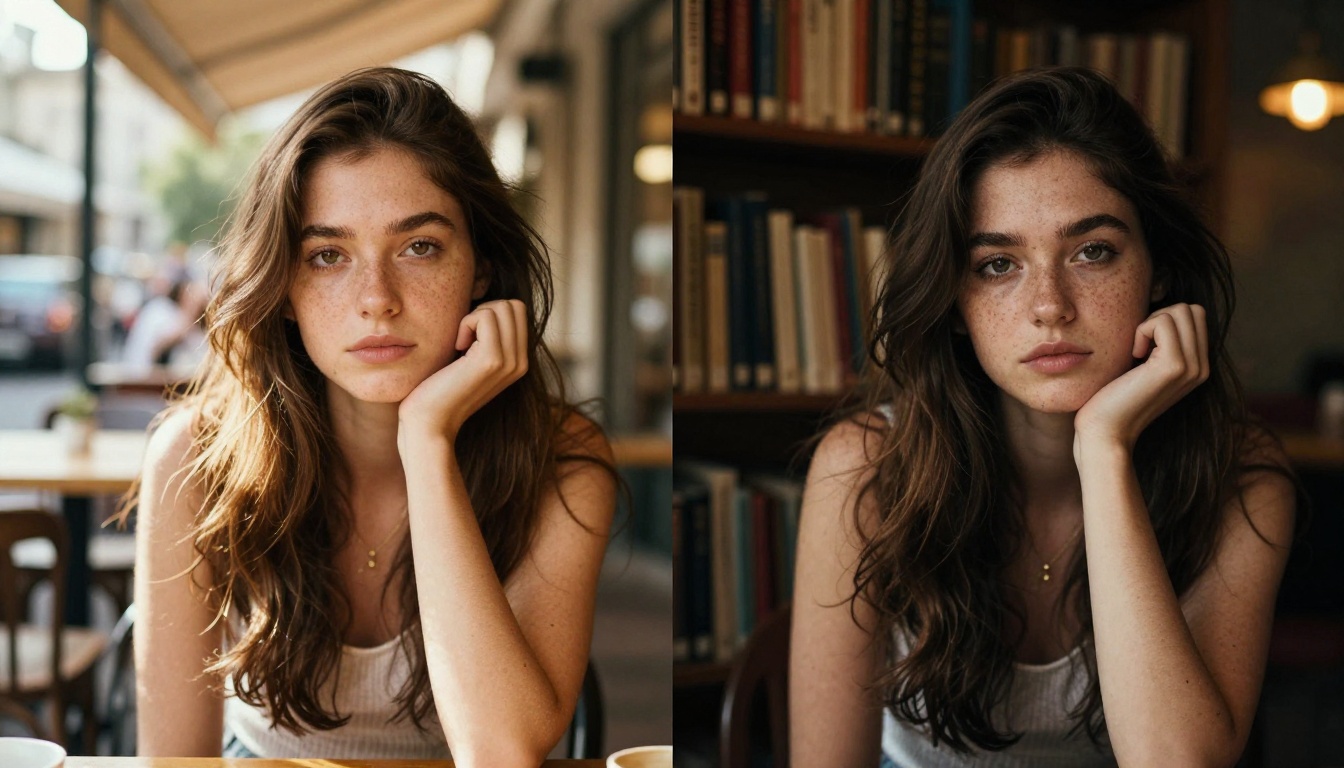
Más allá de la generación de una sola escena, Seedance 2.0 admite condicionamiento entre planos. Al generar una secuencia de escenas, el modelo puede tomar el último fotograma del clip anterior y usarlo como ancla flexible para la siguiente generación. Esto es distinto de una simple continuación de imagen a video. El modelo no necesita que la pose o la iluminación coincidan exactamente. En cambio, extrae los componentes de identidad de ese fotograma previo y los usa como condicionamiento, lo que permite que la acción, el ángulo de cámara y el entorno cambien libremente mientras la identidad visual central del personaje permanece fija.
Consejo: Para obtener los mejores resultados, usa siempre la misma imagen de referencia de origen en cada escena de una secuencia. El condicionamiento entre planos funciona bien, pero una referencia constante de alta calidad sigue siendo el ancla más fiable para las producciones de varias escenas.
Codificación temporal en la arquitectura
La arquitectura subyacente de Seedance 2.0 usa un transformador de doble flujo que procesa la información espacial y temporal en paralelo en lugar de en secuencia. Esto es importante para la coherencia de personajes porque permite al modelo considerar las relaciones entre fotogramas dentro de un clip y, a través del sistema de condicionamiento, las relaciones entre clips dentro de una secuencia.
En la práctica, esto significa:
| Característica | Modelo de video estándar | Seedance 2.0 |
|---|
| Fuente de identidad | Solo prompt de texto | Texto + codificación profunda de imagen de referencia |
| Vínculo entre escenas | Ninguno | Condicionamiento entre planos |
| Procesamiento temporal | Secuencial | Paralelo de doble flujo |
| Tasa de deriva del personaje | Alta después de la escena 2-3 | Mínima en 6 o más escenas |
| Adaptación a la iluminación | Remuestreada en cada escena | Normalizada por identidad, luego reiluminada |
Qué se mantiene realmente coherente
Entender lo que el modelo conserva y lo que no ayuda a fijar expectativas realistas para el trabajo de producción.
Lo que se mantiene estable
- Forma del rostro y rasgos faciales clave: línea de la mandíbula, separación de los ojos, puente de la nariz, estructura de los labios
- Color del cabello y longitud general: el modelo respeta estos rasgos incluso con iluminación distinta
- Color de la ropa y diseño general: una chaqueta roja sigue siendo una chaqueta roja, aunque la textura fina puede variar
- Tono de piel: constante incluso al pasar de escenas en interiores a exteriores
- Proporciones corporales: altura, anchura de hombros, complexión general
Dónde vigilar la deriva
- Textura fina de la ropa: los patrones intrincados o los logotipos pueden cambiar entre escenas
- Accesorios: joyas, gafas y sombreros necesitan refuerzo en el prompt
- Detalle fino del cabello: el comportamiento de cada mechón varía, aunque el color y la longitud se mantienen
- Secuencias muy largas: con más de 8-10 escenas, se acumula algo de deriva incluso con un condicionamiento fuerte
Consejo: Al generar secuencias largas, vuelve a introducir periódicamente la imagen de referencia original como ancla en lugar de encadenar desde el resultado de la escena anterior. Así la identidad vuelve a su punto de partida y se evita la deriva gradual.
Transiciones entre escenas sin perder la identidad
Una de las aplicaciones prácticas en las que brilla la coherencia de Seedance 2.0 es el manejo de distintos tipos de transiciones entre escenas. Crear una narrativa fluida exige que el personaje sobreviva no solo al movimiento continuo, sino también a los cortes secos, los cambios de iluminación, los cambios de ubicación y los cambios emocionales.
Cortes secos frente a movimiento continuo
Los cortes secos, en los que generas dos clips completamente separados y cortas entre ellos en la posproducción, son la prueba más exigente para la coherencia de personajes. Aquí no hay ninguna continuidad visual entre las imágenes de origen. Lo único que une las dos escenas es la señal de condicionamiento.
Seedance 2.0 maneja bien los cortes secos cuando la imagen de referencia es coherente. La identidad del personaje reaparece en la nueva escena incluso ante cambios radicales de ángulo de cámara, iluminación o entorno. Esto es lo que lo diferencia de modelos anteriores como Seedance 1.5 Pro, en los que los cortes secos casi siempre producían una deriva de identidad notable.
Cambios de iluminación entre escenas
Pasar a un personaje de una escena exterior brillante al mediodía a un interior nocturno y tenue es una de las pruebas más reveladoras para un modelo de video con IA. La mayoría de los modelos, o bien aplanan la identidad en rasgos planos con poca luz, o bien introducen detalles alucinados que no estaban en la referencia.
La codificación de identidad normalizada por iluminación de Seedance 2.0 significa que el modelo separa la apariencia intrínseca del personaje de la iluminación de la escena. Luego vuelve a aplicar las condiciones de luz de la nueva escena sobre la identidad estable, en lugar de regenerar la identidad bajo esas nuevas condiciones. El resultado es que las mismas pecas, el mismo color de ojos y el mismo tono de piel sobreviven a la transición de iluminación, solo que se representan de otra forma, tal como lo haría la luz real.
Seedance 2.0 frente a otros modelos
Merece la pena situar a Seedance 2.0 en contexto con otros modelos disponibles para trabajos de video de varias escenas.
Kling V3 ofrece una calidad sólida por escena y tiene su propio sistema de control de movimiento, pero la persistencia de identidad entre escenas requiere más intervención manual en la estructura del prompt. DreamActor-M2.0, también de ByteDance, adopta un enfoque distinto al centrarse en animar una única imagen de origen con movimiento, lo que evita por completo el problema entre escenas, pero limita la flexibilidad narrativa.
Para los creadores que construyen historias reales de varias escenas, Seedance 2.0 ofrece actualmente el mejor equilibrio entre calidad visual por escena y persistencia de personajes entre escenas dentro de su categoría.
| Modelo | Calidad por escena | Coherencia de personajes | Velocidad | Compatibilidad con varias escenas |
|---|
| Seedance 2.0 | Excelente | Excelente | Moderada | Nativa |
| Seedance 2.0 Fast | Muy buena | Muy buena | Rápida | Nativa |
| Kling V3 | Excelente | Buena | Moderada | Manual |
| DreamActor-M2.0 | Muy buena | Excelente (una sola escena) | Moderada | Limitada |
Cómo usar Seedance 2.0 en PicassoIA
PicassoIA hace que Seedance 2.0 sea accesible sin ninguna configuración. Este es un flujo de trabajo paso a paso para generar una narrativa coherente de varias escenas.
Paso 1: Prepara tu referencia de personaje
Elige una única imagen de referencia de alta calidad para tu personaje. La referencia ideal es:
- Un retrato nítido, de frente o de 3/4, con el rostro totalmente visible
- Iluminación natural y uniforme, sin sombras marcadas ni contraste extremo
- El personaje con la ropa que llevará a lo largo de la historia
- Tomada con una resolución de 512px o superior, con el sujeto ocupando la mayor parte del encuadre
Paso 2: Escribe descripciones de escena que refuercen la identidad
Tus prompts de texto deben describir la acción y el entorno, pero también incluir un breve refuerzo de identidad. Una buena estructura es:
[Descripción del personaje] + [Acción] + [Entorno] + [Cámara e iluminación]
Ejemplo: "Mujer joven de cabello castaño y ojos ámbar, con una chaqueta de lona roja, caminando por una calle empedrada mojada por la lluvia de noche, luz cálida de farola desde arriba, objetivo de 35 mm, cinematográfico"
La descripción del personaje no tiene por qué ser exhaustiva, porque la imagen de referencia lleva el peso del detalle, pero mencionar algunos rasgos ancla, como el color del cabello, el color de los ojos y las prendas clave, ayuda al modelo a mantenerse fiel a la referencia.
Paso 3: Genera la escena uno
Sube tu imagen de referencia y tu prompt de texto a Seedance 2.0 en PicassoIA. Ejecuta la generación y revisa el resultado. Si el personaje se ve bien, guarda este clip y anota qué ajustes de generación usaste.
Paso 4: Encadena tus escenas
Para la siguiente escena, usa la misma imagen de referencia original combinada con un nuevo prompt de texto que describa la escena siguiente. Si quieres usar el condicionamiento entre planos, exporta el último fotograma del clip anterior y úsalo junto con tu referencia original.
Paso 5: Revisa e itera
Revisa cada clip generado en busca de deriva de identidad antes de pasar a la siguiente escena. Fíjate en concreto en:
- Forma y color de los ojos
- Mandíbula y barbilla
- Coherencia del color del cabello
- Coincidencia del color de la ropa
Si detectas deriva, vuelve a generar esa escena concreta con la imagen de referencia original antes de seguir encadenando. No encadenes desde un clip con deriva, porque la deriva se acumula.
Paso 6: Monta en posproducción
Una vez generadas y verificadas todas las escenas en cuanto a identidad, llévalas a tu software de edición de video. Seedance 2.0 se combina de forma natural con herramientas de mejora de video con IA para el escalado y la estabilización antes de la exportación final.
Consejo: Usa Seedance 2.0 Fast para las pasadas de prueba iniciales, para comprobar la composición y la acción antes de lanzar generaciones de calidad completa en las escenas con las que estés conforme. Así ahorras créditos y aceleras la iteración.
Cuándo importa de verdad la coherencia de personajes
No todos los casos de uso del video con IA necesitan coherencia de personajes en varias escenas. Pero en varias categorías de trabajo, no es opcional. Es todo el producto.
Cortometrajes narrativos: Cualquier contenido basado en una historia en el que el espectador necesita seguir a un personaje concreto a través de las escenas. La coherencia no es un extra, es lo que hace que la narrativa tenga sentido.
Contenido con personajes de marca: Las empresas que crean contenido protagonizado por mascotas o videos con portavoces necesitan que el personaje sea reconocible al instante en distintos escenarios, campañas y formatos.
Series para redes sociales: Contenido episódico en el que el mismo personaje aparece semana tras semana. La retención de la audiencia depende de que el personaje resulte familiar, y la deriva de identidad entre episodios rompe ese vínculo.
Demostraciones de productos: Cuando un personaje de marca interactúa con un producto a lo largo de varias escenas o videos, la coherencia visual está directamente ligada al reconocimiento de marca y a la confianza.
Resultados reales: qué cambia en la práctica
Los usuarios que han pasado de modelos de generación anteriores a Seedance 2.0 señalan la mejora más notable en dos áreas: la estabilidad del rostro ante cambios de iluminación y la persistencia del color de la ropa. Ambos eran puntos débiles importantes en los flujos de trabajo anteriores.
El modelo no es perfecto. Los accesorios finos y los patrones de ropa complejos siguen necesitando prompts cuidadosos. Las secuencias muy largas siguen beneficiándose de reinicios periódicos de la referencia. Pero la coherencia base, el nivel que obtienes sin ningún ajuste especial en el flujo de trabajo, es sustancialmente superior a la que ofrecían los modelos de video con IA anteriores.
Para los creadores que trabajan en algo más que un video de una sola escena, esa base importa. Es la diferencia entre un resultado de varias escenas que parece producido profesionalmente y uno que parece una colección aleatoria de clips.
Las tres mejoras más notables que los usuarios perciben justo después de pasarse a Seedance 2.0:
- Menos tiempo en correcciones: se necesitan menos regeneraciones para arreglar la identidad con deriva
- Más libertad creativa: puedes escribir cambios de escena más atrevidos sin preocuparte de que tu personaje parezca un desconocido
- Resultados narrativos más sólidos: los personajes coherentes crean una conexión emocional con el público, y eso se refleja en las métricas de interacción
Empieza a crear con Seedance 2.0 hoy
La tecnología detrás de la coherencia de personajes de Seedance 2.0 es sofisticada, pero usarla no tiene por qué serlo. En PicassoIA puedes empezar a generar videos de varias escenas con una sola imagen de referencia y unos cuantos prompts descriptivos. La plataforma se encarga de la infraestructura, y Seedance 2.0 se encarga del personaje. Tú te concentras en la historia.
Ya estés construyendo un cortometraje, una campaña de marca o una serie episódica para redes sociales, el flujo de trabajo es el mismo: una referencia visual sólida, descripciones de escena claras y el modelo adecuado. Seedance 2.0 te da las herramientas para construirlo, y Seedance 2.0 Fast te permite iterar rápidamente antes de comprometerte con renders de calidad completa.
Prueba tu primera generación de varias escenas en PicassoIA y descubre hasta dónde lleva la identidad coherente de tus personajes a tu forma de contar historias.


