La dérive des personnages dans la vidéo IA n’est pas un simple désagrément. Vous passez des heures à construire une histoire captivante, mais dès la troisième scène, votre protagoniste ressemble à une tout autre personne : toute la production s’effondre. Seedance 2.0 de ByteDance traite ce problème au niveau de l’architecture, et les résultats sont frappants. Voici comment cela fonctionne réellement.
Le vrai problème de la vidéo IA multi-scènes
La plupart des personnes qui ont essayé de créer des récits multi-scènes avec des générateurs de vidéo IA se sont heurtées au même mur. La première scène est exactement comme prévu. La deuxième s’en approche. À la cinquième, votre héros a une structure osseuse différente, un autre nez, et des vêtements passés on ne sait comment du bleu au gris. Ce n’est pas un simple bug. C’est un défi fondamental dans la façon dont les modèles vidéo basés sur la diffusion traitent l’information.
Pourquoi les personnages dérivent d’une scène à l’autre
Chaque scène vidéo générée par IA est produite comme une sortie largement indépendante. Sans représentation persistante du personnage, le modèle rééchantillonne les caractéristiques liées à l’identité depuis zéro à chaque nouveau clip. Imaginez demander à un artiste différent de dessiner le même personnage, avec pour seule référence une description textuelle. Les traits généraux survivent, mais les micro-détails (la courbe exacte de la mâchoire, l’écartement précis des yeux, la nuance exacte des cheveux) se perdent en cours de route.
Le terme technique pour désigner ce phénomène est érosion de l’identité. Il s’accumule de scène en scène, et c’est l’une des principales raisons pour lesquelles les courts métrages générés par IA ont souvent paru fragmentés, même lorsque les plans pris isolément étaient magnifiques.
Pourquoi la cohérence temporelle est si difficile
La cohérence temporelle signifie que l’information visuelle reste stable dans le temps. Dans un film réel, un acteur humain résout cela automatiquement. Dans la vidéo par IA, le modèle doit apprendre à préserver :
- La géométrie du visage : ossature, position des yeux, forme du nez
- Les détails de texture : teint, taches de rousseur, cicatrices, tatouages
- Les vêtements : couleur, texture, coupe, traces d’usure
- Les cheveux : longueur, couleur, type de boucles, direction naturelle du mouvement
- Les proportions du corps : rapports de taille, largeur des épaules, posture
Préserver tous ces éléments simultanément d’une scène à l’autre, lorsque celles-ci sont générées lors de passes d’inférence séparées, est véritablement difficile. Cela exige que le modèle conserve une représentation persistante du sujet, au lieu de le régénérer à partir de zéro.
Seedance 2.0 aborde la cohérence des personnages grâce à plusieurs systèmes imbriqués, qui fonctionnent à la fois au niveau de l’entraînement et de l’inférence. Plutôt que de traiter chaque clip comme une génération indépendante, le modèle maintient ce que l’on peut décrire comme un vecteur d’état du personnage, une représentation compressée de l’identité du sujet qui persiste tout au long du pipeline de génération.
L’ancrage de l’identité par images de référence
Le mécanisme le plus important de Seedance 2.0 est l’injection d’images de référence. Lorsque vous fournissez une image en entrée avec votre prompt textuel, le modèle ne se contente pas d’utiliser cette image comme simple suggestion stylistique. Il réalise un encodage approfondi de l’identité visuelle du sujet, en extrayant :
- Les positions des repères faciaux avec une précision sub-pixel
- Les cartes de texture pour la peau, les cheveux et les surfaces textiles
- Les profils de couleur normalisés selon l’éclairage, pouvant être réappliqués sous différentes lumières
- Les données de silhouette et de proportion pour l’ensemble du corps
Ces caractéristiques extraites sont ensuite injectées dans le processus de génération à plusieurs couches d’attention, et non pas seulement au début. L’influence de l’identité s’applique donc en continu tout au long de l’inférence, ramenant la sortie vers le personnage de référence même lorsque l’environnement, la lumière et l’action de la scène changent.
Mécanismes d’attention inter-scènes
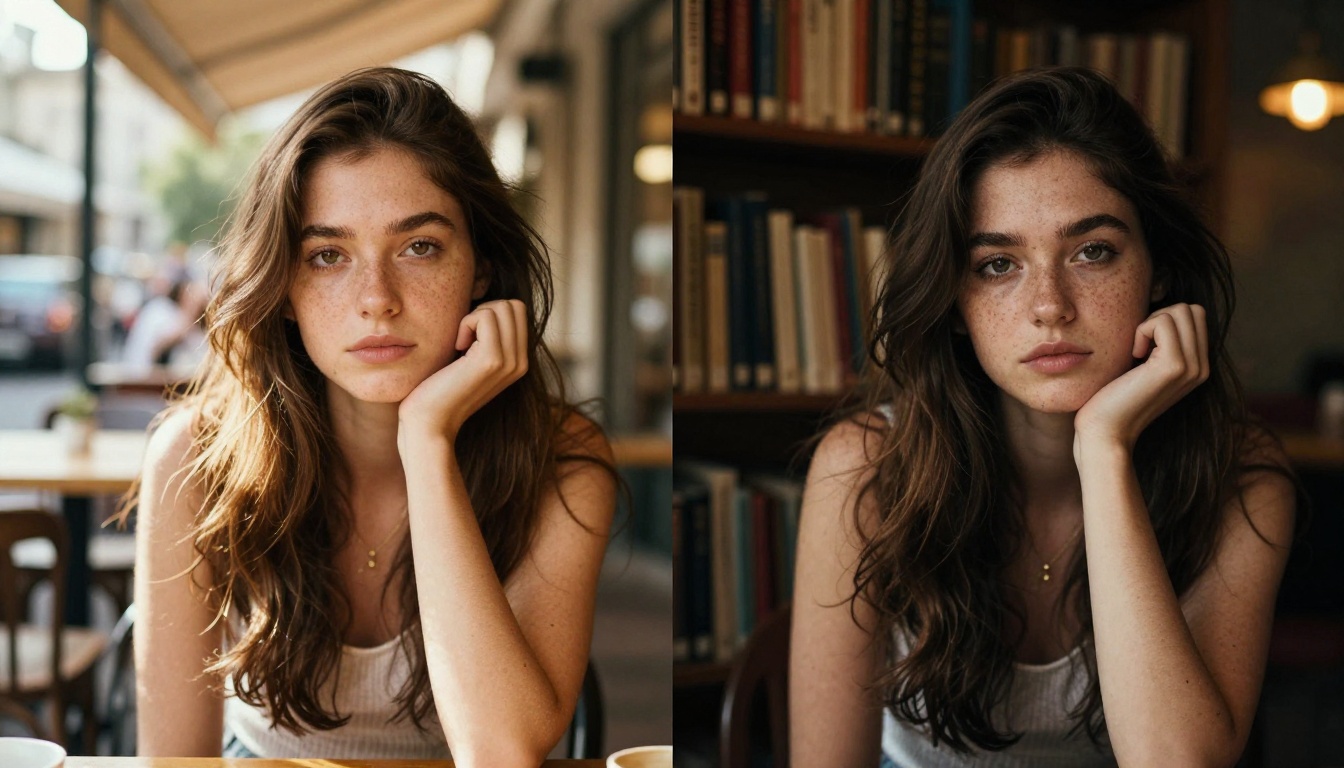
Au-delà de la génération d’une seule scène, Seedance 2.0 prend en charge le conditionnement inter-plans. Lors de la génération d’une séquence de scènes, le modèle peut prendre la dernière image du clip précédent et l’utiliser comme ancre souple pour la génération suivante. Ce n’est pas une simple continuation image vers vidéo. Le modèle n’a pas besoin que la pose ou l’éclairage correspondent exactement. Il extrait plutôt les composantes d’identité de cette image précédente et les utilise comme conditionnement, ce qui permet à l’action, à l’angle de caméra et à l’environnement de changer librement, tandis que l’identité visuelle essentielle du personnage reste verrouillée.
Astuce : Pour de meilleurs résultats, utilisez toujours la même image de référence source pour chaque scène d’une séquence. Le conditionnement inter-plans fonctionne bien, mais une référence constante de haute qualité reste l’ancre la plus fiable pour les productions multi-scènes.
L’encodage temporel dans l’architecture
L’architecture sous-jacente de Seedance 2.0 repose sur un transformeur à double flux qui traite les informations spatiales et temporelles en parallèle plutôt que séquentiellement. Cela compte pour la cohérence des personnages, car cela permet au modèle de prendre en compte les relations d’image à image au sein d’un clip et, grâce au système de conditionnement, les relations de clip à clip au sein d’une séquence.
Concrètement, cela signifie que :
| Caractéristique | Modèle vidéo standard | Seedance 2.0 |
|---|
| Source de l’identité | Prompt textuel uniquement | Encodage approfondi texte + image de référence |
| Lien entre les scènes | Aucun | Conditionnement inter-plans |
| Traitement temporel | Séquentiel | Double flux parallèle |
| Taux de dérive du personnage | Élevé après la scène 2-3 | Minimal sur plus de 6 scènes |
| Adaptation à l’éclairage | Rééchantillonné à chaque scène | Identité normalisée, puis rééclairée |
Ce qui reste réellement cohérent
Comprendre ce que le modèle préserve et ce qu’il ne préserve pas aide à fixer des attentes réalistes pour un travail de production.
Ce qui reste stable
- Forme du visage et traits faciaux clés : mâchoire, écartement des yeux, arête du nez, structure des lèvres
- Couleur des cheveux et longueur générale : le modèle les respecte même sous des éclairages différents
- Couleur des vêtements et design général : une veste rouge reste une veste rouge, même si la texture fine peut varier
- Teint : cohérent même lors des transitions entre intérieur et extérieur
- Proportions du corps : taille, largeur des épaules, carrure générale
Où surveiller la dérive
- Texture fine des vêtements : les motifs complexes ou les logos peuvent changer d’une scène à l’autre
- Accessoires : bijoux, lunettes et chapeaux nécessitent un renforcement dans le prompt
- Détails fins des cheveux : le comportement de chaque mèche varie, même si la couleur et la longueur tiennent
- Séquences très longues : au-delà de 8 à 10 scènes, une certaine dérive s’accumule, même avec un conditionnement solide
Astuce : Pour les séquences longues, réintroduisez régulièrement l’image de référence d’origine comme ancre, au lieu d’enchaîner à partir de la sortie de la scène précédente. Cela réinitialise l’horloge de l’identité et évite la dérive progressive.
Transitions entre scènes sans perdre l’identité
L’une des applications concrètes où la cohérence de Seedance 2.0 fait la différence concerne la gestion des différents types de transitions entre scènes. Créer un récit fluide exige que le personnage survive non seulement au mouvement continu, mais aussi aux coupes franches, aux changements d’éclairage, aux changements de lieu et aux variations émotionnelles.
Coupes franches ou mouvement continu
Les coupes franches, où vous générez deux clips entièrement séparés et les montez l’un après l’autre en post-production, constituent le plus grand test de cohérence des personnages. Ici, il n’existe aucune continuité visuelle entre les images source. Le seul élément qui relie les deux scènes est le signal de conditionnement.
Seedance 2.0 gère bien les coupes franches lorsque l’image de référence est constante. L’identité du personnage réapparaît dans la nouvelle scène, même lors de changements radicaux d’angle de caméra, d’éclairage ou d’environnement. C’est ce qui le distingue de modèles antérieurs comme Seedance 1.5 Pro, dont les coupes franches produisaient presque toujours une dérive d’identité notable.
Changements d’éclairage entre les scènes
Faire passer un personnage d’une scène extérieure lumineuse, en plein midi, à un intérieur sombre en soirée est l’un des tests les plus révélateurs pour un modèle vidéo par IA. La plupart des modèles aplatissent soit l’identité en traits uniformes sous faible lumière, soit introduisent des détails hallucinés absents de la référence.
L’encodage d’identité normalisé selon l’éclairage de Seedance 2.0 signifie que le modèle sépare l’apparence intrinsèque du personnage de l’éclairage de la scène. Il réapplique ensuite les conditions lumineuses de la nouvelle scène à l’identité stable, au lieu de régénérer l’identité dans ces nouvelles conditions. Le résultat : les mêmes taches de rousseur, la même couleur des yeux, le même teint survivent à la transition d’éclairage, simplement rendus différemment, comme la lumière réelle les rendrait.
Seedance 2.0 face à d’autres modèles
Il est utile de replacer Seedance 2.0 dans le contexte des autres modèles disponibles pour le travail vidéo multi-scènes.
Kling V3 offre une excellente qualité par scène et dispose de son propre système de contrôle du mouvement, mais la persistance de l’identité d’une scène à l’autre nécessite davantage d’intervention manuelle dans la structure du prompt. DreamActor-M2.0, également de ByteDance, adopte une approche différente en se concentrant sur l’animation d’une seule image source par le mouvement, ce qui contourne entièrement le problème inter-scènes, mais limite la souplesse narrative.
Pour les créateurs qui construisent de véritables histoires multi-scènes, Seedance 2.0 offre actuellement le meilleur équilibre, dans sa catégorie, entre qualité visuelle par scène et persistance du personnage d’une scène à l’autre.
| Modèle | Qualité par scène | Cohérence du personnage | Vitesse | Prise en charge multi-scène |
|---|
| Seedance 2.0 | Excellente | Excellente | Modérée | Native |
| Seedance 2.0 Fast | Très bonne | Très bonne | Rapide | Native |
| Kling V3 | Excellente | Bonne | Modérée | Manuelle |
| DreamActor-M2.0 | Très bonne | Excellente (scène unique) | Modérée | Limitée |
Utiliser Seedance 2.0 sur PicassoIA
PicassoIA rend Seedance 2.0 accessible sans aucune configuration. Voici un flux de travail étape par étape pour générer un récit multi-scène cohérent.
Étape 1 : préparer la référence du personnage
Choisissez une image de référence unique et de haute qualité pour votre personnage. La référence idéale est :
- Un portrait net de face ou en 3/4, visage entièrement visible
- Éclairage naturel et uniforme, sans ombres marquées ni contraste extrême
- Le personnage porte les vêtements qu’il portera tout au long de l’histoire
- Image d’une résolution d’au moins 512 px, le sujet occupant la plus grande partie du cadre
Étape 2 : rédiger des descriptions de scène qui renforcent l’identité
Vos prompts textuels doivent décrire l’action et l’environnement, tout en incluant de brefs renforts d’identité. Une bonne structure est :
[Description du personnage] + [Action] + [Environnement] + [Caméra et éclairage]
Exemple : « Jeune femme brune aux yeux ambrés, vêtue d’une veste en toile rouge, marchant dans une rue pavée humide de pluie la nuit, lumière chaude d’un réverbère au-dessus, objectif 35 mm, cinématographique »
La description du personnage n’a pas besoin d’être exhaustive, car l’image de référence porte l’essentiel du détail. Mentionner quelques éléments d’ancrage, comme la couleur des cheveux, la couleur des yeux et les vêtements clés, aide cependant le modèle à rester fidèle à la référence.
Étape 3 : générer la première scène
Importez votre image de référence et votre prompt textuel dans Seedance 2.0 sur PicassoIA. Lancez la génération et examinez le résultat. Si le personnage vous semble correct, enregistrez ce clip et notez les réglages utilisés.
Étape 4 : enchaîner vos scènes
Pour la scène suivante, utilisez la même image de référence d’origine, combinée à un nouveau prompt décrivant la scène suivante. Si vous souhaitez utiliser le conditionnement inter-plans, exportez la dernière image du clip précédent et utilisez-la avec votre référence d’origine.
Étape 5 : vérifier et itérer
Contrôlez chaque clip généré pour détecter une dérive d’identité avant de passer à la scène suivante. Examinez en particulier :
- La forme et la couleur des yeux
- La mâchoire et le menton
- La cohérence de la couleur des cheveux
- La correspondance de la couleur des vêtements
Si vous repérez une dérive, relancez cette scène précise avec l’image de référence d’origine avant de poursuivre l’enchaînement. Ne partez pas d’un clip qui dérive, sinon la dérive s’accumule.
Étape 6 : assembler en post-production
Une fois toutes les scènes générées et leur identité vérifiée, importez-les dans votre logiciel de montage vidéo. Seedance 2.0 se combine naturellement avec les outils d’amélioration vidéo par IA pour l’upscaling et la stabilisation avant l’export final.
Astuce : Utilisez Seedance 2.0 Fast pour les premiers essais, afin de vérifier la composition et l’action avant de lancer des générations en pleine qualité sur les scènes qui vous satisfont. Cela permet d’économiser des crédits et d’accélérer l’itération.
Quand la cohérence des personnages compte vraiment
Tous les cas d’usage de la vidéo par IA ne nécessitent pas une cohérence des personnages multi-scènes. Mais pour plusieurs catégories de travaux, elle est indispensable. Elle est tout le produit.
Courts-métrages narratifs : tout contenu porté par une histoire, où le spectateur doit suivre un personnage précis d’une scène à l’autre. La cohérence n’est pas un plus, c’est ce qui rend le récit cohérent.
Contenus à personnage de marque : les entreprises qui créent des contenus portés par une mascotte ou des vidéos avec un porte-parole ont besoin que le personnage soit immédiatement reconnaissable dans différents décors, campagnes et formats.
Séries sociales : contenus épisodiques où le même personnage apparaît semaine après semaine. La fidélisation du public dépend du fait que le personnage paraisse familier, et une dérive d’identité d’un épisode à l’autre brise ce lien.
Démonstrations de produits : lorsqu’un personnage de marque interagit avec un produit dans plusieurs scènes ou vidéos, la cohérence visuelle est directement liée à la reconnaissance de la marque et à la confiance.
Résultats concrets : ce qui change en pratique
Les utilisateurs ayant migré des modèles de génération précédents vers Seedance 2.0 signalent les améliorations les plus spectaculaires sur deux points : la stabilité du visage lors des changements d’éclairage et la persistance de la couleur des vêtements. Ces deux aspects constituaient des difficultés majeures dans les flux de travail antérieurs.
Le modèle n’est pas parfait. Les accessoires fins et les motifs de vêtements complexes demandent toujours un prompt soigné. Les séquences très longues profitent encore de réinitialisations périodiques de la référence. Mais la cohérence de base, celle que l’on obtient sans aucun ajustement particulier du flux de travail, est nettement supérieure à celle des modèles de vidéo IA antérieurs.
Pour les créateurs qui travaillent sur autre chose qu’une vidéo à scène unique, ce niveau de base compte. C’est la différence entre une sortie multi-scène qui paraît produite par des professionnels et une suite de clips disparates.
Les trois avantages les plus remarqués par les utilisateurs dès leur passage à Seedance 2.0 :
- Moins de temps en corrections : moins de générations à refaire pour corriger une identité qui dérive
- Plus de liberté créative : vous pouvez écrire des changements de scène plus audacieux sans craindre que votre personnage ressemble à un inconnu
- Un récit plus fort : des personnages constants créent un lien émotionnel avec le public, et cela se voit dans les indicateurs d’engagement
Commencez à créer avec Seedance 2.0 dès aujourd’hui
La technologie qui sous-tend la cohérence des personnages de Seedance 2.0 est sophistiquée, mais l’utiliser n’a pas à l’être. Sur PicassoIA, vous pouvez commencer à générer des vidéos multi-scènes à partir d’une seule image de référence et de quelques prompts descriptifs. La plateforme gère l’infrastructure, Seedance 2.0 gère le personnage. Vous, vous vous concentrez sur l’histoire.
Que vous construisiez un court récit, une campagne de marque ou une série sociale épisodique, le flux de travail reste le même : une image de référence solide, des descriptions de scène claires et le bon modèle. Seedance 2.0 vous donne les outils pour le réaliser, et Seedance 2.0 Fast vous permet d’itérer rapidement avant de lancer les rendus en pleine qualité.
Lancez votre première génération multi-scène sur PicassoIA et découvrez jusqu’où une identité de personnage constante peut porter votre narration.


