Un recorrido detallado para crear imágenes NSFW artísticas con modelos de Stable Diffusion. Cubre la selección de modelos, la arquitectura del prompt, la escala CFG, los prompts negativos, la personalización con LoRA y un flujo de trabajo paso a paso en PicassoIA para producir arte IA glamour impresionante y fotorrealista, sin configuración de software compleja.
Stable Diffusion cambió las reglas para quien quiere crear arte generado por IA, sobre todo contenido que las plataformas convencionales evitan. A diferencia de los generadores en la nube bloqueados tras filtros de contenido corporativos, los modelos de difusión de código abierto te dan control total sobre lo que generas, cómo escribes el prompt y hasta dónde llevas la estética. Este artículo explica paso a paso cómo crear arte IA NSFW bello y no explícito con Stable Diffusion: selección de modelos, estructura del prompt, ajuste de parámetros, personalización con LoRA y un flujo de trabajo completo en PicassoIA que no requiere instalar nada en tu equipo.
Por qué Stable Diffusion domina el arte IA NSFW
La mayoría de herramientas comerciales de imagen IA aplican filtros de seguridad agresivos que bloquean cualquier cosa remotamente sugerente. Stable Diffusion funciona de otra manera porque sus pesos están disponibles públicamente y se ejecutan en local o en plataformas que permiten más libertad creativa.
El código abierto significa control creativo real
Cuando Stability AI publicó los pesos de Stable Diffusion en 2022, se abrió una era en la que los creadores individuales podían ajustar, fusionar y desplegar modelos sin esperar a los ciclos de aprobación de una plataforma. La comunidad que se formó en torno a ello produjo rápidamente checkpoints especializados orientados al fotorrealismo y a la fotografía glamour, que es justo lo que hace posible el arte IA NSFW a escala.
No trabajas contra una caja negra. Ves el proceso de muestreo, la manipulación del espacio latente y cada parámetro. Esa transparencia es la razón por la que los artistas de IA serios usan Stable Diffusion como base, incluso en 2027. El impulso de la comunidad es enorme: cada semana aparecen nuevos checkpoints, adaptadores LoRA y embeddings, y la mayoría son gratuitos.
El ecosistema de modelos que lo hace posible
El verdadero poder de Stable Diffusion procede del ecosistema de la comunidad construido sobre él. Existen miles de checkpoints ajustados específicamente para producir imágenes glamour fotorrealistas. No necesitas entrenar nada desde cero. Cargas un checkpoint, escribes un prompt estructurado e iteras.
El ecosistema se divide en tres familias de modelos principales, cada una con fortalezas distintas: SD 1.5 para velocidad y compatibilidad con LoRA, SDXL para realismo de alta resolución y la nueva familia SD 3.5 para máxima fidelidad al prompt. Elegir entre ellas es la primera decisión real al empezar cualquier proyecto de arte IA NSFW.
Cómo elegir el checkpoint adecuado
La selección del modelo es la variable más importante en la calidad del resultado. Un checkpoint débil o que no encaja fallará, da igual lo bueno que sea tu prompt.
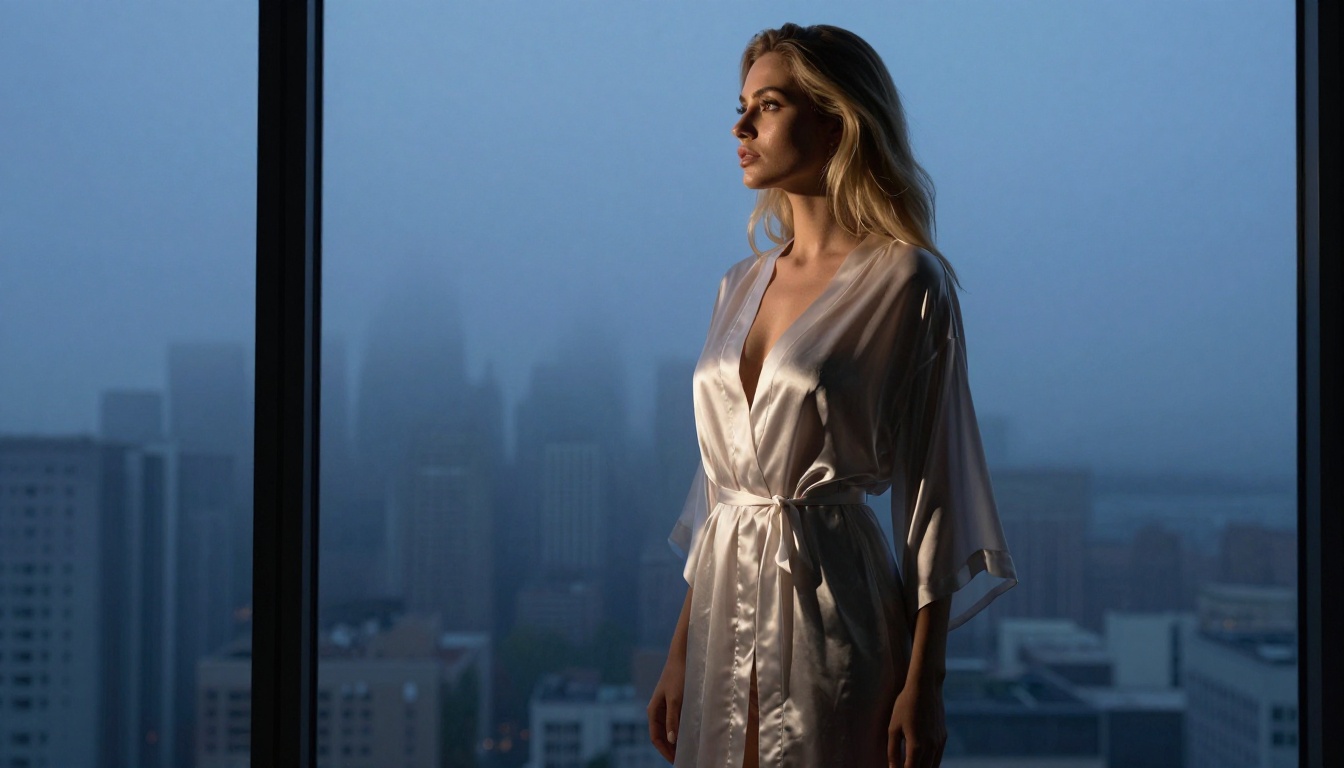
Para contenido NSFW de corte sugerente, los checkpoints basados en SDXL superan siempre a SD 1.5 en fotorrealismo. El espacio latente más amplio a 1024px hace que rostros, cabello, textura de la piel y tela se rendericen con bastante más detalle creíble. Stable Diffusion 3.5 Large va más allá con un mecanismo de atención completamente rediseñado que maneja prompts complejos con varios elementos con mucha más precisión que cualquier versión anterior de Stable Diffusion.
Realistic Vision y RealVisXL
Dos checkpoints de la comunidad figuran siempre entre los mejores para contenido glamour fotorrealista:
Realistic Vision v5.1: Basado en SD 1.5, este modelo se ajustó con cientos de miles de imágenes fotográficas. Produce tonos de piel, cabello y texturas de tela que pueden pasar por fotografía real a primera vista. Es muy útil para composiciones de retrato en las que quieres un control preciso de los rasgos faciales.
RealVisXL v3.0 Turbo: La versión SDXL de Realistic Vision. Funciona nativamente a 1024px, maneja mejor las composiciones de cuerpo completo que su predecesor y responde muy bien a las descripciones de iluminación en los prompts. Si vas a generar escenas con entornos complejos, es con el que conviene empezar.
💡 Para fotos glamour en playa, piscina o exterior, RealVisXL v3.0 Turbo produce una iluminación natural más convincente que Realistic Vision v5.1. Usa Realistic Vision para trabajos de retrato cerrado en los que la precisión facial sea la prioridad.
Cómo redactar prompts que funcionan
Los prompts malos producen malas imágenes, sea cual sea el modelo. Aquí es donde más horas pierden la mayoría de principiantes. La estructura del prompt determina directamente la composición, la iluminación, el ambiente y el realismo.
La anatomía de un prompt sólido
Todo prompt de arte NSFW de alta calidad tiene la misma estructura básica:
Entorno y escenario — ubicación, hora del día, ambiente
Especificación de iluminación — dirección, calidad, temperatura de color
Cámara y objetivo — distancia focal, apertura, ángulo
Modificadores de estilo y calidad — grano de película, resolución, enfoque fotográfico
Combinar los cinco elementos da al modelo instrucciones explícitas en cada nivel. Estás escribiendo un encargo para un fotógrafo, no solo describiendo una escena.
Sujeto, estilo y modificadores técnicos
Este es un ejemplo práctico de lo que hace una buena estructura de prompt:
Prompt débil:
beautiful woman, beach, sunset, suggestive
Prompt fuerte:
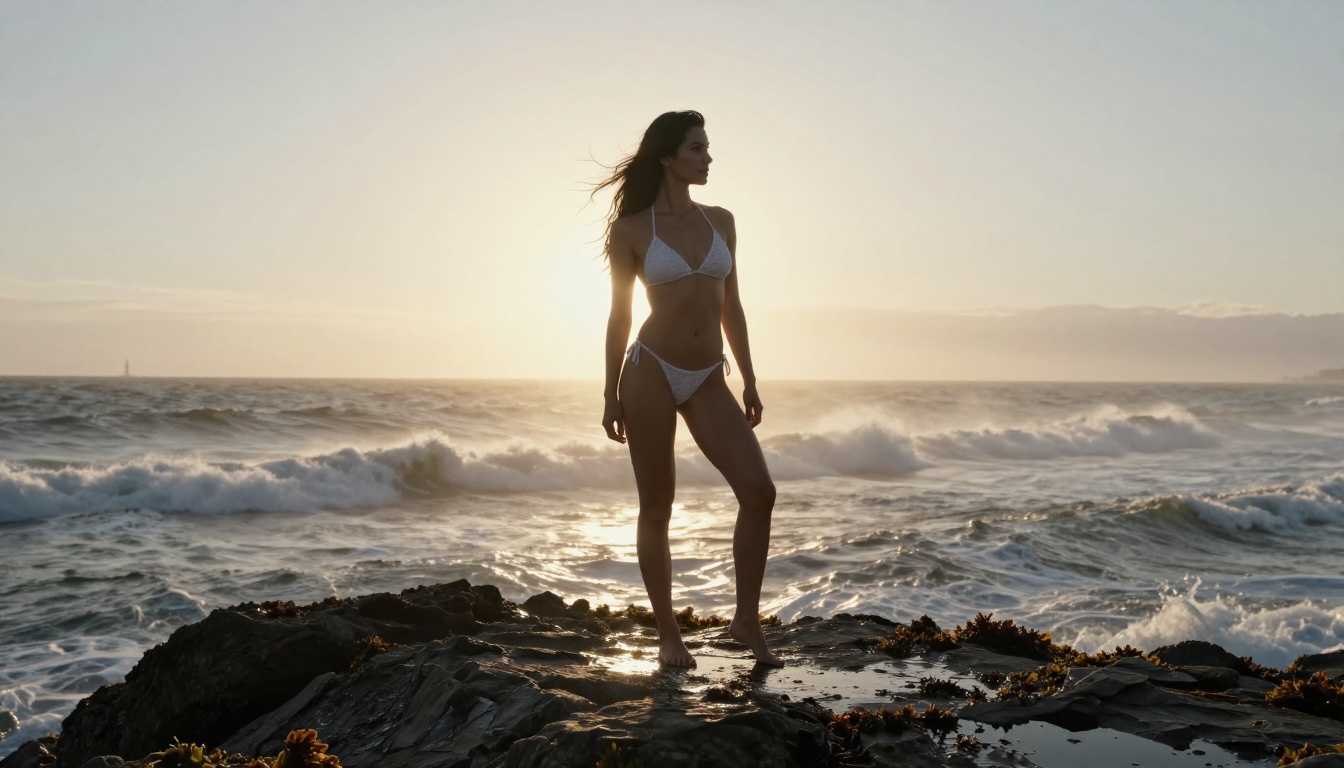
Retrato fotorrealista de una mujer segura de sí misma, con un bikini blanco minimalista, de pie a la orilla del agua durante la hora dorada, luz lateral cálida desde la izquierda que ilumina su cabello y sus hombros, tomado con un objetivo de 85 mm f/1.8 que crea un bokeh costero suave, arena húmeda bajo sus pies, olas rompiendo al fondo, grano de película Kodak Portra 400, fotografía RAW 8K
El segundo prompt da al modelo instrucciones explícitas en cada nivel de composición. La diferencia en la calidad del resultado no es sutil.
Modificadores de calidad que funcionan de forma fiable en los modelos de Stable Diffusion:
RAW 8K photography
Kodak Portra 400 film grain
cinematic lighting
photorealistic
skin pores visible
subsurface scattering
shot on Canon EOS R5
volumetric morning light
85mm f/1.4 portrait lens
SDXL Lightning 4Step responde especialmente bien al lenguaje técnico de cámara en los prompts. Si iteras rápido para encontrar la composición adecuada, la inferencia en 4 pasos de este modelo te da resultados en segundos y conserva calidad suficiente para probar prompts.
Los prompts negativos son gran parte del éxito
En Stable Diffusion, lo que le dices al modelo que evite es tan importante como lo que le pides que cree. Los prompts negativos evitan los fallos más comunes: extremidades de más, rostros deformados, piel borrosa, texturas de plástico.
Bloques básicos de prompts negativos
Los siguientes tokens de prompt negativo forman una base sólida para arte NSFW fotorrealista:
(worst quality, low quality:1.4), bad anatomy, bad hands, extra fingers,
missing fingers, deformed, disfigured, blurry, plastic skin, artificial,
CGI, 3D render, cartoon, illustration, painting, watermark, text,
oversaturated, flat lighting, studio white background
Los números entre paréntesis (worst quality:1.4) son pesos de atención. Un valor superior a 1,0 amplifica la influencia del token en el proceso de denoising. Los valores entre 1,2 y 1,5 funcionan bien para negativos de calidad sin restringir demasiado el espacio de generación.
💡 Si tus imágenes muestran siempre una piel demasiado lisa o cérea, añade plastic skin, (airbrushed:1.3), smooth skin a tu prompt negativo. Esto obliga al modelo a renderizar una estructura de poros realista y una textura de superficie natural.
Negativos específicos de anatomía para composiciones de cuerpo completo:
extra limbs, (extra arms:1.3), bad proportions, asymmetrical body,
too many fingers, fused fingers, floating limbs, disconnected limbs,
elongated neck, distorted torso
La combinación de negativos de calidad y de anatomía es imprescindible para cualquier toma NSFW de cuerpo completo. Sin ellos, incluso checkpoints potentes como Stable Diffusion 3.5 Large Turbo producirán de vez en cuando incoherencias anatómicas que habrá que corregir con inpainting.
Los parámetros que dan forma al resultado
Más allá del prompt, tres parámetros controlan más el resultado final que cualquier otra cosa: la escala CFG, el número de pasos y la elección del sampler. Configurarlos mal desperdicia tiempo de cómputo y produce imágenes que ningún refinamiento del prompt arreglará.
Escala CFG, pasos y samplers
CFG Scale (Classifier-Free Guidance) controla lo estrictamente que el modelo sigue tu prompt. Un valor de 1 significa que casi ignora el prompt. Un valor de 30 fuerza una interpretación hiperliteral que a menudo introduce artefactos y sobresaturación.
Valor de CFG
Efecto
3-5
Suelto, creativo, a menudo impredecible
6-8
Punto ideal para contenido fotorrealista
9-12
Mayor adherencia al prompt, aumenta el riesgo de artefactos
13+
Probable sobresaturación y deformación
Para fotorrealismo NSFW, 7 es el valor por defecto fiable. Súbelo hasta 9 cuando necesites fijar elementos de composición concretos, como detalles precisos de la ropa o un elemento de fondo que sigue desapareciendo de tus resultados.
Pasos de muestreo:
Más pasos no siempre dan mejores imágenes, pero con muy pocos pasos los resultados quedan borrosos e incompletos. Para flujos basados en SDXL:
20-25 pasos: calidad equilibrada para fotorrealismo
30-40 pasos: más detalle fino, rendimientos decrecientes a partir de 35
4-8 pasos: solo para las versiones Lightning y Turbo
Samplers:
DPM++ 2M Karras y Euler A son los dos más populares para fotorrealismo. DPM++ 2M Karras es estable y muy constante entre semillas distintas, lo que facilita iterar de forma sistemática. Euler A introduce más variación entre muestras, lo que resulta útil en la exploración inicial, cuando quieres ver varias interpretaciones del mismo prompt.
Resolución y relación de aspecto
SDXL y SD 3.5 Large se diseñaron ambos para salidas de 1024x1024 px. Generar en resoluciones que no son las nativas degrada la calidad, sobre todo en los rasgos faciales y las texturas finas.
Resoluciones recomendadas según el tipo de composición:
Tipo de escena
Resolución recomendada
Relación
Retrato / primer plano del rostro
1024x1024
1:1
Cuerpo completo de pie
832x1216
Retrato
Paisaje / exterior
1216x832
Paisaje
Editorial / doble página de moda
832x1248
2:3
💡 Después de generar en resolución nativa, pasa el resultado por un upscaler de superresolución para llegar a 4K. Así se conserva el detalle de calidad nativa y se duplica la densidad de píxeles, evitando los artefactos que aparecen al generar desde el principio en una resolución demasiado alta.
Modelos LoRA para controlar el estilo
Los modelos LoRA (Low-Rank Adaptation) son parches pequeños de ajuste fino que se colocan sobre tu checkpoint base y dirigen el resultado hacia una dirección estilística concreta. Son la herramienta de personalización más potente del ecosistema de Stable Diffusion y no requieren que entrenes nada por tu parte.
Qué hace LoRA en el arte NSFW
Un LoRA entrenado con fotografía de playa empujará todos los resultados hacia una iluminación costera más convincente, reflejos en el agua y tonos de piel naturales, propios de las sesiones al aire libre. Un LoRA entrenado con fotografía glamour desplaza el modelo hacia las proporciones de iluminación, las convenciones de postura corporal y el renderizado de telas típicos de ese género.
La comunidad ha creado LoRA para casi cualquier estilo fotográfico que puedas imaginar. La mayoría se cargan en segundos en cualquier interfaz de Stable Diffusion, incluida PicassoIA.
SDXL Multi ControlNet LoRA te da control estructurado sobre la pose y la composición mientras ejecuta adaptadores LoRA al mismo tiempo. Esta combinación es especialmente potente para composiciones NSFW de cuerpo completo, donde la precisión de la anatomía y de la pose es crítica y no puede dejarse al azar.
Apilar LoRA de la forma correcta
Puedes cargar varios LoRA a la vez ajustando el peso de cada uno. Un peso combinado superior a 1,8 entre todos los LoRA activos suele provocar artefactos y conflictos de estilo que degradan la imagen.
Enfoque recomendado para apilarlos:
1 LoRA de estilo con peso 0,7
1 LoRA de detalle o textura con peso 0,5
1 LoRA de pose o composición con peso 0,4
Peso combinado total: 1,6. Se mantiene dentro de un rango estable y, a la vez, aprovecha la influencia de tres modelos especializados.
💡 Prueba siempre cada LoRA primero de forma aislada con peso 1,0. Algunos LoRA son bastante más potentes de lo que indica su documentación. Construye tu conjunto a partir de una base probada en lugar de adivinar el comportamiento combinado desde el principio.
Cómo crear arte NSFW en PicassoIA
PicassoIA aloja la gama completa de modelos de Stable Diffusion, desde el Stable Diffusion clásico hasta la versión más reciente de SD 3.5 Large, sin instalación local. Este es un flujo de trabajo concreto, paso a paso, para obtener resultados de arte NSFW de alta calidad.
Paso a paso con SD 3.5 Large
Paso 1: elige tu modelo
Ve a Stable Diffusion 3.5 Large en PicassoIA. Para iterar el prompt con rapidez, empieza con SD 3.5 Large Turbo y cambia al modelo completo cuando tengas una composición que merezca la pena refinar.
Paso 2: escribe tu prompt positivo
Usa la estructura de cinco partes de antes. Esta es una plantilla de trabajo:
[Subject with clothing and pose], [setting and time of day],
[lighting direction and color temperature], [camera body and lens specs],
RAW 8K photography, Kodak Portra 400 film grain, photorealistic
Paso 3: pega tu prompt negativo
Usa el bloque de negativos de calidad y anatomía de la sección anterior. Añade negativos específicos de la escena según tu sujeto. Para tomas exteriores naturales, añade flat lighting, studio backdrop, indoor para que la atmósfera resulte convincente.
Paso 4: configura los parámetros
CFG Scale: 7
Pasos: 25
Sampler: DPM++ 2M Karras
Resolución: 1024x1024 para retratos, 1216x832 para composiciones de paisaje
Paso 5: genera e itera
Genera 3-4 muestras con semillas distintas para encontrar una composición que merezca más trabajo. Cuando tengas una base sólida, refina el prompt con detalles más precisos sobre la pose, el ángulo de la luz y la tela. La velocidad de iteración en PicassoIA te permite pasar por 20-30 variaciones en el tiempo que te llevaría preparar un entorno local.
Paso 6: añade control de pose cuando haga falta
Si la anatomía sale incoherente, cambia a SDXL Multi ControlNet LoRA y aporta una imagen de referencia de pose. Así el esqueleto queda fijado en la posición que quieres, mientras el prompt se ocupa de la iluminación, el entorno y el estilo.
Paso 7: escala el resultado final
Cuando estés satisfecho con la composición, pasa el resultado por las herramientas de superresolución de PicassoIA para llegar a 4K. Así se conserva todo el detalle fino de piel y tela logrado durante la generación y obtienes una salida lista para imprimir.
Trabajo de retrato con Realistic Vision v5.1
Para composiciones de retrato más cerradas, Realistic Vision v5.1 sigue siendo una de las opciones más fiables de la plataforma. Su conjunto de datos de ajuste fino se inclina hacia la fotografía de primer plano, así que los rostros, los ojos y el cabello salen con una definición excepcional.
Añadidos de prompt específicos para retrato que funcionan bien con Realistic Vision:
shot with Sony A7III, 85mm portrait lens
catchlight in eyes
rim light from right
shallow depth of field, creamy bokeh background
high-key studio lighting o low-key dramatic lighting
natural makeup, freckles visible
Para experimentar rápido con prompts antes de comprometerte con una generación de máxima calidad, SDXL Lightning 4Step permite lanzar 25-30 variaciones rápidas en el tiempo que un flujo SDXL estándar tarda en producir 3-4 salidas. Úsalo para fijar la composición y el lenguaje del prompt, y luego cambia a Stable Diffusion 3.5 Large para el render final de alta calidad.
Comparativa de modelos de PicassoIA para fotorrealismo NSFW:
Los modelos están disponibles, la plataforma está lista y la estructura de prompt de este artículo funciona de inmediato. Lo que separa el arte IA corriente de imágenes llamativas y fotorrealistas no es la suerte con las semillas aleatorias. Es una selección metódica de modelos, prompts estructurados, parámetros calibrados e iteración constante.
Empieza con Stable Diffusion 3.5 Medium si eres nuevo en el flujo de trabajo. Ofrece un buen equilibrio entre calidad y velocidad de inferencia, lo que hace que la iteración sea más rápida sin sacrificar la calidad de salida que necesitas para un arte NSFW convincente. Pasa a Stable Diffusion 3.5 Large cuando tu estructura de prompt esté afinada y quieras llevar la calidad de imagen a su máximo.
PicassoIA te da acceso a todos los modelos que aparecen en este artículo, funcionando en la nube, sin configuración de software, sin límites de VRAM y sin restricciones de contenido para desnudo artístico y fotografía glamour. Escribe hoy tu primer prompt estructurado, itera tres o cuatro veces y verás lo rápido que mejoran los resultados cuando dejas de usar descripciones vagas y empiezas a escribir prompts como un director de fotografía que instruye a un fotógrafo.