Comment créer de l’art IA NSFW avec Stable Diffusion
Un guide détaillé pour créer des images NSFW artistiques avec les modèles Stable Diffusion. Il couvre le choix du modèle, l’architecture du prompt, le CFG scale, les prompts négatifs, la personnalisation LoRA et un flux de travail pas à pas sur PicassoIA pour produire un art IA glamour, photoréaliste et saisissant, sans aucune configuration logicielle complexe.
Stable Diffusion a changé les règles pour quiconque souhaite créer de l’art généré par IA, en particulier les contenus que les plateformes grand public refusent de traiter. Contrairement aux générateurs en ligne enfermés derrière les filtres de contenu des entreprises, les modèles de diffusion open source vous donnent un contrôle total sur ce que vous générez, sur la manière dont vous rédigez votre prompt et sur la mesure dans laquelle vous poussez l’esthétique. Cet article explique précisément comment créer de belles images d’art IA NSFW non explicites avec Stable Diffusion, en couvrant le choix du modèle, la structure du prompt, le réglage des paramètres, la personnalisation LoRA et un flux de travail complet, étape par étape, sur PicassoIA, qui ne nécessite aucune installation locale.
Pourquoi Stable Diffusion domine l’art IA NSFW
La plupart des outils d’image IA commerciaux appliquent des filtres de sécurité agressifs qui bloquent tout ce qui est tant soit peu suggestif. Stable Diffusion fonctionne différemment, car ses poids sont publiquement disponibles et s’exécutent en local ou sur des plateformes qui permettent une plus grande liberté créative.
L’open source offre un réel contrôle créatif
Lorsque Stability AI a publié les poids de Stable Diffusion en 2022, cela a ouvert une ère où les créateurs individuels pouvaient faire du fine-tuning, fusionner et déployer des modèles sans attendre les cycles d’approbation des plateformes. La communauté qui s’est formée autour de ce projet a rapidement produit des modèles checkpoint spécialisés, orientés vers le photoréalisme et la photographie glamour, ce qui rend précisément possible l’art IA NSFW à grande échelle.
Vous ne travaillez pas avec une boîte noire. Vous voyez le processus d’échantillonnage, la manipulation de l’espace latent, chaque paramètre. Cette transparence explique pourquoi les artistes IA sérieux utilisent Stable Diffusion comme base, y compris en 2027. L’élan de la communauté est énorme : de nouveaux checkpoints, adaptateurs LoRA et embeddings apparaissent chaque semaine, et la plupart sont gratuits.
L’écosystème de modèles qui le rend possible
La vraie puissance de Stable Diffusion vient de l’écosystème communautaire construit autour de lui. Des milliers de modèles checkpoint fine-tunés existent spécifiquement pour produire des images photoréalistes et glamour. Vous n’avez pas besoin d’entraîner quoi que ce soit depuis zéro. Vous chargez un checkpoint, rédigez un prompt structuré et itérez.
L’écosystème se répartit en trois grandes familles de modèles, chacune avec des atouts distincts : SD 1.5 pour la rapidité et la compatibilité LoRA, SDXL pour le réalisme en haute résolution, et la famille SD 3.5, plus récente, pour une fidélité maximale au prompt. Choisir entre elles est la première vraie décision à prendre lorsque vous démarrez un projet d’art IA NSFW.
Choisir le bon modèle checkpoint
Le choix du modèle est le facteur le plus déterminant pour la qualité de votre rendu. Un checkpoint faible ou mal adapté échouera quelle que soit la qualité de votre prompt.
Pour les contenus NSFW apparentés, les checkpoints basés sur SDXL surpassent systématiquement SD 1.5 en photoréalisme. L’espace latent plus large à 1024 px fait que les visages, les cheveux, la texture de la peau et les tissus se rendent avec des détails nettement plus convaincants. Stable Diffusion 3.5 Large va plus loin avec un mécanisme d’attention entièrement réarchitecturé, qui gère les prompts complexes à plusieurs éléments avec une précision bien supérieure à toute version précédente de Stable Diffusion.
Realistic Vision et RealVisXL
Deux checkpoints communautaires figurent systématiquement en tête pour le contenu glamour photoréaliste :
Realistic Vision v5.1 : Basé sur SD 1.5, ce modèle a été fine-tuné sur des centaines de milliers d’images photographiques. Il produit des teints de peau, des cheveux et des textures de tissu qui peuvent passer pour de la vraie photographie à première vue. Efficace pour les compositions orientées portrait lorsque vous voulez un contrôle précis des traits du visage.
RealVisXL v3.0 Turbo : La version SDXL de Realistic Vision. Fonctionne nativement en 1024 px, gère mieux les compositions en pied que son prédécesseur et réagit très bien aux descriptions d’éclairage dans les prompts. Si vous photographiez des décors complexes, c’est celui-là qu’il faut privilégier en premier.
💡 Pour des prises de vue de plage, de piscine ou d’extérieur glamour, RealVisXL v3.0 Turbo produit un éclairage naturel plus convaincant que Realistic Vision v5.1. Utilisez Realistic Vision pour les portraits serrés où la fidélité du visage est la priorité.
Rédiger des prompts qui fonctionnent
De mauvais prompts donnent de mauvaises images, quel que soit le modèle. C’est là que la plupart des débutants perdent des heures. La structure de votre prompt détermine directement la composition, l’éclairage, l’ambiance et le réalisme.
L’anatomie d’un prompt efficace
Chaque prompt de haute qualité pour l’art NSFW repose sur la même structure de base :
Description du sujet — qui, quelle pose, quelle tenue
Environnement et décor — lieu, moment de la journée, ambiance
Spécification de l’éclairage — direction, qualité, température de couleur
Caméra et objectif — focale, ouverture, angle
Modificateurs de style et de qualité — grain de film, résolution, approche photographique
Combiner les cinq éléments donne au modèle des instructions explicites à chaque niveau. Vous rédigez un brief pour un photographe, et pas seulement la description d’une scène.
Sujet, style et modificateurs techniques
Voici un exemple concret de ce que produit une structure de prompt correcte :
Prompt faible :
beautiful woman, beach, sunset, suggestive
Prompt fort :
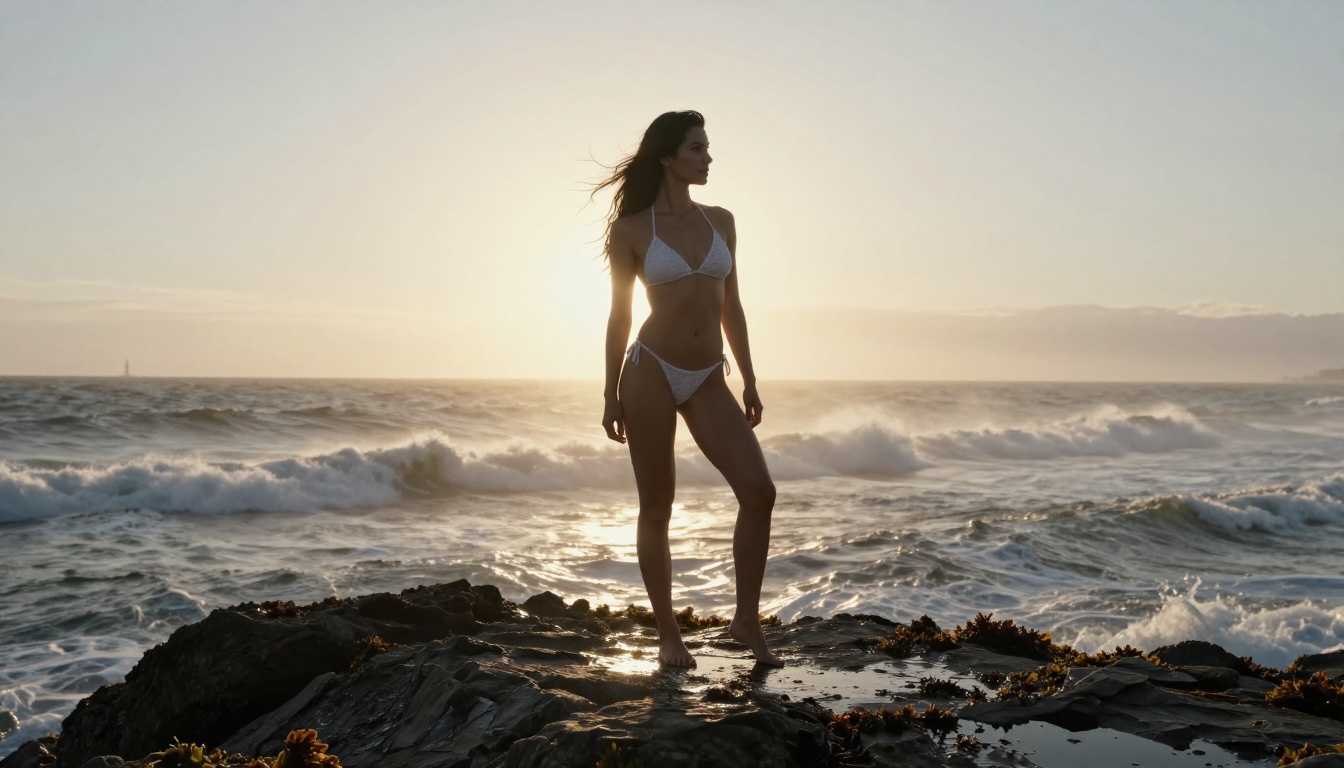
Portrait photoréaliste d’une femme sûre d’elle en bikini blanc minimaliste, debout au bord de l’eau pendant l’heure dorée, lumière latérale chaude venant de la gauche et accrochant ses cheveux et ses épaules, prise de vue avec un objectif 85 mm f/1.8 créant un bokeh côtier doux, sable mouillé sous ses pieds, vagues qui déferlent en arrière-plan, grain de film Kodak Portra 400, photographie RAW 8K
Le second prompt donne au modèle des instructions explicites à chaque niveau de composition. La différence de qualité du rendu n’est pas subtile.
Modificateurs de qualité qui fonctionnent de manière fiable sur les modèles SD :
RAW 8K photography
Kodak Portra 400 film grain
cinematic lighting
photorealistic
skin pores visible
subsurface scattering
shot on Canon EOS R5
volumetric morning light
85mm f/1.4 portrait lens
SDXL Lightning 4Step répond particulièrement bien au vocabulaire photographique technique dans les prompts. Si vous itérez rapidement pour trouver la bonne composition, l’inférence en 4 étapes de ce modèle donne des résultats en quelques secondes, avec une qualité suffisante pour tester vos prompts.
Les prompts négatifs représentent la moitié du travail
Avec Stable Diffusion, ce que vous demandez au modèle d’éviter est tout aussi important que ce que vous lui demandez de créer. Les prompts négatifs préviennent les échecs les plus courants : membres en trop, visages déformés, peau floue, textures en plastique.
Les briques de base d’un prompt négatif
Les tokens de prompt négatif suivants constituent une base solide pour l’art NSFW photoréaliste :
(worst quality, low quality:1.4), bad anatomy, bad hands, extra fingers,
missing fingers, deformed, disfigured, blurry, plastic skin, artificial,
CGI, 3D render, cartoon, illustration, painting, watermark, text,
oversaturated, flat lighting, studio white background
Les nombres entre parenthèses (worst quality:1.4) sont des poids d’attention. Une valeur supérieure à 1,0 amplifie l’influence du token sur le processus de débruitage. Des valeurs comprises entre 1,2 et 1,5 fonctionnent bien pour les négatifs liés à la qualité, sans trop contraindre l’espace de génération.
💡 Si vos images présentent systématiquement une peau trop lisse ou cireuse, ajoutez plastic skin, (airbrushed:1.3), smooth skin à votre prompt négatif. Cela oblige le modèle à rendre une structure de pores et une texture de surface réalistes.
Négatifs spécifiques à l’anatomie pour les compositions en pied :
extra limbs, (extra arms:1.3), bad proportions, asymmetrical body,
too many fingers, fused fingers, floating limbs, disconnected limbs,
elongated neck, distorted torso
L’association des négatifs de qualité et d’anatomie est indispensable pour tout plan en pied NSFW. Sans eux, même des checkpoints solides comme Stable Diffusion 3.5 Large Turbo produiront occasionnellement des incohérences anatomiques qui demandent un inpainting pour être corrigées.
Les paramètres qui façonnent votre rendu
Au-delà du prompt lui-même, trois paramètres contrôlent plus du résultat final que tout le reste : le CFG scale, le nombre d’étapes et le choix du sampler. Mal les régler fait perdre du temps de calcul et produit des images qu’aucun affinage du prompt ne pourra corriger.
CFG scale, étapes et samplers
CFG scale (Classifier-Free Guidance) contrôle la rigueur avec laquelle le modèle suit votre prompt. Une valeur de 1 signifie qu’il ignore largement le prompt. Une valeur de 30 impose une interprétation hyper-littérale qui introduit souvent des artefacts et une saturation excessive.
Valeur CFG
Effet
3 à 5
Souple, créatif, souvent imprévisible
6 à 8
Le juste milieu pour le contenu photoréaliste
9 à 12
Meilleure adhérence au prompt, risque d’artefacts accru
13+
Saturation excessive et déformations probables
Pour le photoréalisme NSFW, 7 est la valeur par défaut fiable. Montez à 9 lorsque vous avez besoin de verrouiller des éléments de composition précis, comme des détails de tenue ou un élément de décor qui disparaît sans cesse de vos rendus.
Étapes d’échantillonnage :
Plus d’étapes ne donnent pas toujours de meilleures images, mais trop peu rendent le résultat flou et incomplet. Pour les flux de travail basés sur SDXL :
20 à 25 étapes : qualité équilibrée pour le photoréalisme
30 à 40 étapes : détail fin plus poussé, rendements décroissants au-delà de 35
4 à 8 étapes : uniquement pour les versions Lightning et Turbo
Samplers :
DPM++ 2M Karras et Euler A sont les deux plus populaires pour le photoréalisme. DPM++ 2M Karras est stable et très constant d’une seed à l’autre, ce qui facilite une itération méthodique. Euler A introduit davantage de variations entre les échantillons, ce qui est utile lors de l’exploration initiale, lorsque vous voulez voir plusieurs interprétations d’un même prompt.
Résolution et format
SDXL et SD 3.5 Large ont tous deux été conçus pour une sortie en 1024x1024 px. Générer à des résolutions non natives dégrade la qualité, en particulier pour les traits du visage et les textures fines.
Résolutions recommandées selon le type de composition :
Type de scène
Résolution recommandée
Format
Portrait / gros plan du visage
1024x1024
1:1
Plein pied debout
832x1216
Portrait
Paysage / extérieur
1216x832
Paysage
Éditorial / shooting de mode
832x1248
2:3
💡 Après une génération en résolution native, passez le résultat par un upscaler de super-résolution pour atteindre le 4K. Cela préserve les détails de qualité native tout en doublant la densité de pixels, et évite les artefacts liés à une génération en trop haute résolution dès le départ.
Modèles LoRA pour contrôler le style
Les modèles LoRA (Low-Rank Adaptation) sont de petits patchs de fine-tuning qui se greffent sur votre checkpoint de base et orientent le rendu dans une direction stylistique précise. Ce sont l’outil de personnalisation le plus puissant de l’écosystème Stable Diffusion, et ils ne nécessitent aucun entraînement supplémentaire de votre part.
Ce que fait LoRA pour l’art NSFW
Un LoRA entraîné sur des photos de plage orientera tous les rendus vers un éclairage côtier plus convaincant, des reflets d’eau et des teints naturels associés aux prises de vue en extérieur. Un LoRA entraîné sur la photographie glamour fait évoluer le modèle vers les rapports d’éclairage, les conventions de posture corporelle et le rendu des tissus propres à ce genre.
La communauté a produit des LoRA pour presque tous les styles photographiques imaginables. La plupart se chargent en quelques secondes dans n’importe quelle interface Stable Diffusion, y compris sur PicassoIA.
SDXL Multi ControlNet LoRA vous offre un contrôle structuré de la pose et de la composition tout en faisant fonctionner simultanément des adaptateurs LoRA. Cette association est particulièrement puissante pour les compositions NSFW en pied, où la précision de l’anatomie et de la pose est critique et ne peut pas être laissée au hasard.
Empiler des LoRA correctement
Vous pouvez charger plusieurs LoRA à la fois en ajustant le poids de chacun. Un poids combiné supérieur à 1,8 pour l’ensemble des LoRA actifs provoque généralement des artefacts et des conflits de style qui dégradent l’image.
Méthode d’empilement recommandée :
1 LoRA de style à un poids de 0,7
1 LoRA de détail/texture à un poids de 0,5
1 LoRA de pose/composition à un poids de 0,4
Poids combiné total : 1,6. Cela reste dans une plage stable tout en faisant intervenir simultanément l’influence de trois modèles spécialisés.
💡 Testez toujours chaque LoRA isolément à un poids de 1,0 d’abord. Certains LoRA sont nettement plus puissants que ce que laisse entendre leur documentation. Construisez votre empilement à partir d’une base testée plutôt que de deviner le comportement combiné dès le départ.
Comment créer de l’art NSFW sur PicassoIA
PicassoIA héberge l’ensemble des modèles Stable Diffusion, de la version classique Stable Diffusion à la dernière version SD 3.5 Large, sans installation locale. Voici un flux de travail concret, étape par étape, pour produire des résultats d’art NSFW de haute qualité.
Étape par étape avec SD 3.5 Large
Étape 1 : choisissez votre modèle
Rendez-vous sur Stable Diffusion 3.5 Large sur PicassoIA. Pour gagner du temps pendant l’itération des prompts, commencez par SD 3.5 Large Turbo et passez au modèle complet dès que vous tenez une composition qui mérite d’être affinée.
Étape 2 : rédigez votre prompt positif
Utilisez la structure en cinq parties vue précédemment. Voici un modèle de travail :
[Subject with clothing and pose], [setting and time of day],
[lighting direction and color temperature], [camera body and lens specs],
RAW 8K photography, Kodak Portra 400 film grain, photorealistic
Étape 3 : collez votre prompt négatif
Utilisez le bloc de négatifs de qualité et d’anatomie de la section précédente. Ajoutez des négatifs propres à la scène selon votre sujet. Pour les prises de vue naturelles en extérieur, ajoutez flat lighting, studio backdrop, indoor afin de préserver la crédibilité de l’atmosphère.
Étape 4 : réglez vos paramètres
CFG scale : 7
Étapes : 25
Sampler : DPM++ 2M Karras
Résolution : 1024x1024 pour les portraits, 1216x832 pour les compositions paysage
Étape 5 : générez et itérez
Lancez 3 à 4 échantillons avec des seeds différentes pour trouver une composition qui mérite d’être poussée plus loin. Une fois une base solide obtenue, affinez le prompt avec des détails plus précis sur la pose, l’angle d’éclairage et le tissu. La vitesse d’itération sur PicassoIA vous permet d’enchaîner 20 à 30 variations dans le temps qu’il faudrait pour configurer un environnement local.
Étape 6 : ajoutez un contrôle de pose si nécessaire
Si l’anatomie reste incohérente, passez à SDXL Multi ControlNet LoRA et fournissez une image de pose de référence. Cela verrouille le squelette dans la position souhaitée, tandis que le prompt gère l’éclairage, le décor et le style.
Étape 7 : upscalez le résultat final
Une fois la composition satisfaisante, passez le résultat par les outils de super-résolution de PicassoIA pour atteindre le 4K. Cela préserve tous les détails fins de peau et de tissu obtenus pendant la génération, tout en produisant une sortie de qualité impression.
Travail de portrait avec Realistic Vision v5.1
Pour des compositions de portrait plus serrées, Realistic Vision v5.1 reste l’une des options les plus fiables de la plateforme. Son jeu de données de fine-tuning penche vers la photographie en gros plan : les visages, les yeux et les cheveux ressortent avec une définition exceptionnelle.
Ajouts de prompt spécifiques aux portraits qui fonctionnent bien avec Realistic Vision :
shot with Sony A7III, 85mm portrait lens
catchlight in eyes
rim light from right
shallow depth of field, creamy bokeh background
high-key studio lighting ou low-key dramatic lighting
natural makeup, freckles visible
Pour expérimenter rapidement les prompts avant de lancer un rendu de pleine qualité, SDXL Lightning 4Step permet de tester 25 à 30 variantes rapides dans le temps qu’un flux SDXL standard met à produire 3 ou 4 résultats. Servez-vous-en pour figer la composition et le vocabulaire du prompt, puis passez à Stable Diffusion 3.5 Large pour le rendu final de haute qualité.
Comparatif des modèles PicassoIA pour le photoréalisme NSFW :
Les modèles sont disponibles, la plateforme est prête, et la structure de prompt présentée dans cet article fonctionne immédiatement. Ce qui distingue un art IA ordinaire d’une image photoréaliste saisissante, ce n’est pas la chance avec des seeds aléatoires. C’est une sélection méthodique des modèles, des prompts structurés, des paramètres calibrés et une itération constante.
Commencez par Stable Diffusion 3.5 Medium si vous débutez dans ce flux de travail. Il offre un bon équilibre entre qualité et vitesse d’inférence, ce qui rend l’itération plus rapide sans sacrifier la qualité de sortie dont vous avez besoin pour un art NSFW convaincant. Passez à Stable Diffusion 3.5 Large une fois votre structure de prompt au point et que vous êtes prêt à pousser la qualité d’image à son maximum.
PicassoIA vous donne accès à tous les modèles présentés dans cet article, fonctionnant dans le cloud sans installation logicielle, sans limite de VRAM et sans restriction de contenu sur la nudité artistique et la photographie glamour. Rédigez votre premier prompt structuré aujourd’hui, itérez-le trois ou quatre fois, et constatez à quelle vitesse les résultats s’améliorent dès que vous cessez d’utiliser des descriptions vagues pour rédiger des prompts comme un chef opérateur qui briefe un photographe.