Imagina escribir una frase y verla convertirse en un video en movimiento. Esto ya no es ciencia ficción—es la realidad de la tecnología de IA de texto a video. La capacidad de generar contenido de video a partir de descripciones escritas representa uno de los avances creativos más importantes de los últimos años, y está cambiando la forma en que los especialistas en marketing, los educadores, los cineastas y los creadores de contenido abordan la narrativa visual.
Los estudios de producción de video integran cada vez más herramientas de IA en sus flujos de trabajo
El proceso empieza con un prompt de texto sencillo, pero detrás hay modelos sofisticados de aprendizaje automático que entienden el lenguaje, los conceptos visuales, las relaciones temporales y los principios cinematográficos. Lo que empezó como una simple generación de animaciones ha evolucionado hasta sistemas capaces de producir metraje fotorrealista con movimientos de cámara complejos, animaciones de personajes y efectos de entorno.
Por qué el texto a video con IA importa ahora
Los plazos de creación de contenido se han reducido mucho. Donde la producción tradicional de video requería semanas de planificación, rodaje y edición, la generación de video con IA entrega resultados en minutos. Las implicaciones abarcan varios sectores:
💡 Para especialistas en marketing: Genera videos de demostración de productos a partir de descripciones, crea contenido para redes sociales bajo demanda y personaliza los mensajes en video a gran escala.
💡 Para educadores: Convierte planes de lección en contenido visual atractivo, crea materiales formativos a partir de documentación técnica y desarrolla módulos de aprendizaje interactivos.
💡 Para cineastas: Prototipa rápidamente conceptos de escena, genera elementos de efectos visuales y crea animaciones de storyboard sin grandes recursos de producción.
La accesibilidad es un factor que no se puede exagerar. Las pequeñas empresas, los creadores independientes y las instituciones educativas ahora tienen acceso a capacidades de producción de video que antes eran exclusivas de organizaciones con grandes presupuestos. Esta democratización de las herramientas de narrativa visual supone un cambio fundamental en la economía creativa.
Cómo funcionan en realidad los generadores de video con IA
La arquitectura detrás de los modelos de texto a video
Los sistemas modernos de texto a video suelen emplear arquitecturas basadas en difusión, que parten del éxito de los modelos de texto a imagen pero añaden comprensión temporal. La innovación central consiste en entrenar los modelos para predecir no solo lo que viene después en el espacio (como en la generación de imágenes), sino lo que viene después en el tiempo.
La mayoría de los sistemas siguen este flujo general:
- Codificación del texto: Tu prompt pasa por un modelo de lenguaje que extrae el significado semántico, identifica las entidades clave y entiende los modificadores descriptivos.
- Mapeo de conceptos visuales: El sistema relaciona los conceptos textuales con las representaciones visuales que aprendió durante el entrenamiento.
- Secuenciación temporal: El modelo predice cómo deben cambiar los elementos visuales con el tiempo, según los verbos de acción y las pistas temporales de tu prompt.
- Generación de fotogramas: Se sintetizan los fotogramas individuales, manteniendo la coherencia a lo largo de la secuencia temporal.
- Posprocesado: Los pasos adicionales pueden incluir suavizado de movimiento, mejora de la resolución y refinamiento estilístico.
La ingeniería de prompts detallada requiere entender cómo interpretan los modelos de IA el lenguaje descriptivo
Componentes técnicos clave que lo hacen posible
Varias tecnologías fundamentales convergen para hacer posible la generación de video a partir de texto:
Modelos de visión-lenguaje (VLM): Estos modelos aprenden asociaciones entre descripciones de texto y conceptos visuales durante el entrenamiento con enormes conjuntos de datos de imágenes y videos con subtítulos.
Modelos de difusión: Partiendo de ruido aleatorio, estos modelos van "eliminando el ruido" de forma gradual hacia una distribución objetivo, y aprenden a generar imágenes coherentes condicionadas por los prompts de texto.
Mecanismos de atención temporal: Componentes especializados de redes neuronales que mantienen la coherencia entre los fotogramas del video al atender tanto a las relaciones espaciales como a las temporales.
Priors de movimiento: Representaciones estadísticas de cómo se mueven habitualmente los objetos en el mundo real, aprendidas a partir del análisis de millones de clips de video.
Redes de transferencia de estilo: Componentes opcionales que aplican estilos artísticos o looks cinematográficos coherentes a las secuencias generadas.
Cómo elegir el modelo de video con IA adecuado para tus necesidades
Comparativa de las mejores plataformas de texto a video
Cada plataforma destaca en áreas concretas. Aquí tienes un análisis comparativo de las opciones principales disponibles a través de plataformas como PicassoIA:
| Modelo | Ideal para | Resolución | Duración | Funciones clave |
|---|
| WAN-2.6-T2V | Marketing y contenido para redes sociales | 720p a 1080p | 5-15 segundos | Sincronización de audio, segmentación multitoma |
| kling-v2.6 | Calidad cinematográfica | 1080p+ | Variable | Control de movimiento, mucho detalle |
| seedance-1.5-pro | Animación de personajes | 720p-1080p | 5-30 segundos | Coherencia de personajes |
| sora-2-pro | Escenas complejas | 1080p+ | Hasta 60 segundos | Coherencia de escena, física |
| veo-3.1 | Metraje realista | 720p-4K | 5-30 segundos | Fotorrealismo, movimiento natural |
| hailuo-2.3 | Iteración rápida | 480p-720p | 3-10 segundos | Generación rápida, bajo costo |
La evolución de un concepto de texto a un resultado visual implica varios pasos de traducción
Consideraciones de resolución, duración y formato
Las opciones de resolución afectan tanto a la calidad como al costo:
- 480p-720p: Adecuada para redes sociales, prototipos rápidos y contenido educativo
- 1080p: Materiales de marketing profesionales, videos de presentación y demostraciones de producto
- 4K: Producción de alto nivel, proyectos cinematográficos y calidad de emisión
La duración varía según el modelo:
- La mayoría de los modelos manejan bien clips de 5 a 15 segundos
- Algunos sistemas avanzados admiten generaciones de 30 a 60 segundos
- Para contenido más largo, considera generar varios clips y editarlos juntos
Opciones de relación de aspecto:
- 16:9: Formato panorámico estándar para la mayoría de aplicaciones
- 9:16: Formato vertical para plataformas móviles como TikTok e Instagram Reels
- 1:1: Formato cuadrado para algunas redes sociales
- Personalizada: Algunos modelos admiten requisitos de dimensiones específicos
Cómo escribir prompts de video eficaces que den resultados
La anatomía de un prompt de video exitoso
Los prompts de video eficaces siguen un enfoque estructurado que da al modelo de IA una dirección clara:
Sujeto + Acción + Entorno + Elementos cinematográficos + Especificaciones técnicas
Veamos esto con ejemplos:
Prompt básico (poco detalle):
"Un gato jugando en un jardín"
Prompt mejorado (enfoque estructurado):
"Un gato atigrado de pelaje rojizo persiguiendo juguetonamente una mariposa por un jardín de una casa de campo inglesa bañado por el sol, con luz moteada filtrándose entre los robles, grabado con poca profundidad de campo usando un objetivo de 50mm, captura en cámara lenta de los movimientos elegantes del gato, iluminación de hora dorada de primera hora de la mañana que crea reflejos cálidos en el pelaje"
La ingeniería colaborativa de prompts suele dar mejores resultados que los esfuerzos individuales
Explicación de los componentes clave del prompt:
- Especificidad del sujeto: "gato atigrado de pelaje rojizo" frente a "un gato"
- Claridad de la acción: "persiguiendo juguetonamente una mariposa" frente a "jugando"
- Detalle del entorno: "jardín de una casa de campo inglesa bañado por el sol" frente a "jardín"
- Lenguaje cinematográfico: "luz moteada filtrándose entre los robles"
- Detalles técnicos de cámara: "grabado con poca profundidad de campo usando un objetivo de 50mm"
- Especificación del movimiento: "captura en cámara lenta"
- Condiciones de iluminación: "iluminación de hora dorada de primera hora de la mañana"
- Efectos visuales: "reflejos cálidos en el pelaje"
Errores comunes en los prompts y cómo evitarlos
Vaguedad: La IA necesita detalles concretos. En lugar de "un paisaje hermoso", especifica "picos de montaña cubiertos de nieve al amanecer, con niebla que sube desde bosques de pinos".
Elementos contradictorios: Evita mezclar conceptos incompatibles, como "sol de mediodía brillante con estrellas visibles".
Secuencias demasiado complejas: Aunque algunos modelos manejan varias acciones, empezar con acciones únicas y claras da mejores resultados.
Falta de pistas temporales: Especifica la hora del día, la estación y la velocidad del movimiento cuando sean relevantes para tu escena.
Ignorar la perspectiva de cámara: Indica si quieres un primer plano, un plano general, una perspectiva con dron o un movimiento de cámara concreto.
Cómo usar WAN-2.6-T2V en PicassoIA
Tutorial paso a paso para principiantes
WAN-2.6-T2V destaca como un excelente punto de partida para la generación de texto a video gracias a su equilibrio entre calidad, funciones y accesibilidad. Así se empieza:
-
Accede al modelo: Ve a la página de WAN-2.6-T2V en PicassoIA
-
Prepara tu prompt: Redacta una descripción detallada siguiendo el enfoque estructurado que vimos antes.
-
Configura los parámetros básicos:
- Tamaño: Elige entre 1280×720 (horizontal 16:9), 720×1280 (vertical 9:16), 1920×1080 (HD horizontal) o 1080×1920 (HD vertical)
- Duración: Selecciona 5, 10 o 15 segundos según las necesidades de tu contenido
- Audio: Opcionalmente, sube un archivo de audio de 3 a 30 segundos para la sincronización
-
Activa las funciones avanzadas:
- Expansión del prompt: Déjala activada (por defecto) para obtener mejores resultados
- Segmentación multitoma: Actívala para lograr cambios de escena de estilo cinematográfico dentro de tu video
- Prompt negativo: Especifica los elementos que quieres evitar (por ejemplo, "borroso, rostros distorsionados, texto superpuesto")
-
Define la semilla (opcional): Usa un valor de semilla específico para obtener resultados reproducibles al iterar variaciones
-
Genera y revisa: El proceso suele tardar entre 1-5 minutos, según la duración y la resolución
La revisión profesional y el control de calidad garantizan que el contenido generado por IA cumpla los estándares de producción
Técnicas avanzadas de optimización de parámetros
Estrategia de segmentación multitoma: Cuando está activada, WAN-2.6-T2V divide de forma inteligente tu prompt en segmentos de escena lógicos. Para obtener mejores resultados:
- Estructura tu prompt con transiciones de escena claras implícitas
- Ejemplo: "Plano de apertura de un horizonte urbano al amanecer, luego corte al interior de una cafetería concurrida, plano final de una persona caminando por un parque"
Sincronización del audio: Al añadir audio:
- Ajusta la duración de tu clip de audio a la duración de video que hayas elegido
- Ten en cuenta el tono emocional de tu audio al redactar los prompts visuales
- La música llena de acción combina bien con movimientos de cámara dinámicos
- Las pistas instrumentales más suaves encajan con escenas tranquilas y de ritmo lento
Guía para elegir la resolución:
- 1280×720: La opción más económica para pruebas y redes sociales
- 1920×1080: Recomendada para casos de uso profesionales
- Formatos verticales: Imprescindibles para estrategias de contenido pensadas primero para dispositivos móviles
Optimización de la duración:
- 5 segundos: Perfecto para fragmentos para redes sociales y destacados de productos
- 10 segundos: Ideal para contenido explicativo y demostraciones breves
- 15 segundos: Adecuado para minirrelatos y para presentar escenas
Cómo integrar los videos con IA en tu flujo de producción
Estrategias de posproducción y mejora
Los videos generados con IA suelen beneficiarse de técnicas tradicionales de posproducción:
Corrección de color: Aplica perfiles de color coherentes en varios clips generados con IA para mantener la coherencia visual.
Mejora del audio: Añade efectos de sonido, voces en off o pistas musicales para mejorar el producto final.
Edición y secuenciación: Combina varios clips generados con IA con metraje tradicional para producciones híbridas.
Superposición de texto y gráficos: Añade títulos, subtítulos, logotipos o gráficos informativos para contextualizar el contenido.
Ajuste de velocidad: Modifica la velocidad de reproducción para lograr un efecto dramático o para ajustarte a requisitos de tiempo concretos.
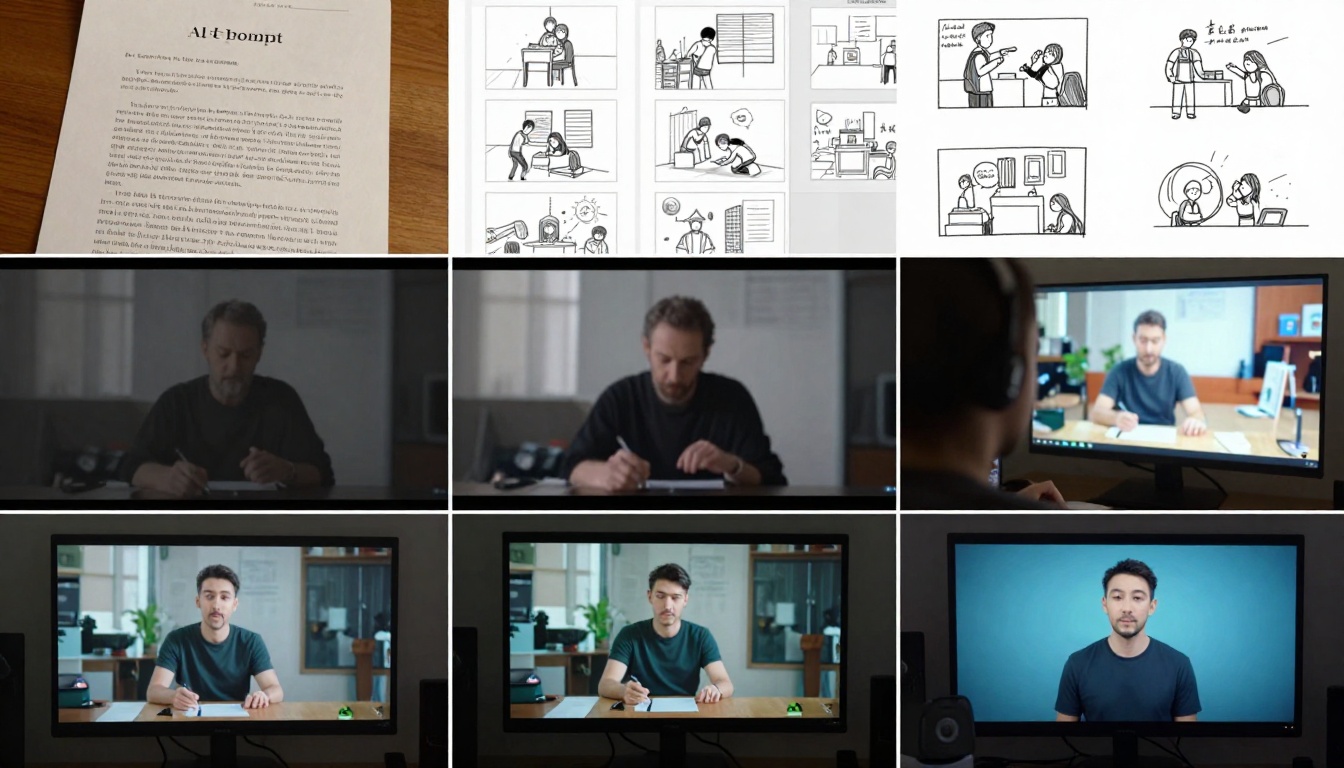
El flujo de trabajo completo, desde el concepto de texto hasta la entrega final, implica varias etapas de refinamiento
Medidas de control de calidad y coherencia
Generación por lotes con control de semilla: Genera varias variaciones con la misma semilla y pequeños ajustes en el prompt para mantener la coherencia visual a lo largo de una serie.
Guías de estilo para la coherencia de marca: Desarrolla plantillas de prompt que incorporen el lenguaje visual, la paleta de colores y las preferencias de composición de tu marca.
Listas de validación: Crea criterios de control de calidad que cubran:
- Coherencia visual entre fotogramas
- Física del movimiento adecuada
- Coherencia del color
- Nitidez de la resolución
- Sincronización audiovisual (si aplica)
Proceso de refinamiento iterativo: Trata las primeras generaciones como borradores y usa los resultados para afinar los prompts siguientes y obtener mejores resultados.
Aplicaciones y casos de uso reales
Ejemplos de marketing y publicidad
Videos de demostración de productos: Convierte especificaciones técnicas en escaparates visuales atractivos. Una empresa de muebles podría generar videos que muestren sus productos en distintos ambientes de la casa a partir de las descripciones del catálogo.
Creación de contenido para redes sociales: Produce contenido adaptado a cada plataforma a gran escala. Una marca de moda podría generar cada semana videos de estilo a partir de descripciones de producto para Instagram Reels y TikTok.
Mensajes de video personalizados: Crea contenido de video a medida para campañas de correo electrónico o comunicaciones con clientes, basado en preferencias individuales o en el historial de compras.
Videos explicativos: Convierte descripciones de servicios complejos en explicaciones visuales sencillas para páginas de destino o presentaciones de ventas.
Creación de contenido educativo y formativo
Visualización de lecciones: Los docentes pueden transformar el texto del currículo en contenido visual atractivo que ilustre hechos históricos, conceptos científicos o principios matemáticos.
Desarrollo de módulos de formación: Los formadores corporativos pueden crear demostraciones visuales de procedimientos, protocolos de seguridad o flujos de trabajo de software a partir de documentación escrita.
Materiales para aprender idiomas: Genera escenas visuales contextuales que ilustren vocabulario, contextos culturales o situaciones de conversación.
Mejora de la accesibilidad: Crea contenido visual que complemente los materiales basados en texto para distintos estilos de aprendizaje y necesidades de accesibilidad.
La integración de herramientas de IA con el equipo de cine tradicional representa el futuro de la producción de contenido
Limitaciones y desafíos actuales
Restricciones técnicas a tener en cuenta
Coherencia temporal: Aunque están mejorando, algunos modelos todavía tienen dificultades para mantener la coherencia perfecta de los objetos en secuencias largas o con movimientos de cámara complejos.
Precisión física: La física del movimiento natural, sobre todo en interacciones complejas entre varios objetos, sigue siendo un desafío para los sistemas actuales.
Limitaciones de resolución: La mayoría de los modelos tienen restricciones máximas de resolución, aunque esto evoluciona rápidamente con cada nueva generación.
Tiempo de generación: Según la complejidad del modelo y la calidad deseada, la generación puede tardar desde segundos hasta minutos, lo que afecta a los flujos de trabajo de iteración rápida.
Factores de costo: Las generaciones de mayor calidad suelen requerir más recursos computacionales, lo que se traduce en costos más altos por video.
Límites creativos y consideraciones éticas
Originalidad frente a derivación: Sigue abierta la pregunta sobre el origen de los datos de entrenamiento y sobre hasta qué punto el contenido generado es una creación realmente original y no una recombinación de patrones aprendidos.
Consideraciones sobre propiedad intelectual: El panorama legal sobre la titularidad y los derechos de autor del contenido generado por IA sigue evolucionando en las distintas jurisdicciones.
Representación y sesgos: Como todos los sistemas de IA entrenados con datos existentes, los modelos de texto a video pueden reflejar y, potencialmente, amplificar los sesgos presentes en sus conjuntos de datos de entrenamiento.
Requisitos de transparencia: Según el caso de uso y la jurisdicción, puede ser obligatorio o recomendable informar de que el contenido ha sido generado por IA.
Autenticidad creativa: Continúan los debates sobre el papel de la IA en los procesos creativos y sobre qué constituye una expresión artística auténtica.
La diversidad de resultados demuestra la versatilidad de la tecnología moderna de texto a video
El panorama del texto a video con IA sigue evolucionando a un ritmo notable. Lo que empezó como tecnología experimental se ha convertido en herramientas prácticas que los profesionales creativos integran en su día a día. La combinación de plataformas accesibles como PicassoIA con modelos cada vez más sofisticados como WAN-2.6-T2V hace que esta tecnología esté al alcance de creadores de todos los niveles.
Los enfoques más exitosos combinan las capacidades de la IA con la creatividad humana: usan el contenido generado como punto de partida para refinarlo, combinan varios clips en narrativas coherentes y aplican técnicas de producción tradicionales para mejorar los resultados de la IA. Este enfoque híbrido aprovecha la velocidad y la escalabilidad de la IA sin renunciar a la dirección artística ni a los estándares de calidad de la producción profesional.
A medida que la tecnología avance, cabe esperar mejoras en la coherencia temporal, en la simulación física y en el control creativo. La generación actual ya ofrece resultados impresionantes en muchas aplicaciones, y la tendencia apunta a sistemas aún más capaces en un futuro cercano.
Para quienes quieran explorar esta tecnología, el camino pasa por experimentar, iterar e integrar. Empieza con proyectos claros y bien definidos, aprende con la práctica y amplía poco a poco tus casos de uso a medida que domines la ingeniería de prompts y las capacidades de los modelos. Las herramientas ya existen; las posibilidades creativas solo esperan a que las explores.


