Imaginez taper une phrase et la voir se transformer en vidéo animée. Ce n’est plus de la science-fiction : c’est la réalité de la technologie de génération de vidéos IA à partir de texte. La capacité à générer des contenus vidéo à partir de descriptions écrites représente l’une des avancées créatives les plus importantes de ces dernières années, et elle change la façon dont les spécialistes du marketing, les enseignants, les cinéastes et les créateurs de contenus abordent la narration visuelle.
Les studios de production vidéo professionnels intègrent de plus en plus d’outils IA à leurs flux de travail
Le processus part d’un simple prompt texte, mais il fait appel à des modèles d’apprentissage automatique sophistiqués qui comprennent le langage, les concepts visuels, les relations temporelles et les principes cinématographiques. Ce qui n’était à l’origine qu’une simple génération d’animations est devenu des systèmes capables de produire des séquences photoréalistes, avec des mouvements de caméra complexes, des animations de personnages et des effets environnementaux.
Pourquoi la génération de vidéos par IA compte maintenant
Les délais de création de contenus se sont considérablement réduits. Là où la production vidéo traditionnelle exigeait des semaines de planification, de tournage et de montage, la génération de vidéos par IA livre des résultats en quelques minutes. Les implications touchent plusieurs secteurs :
💡 Pour les spécialistes du marketing : générez des vidéos de démonstration produit à partir de descriptions, créez des contenus pour les réseaux sociaux à la demande et personnalisez vos messages vidéo à grande échelle.
💡 Pour les enseignants : transformez vos plans de cours en contenus visuels engageants, créez des supports de formation à partir de documentations techniques et développez des modules d’apprentissage interactifs.
💡 Pour les cinéastes : prototypez rapidement des concepts de scène, générez des éléments d’effets visuels et créez des animations de storyboard sans recourir à des moyens de production importants.
L’accessibilité ne peut pas être sous-estimée. Les petites entreprises, les créateurs indépendants et les établissements d’enseignement disposent désormais de capacités de production vidéo qui étaient auparavant réservées aux organisations bien financées. Cette démocratisation des outils de narration visuelle représente un changement fondamental dans l’économie de la création.
L’architecture des modèles texte vers vidéo
Les systèmes texte vers vidéo modernes utilisent généralement des architectures à diffusion, qui s’appuient sur le succès des modèles texte vers image tout en ajoutant une compréhension du temps. L’innovation centrale consiste à entraîner les modèles à prédire non seulement ce qui vient ensuite dans l’espace (comme dans la génération d’images), mais aussi ce qui vient ensuite dans le temps.
La plupart des systèmes suivent ce flux de travail général :
- Encodage du texte : votre prompt est traité par un modèle de langage qui extrait le sens, identifie les entités clés et comprend les qualificatifs descriptifs.
- Mise en correspondance des concepts visuels : le système associe les concepts textuels aux représentations visuelles qu’il a apprises pendant l’entraînement.
- Séquençage temporel : le modèle prédit la façon dont les éléments visuels doivent évoluer dans le temps, à partir des verbes d’action et des indices temporels de votre prompt.
- Génération des images : les images individuelles sont synthétisées, avec une cohérence maintenue sur toute la séquence temporelle.
- Post-traitement : des étapes supplémentaires peuvent inclure le lissage des mouvements, l’amélioration de la résolution et l’affinage stylistique.
La rédaction détaillée de prompts exige de comprendre la façon dont les modèles d’IA interprètent le langage descriptif
Les composants techniques clés qui rendent cela possible
Plusieurs technologies essentielles convergent pour permettre la génération de vidéos à partir de texte :
Modèles vision-langage (VLM) : ces modèles apprennent les associations entre descriptions textuelles et concepts visuels pendant l’entraînement sur d’immenses jeux de données d’images et de vidéos accompagnées de légendes.
Modèles de diffusion : partant d’un bruit aléatoire, ces modèles « débruitent » progressivement vers une distribution cible, et apprennent à générer des visuels cohérents conditionnés par les prompts textuels.
Mécanismes d’attention temporelle : composants spécialisés des réseaux de neurones qui maintiennent la cohérence entre les images d’une vidéo en tenant compte à la fois des relations spatiales et temporelles.
Priors de mouvement : représentations statistiques de la façon dont les objets se déplacent habituellement dans le monde réel, apprises à partir de l’analyse de millions de clips vidéo.
Réseaux de transfert de style : composants facultatifs qui appliquent des styles artistiques ou des rendus cinématographiques cohérents aux séquences générées.
Choisir le bon modèle de génération de vidéos IA selon vos besoins
Comparer les meilleures plateformes texte vers vidéo
Différentes plateformes excellent dans des domaines précis. Voici une analyse comparative des principales options disponibles via des plateformes comme PicassoIA :
| Modèle | Idéal pour | Résolution | Durée | Fonctions clés |
|---|
| WAN-2.6-T2V | Marketing et contenus sociaux | 720p à 1080p | 5-15 secondes | Synchronisation audio, segmentation multi-plans |
| kling-v2.6 | Qualité cinématographique | 1080p+ | Variable | Contrôle des mouvements, niveau de détail élevé |
| seedance-1.5-pro | Animation de personnages | 720p-1080p | 5-30 secondes | Cohérence des personnages |
| sora-2-pro | Scènes complexes | 1080p+ | Jusqu’à 60 s | Cohérence de scène, physique |
| veo-3.1 | Séquences réalistes | 720p-4K | 5-30 secondes | Photoréalisme, mouvements naturels |
| hailuo-2.3 | Itérations rapides | 480p-720p | 3-10 secondes | Génération rapide, coût réduit |
L’évolution d’un concept textuel vers un résultat visuel implique plusieurs étapes de transposition
Résolution, durée et considérations de format
Les choix de résolution influencent à la fois la qualité et le coût :
- 480p-720p : adapté aux réseaux sociaux, aux prototypes rapides et aux contenus éducatifs
- 1080p : supports marketing professionnels, vidéos de présentation, démos produit
- 4K : production haut de gamme, projets cinématographiques, qualité de diffusion
Les limites de durée varient selon le modèle :
- La plupart des modèles gèrent efficacement des clips de 5 à 15 secondes
- Certains systèmes avancés prennent en charge une génération de 30 à 60 secondes
- Pour des contenus plus longs, envisagez de générer plusieurs clips puis de les monter ensemble
Options de format :
- 16:9 : format panoramique standard pour la plupart des usages
- 9:16 : format vertical pour les plateformes mobiles comme TikTok et Instagram Reels
- 1:1 : format carré pour certaines plateformes sociales
- Personnalisé : certains modèles prennent en charge des exigences de dimensions spécifiques
Rédiger des prompts vidéo efficaces qui donnent des résultats
L’anatomie d’un prompt vidéo réussi
Les prompts vidéo efficaces suivent une démarche structurée qui donne au modèle d’IA une direction claire :
Sujet + action + environnement + éléments cinématographiques + spécifications techniques
Décomposons cela avec des exemples :
Prompt de base (détail minimal) :
« Un chat qui joue dans un jardin »
Prompt amélioré (démarche structurée) :
« Un chat roux tigré qui pourchasse avec espièglerie un papillon à travers un jardin de chaumière anglaise baigné de soleil, avec une lumière tachetée filtrant à travers les chênes, filmé avec une faible profondeur de champ grâce à un objectif 50 mm, capture au ralenti des mouvements gracieux du chat, éclairage doré de début de matinée créant des reflets chauds sur le pelage »
La rédaction collaborative de prompts donne souvent de meilleurs résultats que les efforts individuels
Explication des composants clés du prompt :
- Précision du sujet : « chat roux tigré » plutôt que « un chat »
- Clarté de l’action : « pourchasse avec espièglerie un papillon » plutôt que « joue »
- Détail de l’environnement : « jardin de chaumière anglaise baigné de soleil » plutôt que « jardin »
- Langage cinématographique : « lumière tachetée filtrant à travers les chênes »
- Détails techniques de la caméra : « filmé avec une faible profondeur de champ grâce à un objectif 50 mm »
- Spécification du mouvement : « capture au ralenti »
- Conditions d’éclairage : « éclairage de l’heure dorée du petit matin »
- Effets visuels : « reflets chauds sur le pelage »
Erreurs courantes dans les prompts et comment les éviter
Le flou : l’IA a besoin de détails concrets. Au lieu de « un beau paysage », précisez « sommets enneigés au lever du soleil, avec une brume s’élevant des forêts de pins ».
Des éléments contradictoires : évitez de mélanger des concepts incompatibles, comme « soleil de midi éclatant avec des étoiles visibles ».
Des séquences trop complexes : bien que certains modèles gèrent plusieurs actions, commencer par des actions simples et claires donne de meilleurs résultats.
Des repères temporels absents : précisez l’heure de la journée, la saison et la vitesse du mouvement lorsqu’ils sont pertinents pour votre scène.
Négliger la perspective de la caméra : indiquez si vous souhaitez un gros plan, un plan large, une vue de drone ou un mouvement de caméra précis.
Tutoriel pas à pas pour débutants
WAN-2.6-T2V se distingue comme un excellent point de départ pour la génération de vidéos à partir de texte, grâce à son équilibre entre qualité, fonctions et accessibilité. Voici comment commencer :
-
Accéder au modèle : accédez à la page WAN-2.6-T2V sur PicassoIA
-
Préparer votre prompt : rédigez une description détaillée en suivant la démarche structurée présentée plus haut.
-
Configurer les paramètres de base :
- Taille : choisissez parmi 1280×720 (paysage 16:9), 720×1280 (vertical 9:16), 1920×1080 (paysage HD) ou 1080×1920 (vertical HD)
- Durée : sélectionnez 5, 10 ou 15 secondes selon les besoins de votre contenu
- Audio : importez facultativement un fichier audio de 3 à 30 secondes pour la synchronisation
-
Activer les fonctions avancées :
- Expansion du prompt : laissez-la activée (par défaut) pour de meilleurs résultats
- Segmentation multi-plans : activez-la pour des changements de scène de style cinématographique dans votre vidéo
- Prompt négatif : indiquez les éléments à éviter (par exemple « flou, visages déformés, texte superposé »)
-
Définir le seed (facultatif) : utilisez une valeur de seed précise pour obtenir des résultats reproductibles lors de la création de variantes
-
Générer et vérifier : le traitement prend généralement 1 à 5 minutes selon la durée et la résolution
La relecture professionnelle et le contrôle qualité garantissent que les contenus générés par IA respectent les standards de production
Techniques avancées d’optimisation des paramètres
Stratégie de segmentation multi-plans : lorsqu’elle est activée, WAN-2.6-T2V découpe intelligemment votre prompt en segments de scène logiques. Pour de meilleurs résultats :
- Structurez votre prompt avec des transitions de scène clairement suggérées
- Exemple : « Plan d’ouverture d’un horizon urbain à l’aube, puis coupe sur l’intérieur animé d’un café, plan final d’une personne traversant un parc »
Timing de la synchronisation audio : lorsque vous ajoutez un son :
- Faites correspondre la durée de votre extrait audio à la durée de la vidéo choisie
- Tenez compte de la tonalité émotionnelle de votre audio lorsque vous rédigez les prompts visuels
- Une musique rythmée se marie bien avec des mouvements de caméra dynamiques
- Les morceaux instrumentaux plus doux conviennent aux scènes calmes et lentes
Conseils pour le choix de la résolution :
- 1280×720 : le plus économique pour les tests et les réseaux sociaux
- 1920×1080 : recommandé pour les usages professionnels
- Formats verticaux : indispensables pour les stratégies de contenu pensées d’abord pour le mobile
Optimisation de la durée :
- 5 secondes : parfait pour les extraits sur les réseaux sociaux et les mises en avant de produits
- 10 secondes : idéal pour les contenus explicatifs et les courtes démonstrations
- 15 secondes : adapté aux mini-récits et à la mise en place d’une scène
Intégrer les vidéos IA à votre flux de production
Stratégies de post-production et d’amélioration
Les vidéos générées par IA gagnent souvent à être retravaillées avec des techniques de post-production traditionnelles :
Étalonnage des couleurs : appliquez des profils colorimétriques cohérents à plusieurs extraits générés par IA pour préserver la cohérence visuelle.
Amélioration audio : superposez des effets sonores, des voix off ou des morceaux de musique pour enrichir le produit final.
Montage et séquençage : combinez plusieurs extraits générés par IA avec des images tournées de façon traditionnelle pour obtenir des productions hybrides.
Superposition de texte et de graphiques : ajoutez titres, légendes, logos ou infographies pour contextualiser le contenu.
Réglage de la vitesse : modifiez la vitesse de lecture pour un effet dramatique ou pour respecter des contraintes de timing précises.
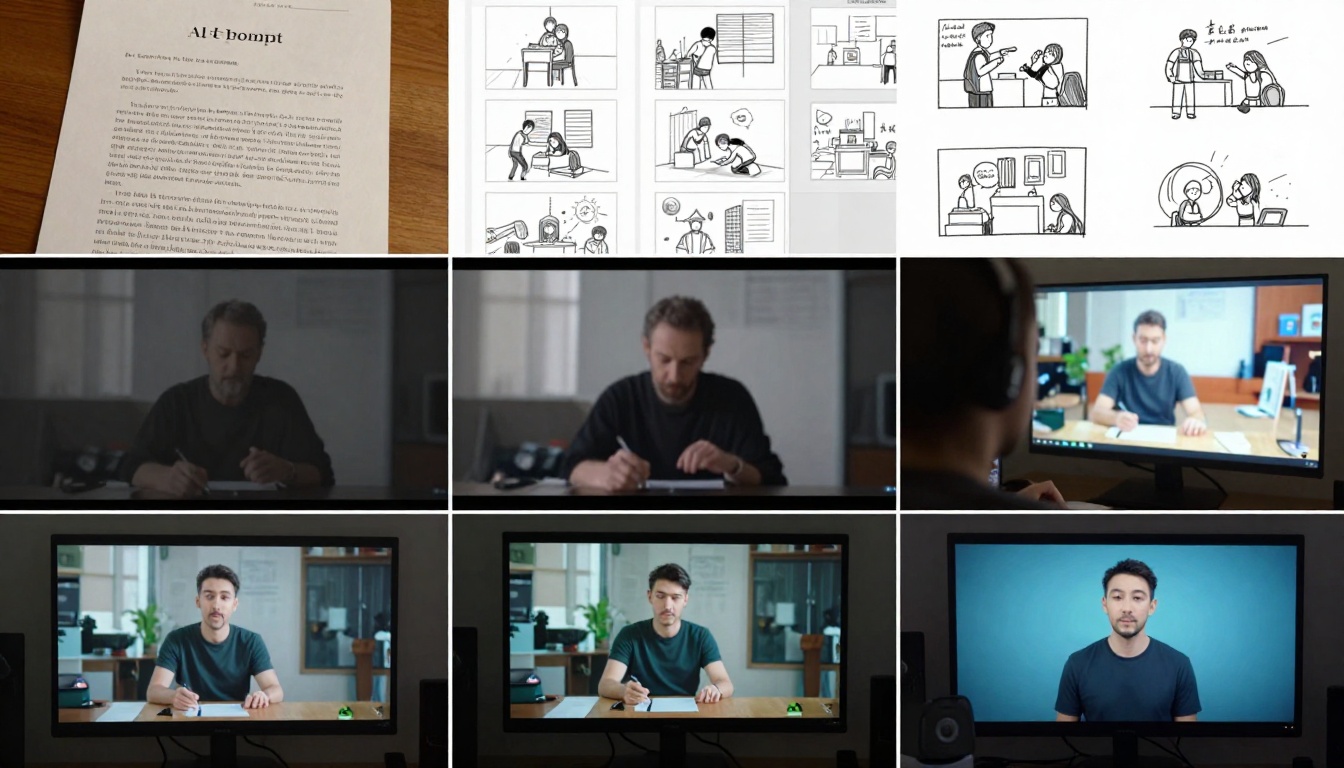
Le flux de travail complet, de l’idée textuelle à la livraison finale, implique plusieurs étapes d’affinage
Contrôle qualité et mesures de cohérence
Génération par lots avec contrôle du seed : générez plusieurs variantes avec le même seed en ajustant légèrement le prompt, afin de conserver une cohérence visuelle sur toute une série.
Chartes graphiques pour l’alignement sur la marque : créez des modèles de prompts intégrant le langage visuel de votre marque, sa palette de couleurs et ses préférences de composition.
Listes de contrôle de validation : définissez des critères d’assurance qualité couvrant :
- Cohérence visuelle d’une image à l’autre
- Physique du mouvement appropriée
- Cohérence des couleurs
- Netteté de la résolution
- Synchronisation audio-visuelle (le cas échéant)
Processus d’affinage itératif : considérez les premières générations comme des brouillons, et utilisez les résultats pour affiner les prompts suivants afin d’obtenir de meilleurs résultats.
Applications concrètes et cas d’usage
Exemples en marketing et publicité
Vidéos de démonstration produit : transformez des spécifications techniques en présentations visuelles captivantes. Une entreprise de mobilier pourrait générer des vidéos montrant ses produits dans différentes pièces, à partir des descriptions de son catalogue.
Création de contenus pour les réseaux sociaux : produisez à grande échelle des contenus adaptés à chaque plateforme. Une marque de mode pourrait générer chaque semaine des vidéos de style à partir des descriptions produits, pour Instagram Reels et TikTok.
Messages vidéo personnalisés : créez des contenus vidéo sur mesure pour vos campagnes e-mail ou vos communications clients, en fonction des préférences individuelles ou de l’historique d’achat.
Vidéos explicatives : transformez des descriptions de services complexes en explications simples et visuelles pour vos pages d’atterrissage ou vos présentations commerciales.
Création de contenus éducatifs et de formation
Visualisation des cours : les enseignants peuvent transformer le texte du programme en contenus visuels captivants qui illustrent des événements historiques, des concepts scientifiques ou des principes mathématiques.
Conception de modules de formation : les formateurs en entreprise peuvent créer des démonstrations visuelles de procédures, de protocoles de sécurité ou de flux de travail logiciels à partir de la documentation écrite.
Supports d’apprentissage des langues : générez des scènes visuelles contextuelles qui illustrent le vocabulaire, les contextes culturels ou les situations de conversation.
Amélioration de l’accessibilité : créez des contenus visuels pour compléter les supports textuels, afin de répondre à des styles d’apprentissage variés et aux exigences d’accessibilité.
L’intégration des outils d’IA au matériel de cinéma traditionnel représente l’avenir de la production de contenus
Limites et défis actuels
Contraintes techniques à prendre en compte
Cohérence temporelle : bien que cela s’améliore, certains modèles peinent encore à maintenir une cohérence parfaite des objets sur des séquences plus longues ou lors de mouvements de caméra complexes.
Précision physique : la physique naturelle du mouvement, en particulier pour les interactions complexes entre plusieurs objets, reste un défi pour les systèmes actuels.
Limites de résolution : la plupart des modèles ont une résolution maximale, même si cela évolue rapidement à chaque nouvelle génération.
Temps de génération : selon la complexité du modèle et la qualité souhaitée, la génération peut prendre de quelques secondes à quelques minutes, ce qui affecte les flux de travail d’itération rapide.
Facteurs de coût : les générations de meilleure qualité nécessitent généralement davantage de ressources de calcul, ce qui se traduit par un coût plus élevé par vidéo.
Limites créatives et considérations éthiques
Originalité ou dérivation : des questions demeurent sur l’origine des données d’entraînement et sur la mesure dans laquelle le contenu généré relève d’une création réellement originale, plutôt que d’une recombinaison de schémas appris.
Questions de propriété intellectuelle : le cadre juridique de la propriété et du droit d’auteur sur les contenus générés par l’IA continue d’évoluer selon les juridictions.
Représentation et biais : comme tous les systèmes d’IA entraînés sur des données existantes, les modèles texte vers vidéo peuvent refléter, voire amplifier, les biais présents dans leurs jeux de données d’entraînement.
Exigences de transparence : selon le cas d’usage et la juridiction, la mention du caractère généré par l’IA d’un contenu peut être obligatoire ou recommandée.
Authenticité créative : les débats se poursuivent sur le rôle de l’IA dans les processus créatifs et sur ce qui constitue une expression artistique authentique.
La diversité des résultats illustre la polyvalence de la technologie moderne texte vers vidéo
Le paysage de l’IA texte vers vidéo évolue à un rythme remarquable. Ce qui était une technologie expérimentale est devenu des outils concrets que les professionnels de la création intègrent à leur travail quotidien. L’association de plateformes accessibles comme PicassoIA et de modèles de plus en plus sophistiqués comme WAN-2.6-T2V rend cette technologie accessible aux créateurs de tous niveaux.
Les mises en œuvre les plus réussies allient les capacités de l’IA à la créativité humaine : elles utilisent les contenus générés comme points de départ à affiner, combinent plusieurs extraits en récits cohérents et appliquent des techniques de production traditionnelles pour améliorer les résultats de l’IA. Cette approche hybride tire parti de la rapidité et de l’évolutivité de l’IA tout en préservant la direction artistique et les standards de qualité de la production professionnelle.
À mesure que la technologie progresse, on peut s’attendre à des améliorations de la cohérence temporelle, de la simulation physique et du contrôle créatif. La génération actuelle offre déjà des résultats impressionnants pour de nombreuses applications, et la trajectoire laisse présager des systèmes encore plus performants à court terme.
Pour ceux qui sont prêts à explorer cette technologie, la suite passe par l’expérimentation, l’itération et l’intégration. Commencez par des projets clairs et bien définis, apprenez par la pratique et élargissez progressivement vos cas d’usage à mesure que vous maîtrisez le prompt engineering et les capacités des modèles. Les outils existent : les possibilités créatives n’attendent plus que d’être explorées.


