Un mal lipsync es una de las formas más rápidas de sacar al espectador de tu animación. No importa lo pulido que sea el diseño del personaje ni lo suaves que sean sus curvas de movimiento. En cuanto una boca se mueve desfasada respecto a la voz, el público lo nota al instante. Ya trabajes con personajes 2D, rigs 3D o avatares parlantes generados con IA, sincronizar los labios con el audio es una habilidad que merece la pena trabajar en serio.
Por qué un mal lipsync lo arruina todo
El cerebro mira primero la boca
Los seres humanos estamos programados para mirar la boca cuando alguien habla. Es la misma razón por la que las películas dobladas siempre parecen un poco fuera de lugar, incluso cuando la traducción es brillante. Tu cerebro compara constantemente lo que oye con lo que ve, y cuando esas dos señales no coinciden, la escena pierde credibilidad.
En los personajes animados, la tolerancia al error de sincronía es sorprendentemente baja. El público perdona mucho en la animación: físicas exageradas, fondos simplificados, anatomías estilizadas. Pero ¿un retraso de medio segundo en el audio o un personaje que sigue moviendo la boca después de que termine el diálogo? Eso se nota siempre.
Las cifras detrás de la percepción
Las investigaciones sobre la percepción audiovisual del habla muestran que los espectadores pueden detectar errores de sincronía de tan solo 40 a 80 milisegundos en condiciones óptimas. En la práctica, los errores de sincronía en animación por debajo de 150 ms suelen pasar desapercibidos en escenas de ritmo rápido, pero cualquier cosa por encima se percibe como incorrecta, incluso para espectadores casuales.
💡 La regla de los 2 fotogramas: A 24 fps, dos fotogramas equivalen a unos 83 ms. Mantener tu lipsync dentro de un margen de dos fotogramas respecto al inicio real del fonema es un objetivo práctico y sólido para la mayoría de estilos de animación.
El sistema de fonemas explicado
Separar el habla en formas de boca
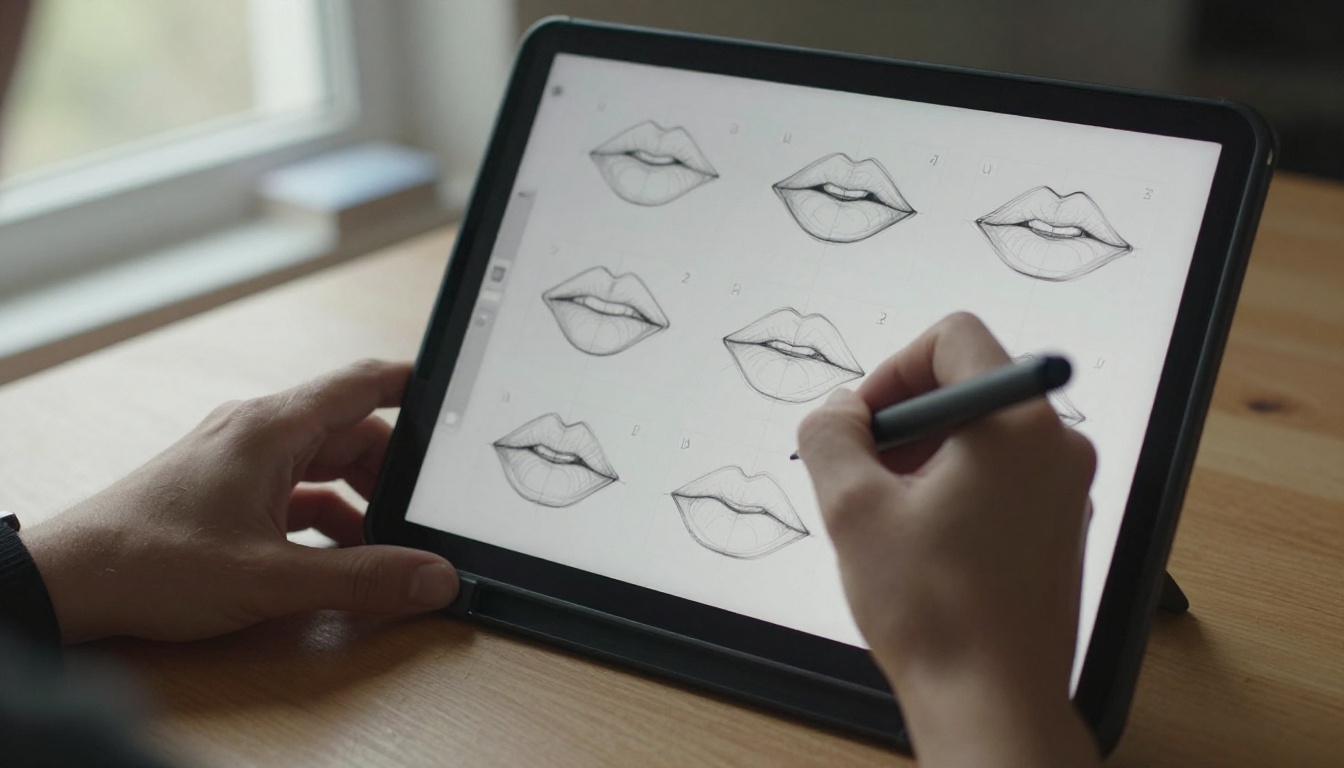
El lenguaje hablado no es un flujo continuo y suave. Es una secuencia de unidades sonoras discretas llamadas fonemas, y cada fonema corresponde a una forma de boca distinta, también llamada visema. La idea práctica para los animadores es esta: no necesitas un dibujo de boca único para cada sonido. Necesitas un conjunto reducido de formas bien elegidas que cubra toda la gama del habla.
La mayoría de los flujos de trabajo profesionales de animación usan entre 8 y 12 formas de boca básicas. La clasificación clásica de Preston Blair, que sigue utilizándose hoy, organiza los fonemas del inglés en grupos:
| Forma | Fonemas | Descripción |
|---|
| A/I | "ah", "ay", "i" | Boca muy abierta |
| O | "oh", "oo" | Labios redondeados |
| E | "ee", "e" | Estirada hacia atrás, dientes visibles |
| U | "u" | Ligeramente fruncida |
| M/B/P | "m", "b", "p" | Labios juntos y presionados |
| F/V | "f", "v" | Dientes superiores sobre el labio inferior |
| L/D/T | "l", "d", "t", "n" | Posición de la punta de la lengua |
| Th | "th" | Lengua entre los dientes |
| W/Q | "w", "qu" | Morro apretado y redondeado |
| Reposo | silencio | Posición neutra cerrada |
Por qué importa el número de visemas
Más formas de boca significan más realismo, pero también mucho más tiempo de animación. Menos formas significan una producción más rápida, aunque corren el riesgo de verse gomosas si no se manejan con cuidado. La mayoría de los animadores independientes encuentran el punto justo entre 8 y 10 formas. Las grandes producciones de estudio con rigs faciales suelen llegar a 16 o más, pero rara vez es necesario para contenido web o animación de formato corto.
El factor crítico es la coherencia: una vez que eliges una biblioteca de formas, úsala en toda la producción. Cambiar de enfoque a mitad de proyecto crea una incoherencia que el espectador detecta de forma subconsciente.
Qué estás mirando en realidad
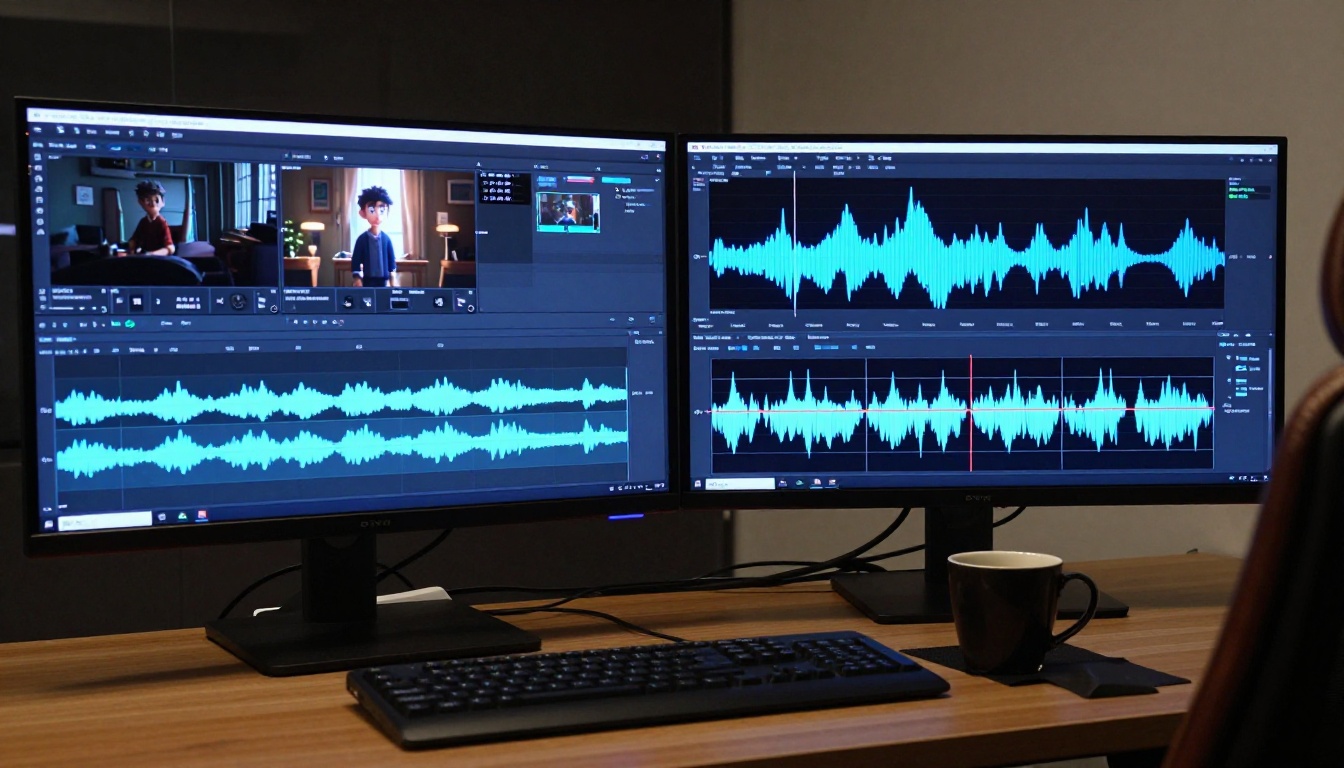
La forma de onda de audio en tu línea de tiempo es tu hoja de ruta para el trabajo de lipsync. Los picos de amplitud de la onda corresponden a vocales acentuadas y consonantes explosivas. Los pasajes silenciosos indican pausas, fricativas o consonantes suaves. Saber leer una forma de onda con fluidez es la habilidad más valiosa para el lipsync manual.
Algunos patrones prácticos que conviene reconocer:
- Picos verticales agudos: Consonantes oclusivas (p, b, t, d, k, g). Necesitan una forma de boca cerrada justo antes del pico, abriéndose de inmediato después.
- Amplitud densa y sostenida: Sílabas con muchas vocales. Mantienen una forma de boca abierta durante toda su duración.
- Desvanecimiento gradual: El final de una palabra o frase. La boca debe empezar a cerrarse mientras la amplitud sigue presente, no después de que llegue el silencio.
- Secciones planas: Pausas e inspiraciones. La boca debe volver por completo a la posición de reposo en este punto.
El desfase de tiempo que la mayoría de animadores pasa por alto
Un principio contraintuitivo del lipsync profesional es que la forma de la boca debe adelantarse ligeramente al audio. Como el ojo humano procesa la información visual un poco antes de que la percibamos conscientemente en el audio, una boca que se abre exactamente en el fotograma de un sonido puede parecer tardía.
La corrección habitual es colocar los fotogramas clave de boca abierta de 1 a 2 fotogramas antes del inicio del audio. A 24 fps, eso equivale a unos 42 a 83 ms de anticipación visual. En diálogos rápidos, esto marca una diferencia perceptible.
💡 Consejo práctico: Desplázate por tu línea de tiempo un fotograma a la vez en una línea de diálogo rápida. Si el pico de la onda y el pico de apertura de la boca están en el mismo fotograma, mueve el fotograma clave de la boca un fotograma antes. Ese pequeño ajuste suele convertir una sincronía mediocre en algo que parece natural.
Lipsync con IA en PicassoIA
Qué cambia con las herramientas de IA
El lipsync manual exige mucho oficio. Incluso en una escena de diálogo de 30 segundos, colocar y ajustar los fotogramas clave de cada fonema puede llevar horas. Las herramientas de lipsync con IA cambian el flujo de trabajo de raíz: en lugar de animar las formas de la boca fotograma a fotograma, le das a la herramienta una pista de audio (y opcionalmente un rostro de referencia) y ella genera la sincronía automáticamente.
La calidad de los resultados ha mejorado de forma notable en los últimos años. Los mejores modelos de IA actuales logran una precisión de sincronía que a un animador profesional le habría llevado días conseguir a mano, en cuestión de segundos.
Cómo usar Lipsync 2 Pro
Lipsync 2 Pro de Sync es uno de los modelos de lipsync automatizado más precisos disponibles en PicassoIA. Está pensado para aplicar una sincronía labial precisa a metraje de video existente de personajes o personas.
Paso a paso con Lipsync 2 Pro:
- Abre Lipsync 2 Pro en PicassoIA.
- Sube tu archivo de video (el clip del personaje animado o la grabación de una cabeza parlante).
- Sube el archivo de audio al que quieres sincronizar (locución, grabación de diálogo o audio doblado).
- Configura el modo de sincronía: Tight para una precisión exacta a nivel de fonema, Natural para transiciones más suaves entre formas.
- Pulsa Generate y deja que el modelo procese. Con la configuración estándar, el procesado tarda de 30 a 90 segundos por minuto de metraje.
- Descarga el resultado y revísalo fotograma a fotograma en tu editor.
💡 Consejo de parámetros: Para personajes de dibujos animados con formas de boca simplificadas, usa el modo Tight. Para personajes 3D más realistas o avatares fotorrealistas, el modo Natural produce menos vibración entre fotogramas de fonemas contiguos.
El modelo estándar Lipsync 2 es una opción sólida si necesitas un procesado más rápido con una precisión algo menor. Ambos ofrecen resultados de nivel profesional para la mayoría de necesidades de producción.
Kling Lip Sync para personajes en movimiento
Kling Lip Sync de Kwaivgi destaca especialmente en clips de video donde el rostro del personaje se mueve mucho mientras habla. Las herramientas de lipsync tradicionales pueden tener problemas cuando la cabeza gira, asiente o la cámara se mueve. Kling maneja bien estos casos porque sigue el rostro a lo largo de los fotogramas antes de aplicar la sincronía.
Es especialmente adecuado para:
- Personajes animados con movimiento activo de cabeza durante el diálogo
- Escenas con cortes de cámara a mitad de frase
- Clips cortos en formato social en los que el personaje está en movimiento todo el tiempo
Avatares parlantes con Omni Human
Omni Human 1.5 de ByteDance sigue un enfoque distinto: en lugar de sincronizar una animación existente con el audio, genera un video parlante a partir de una sola imagen fija. Sube una ilustración de personaje o una fotografía, aporta un archivo de audio y Omni Human anima el rostro con un movimiento labial natural, un leve movimiento de cabeza y parpadeos.
Esto es ideal para:
- Retratos de personajes que se adaptan a contenido de video corto
- Clips para redes sociales en los que no hace falta animación de cuerpo completo
- Prototipado rápido de escenas de diálogo antes de comprometerse con una animación completa
Omni Human (la versión anterior) sigue disponible y es algo más rápida para casos de uso básicos en los que no se necesita la máxima fidelidad de la 1.5.
Comparación de modelos de un vistazo
| Modelo | Ideal para | Entrada | Velocidad |
|---|
| Lipsync 2 Pro | Sincronía precisa en video existente | Video + Audio | Media |
| Lipsync 2 | Sincronía rápida, calidad estándar | Video + Audio | Rápida |
| Kling Lip Sync | Personajes en movimiento en video | Video + Audio | Media |
| Omni Human 1.5 | De foto a video parlante | Imagen + Audio | Media |
| React 1 | Superposición de lipsync realista | Video + Audio | Rápida |
| Fabric 1.0 | Hacer hablar a las fotos | Imagen + Audio | Rápida |
3 errores comunes de lipsync
El problema del aleteo labial
Lip flap es el término informal para una boca que sigue abriéndose y cerrándose después de que el personaje deja de hablar, o que recorre formas sin corresponder a ningún fonema. Es el error de lipsync más común en animación de bajo presupuesto, y tiene una causa concreta: los animadores colocan las formas de boca sin consultar la forma de onda, guiándose por suposiciones sobre el ritmo.
La solución es sencilla: nunca coloques un fotograma clave de boca abierta sin identificar en la forma de onda un fonema concreto que lo justifique. Cada posición de boca abierta debe tener un sonido correspondiente.
Exagerar las consonantes
Las consonantes duras (sobre todo las oclusivas como "p", "b", "t", "d") no necesitan formas de boca exageradas. La boca debe cerrarse brevemente para estos sonidos, pero la posición cerrada debe ser sutil, no un apretón fuerte. Las formas de consonante demasiado enfáticas crean una calidad entrecortada y sobreanimada que llama la atención sobre la sincronía en lugar de sobre la interpretación.
💡 Muchos animadores profesionales suavizan a propósito las formas de consonante entre un 30 y un 50 % respecto a su primer impulso. La sutileza se lee como más natural, sobre todo a velocidad de reproducción normal.
Olvidar el movimiento de la mandíbula
El lipsync no es solo labios. El movimiento de la mandíbula es lo que transmite la sensación general de que un personaje habla. Un rig de cabeza sin una animación de mandíbula adecuada parecerá un muñeco de ventrílocuo, por muy precisas que sean las formas de los labios. En rigs 3D, la rotación de la mandíbula debe seguir la intensidad de las vocales. En animación 2D, la línea de la mandíbula debe bajar de forma visible en las vocales abiertas acentuadas.
La mandíbula también impone una restricción física a las formas de boca posibles. Una "ah" muy abierta requiere que la mandíbula caiga. Mostrar formas de labios muy abiertas sin que la mandíbula baje se ve anatómicamente incorrecto y también lo parece.
Consejos profesionales para resultados pulidos
Sincroniza con la mezcla final, no con la guía
Uno de los errores de producción más comunes es animar el lipsync sobre una grabación de guía temprana y, después, sustituir el audio por la mezcla final sin volver a comprobar la sincronía. Incluso pequeñas diferencias de tiempo entre la guía y la grabación final (una dicción más rápida o un ritmo ligeramente distinto por parte del actor de doblaje) hacen que la sincronía se desvíe.
Termina siempre el audio antes de bloquear el lipsync. Si se regraba después de haber sincronizado, trátalo como volver a hacer el trabajo de sincronía, no como un simple cambio de archivo.
Grabar video de referencia de los actores de doblaje
Los estudios de animación profesionales graban de forma habitual video de los actores de doblaje durante la sesión de grabación, no solo audio. Estos videos de referencia dan a los animadores una interpretación real que analizar: las formas exactas de la boca, el ritmo del movimiento de la mandíbula y las pequeñas expresiones físicas que hacen que el diálogo parezca habitado por el personaje.
Incluso si trabajas en solitario en un proyecto, grabarte diciendo las frases con tu teléfono y revisar el metraje fotograma a fotograma te da una referencia mucho más útil que adivinar.
Conciencia de los fotogramas por segundo
Tu precisión de sincronía está limitada por tus fotogramas por segundo. A 12 fps, cada fotograma dura 83 ms, lo que significa que tu mejor precisión posible es de aproximadamente un fotograma, que ya está en el umbral de lo perceptible. A 24 fps, tienes 42 ms por fotograma. A 30 fps, 33 ms.
En proyectos con mucho lipsync, se recomienda trabajar con un mínimo de 24 fps. Animar el diálogo a 12 fps puede funcionar en producciones estilizadas con una estética deliberadamente limitada, pero exige aceptar una imprecisión visible en la sincronía como parte del estilo.
Sincronizar distintos tipos de personaje
Personajes 2D fotograma a fotograma
Los personajes 2D tradicionales suelen usar un enfoque de animación por reemplazo para el lipsync: un dibujo de boca distinto para cada forma de fonema, que se intercambia en el fotograma correspondiente. Es eficiente porque reutilizas una pequeña biblioteca de formas ya dibujadas en lugar de redibujar la boca en cada fotograma.
El flujo de trabajo:
- Dibuja la biblioteca completa de formas de fonema para el estilo de tu personaje.
- Divide la pista de audio en eventos de fonema con marcas de tiempo.
- Coloca el dibujo correcto en el fotograma de inicio de cada fonema.
- Suaviza las transiciones entre formas alejadas insertando posiciones intermedias.
Personajes 3D con rig
Los personajes 3D usan blend shapes o rigs de huesos para transformar entre posiciones de boca. El flujo es parecido en concepto, pero consiste en definir valores en los controles del rig en lugar de cambiar dibujos.
La mayoría del software de animación 3D (Blender, Maya, Cinema 4D) incluye una forma de hornear el audio en fotogramas clave, lo que automatiza la colocación inicial de los fonemas. El resultado normalmente necesita un ajuste manual, pero ofrece un punto de partida mucho más rápido que colocar cada fotograma clave a mano.
Personajes generados con IA y fotografías
Para personajes generados con IA o fotografías que se quieren dar vida, herramientas como Omni Human 1.5 y Fabric 1.0 se encargan por completo de generar la sincronía. El flujo de trabajo pasa de la animación a la ingeniería de prompts y la iteración: entender qué entradas producen la mejor sincronía para el estilo concreto de tu personaje.
P Video Avatar de Prunaai merece la pena probarlo para crear videos de avatares parlantes a partir de imágenes de personajes con muy poca configuración.
Automatización y velocidad a escala
Software de detección automática de fonemas
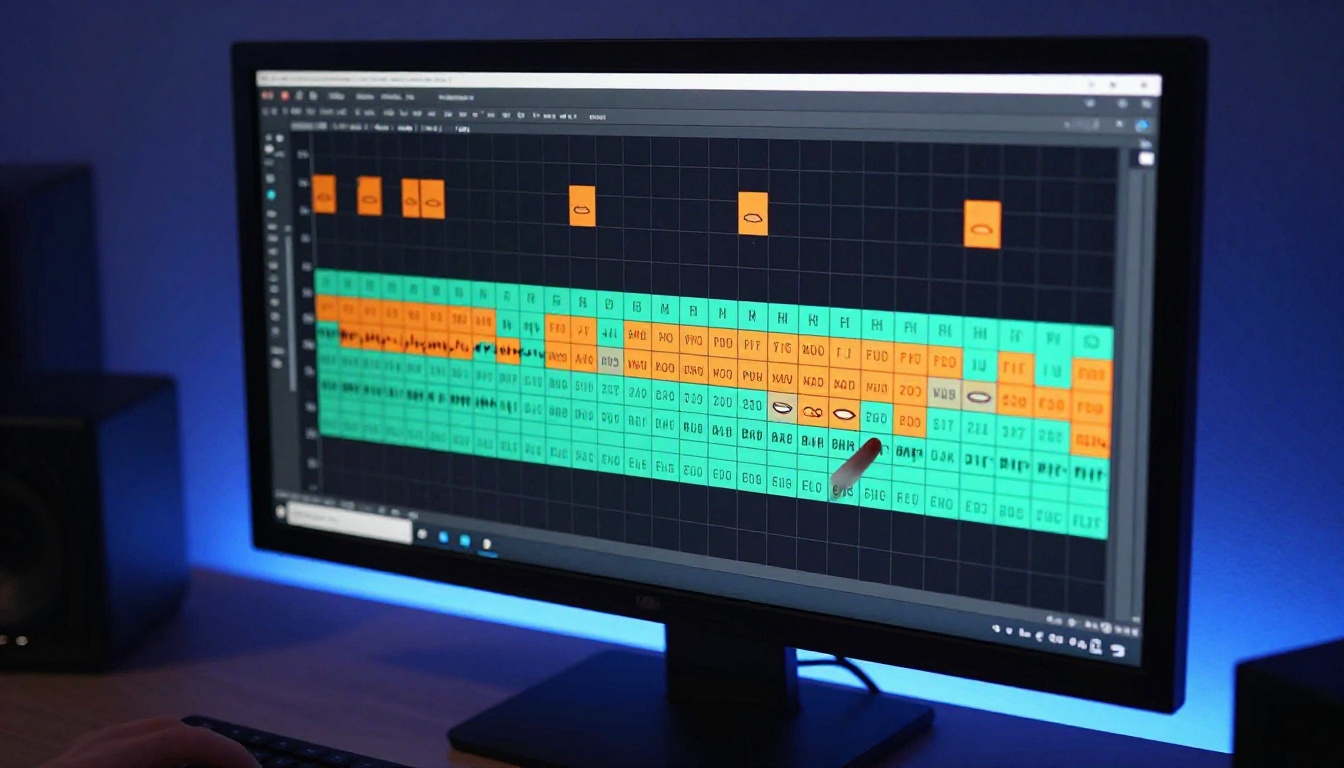
Varias herramientas de software pueden detectar fonemas automáticamente en un archivo de audio y generar un desglose con tiempos que puedes usar como referencia para los fotogramas clave. Papagayo-NG es una opción gratuita muy conocida. Adobe Character Animator lo incluye de serie. La mayoría de las aplicaciones 3D con capacidad de hornear audio hacen algo similar.
El resultado de estas herramientas es un punto de partida, no un producto terminado. La detección automática de fonemas es buena identificando los grandes eventos vocálicos y las oclusivas, pero tiene dificultades con los grupos de consonantes, el habla rápida y la pronunciación poco habitual. Reserva entre un 30 y un 50 % del tiempo manual original para la limpieza tras la detección automática.
Doblaje y sincronía multilingüe
Cuando necesitas sincronizar un nuevo diálogo con metraje en otro idioma, herramientas de IA como Video Translate de HeyGen se encargan a la vez de la traducción y del ajuste del lipsync. Es un cambio importante en el flujo de trabajo para cualquiera que produzca contenido multilingüe. Lo que antes requería regrabar, reeditar y reanimar para cada idioma ahora puede procesarse de forma automática.
Lipsync Speed y Lipsync Precision de HeyGen ofrecen dos puntos en el espectro entre precisión y velocidad. El modo Speed procesa con rapidez para la revisión de borradores. El modo Precision es más lento, pero ofrece una precisión de fonemas más ajustada para el resultado final.
Pixverse Lipsync completa las opciones de PicassoIA para equipos que necesitan sincronía instantánea entre audio y video sin trabajo manual fotograma a fotograma.
Una nota sobre las expectativas de calidad de la sincronía
Ninguna herramienta automatizada, con IA o sin ella, produce una sincronía perfecta en la primera pasada para todo tipo de entrada. La diferencia entre un buen resultado y uno excelente casi siempre está en el ciclo de revisión e iteración: ver el resultado con ojo crítico, identificar los dos o tres fotogramas que no encajan y hacer ajustes puntuales.
Trata el resultado de la sincronía con IA del mismo modo que un profesional trata la detección automática de fonemas: un buen punto de partida que ahorra entre un 70 y un 80 % del trabajo manual, mientras que entre el 20 y el 30 % restante requiere criterio humano.
Empieza a crear personajes que hablan
La diferencia entre un lipsync aceptable y uno realmente convincente depende de una sola cosa: cuánta atención prestas al audio. Cada herramienta de este artículo, ya sea un enfoque de fotogramas clave manual o un modelo de IA en PicassoIA, da mejores resultados cuando le das una buena entrada y revisas el resultado con ojo crítico.
Empieza con un clip de diálogo corto. Usa Lipsync 2 Pro para generar una base de sincronía automatizada y luego compárala con la forma de onda. Mira el resultado en bucle. Fíjate en qué fotogramas no encajan y en cuáles sí. Ese ciclo de generación, revisión y ajuste es donde se desarrolla el verdadero instinto para el lipsync.
Si quieres dar vida al instante a la imagen fija de un personaje, prueba Omni Human 1.5 con un clip de audio corto. Los resultados te darán una idea concreta de lo que puede producir el lipsync asistido por IA y de dónde están todavía sus límites.
PicassoIA tiene una biblioteca completa de modelos de lipsync lista para usar. Tanto si doblas metraje, animas un retrato o aplicas sincronía a un render de personaje 3D, hay una herramienta para tu flujo de trabajo concreto. Haz pruebas, compara resultados y sigue refinando. Tus personajes te lo agradecerán.


