खराब लिपसिंक दर्शक को आपके एनिमेशन से बाहर निकालने का सबसे तेज़ तरीका है। इससे फ़र्क नहीं पड़ता कि आपका कैरेक्टर डिज़ाइन कितना पॉलिश्ड है या मूवमेंट के कर्व कितने स्मूद हैं। जैसे ही मुँह बोली से मेल नहीं खाता, दर्शक तुरंत इसे महसूस कर लेते हैं। चाहे आप 2D कैरेक्टर, 3D रिग, या AI से बने टॉकिंग अवतार के साथ काम कर रहे हों, होंठों को ऑडियो से सिंक करना एक ऐसा कौशल है जिसमें गंभीरता से समय लगाना सार्थक है।
खराब लिपसिंक सब कुछ क्यों बिगाड़ देता है
दिमाग सबसे पहले मुँह देखता है
इंसान जब कोई बोलता है तो मुँह देखने के लिए ही बना है। यही वजह है कि डब की गई फ़िल्में हमेशा थोड़ी अटपटी लगती हैं, भले ही अनुवाद कितना भी शानदार हो। आपका दिमाग लगातार जो सुनता है और जो देखता है, उन्हें आपस में मिलाता रहता है, और जब ये दोनों संकेत मेल नहीं खाते, तो पूरे सीन की विश्वसनीयता खत्म हो जाती है।
खासतौर पर एनिमेटेड कैरेक्टर के लिए सिंक की गलती की सहनशीलता अप्रत्याशित रूप से कम होती है। एनिमेशन में दर्शक बहुत कुछ माफ़ कर देते हैं: बढ़ा-चढ़ाकर दिखाई गई फ़िज़िक्स, सरल बैकग्राउंड, स्टाइलाइज़्ड शरीर की बनावट। लेकिन आधा सेकंड का ऑडियो लैग या डायलॉग खत्म होने के बाद भी कैरेक्टर का मुँह चलते रहना? यह हर बार पकड़ में आता है।
धारणा के पीछे के आँकड़े
ऑडियोविज़ुअल स्पीच पर्सेप्शन की शोध बताती है कि अनुकूल परिस्थितियों में दर्शक 40 से 80 मिलीसेकंड जितनी छोटी सिंक गलती भी पकड़ सकते हैं। व्यवहार में, तेज़ रफ़्तार वाले सीन में 150ms से कम की एनिमेशन सिंक गलतियाँ अक्सर नज़र नहीं आतीं, लेकिन इससे ज़्यादा कुछ भी आम दर्शकों को भी गलत लगता है।
💡 2-फ़्रेम नियम: 24fps पर दो फ़्रेम लगभग 83ms के बराबर होते हैं। अपने लिपसिंक को असली फ़ोनीम ऑनसेट से दो-फ़्रेम के मार्जिन के भीतर रखना ज़्यादातर एनिमेशन स्टाइल के लिए एक ठोस कार्यशील लक्ष्य है।
फ़ोनीम सिस्टम की व्याख्या
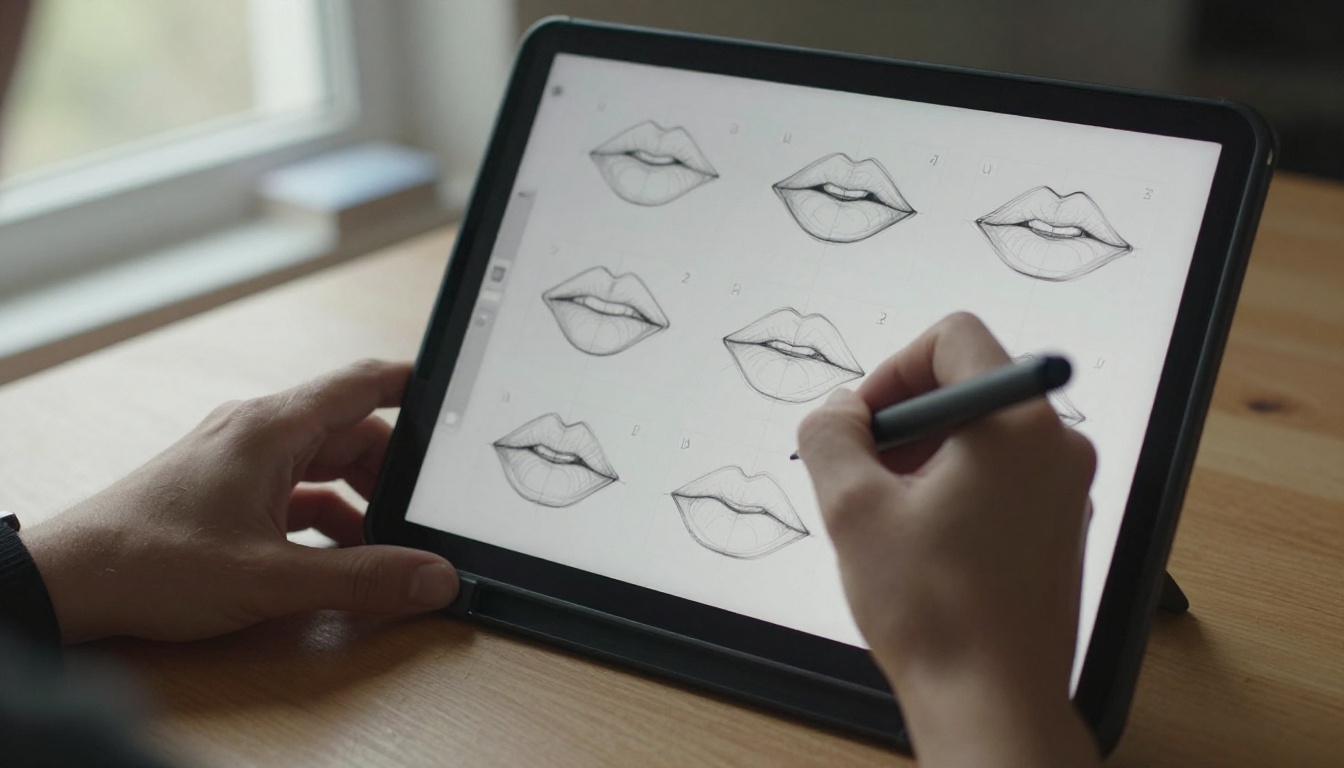
बोली को मुँह के आकारों में तोड़ना
बोली कोई चिकनी, लगातार बहती धारा नहीं है। यह फ़ोनीम नाम की अलग-अलग ध्वनि इकाइयों का क्रम है, और हर फ़ोनीम मुँह के एक अलग आकार से मेल खाता है, जिसे वाइज़ीम भी कहते हैं। एनिमेटर के लिए व्यावहारिक समझ यह है: आपको हर ध्वनि के लिए अलग मुँह का चित्र बनाने की ज़रूरत नहीं है। आपको आकारों का एक छोटा, सोच-समझकर चुना गया सेट चाहिए जो बोली की पूरी रेंज को कवर करे।
ज़्यादातर प्रोफ़ेशनल एनिमेशन पाइपलाइन में 8 से 12 मुख्य मुँह के आकार इस्तेमाल होते हैं। Preston Blair का क्लासिक ब्रेकडाउन, जो आज भी व्यापक रूप से इस्तेमाल होता है, अंग्रेज़ी फ़ोनीम्स को समूहों में बाँटता है:
| आकार | फ़ोनीम | विवरण |
|---|
| A/I | "ah", "ay", "i" | चौड़ा खुला मुँह |
| O | "oh", "oo" | गोल होंठ |
| E | "ee", "e" | पीछे खिंचे हुए, दाँत दिखते हुए |
| U | "u" | हल्के से सिकुड़े हुए |
| M/B/P | "m", "b", "p" | होंठ आपस में दबे हुए |
| F/V | "f", "v" | ऊपर के दाँत निचले होंठ पर |
| L/D/T | "l", "d", "t", "n" | जीभ की नोक की स्थिति |
| Th | "th" | दाँतों के बीच जीभ |
| W/Q | "w", "qu" | कसकर गोल की हुई सिकुड़न |
| Rest | silence | तटस्थ बंद स्थिति |
वाइज़ीम की गिनती क्यों मायने रखती है
मुँह के ज़्यादा आकार मतलब ज़्यादा यथार्थवाद, लेकिन एनिमेशन का समय भी काफ़ी बढ़ जाता है। कम आकार तेज़ प्रोडक्शन देते हैं, लेकिन सावधानी से न संभाले जाएँ तो लचीले, रबर जैसे दिख सकते हैं। ज़्यादातर स्वतंत्र एनिमेटरों को 8 से 10 आकारों पर सही संतुलन मिलता है। फ़ेशियल रिग वाले बड़े स्टूडियो प्रोडक्शन अक्सर 16 या उससे ज़्यादा आकार तक जाते हैं, लेकिन वेब कंटेंट या शॉर्ट-फ़ॉर्म एनिमेशन के लिए इतनी ज़रूरत शायद ही कभी पड़ती है।
सबसे अहम बात है लगातारपन: एक बार शेप लाइब्रेरी चुन लें, तो पूरे प्रोडक्शन में उसी का इस्तेमाल करें। प्रोजेक्ट के बीच में तरीके बदलने से ऐसी असंगति पैदा होती है, जिसे दर्शक अवचेतन रूप से पकड़ लेते हैं।
वेवफ़ॉर्म पढ़ना
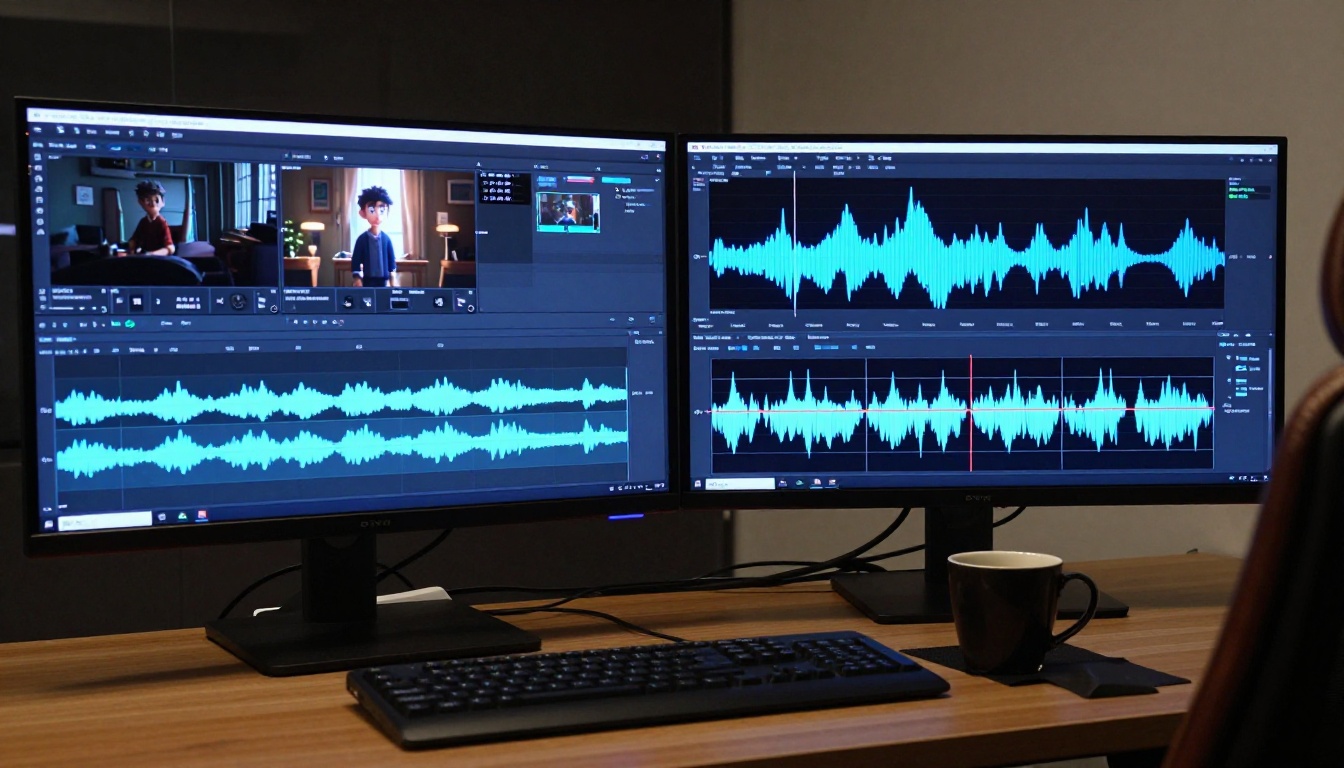
आप असल में क्या देख रहे हैं
आपकी टाइमलाइन में ऑडियो वेवफ़ॉर्म लिपसिंक के काम का रोडमैप है। वेवफ़ॉर्म में एम्प्लिट्यूड पीक ज़ोर वाले स्वरों और विस्फोटक व्यंजनों से मेल खाते हैं। शांत हिस्से विराम, घर्षण वाली ध्वनियों या हल्के व्यंजनों को दिखाते हैं। वेवफ़ॉर्म को धाराप्रवाह पढ़ पाना मैनुअल लिपसिंक के लिए सबसे मूल्यवान एकल कौशल है।
पहचानने के लिए कुछ व्यावहारिक पैटर्न:
- तीखी खड़ी चोटियाँ: प्लोसिव व्यंजन (p, b, t, d, k, g)। इन्हें चोटी से ठीक पहले बंद मुँह का आकार चाहिए, और उसके तुरंत बाद खुलना।
- घना, लगातार एम्प्लिट्यूड: स्वर-प्रधान अक्षर। ये पूरी अवधि तक खुले मुँह का आकार बनाए रखते हैं।
- धीरे-धीरे फ़ेड-आउट: किसी शब्द या वाक्यांश का अंत। एम्प्लिट्यूड अभी मौजूद रहते हुए मुँह बंद होना शुरू होना चाहिए, खामोशी आने के बाद नहीं।
- सपाट हिस्से: विराम और साँस लेना। यहाँ मुँह पूरी तरह आराम वाली स्थिति में लौट आना चाहिए।
वह टाइमिंग ऑफ़सेट जो ज़्यादातर एनिमेटर चूक जाते हैं
प्रोफ़ेशनल लिपसिंक में एक उल्टा लगने वाला सिद्धांत यह है कि मुँह का आकार ऑडियो से थोड़ा आगे चलना चाहिए। इंसान की आँख दृश्य जानकारी को उस गति से थोड़ा पहले प्रोसेस करती है जिस गति से हम सचेत रूप से ऑडियो समझते हैं, इसलिए जो मुँह ठीक उसी फ़्रेम पर खुलता है जहाँ ध्वनि शुरू होती है, वह असल में देर से खुला लग सकता है।
मानक सुधार यह है कि मुँह खुलने वाले कीफ़्रेम ऑडियो ऑनसेट से 1 से 2 फ़्रेम पहले रखे जाएँ। 24fps पर यह लगभग 42 से 83ms की दृश्य पूर्वानुमान अवधि है। तेज़ डायलॉग पर इससे साफ़ महसूस होने वाला बड़ा फ़र्क पड़ता है।
💡 व्यावहारिक टिप: तेज़ डायलॉग की एक लाइन पर अपनी टाइमलाइन को एक-एक फ़्रेम करके स्क्रब करें। अगर वेवफ़ॉर्म की चोटी और मुँह खुलने की चोटी एक ही फ़्रेम पर हैं, तो मुँह वाले कीफ़्रेम को एक फ़्रेम पहले खिसका दें। यह छोटा-सा बदलाव अक्सर औसत सिंक को स्वाभाविक महसूस होने वाले सिंक में बदल देता है।
PicassoIA पर AI लिपसिंक
AI टूल्स से क्या बदलता है
मैनुअल लिपसिंक में बहुत मेहनत लगती है। 30 सेकंड के छोटे डायलॉग सीन में भी हर फ़ोनीम के लिए कीफ़्रेम लगाना और उन्हें सुधारना घंटों ले सकता है। AI लिपसिंक टूल्स वर्कफ़्लो को मूल रूप से बदल देते हैं: मुँह के आकार फ़्रेम-दर-फ़्रेम एनिमेट करने के बजाय, आप टूल को एक ऑडियो ट्रैक (और चाहें तो एक रेफ़रेंस चेहरा) देते हैं और वह अपने-आप सिंक तैयार कर देता है।
हाल के वर्षों में आउटपुट की क्वालिटी में ज़बरदस्त सुधार हुआ है। आज के सबसे अच्छे AI मॉडल वह सिंक सटीकता कुछ ही सेकंड में दे देते हैं, जिसे किसी प्रोफ़ेशनल एनिमेटर को मैनुअली हासिल करने में कई दिन लगते।
Lipsync 2 Pro का इस्तेमाल कैसे करें
Sync का Lipsync 2 Pro PicassoIA पर उपलब्ध सबसे सटीक ऑटोमेटेड लिपसिंक मॉडल में से एक है। यह मौजूदा वीडियो फ़ुटेज में कैरेक्टर या लोगों पर सटीक मुँह-सिंक लगाने के लिए बनाया गया है।
Lipsync 2 Pro के साथ चरण-दर-चरण:
- PicassoIA पर Lipsync 2 Pro खोलें।
- अपनी वीडियो फ़ाइल अपलोड करें (एनिमेटेड कैरेक्टर क्लिप या टॉकिंग हेड फ़ुटेज)।
- वह ऑडियो फ़ाइल अपलोड करें जिससे सिंक करना है (वॉइसओवर, डायलॉग रिकॉर्डिंग या डब किया गया ऑडियो)।
- सिंक मोड सेट करें: सटीक फ़ोनीम-स्तर की सटीकता के लिए Tight, और आकारों के बीच स्मूद ट्रांज़िशन के लिए Natural।
- Generate दबाएँ और मॉडल को प्रोसेस करने दें। स्टैंडर्ड सेटिंग्स पर, हर मिनट के फ़ुटेज के लिए प्रोसेसिंग में 30 से 90 सेकंड लगते हैं।
- आउटपुट डाउनलोड करें और अपने एडिटर में फ़्रेम-दर-फ़्रेम जाँचें।
💡 पैरामीटर टिप: सरल मुँह आकार वाले कार्टून कैरेक्टर के लिए Tight मोड इस्तेमाल करें। ज़्यादा यथार्थवादी 3D कैरेक्टर या फोटोरियलिस्टिक अवतार के लिए Natural मोड आसन्न फ़ोनीम फ़्रेम के बीच कम झटके देता है।
अगर आपको थोड़ी कम सटीकता के बदले तेज़ प्रोसेसिंग चाहिए, तो स्टैंडर्ड Lipsync 2 मॉडल एक ठोस विकल्प है। ज़्यादातर प्रोडक्शन ज़रूरतों के लिए दोनों ही प्रोफ़ेशनल-ग्रेड आउटपुट देते हैं।
चलते हुए कैरेक्टर के लिए Kling Lip Sync
Kwaivgi का Kling Lip Sync खास तौर पर उन वीडियो क्लिप्स में उत्कृष्ट है जहाँ बोलते समय कैरेक्टर के चेहरे में काफ़ी मूवमेंट होता है। जब सिर घूम रहा हो, सिर हिल रहा हो, या कैमरा चल रहा हो, तो पारंपरिक लिपसिंक टूल्स में दिक्कत आ सकती है। Kling सिंक लगाने से पहले फ़्रेम-दर-फ़्रेम चेहरे को ट्रैक करके इन स्थितियों को अच्छी तरह संभालता है।
यह खास तौर पर इनके लिए उपयुक्त है:
- डायलॉग के दौरान सक्रिय सिर मूवमेंट वाले एनिमेटेड कैरेक्टर
- वाक्य के बीच में कैमरा कट वाले सीन
- छोटे सोशल-फ़ॉर्मेट क्लिप जिनमें कैरेक्टर पूरे समय गतिमान है
Omni Human के साथ टॉकिंग अवतार
ByteDance का Omni Human 1.5 अलग तरीका अपनाता है: मौजूदा एनिमेशन को ऑडियो से सिंक करने के बजाय, यह एक ही स्थिर इमेज से टॉकिंग वीडियो बनाता है। एक कैरेक्टर इलस्ट्रेशन या फ़ोटो अपलोड करें, एक ऑडियो फ़ाइल दें, और Omni Human चेहरे को स्वाभाविक दिखने वाले होंठों की गति, हल्के सिर के मूवमेंट और पलक झपकने के साथ एनिमेट करता है।
यह इनके लिए आदर्श है:
- कैरेक्टर पोर्ट्रेट जिन्हें छोटे वीडियो कंटेंट में बदला जा रहा है
- सोशल मीडिया क्लिप जहाँ फ़ुल-बॉडी एनिमेशन की ज़रूरत नहीं है
- पूरे एनिमेशन पर काम शुरू करने से पहले डायलॉग सीन का रैपिड प्रोटोटाइप
Omni Human (पिछला वर्ज़न) अब भी उपलब्ध है, और उन सरल उपयोगों के लिए थोड़ा तेज़ है जहाँ 1.5 की सबसे उच्च फ़िडेलिटी की ज़रूरत नहीं होती।
मॉडल की तुलना एक नज़र में
| मॉडल | सबसे अच्छा किसके लिए | इनपुट | स्पीड |
|---|
| Lipsync 2 Pro | मौजूदा वीडियो पर सटीक सिंक | वीडियो + ऑडियो | मध्यम |
| Lipsync 2 | तेज़ सिंक, स्टैंडर्ड क्वालिटी | वीडियो + ऑडियो | तेज़ |
| Kling Lip Sync | वीडियो में चलते कैरेक्टर | वीडियो + ऑडियो | मध्यम |
| Omni Human 1.5 | फ़ोटो से टॉकिंग वीडियो | इमेज + ऑडियो | मध्यम |
| React 1 | यथार्थवादी लिपसिंक ओवरले | वीडियो + ऑडियो | तेज़ |
| Fabric 1.0 | फ़ोटो को बोलने वाला बनाना | इमेज + ऑडियो | तेज़ |
3 आम लिपसिंक गलतियाँ
लिप फ़्लैप की समस्या
लिप फ़्लैप उस स्थिति के लिए अनौपचारिक शब्द है जिसमें कैरेक्टर का बोलना बंद करने के बाद भी मुँह खुलता-बंद होता रहता है, या वह बिना किसी फ़ोनीम से मेल खाए आकारों के बीच घूमता रहता है। यह कम बजट के एनिमेशन की सबसे आम लिपसिंक गलती है, और इसका एक खास कारण है: एनिमेटर वेवफ़ॉर्म देखे बिना मुँह के आकार लगाते हैं, और लय के बारे में अंदाज़े पर निर्भर रहते हैं।
इसका हल सीधा है: बिना वेवफ़ॉर्म में किसी खास फ़ोनीम की पहचान किए, कभी मुँह खोलने वाला कीफ़्रेम न लगाएँ। खुले मुँह की हर स्थिति के पीछे कोई न कोई संबंधित ध्वनि होनी चाहिए।
व्यंजनों को ज़रूरत से ज़्यादा एनिमेट करना
कठोर व्यंजनों (खासकर "p", "b", "t", "d" जैसे प्लोसिव) को बढ़ा-चढ़ाकर बने मुँह के आकारों की ज़रूरत नहीं होती। इन ध्वनियों के लिए मुँह थोड़ी देर के लिए बंद होना चाहिए, लेकिन बंद स्थिति हल्की होनी चाहिए, कसकर दबी हुई नहीं। ज़रूरत से ज़्यादा ज़ोरदार व्यंजन आकार एक झटकेदार, ज़्यादा एनिमेटेड क्वालिटी पैदा करते हैं, जो प्रदर्शन के बजाय सिंक पर ध्यान खींचती है।
💡 कई प्रोफ़ेशनल एनिमेटर अपनी पहली प्रवृत्ति की तुलना में व्यंजन आकारों को 30 से 50% तक जानबूझकर नरम रखते हैं। सामान्य प्लेबैक स्पीड पर यह नज़ाकत ज़्यादा स्वाभाविक लगती है।
जबड़े की हरकत भूल जाना
लिपसिंक सिर्फ़ होंठों का काम नहीं है। जबड़े की हरकत ही कैरेक्टर के बोलने के समग्र एहसास को चलाती है। ठीक से जबड़े का एनिमेशन न हो तो होंठों के आकार चाहे कितने भी सटीक हों, सिर वाला रिग किसी वेंट्रिलोक्विस्ट की गुड़िया जैसा दिखेगा। 3D रिग में जबड़े का घुमाव स्वर की तीव्रता के साथ चलना चाहिए। 2D एनिमेशन में ज़ोर वाले खुले स्वरों पर जबड़े की रेखा साफ़ नीचे आनी चाहिए।
जबड़ा मुँह के आकारों पर भौतिक सीमा भी लगाता है। चौड़ा खुला "ah" स्वर नीचे गिरे हुए जबड़े की माँग करता है। बिना संबंधित जबड़े के झुकाव के चौड़े खुले होंठ दिखाना शारीरिक रूप से गलत लगता है और महसूस भी होता है।
पॉलिश्ड नतीजों के लिए प्रो टिप्स
स्क्रैच नहीं, फ़ाइनल मिक्स पर सिंक करें
सबसे आम प्रोडक्शन गलतियों में से एक है शुरुआती स्क्रैच रिकॉर्डिंग पर लिपसिंक एनिमेट करना, और फिर बिना दोबारा सिंक जाँचे ऑडियो को फ़ाइनल मिक्स से बदल देना। स्क्रैच और फ़ाइनल रिकॉर्डिंग के बीच छोटे टाइमिंग अंतर भी (तेज़ डिलीवरी, वॉइस एक्टर की थोड़ी अलग गति) सिंक को बिगाड़ देंगे।
लिपसिंक लॉक करने से पहले हमेशा ऑडियो फ़ाइनल कर लें। अगर सिंक पूरा होने के बाद दोबारा रिकॉर्डिंग होती है, तो उसे सिर्फ़ फ़ाइल बदलना नहीं, बल्कि सिंक के काम को दोबारा करना मानें।
वॉइस एक्टर्स से रेफ़रेंस वीडियो रिकॉर्ड करें
प्रोफ़ेशनल एनिमेशन स्टूडियो रिकॉर्डिंग सेशन के दौरान नियमित रूप से वॉइस एक्टर्स का वीडियो रिकॉर्ड करते हैं, न कि सिर्फ़ ऑडियो। ये रेफ़रेंस वीडियो एनिमेटरों को असली प्रदर्शन देते हैं जिसका विश्लेषण किया जा सके: मुँह के सटीक आकार, जबड़े की हरकत की टाइमिंग, और वे छोटे शारीरिक हावभाव जो डायलॉग को जीवंत बनाते हैं।
अगर आप किसी प्रोजेक्ट पर अकेले काम कर रहे हैं, तब भी अपने फ़ोन पर खुद लाइनें बोलकर रिकॉर्ड करना और फ़ुटेज को फ़्रेम-दर-फ़्रेम देखना, अंदाज़े से कहीं ज़्यादा काम का रेफ़रेंस देता है।
फ़्रेम रेट की समझ
आपकी सिंक सटीकता आपके फ़्रेम रेट से सीमित होती है। 12fps पर हर फ़्रेम 83ms का होता है, यानी आपकी सबसे अच्छी संभव सिंक सटीकता लगभग एक फ़्रेम है, जो पहले से ही महसूस होने की सीमा पर है। 24fps पर हर फ़्रेम 42ms का है। 30fps पर 33ms।
लिपसिंक-प्रधान प्रोजेक्ट्स के लिए कम से कम 24fps पर काम करना दृढ़ता से सुझाया जाता है। जानबूझकर सीमित सौंदर्य वाली स्टाइलाइज़्ड प्रोडक्शन के लिए 12fps पर डायलॉग एनिमेट करना चल सकता है, लेकिन फिर इसे स्टाइल का हिस्सा मानते हुए दिखने वाली सिंक अशुद्धि स्वीकार करनी होगी।
अलग-अलग कैरेक्टर प्रकारों का सिंक
2D फ़्रेम-दर-फ़्रेम कैरेक्टर
पारंपरिक 2D कैरेक्टर आम तौर पर लिपसिंक के लिए रिप्लेसमेंट एनिमेशन तरीका अपनाते हैं: हर फ़ोनीम आकार के लिए अलग मुँह का चित्र, जो सही फ़्रेम पर बदला जाता है। यह कुशल है क्योंकि आप हर फ़्रेम पर मुँह दोबारा बनाने के बजाय पहले से बनाए गए आकारों की एक छोटी लाइब्रेरी का दोबारा इस्तेमाल करते हैं।
वर्कफ़्लो:
- अपने कैरेक्टर स्टाइल के लिए पूरी फ़ोनीम शेप लाइब्रेरी बनाएँ।
- ऑडियो ट्रैक को टाइमस्टैम्प के साथ फ़ोनीम इवेंट्स में तोड़ें।
- हर फ़ोनीम ऑनसेट फ़्रेम पर सही आकार का चित्र लगाएँ।
- बीच के मध्यवर्ती पोज़िशन डालकर दूर के आकारों के बीच ट्रांज़िशन को स्मूद करें।
3D रिग्ड कैरेक्टर
3D कैरेक्टर मुँह की स्थितियों के बीच मॉर्फ़ करने के लिए ब्लेंड शेप या बोन रिग इस्तेमाल करते हैं। वर्कफ़्लो अवधारणा में मिलता-जुलता है, लेकिन इसमें चित्र बदलने के बजाय रिग कंट्रोल पर वैल्यू सेट करनी होती है।
ज़्यादातर 3D एनिमेशन सॉफ़्टवेयर (Blender, Maya, Cinema 4D) में ऑडियो को कीफ़्रेम में बेक करने का तरीका होता है, जो शुरुआती फ़ोनीम प्लेसमेंट को स्वचालित करता है। नतीजे को आम तौर पर मैन्युअल सुधार चाहिए, लेकिन यह हर कीफ़्रेम हाथ से लगाने से कहीं तेज़ शुरुआत देता है।
AI-जनित और फ़ोटो कैरेक्टर
AI-जनित कैरेक्टर या जिन फ़ोटो को जीवंत किया जा रहा है, उनके लिए Omni Human 1.5 और Fabric 1.0 जैसे टूल्स सिंक जनरेशन पूरी तरह संभाल लेते हैं। वर्कफ़्लो एनिमेशन से बदलकर प्रॉम्प्ट इंजीनियरिंग और इटरेशन की ओर जाता है: यह समझना कि आपके खास कैरेक्टर स्टाइल के लिए कौन-से इनपुट सबसे अच्छी सिंक क्वालिटी देते हैं।
Prunaai का P Video Avatar कैरेक्टर इमेज से टॉकिंग अवतार वीडियो बनाने के लिए, न्यूनतम सेटअप समय में, आज़माने लायक है।
ऑटोमेशन और बड़े पैमाने पर गति
स्वचालित फ़ोनीम डिटेक्शन सॉफ़्टवेयर
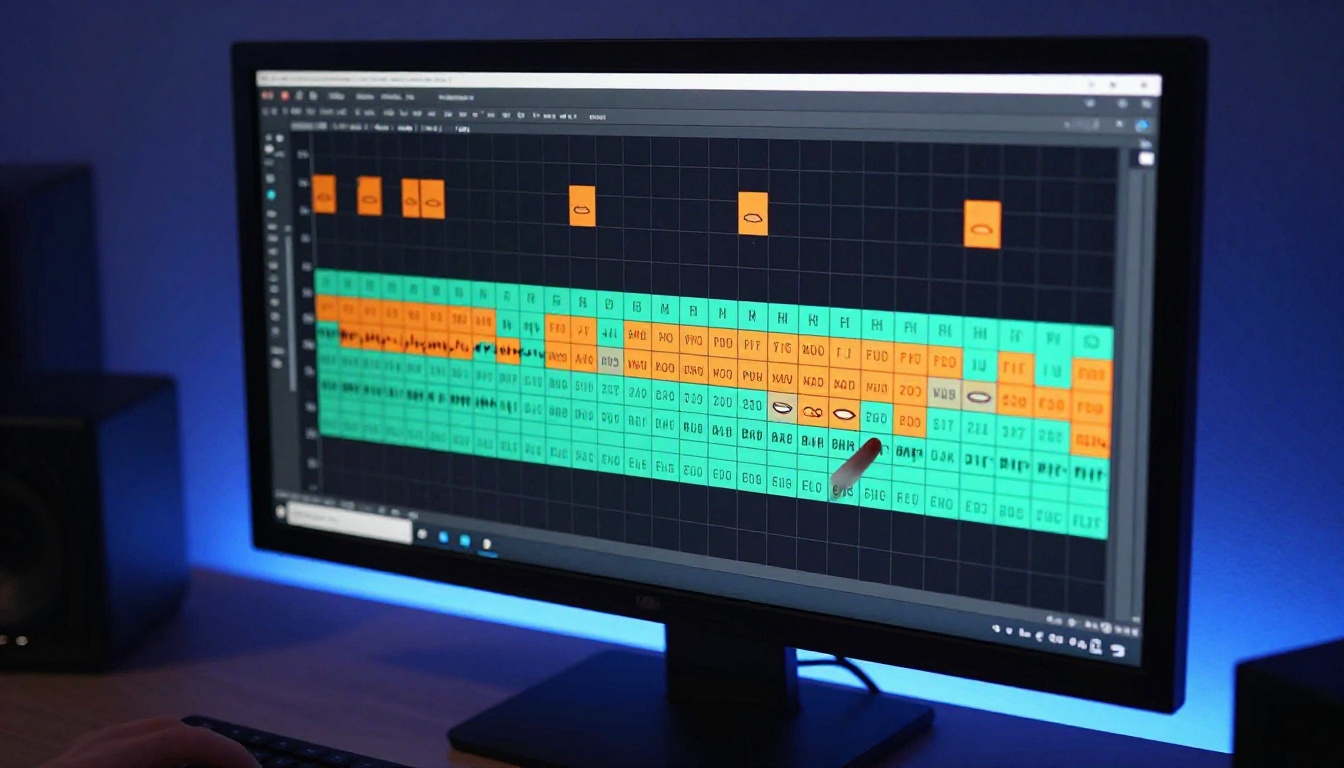
कई सॉफ़्टवेयर टूल्स किसी ऑडियो फ़ाइल में अपने-आप फ़ोनीम पहचान सकते हैं और एक टाइम्ड ब्रेकडाउन बना सकते हैं, जिसे आप कीफ़्रेमिंग के संदर्भ के रूप में इस्तेमाल कर सकते हैं। Papagayo-NG एक जाना-माना मुफ़्त विकल्प है। Adobe Character Animator में यह पहले से बना है। ऑडियो बेकिंग क्षमता वाले ज़्यादातर 3D एप्लिकेशन भी कुछ ऐसा ही करते हैं।
इन टूल्स का आउटपुट एक शुरुआती बिंदु है, तैयार उत्पाद नहीं। स्वचालित फ़ोनीम डिटेक्शन मुख्य स्वर घटनाओं और प्लोसिव को पहचानने में अच्छा है, लेकिन व्यंजन समूहों, तेज़ बोली और असामान्य उच्चारण के साथ संघर्ष करता है। स्वचालित डिटेक्शन के बाद क्लीनअप के लिए अपने मूल मैनुअल समय का 30 से 50% बजट रखें।
डबिंग और बहुभाषी सिंक
जब आपको किसी अलग भाषा के फ़ुटेज में नया डायलॉग सिंक करना हो, तो HeyGen का Video Translate जैसे AI टूल्स अनुवाद और लिपसिंक समायोजन दोनों एक साथ संभालते हैं। बहुभाषी कंटेंट बनाने वालों के लिए यह वर्कफ़्लो में बड़ा बदलाव है। जिस काम में हर भाषा में दोबारा रिकॉर्डिंग, दोबारा एडिटिंग और दोबारा एनिमेशन करना पड़ता था, वह अब अपने-आप प्रोसेस हो सकता है।
HeyGen के Lipsync Speed और Lipsync Precision सटीकता-बनाम-गति के स्पेक्ट्रम पर दो बिंदु देते हैं। Speed मोड ड्राफ़्ट समीक्षा के लिए तेज़ प्रोसेस करता है। Precision मोड धीमा है, लेकिन अंतिम आउटपुट के लिए ज़्यादा कसा हुआ फ़ोनीम सटीकता देता है।
Pixverse Lipsync उन टीमों के लिए PicassoIA पर विकल्पों को पूरा करता है जिन्हें मैन्युअल फ़्रेम काम के बिना तुरंत ऑडियो-से-वीडियो सिंक चाहिए।
सिंक क्वालिटी की अपेक्षाओं पर एक नोट
कोई भी स्वचालित टूल, AI हो या नहीं, हर तरह के इनपुट के लिए पहली बार में ही परफ़ेक्ट सिंक नहीं देता। अच्छे और बेहतरीन नतीजे के बीच का फ़ासला लगभग हमेशा समीक्षा और इटरेशन के चक्र में होता है: आउटपुट को आलोचनात्मक नज़र से देखना, उन दो-तीन फ़्रेमों की पहचान करना जो अटपटे लगते हैं, और सटीक बदलाव करना।
AI सिंक आउटपुट को उसी तरह लें जैसे एक प्रोफ़ेशनल स्वचालित फ़ोनीम डिटेक्शन को लेता है: एक मजबूत शुरुआती बिंदु जो मैन्युअल काम का 70 से 80% बचाता है, और अंतिम 20 से 30% के लिए इंसानी फ़ैसले की ज़रूरत होती है।
बोलते कैरेक्टर बनाना शुरू करें
स्वीकार्य लिपसिंक और सच में प्रभावशाली लिपसिंक के बीच का फ़ासला एक बात पर टिका है: आप ऑडियो पर कितना ध्यान देते हैं। इस लेख के हर टूल, चाहे मैनुअल कीफ़्रेमिंग तरीका हो या PicassoIA पर कोई AI मॉडल, अच्छा इनपुट देने और आउटपुट को आलोचनात्मक रूप से जाँचने पर बेहतर नतीजे देता है।
एक छोटी डायलॉग क्लिप से शुरू करें। ऑटोमेटेड सिंक बेसलाइन बनाने के लिए Lipsync 2 Pro इस्तेमाल करें, फिर उसकी वेवफ़ॉर्म से तुलना करें। नतीजे को लूप पर देखें। नोट करें कि कौन-से फ़्रेम अटपटे लगते हैं और कौन-से सही। जनरेशन, समीक्षा और समायोजन का यही चक्र असली लिपसिंक की समझ विकसित करता है।
अगर आप किसी स्थिर कैरेक्टर इमेज को तुरंत जीवंत करना चाहते हैं, तो एक छोटी ऑडियो क्लिप के साथ Omni Human 1.5 आज़माएँ। नतीजे आपको AI-सहायता वाले लिपसिंक की क्षमता और उसकी असली सीमाएँ ठोस रूप में समझा देंगे।
PicassoIA के पास लिपसिंक मॉडल की पूरी लाइब्रेरी इस्तेमाल के लिए तैयार है। चाहे आप फ़ुटेज को डब कर रहे हों, पोर्ट्रेट को एनिमेट कर रहे हों, या 3D कैरेक्टर रेंडर पर सिंक लगा रहे हों, आपके खास वर्कफ़्लो के लिए एक टूल मौजूद है। प्रयोग करें, नतीजों की तुलना करें, और लगातार सुधारते रहें। आपके कैरेक्टर इसके लिए आपका शुक्रिया अदा करेंगे।


