Tomar una sola fotografía y verla respirar, moverse y cobrar vida como un clip de video ya no es un efecto especial reservado a los estudios de Hollywood. HunyuanVideo 2.0, el último modelo de animación de imágenes de Tencent, lleva esta capacidad directamente a tu navegador, teléfono o equipo de escritorio, con un nivel de coherencia temporal y fotorrealismo que parece realmente distinto de los intentos anteriores con esta tecnología.

No se trata de crear dibujos animados ni animaciones estilizadas. HunyuanVideo 2.0 lee la información espacial contenida en una fotografía, interpreta cómo se moverían realistamente la iluminación, la perspectiva y los sujetos, y genera fotogramas de video que prolongan ese instante congelado de una forma físicamente creíble. El sujeto de un retrato gira la cabeza. Las olas del océano empiezan a romper. El horizonte de una ciudad recibe la sombra de una nube que pasa. El momento congelado se convierte en una escena viva.
Qué hace realmente HunyuanVideo 2.0
Antes de entrar en el cómo, conviene entender qué hace diferente a este modelo de la generación de herramientas de imagen a video que lo precedieron.
Interpreta el potencial de movimiento, no solo los píxeles
La mayoría de los primeros modelos de animación de imágenes trataban la fotografía de entrada como una textura que deformar. Aplicaban algoritmos de flujo óptico para simular el movimiento, lo que producía el clásico "efecto gelatina", en el que los objetos parecían derretirse o estirarse de forma antinatural de un fotograma a otro. HunyuanVideo 2.0 funciona de otra manera. Utiliza una base de generación de video basada en difusión que trata la imagen de origen como el primer fotograma de un clip coherente, y después genera los fotogramas siguientes a partir de una comprensión aprendida de cómo se comportan la física, la anatomía y el entorno del mundo real a lo largo del tiempo.
El resultado es que una fotografía de una persona no se limita a deformar la textura de su piel hacia un lado. El cabello se mueve según lo hace realmente bajo la gravedad y la resistencia del aire. Los pliegues de la tela cambian de forma coherente con el peso del material. Los elementos del fondo, como los árboles o el agua, responden al viento y a la gravedad implícitos, en lugar de estirarse o emborronarse por el encuadre.

El salto de la versión 1.0 a la 2.0
El HunyuanVideo original ya destacaba por la calidad de su generación de texto a video, con un movimiento de los más fluidos vistos en modelos de video de código abierto en el momento de su lanzamiento. La versión 2.0 amplió esto con un acondicionamiento dedicado por imagen, lo que permite ahora anclar la generación a un primer fotograma concreto. Es la función que hace que los flujos de trabajo de foto a video sean realmente prácticos, porque garantiza que el video resultante se parezca de verdad a la imagen de entrada, en lugar de usarla como una inspiración visual vaga.
La versión 2.0 también mejoró la coherencia de identidad a lo largo de toda la duración del clip. Las versiones anteriores a veces mostraban sujetos que se desviaban o se transformaban respecto a la imagen original después del primer segundo o de los dos primeros segundos del material generado. La arquitectura actualizada mantiene la identidad, la precisión del color y la composición de la escena de forma mucho más fiable durante toda la ventana de generación. Esto se nota especialmente en los retratos, donde la identidad facial es el detalle más delicado de conservar.
Qué significa ajustar las expectativas en la práctica
HunyuanVideo 2.0 no es un botón mágico. El modelo genera continuaciones verosímiles de un instante congelado, pero sigue limitado por lo que es físicamente razonable. No añadirá objetos que no estaban en el encuadre original. No puede crear cambios dramáticos de escena, cortar a un ángulo nuevo ni cambiar la hora del día. Lo que sí hace excepcionalmente bien es poner en movimiento la escena existente de una forma natural y creíble.
El punto ideal de este modelo son las fotografías con un sujeto claro, una composición sólida y cierto potencial de movimiento implícito. Una persona riéndose a mitad de carcajada, una ola a punto de romper, un ciclista en una curva, un producto con gotas de agua a punto de caer. Todo ello ya lleva una energía de movimiento que el modelo puede continuar de forma convincente.
Por qué la IA de foto a video lo cambió todo
La imagen fotográfica ha sido el medio dominante del contenido visual personal y comercial durante más de 150 años. Cada álbum de boda, archivo familiar, catálogo de productos y anuncio inmobiliario se construye con imágenes fijas. La limitación práctica siempre ha sido que las imágenes fijas son estáticas, y el contenido estático está perdiendo la batalla por la atención.

Las imágenes estáticas tenían un problema
Las plataformas sociales dan cada vez más prioridad al contenido en video en sus algoritmos. Una publicación con video logra un alcance muy superior al de la misma publicación con una fotografía en la mayoría de las plataformas principales. Pero producir video requiere equipo, tiempo, habilidades de edición y, a menudo, una segunda visita al lugar. Para la mayoría de las personas y las pequeñas empresas, producir contenido en video a partir de cada fotografía que poseen ha estado sencillamente fuera de su alcance.
La IA de foto a video cierra por completo esta brecha. Cada fotografía de tu archivo se convierte en un posible clip de video sin volver a rodar nada. Tus fotos de producto se convierten en contenido para desplazarse. Tus fotografías de viaje se transforman en momentos cinematográficos. Tus retratos pasan a ser recursos de perfil animados. Tus exteriores inmobiliarios se vuelven propiedades vivas, con luz en movimiento y detalles del entorno.
Lo que construyó Tencent
El equipo de investigación en IA de Tencent construyó HunyuanVideo sobre una arquitectura de difusión basada en transformers, entrenada con un enorme conjunto de datos de clips de video emparejados con sus primeros fotogramas correspondientes. Este enfoque de entrenamiento permitió al modelo aprender la relación estadística entre una imagen estática y la gama plausible de movimientos que podrían seguirla. Cuando introduces una fotografía, el modelo recurre a esos patrones aprendidos para generar un movimiento que es a la vez físicamente plausible y estéticamente coherente.
El modelo destaca especialmente en la zona de transición entre el sujeto principal y el fondo, que históricamente ha sido uno de los problemas más difíciles de la generación de imagen a video. Cuando un sujeto se mueve, el fondo que queda detrás debe responder siempre, revelando contenido nuevo que el sujeto ocultaba en el fotograma original. HunyuanVideo 2.0 resuelve esto con un nivel de competencia que los modelos anteriores no alcanzaban.
El lanzamiento de los pesos abiertos de HunyuanVideo lo convirtió en uno de los modelos de animación de imágenes de alta calidad más accesibles, y su integración en plataformas como PicassoIA significa que no necesitas una GPU local potente para usarlo. El cálculo se ejecuta en el servidor y el resultado llega a tu navegador.
Cómo se compara HunyuanVideo 2.0 con otros modelos
HunyuanVideo 2.0 es excelente, pero no es la única opción sólida de imagen a video disponible en este momento. Entender dónde destaca y dónde podrían serte más útiles las alternativas te ayudará a elegir la herramienta adecuada para cada proyecto.

Contrapartidas entre velocidad y calidad
La velocidad y la calidad tiran en direcciones opuestas en todos los modelos actuales de imagen a video. Los resultados de mayor calidad requieren más pasos de difusión, lo que implica tiempos de generación más largos. Los modelos más rápidos usan menos pasos o arquitecturas destiladas que sacrifican algo de detalle a cambio de velocidad.
HunyuanVideo 2.0 se sitúa en el nivel de alta calidad y velocidad moderada. No es la opción más rápida, pero para la animación de retratos, el movimiento de paisajes y el metraje de producto produce algunos de los resultados de aspecto más natural disponibles actualmente, en cualquier nivel de velocidad.
Las mejores alternativas en este momento
💡 Para la fotografía de retrato en concreto, HunyuanVideo 2.0 y Kling v2.1 producen con regularidad la animación facial más natural, con una identidad estable a lo largo de los fotogramas.
Cómo usar HunyuanVideo en PicassoIA
PicassoIA ofrece HunyuanVideo junto con más de 80 modelos de generación de video, lo que significa que puedes ejecutar el modelo en tu navegador sin instalaciones locales ni hardware GPU dedicado.

Paso a paso para imagen a video
Paso 1: Prepara tu imagen de origen
El modelo funciona mejor con fotografías que tienen sujetos claros y una composición sólida. Los retratos deben tener el rostro enfocado. Las imágenes de paisaje funcionan mejor cuando el horizonte está nivelado y el sujeto principal ocupa la mayor parte del encuadre. Evita las fotografías con artefactos de compresión digital intensos, grano excesivo por ISO altos o desenfoque por movimiento extremo en el original. Una fotografía limpia y bien expuesta le da al modelo el mayor margen de trabajo.
Paso 2: Abre HunyuanVideo en PicassoIA
Ve a la página del modelo HunyuanVideo en PicassoIA. Verás el campo para subir la imagen y la entrada del prompt de texto. Sube tu fotografía directamente desde tu dispositivo. El modelo acepta los formatos JPEG y PNG estándar.
Paso 3: Escribe tu prompt de movimiento
La imagen subida fundamenta la generación visualmente, pero el prompt de texto dirige el movimiento. No describas lo que ya aparece en la imagen. En cambio, describe lo que debe pasar durante el video. "Una brisa suave mueve el cabello, el bokeh del fondo se desplaza lentamente, una leve inclinación natural de la cabeza hacia la derecha" le da al modelo instrucciones de movimiento concretas sin contradecir el contenido visual de la foto.
Paso 4: Ajusta la configuración de generación
En la mayoría de las fotografías, los ajustes predeterminados de duración y resolución dan buenos resultados en el primer intento. Si necesitas una salida de mayor calidad y puedes esperar más, aumentar los pasos de inferencia, cuando esté disponible como opción, mejorará la coherencia temporal a costa del tiempo de generación. Empieza con los valores predeterminados y ajusta solo si el primer resultado presenta problemas de coherencia evidentes.
Paso 5: Revisa e itera
La generación de video con IA presenta una variación considerable entre una ejecución y otra. Es posible que tu primer resultado no sea exactamente lo que querías. Pequeños cambios en el prompt de movimiento, o simplemente fijar una semilla aleatoria distinta, producirán resultados claramente diferentes a partir de la misma imagen de origen. Trata la primera generación como un borrador y mejóralo a partir de ahí.
Escribir prompts que funcionan
El error más habitual con la IA de imagen a video es escribir prompts que describen el contenido visual que ya aparece en la imagen, en lugar de dirigir el movimiento. Esta es la diferencia práctica:
Prompt malo: "Una mujer con el pelo castaño largo de pie en un campo de flores"
Esto describe lo que el modelo ya puede ver. No da ninguna dirección de movimiento ni información útil.
Prompt bueno: "El cabello levantado suavemente por una brisa cálida y lenta, la sujeto desplaza ligeramente el peso hacia la derecha, las flores silvestres se mecen en primer plano, las nubes se desplazan lentamente de izquierda a derecha en el fondo, la cámara se mantiene estable"
Esto le indica al modelo qué debe cambiar con el tiempo, qué elementos deben moverse y cómo debería parecer la escena en movimiento.
💡 Los verbos de movimiento cortos y concretos siempre superan a las descripciones largas. Palabras como "deriva", "ondula", "gira", "se mece", "se eleva", "mira de reojo", "se inclina" y "se asienta" dan al modelo acciones físicas claras que generar a lo largo de los fotogramas.
5 tipos de fotos que mejor funcionan
No todas las fotografías responden igual a la generación de imagen a video. Estas cinco categorías producen buenos resultados con regularidad con HunyuanVideo 2.0 y con las alternativas disponibles en PicassoIA.
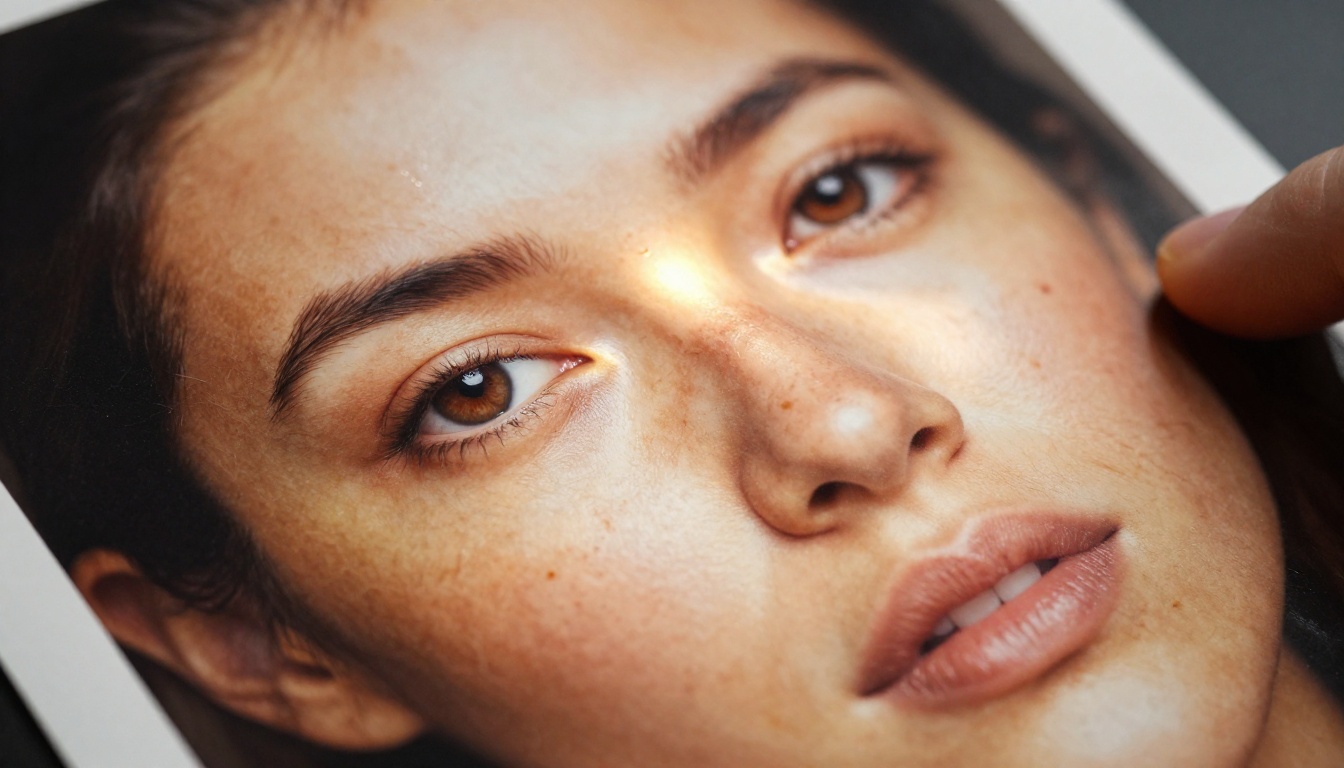
Fotos de retrato
Los retratos son el caso de uso más sólido para la animación de foto a video. Un retrato bien iluminado, con un fondo limpio o suavemente desenfocado, ofrece al modelo un sujeto aislado con una estructura anatómica clara. El modelo destaca al generar microexpresiones realistas, movimiento natural del cabello, desplazamiento de la tela y reposicionamientos sutiles de la cabeza. Usa un prompt de movimiento que especifique dirección y energía: "giro lento de cabeza hacia la izquierda, aparece una leve sonrisa, el cabello cae de forma natural sobre el hombro, se ve la respiración suave."
Paisaje y naturaleza
Los entornos naturales tienen un potencial de movimiento integrado: el agua fluye, los árboles se mueven, las nubes derivan y la luz cambia sobre el terreno. Una fotografía de paisaje con un horizonte interesante y una profundidad compositiva marcada se animará de forma convincente. Prueba Wan 2.7 I2V para animar paisajes en concreto. Maneja el movimiento del entorno, incluidos el agua corriente y el follaje que reacciona de forma realista, con una coherencia temporal muy alta a lo largo del clip generado.
Los prompts de movimiento para paisajes deben centrarse en la física del entorno: "las olas rompen y se retiran, la espuma blanca se extiende sobre la arena oscura y vuelve a retirarse, una gaviota se desplaza lentamente de derecha a izquierda por la parte superior del cielo."
Fotografía de producto y comercial
La fotografía de producto es uno de los usos de mayor valor del foto a video para las empresas. Una toma fija de producto puede convertirse en un expositor giratorio, en una demostración de un líquido que se vierte o en una escena de estilo de vida que muestra el producto en un momento de uso.
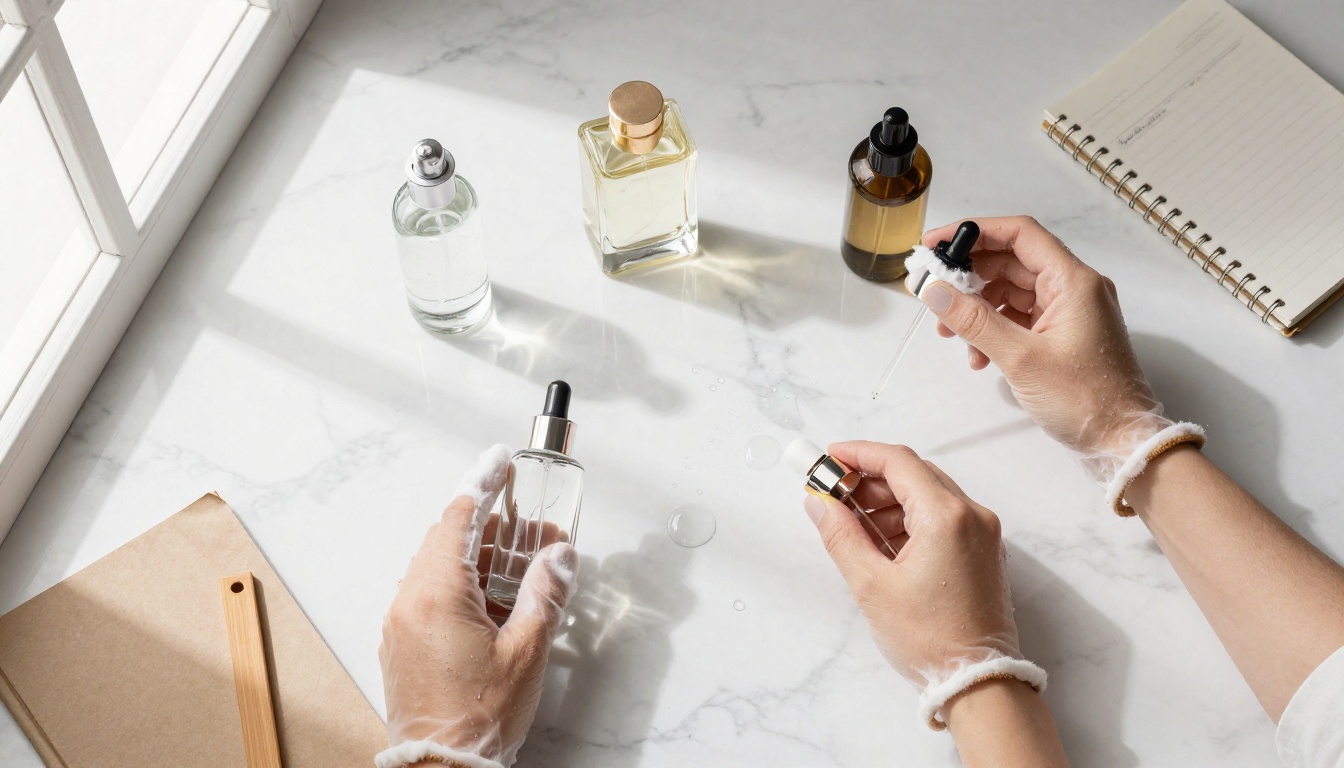
En la fotografía de producto, mantén el movimiento mínimo y deliberado. Evita los prompts que pidan movimientos de cámara dramáticos o cambios de escena a gran escala. Prueba en su lugar: "el frasco de perfume recibe un brillo lento de luz cálida que se desplaza de izquierda a derecha, las gotas de líquido sobre la superficie del cristal se asientan, la etiqueta gana un poco de nitidez al enfocarse."
P Video Animate en PicassoIA merece especialmente la pena para el contenido de producto. Es rápido, maneja bien el detalle fino de los objetos y produce resultados limpios que se adaptan al uso comercial sin una estilización excesiva.
Imágenes de arquitectura
La arquitectura ofrece grandes oportunidades para el foto a video. El movimiento de las nubes, la luz cambiante y el desplazamiento natural de personas y vehículos dentro de la escena pueden generarse de forma convincente a partir de una toma fija de exterior o interior.
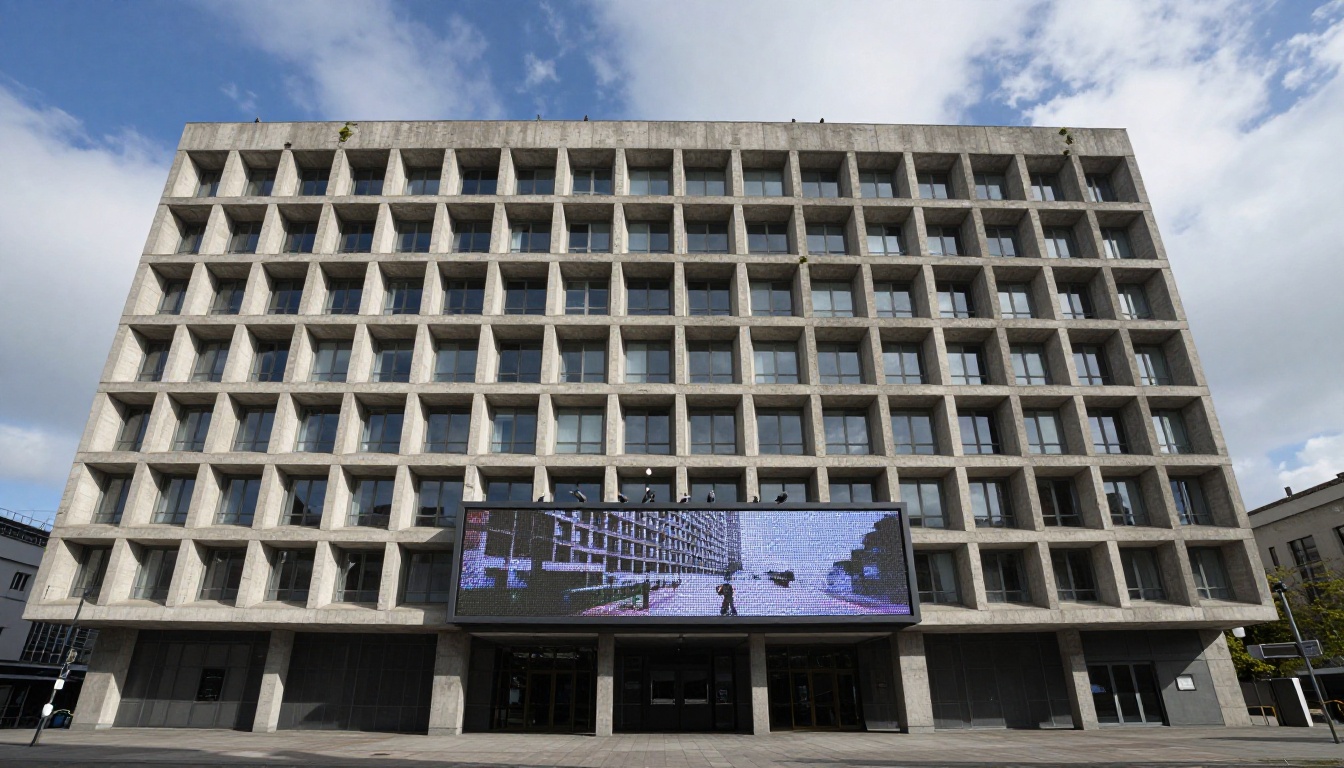
Las tomas de arquitectura con gran angular producen los resultados más satisfactorios porque hay más contenido ambiental en la escena para animar. Prueba: "las nubes se desplazan lentamente por la parte superior del encuadre, la luz de última hora de la tarde recorre la fachada de hormigón, las líneas de sombra cambian gradualmente a medida que el sol se mueve."
Fotografía callejera
La fotografía callejera es documental por naturaleza, y la animación de foto a video puede devolver la sensación de tiempo y movimiento a esos momentos congelados. El modelo puede continuar de forma convincente el movimiento implícito que ya está presente en una escena callejera detenida.
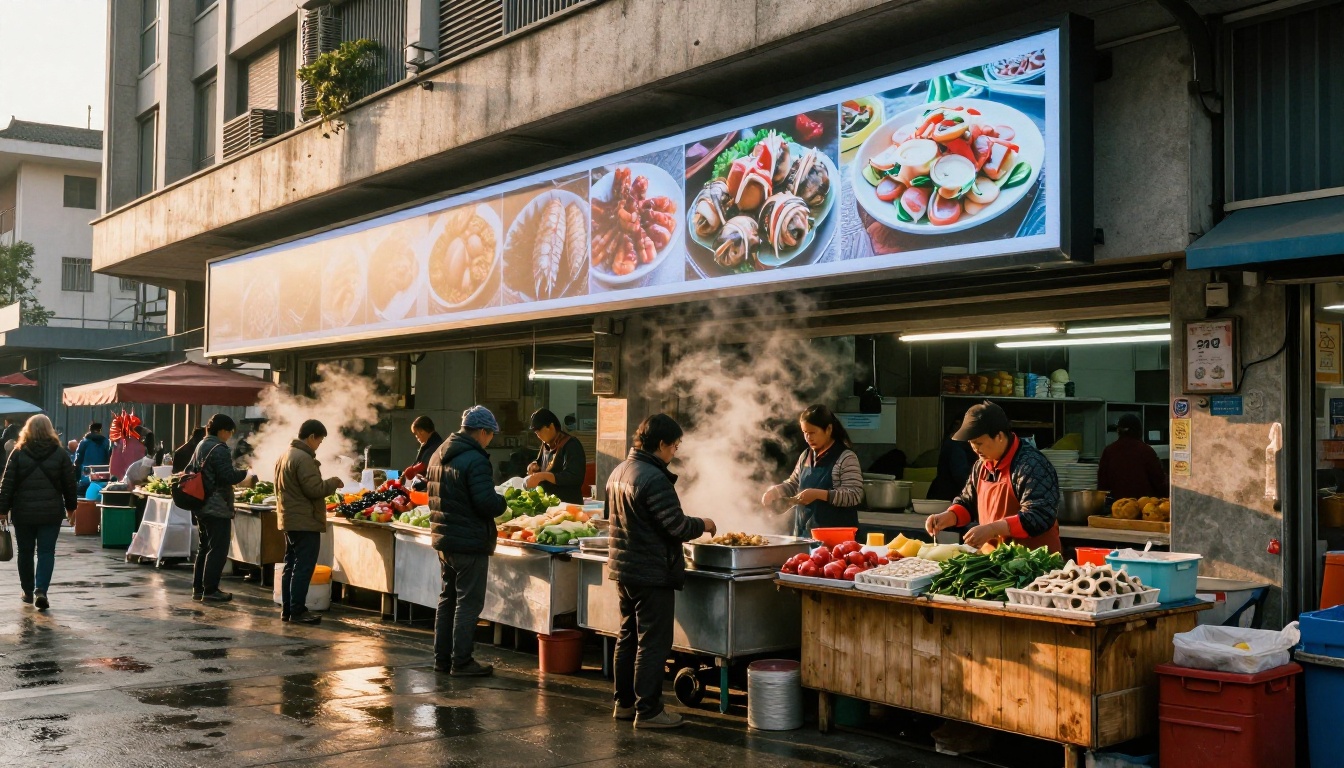
Las escenas callejeras con personas en mitad de un movimiento, vendedores trabajando o mucha actividad de mercado responden especialmente bien a la animación. Prueba Kling v3 Video para la animación callejera cinematográfica, ya que maneja escenas con varios sujetos y una fuerte coherencia temporal en distintos tipos de sujetos.
Errores habituales y cómo evitarlos
La mala calidad de entrada perjudica todos los resultados
Los artefactos de compresión JPEG, el ruido intenso de los ajustes de ISO altos y el desenfoque por movimiento de la fotografía original reducen la capacidad del modelo para interpretar la escena con precisión y generar a partir de ella un movimiento coherente. La regla es sencilla: el techo de calidad del resultado lo marca la calidad de la entrada. Si subes una fotografía específicamente para animarla, elige la versión de mayor calidad disponible. Usa el archivo original sin comprimir o con poca compresión, en lugar de una exportación de redes sociales o una captura de pantalla.
Si tu fotografía está subexpuesta, tiene ruido o está degradada de otra forma, considera pasarla antes por una herramienta de superresolución o restauración. Los modelos de superresolución y mejora disponibles en PicassoIA pueden escalar y reducir el ruido de una imagen antes de que entre en el flujo de trabajo de generación de video, y a menudo producen resultados de animación notablemente mejores a partir de la versión limpia.
Los prompts en conflicto con la imagen
El modelo mantiene la imagen como un ancla sólida para el primer fotograma, pero un prompt que intenta cambiar demasiado respecto al origen producirá un resultado confuso o incoherente. Si tu fotografía muestra a una persona mirando hacia la izquierda y tu prompt dice "el sujeto gira por completo para mirar a la cámara", el modelo tiene que reconciliar un conflicto geométrico importante. Esto suele dar lugar a artefactos de deformación, deriva de identidad o una discontinuidad visual brusca hacia la mitad del clip generado.
Mantente dentro del rango físico plausible que implica la fotografía. Si el sujeto está de perfil, anima un movimiento coherente con estar de perfil. Si la escena es diurna con luz natural, no pidas cambios de iluminación nocturna dramáticos ni una luz artificial de tono cálido. Trabaja con la imagen, no contra ella.
💡 Piensa en ello así: el modelo continúa una historia que ya está en marcha. Tu prompt de texto es la frase siguiente, no una reescritura del capítulo.
Empieza a crear tus propias animaciones de fotos
Las herramientas están disponibles, la calidad está ahí y el flujo de trabajo es lo bastante sencillo como para pasar de una fotografía a un clip de video terminado en pocos minutos. Cada fotografía que has tomado hasta ahora es ya un posible recurso de origen para contenido en video en redes sociales, canales comerciales y proyectos personales.
PicassoIA te da acceso directo a HunyuanVideo, P Video Animate, Wan 2.7 I2V, Kling v2.1, Seedance 2.0, Gen4 Turbo, Hailuo 2.3 y más de 80 otros modelos de generación de video, todos accesibles desde el navegador, sin requisitos de hardware local ni instalación de software.
Empieza con un retrato. Sube una fotografía que ya tengas, escribe un prompt de movimiento sencillo centrado en lo que debe moverse en lugar de en lo que hay en el encuadre, y ejecuta la generación. Luego prueba un paisaje y después una foto de producto. Cada fotografía te enseña algo distinto sobre cómo estos modelos leen y animan el contenido visual, y el estilo de prompt eficaz se asienta rápidamente tras unas cuantas iteraciones.
La mejor foto de tu archivo quizá ya sea tu mejor video futuro.


