Prendre une seule photographie et la voir respirer, bouger et prendre vie sous forme de clip vidéo n’est plus un effet spécial réservé aux studios hollywoodiens. HunyuanVideo 2.0, le dernier modèle d’animation d’images de Tencent, apporte cette capacité directement dans votre navigateur, sur votre téléphone ou sur votre ordinateur, avec une cohérence temporelle et un photoréalisme qui se distinguent nettement des tentatives précédentes dans ce domaine.

Il ne s’agit pas de créer des dessins animés ou des animations stylisées. HunyuanVideo 2.0 lit les informations spatiales contenues dans une photographie, interprète la manière dont la lumière, la perspective et les sujets pourraient réalistement bouger, et génère des images vidéo qui prolongent ce moment figé de façon physiquement plausible. Un sujet de portrait tourne la tête. Des vagues océanes commencent à déferler. La silhouette d’une ville capte l’ombre d’un nuage qui passe. Le moment figé devient une scène vivante.
Ce que fait réellement HunyuanVideo 2.0
Avant d’entrer dans le fonctionnement, il est utile de comprendre ce qui distingue ce modèle de la génération d’outils image vers vidéo qui l’ont précédé.
Il lit le potentiel de mouvement, pas seulement les pixels
La plupart des premiers modèles d’animation d’images traitaient la photographie d’origine comme une texture à déformer. Ils appliquaient des algorithmes de flux optique pour simuler le mouvement, ce qui produisait l’effet « gélatine » caractéristique, où les objets semblaient fondre ou s’étirer de façon non naturelle d’une image à l’autre. HunyuanVideo 2.0 fonctionne différemment. Il utilise un backbone de génération vidéo basé sur la diffusion, qui traite l’image source comme la première image d’un clip vidéo cohérent, puis génère les images suivantes grâce à une compréhension apprise de la façon dont la physique, l’anatomie et l’environnement réels se comportent dans le temps.
Le résultat est qu’une photo de personne ne voit pas simplement sa texture de peau déformée latéralement. Les cheveux bougent selon la façon dont ils bougent réellement sous l’effet de la gravité et de la résistance de l’air. Les plis du tissu se déplacent d’une manière cohérente avec le poids du matériau. Les éléments de l’arrière-plan, comme les arbres ou l’eau, réagissent au vent et à la gravité suggérés, au lieu d’être étirés ou étalés sur le cadre.

Le passage de la version 1.0 à la version 2.0
La version originale d’HunyuanVideo se distinguait déjà par la qualité de sa génération texte vers vidéo, offrant l’un des mouvements les plus fluides parmi les modèles vidéo open source de l’époque. La version 2.0 a enrichi cette approche avec un conditionnement d’image dédié, ce qui permet désormais d’ancrer la génération à une première image précise. C’est la fonctionnalité qui rend les flux de travail photo vers vidéo réellement pratiques, car elle garantit que la vidéo obtenue ressemble vraiment à l’image d’origine, au lieu de l’utiliser comme simple source d’inspiration visuelle.
La version 2.0 a également amélioré la cohérence d’identité sur toute la durée du clip. Les versions antérieures montraient parfois des sujets qui dérivaient ou se transformaient par rapport à l’image source après une seconde ou deux de séquence générée. L’architecture mise à jour préserve bien mieux l’identité, la fidélité des couleurs et la composition de la scène sur toute la fenêtre de génération. C’est particulièrement visible avec les portraits, où l’identité du visage est le détail le plus sensible à préserver.
À quoi ressemble la gestion des attentes
HunyuanVideo 2.0 n’est pas un bouton magique. Le modèle génère des prolongements plausibles d’un moment figé, mais il reste contraint par ce qui est physiquement raisonnable. Il n’ajoutera pas d’objets absents de l’image d’origine. Il ne peut pas créer de changements de scène spectaculaires, passer à un nouvel angle ou modifier le moment de la journée. Ce qu’il fait très bien, en revanche, c’est mettre en mouvement la scène existante d’une manière naturelle et crédible.
Le point idéal de ce modèle se trouve dans les photos avec un sujet clair, une composition solide et un certain potentiel de mouvement suggéré. Une personne en plein rire, une vague sur le point de déferler, un cycliste dans un virage, un produit avec des gouttes d’eau sur le point de tomber. Ces images portent déjà une énergie de mouvement que le modèle peut prolonger de façon convaincante.
Pourquoi l’IA photo vers vidéo a tout changé
L’image photographique est le support dominant du contenu visuel personnel et commercial depuis plus de 150 ans. Chaque album de mariage, chaque archive familiale, chaque catalogue produit et chaque annonce immobilière repose sur des images fixes. La limite pratique a toujours été que les images fixes sont statiques, et que le contenu statique perd la bataille de l’attention.

Les images fixes posaient un problème
Les plateformes sociales privilégient de plus en plus les contenus vidéo dans leurs algorithmes. Une publication avec une vidéo obtient une portée bien supérieure à celle de la même publication avec une photo sur la plupart des grandes plateformes. Mais produire une vidéo demande du matériel, du temps, des compétences de montage et souvent une nouvelle visite sur le lieu. Pour la plupart des particuliers et des petites entreprises, produire une vidéo à partir de chaque photo qu’ils possèdent est tout simplement resté hors de portée.
L’IA photo vers vidéo comble entièrement cet écart. Chaque photo de vos archives existantes devient un clip vidéo potentiel, sans avoir à refaire aucune prise de vue. Vos photos de produits deviennent des contenus à faire défiler. Vos photos de voyage deviennent des moments cinématographiques. Vos portraits deviennent des visuels de profil animés. Vos photos d’extérieurs immobiliers deviennent des biens qui prennent vie, avec une lumière changeante et des détails d’environnement en mouvement.
Ce que Tencent a construit
L’équipe de recherche en IA de Tencent a bâti HunyuanVideo sur une architecture de diffusion basée sur des transformers, entraînée sur un vaste jeu de données de clips vidéo associés à leurs premières images. Cette approche d’entraînement a permis au modèle d’apprendre la relation statistique entre une image statique et la gamme plausible de mouvements qui peuvent la suivre. Lorsque vous importez une photo, le modèle puise dans ces schémas appris pour générer un mouvement à la fois physiquement plausible et esthétiquement cohérent.
Le modèle excelle particulièrement dans la gestion de la zone de transition entre le sujet au premier plan et l’arrière-plan, un problème qui a longtemps été l’un des plus difficiles de la génération image vers vidéo. Lorsqu’un sujet bouge, l’arrière-plan derrière lui doit réagir de manière cohérente, en révélant de nouveaux éléments qui étaient masqués par le sujet sur l’image d’origine. HunyuanVideo 2.0 gère cela avec une compétence que les modèles précédents ne pouvaient pas égaler.
La publication en open source des poids d’HunyuanVideo en a fait l’un des modèles d’animation d’images de haute qualité les plus accessibles, et son intégration sur des plateformes comme PicassoIA signifie que vous n’avez pas besoin d’un GPU local puissant pour l’utiliser. Le calcul s’effectue côté serveur, et vous obtenez le résultat dans votre navigateur.
HunyuanVideo 2.0 est excellent, mais ce n’est pas la seule option solide de génération image vers vidéo disponible actuellement. Comprendre où il excelle et où d’autres alternatives pourraient mieux vous servir vous aidera à choisir le bon outil pour chaque projet.

Compromis entre vitesse et qualité
La vitesse et la qualité vont en sens inverse pour tous les modèles image vers vidéo actuels. Des résultats de meilleure qualité demandent davantage d’étapes de diffusion, ce qui allonge les temps de génération. Les modèles plus rapides utilisent moins d’étapes ou des architectures distillées, qui sacrifient une partie du détail en échange de la vitesse.
HunyuanVideo 2.0 se situe dans la catégorie haute qualité et vitesse modérée. Ce n’est pas l’option la plus rapide, mais pour l’animation de portraits, le mouvement de paysages et les séquences produits, il offre certains des résultats les plus naturels disponibles actuellement, toutes vitesses confondues.
Les meilleures alternatives du moment
| Modèle | Idéal pour | Vitesse | Qualité de sortie |
|---|
| HunyuanVideo | Portraits, mouvement naturel | Moyenne | Excellente |
| P Video Animate | Animation photo générale | Rapide | Très bonne |
| Wan 2.7 I2V | Animation de paysages en HD | Moyenne | Excellente |
| Kling v2.1 | Photo vers vidéo cinématographique | Moyenne | Excellente |
| Wan 2.6 I2V | Animation de scènes et d’environnements | Rapide | Très bonne |
| Video 01 Live | Animation d’images fixes | Rapide | Bonne |
| Grok Imagine R2V | Vidéo à partir d’une photo de référence | Rapide | Bonne |
| Hailuo 2.3 | Mouvement dramatique cinématographique | Moyenne | Excellente |
| Kling v3 Video | Scènes de rue à plusieurs sujets | Moyenne | Excellente |
💡 Pour la photographie de portrait en particulier, HunyuanVideo 2.0 et Kling v2.1 produisent systématiquement l’animation faciale la plus naturelle, avec une identité stable d’une image à l’autre.
PicassoIA héberge HunyuanVideo aux côtés de plus de 80 autres modèles de génération de vidéos, ce qui vous permet d’exécuter le modèle dans votre navigateur, sans installation locale ni matériel GPU dédié.

Étape par étape pour l’image vers vidéo
Étape 1 : préparez votre image source
Le modèle donne les meilleurs résultats avec des photographies à sujet clair et à composition solide. Pour les portraits, le visage doit être net. Pour les paysages, l’horizon doit être droit et le sujet principal doit occuper l’essentiel du cadre. Évitez les photos présentant des artefacts de compression numérique marqués, un grain excessif dû à des réglages ISO élevés ou un flou de bougé important dans l’original. Une photographie propre et bien exposée donne au modèle le meilleur matériau de travail.
Étape 2 : ouvrez HunyuanVideo sur PicassoIA
Rendez-vous sur la page du modèle HunyuanVideo sur PicassoIA. Vous verrez le champ d’import d’image et la zone de saisie du prompt texte. Importez directement votre photo depuis votre appareil. Le modèle accepte les formats JPEG et PNG standard.
Étape 3 : rédigez votre prompt de mouvement
L’image importée ancre visuellement la génération, mais le prompt texte dirige le mouvement. Ne décrivez pas ce qui figure déjà sur l’image. Décrivez plutôt ce qui doit se passer pendant la vidéo. « Une brise légère traverse les cheveux, le bokeh de l’arrière-plan glisse lentement, légère inclinaison naturelle de la tête vers la droite » donne au modèle des instructions de mouvement précises, sans entrer en conflit avec le contenu visuel de la photo.
Étape 4 : ajustez les réglages de génération
Pour la plupart des photos, les réglages de durée et de résolution par défaut donnent de bons résultats dès la première tentative. Si vous avez besoin d’une sortie de meilleure qualité et que vous pouvez patienter davantage, augmenter le nombre d’étapes d’inférence, lorsque cette option est disponible, améliorera la cohérence temporelle au prix d’un temps de génération plus long. Commencez avec les valeurs par défaut et ne modifiez les réglages que si le premier résultat présente des problèmes de cohérence évidents.
Étape 5 : examinez et itérez
La génération de vidéos par IA entraîne des variations importantes d’une exécution à l’autre. Votre première sortie ne correspondra peut-être pas exactement à ce que vous souhaitiez. De petites modifications du prompt de mouvement, ou simplement le choix d’un autre seed aléatoire, produiront des résultats nettement différents à partir de la même image source. Considérez la première génération comme un brouillon et itérez à partir de là.
Rédiger des prompts qui fonctionnent
L’erreur la plus courante avec l’IA image vers vidéo consiste à rédiger des prompts qui décrivent le contenu visuel déjà présent dans l’image, au lieu de diriger le mouvement. Voici la différence concrète :
Mauvais prompt : « Une femme aux longs cheveux bruns debout dans un champ de fleurs »
Cela décrit ce que le modèle voit déjà. Cela ne donne aucune direction de mouvement et aucune information utile.
Bon prompt : « Cheveux doucement soulevés par une brise chaude et lente, le sujet déplace légèrement son poids vers la droite, des fleurs sauvages ondulent au premier plan, des nuages dérivent lentement de gauche à droite en arrière-plan, la caméra reste immobile »
Cela indique au modèle ce qui doit changer dans le temps, quels éléments doivent bouger et comment la scène doit paraître en mouvement.
💡 Des verbes de mouvement courts et précis battent toujours les descriptions longues. Des mots comme « dérive », « ondule », « tourne », « ondoie », « se lève », « jette un regard », « s’incline » et « se pose » donnent au modèle des actions physiques claires à générer d’une image à l’autre.
5 types de photos qui fonctionnent le mieux
Toutes les photographies ne réagissent pas de la même manière à la génération image vers vidéo. Ces cinq catégories produisent systématiquement de bons résultats avec HunyuanVideo 2.0 et les alternatives disponibles sur PicassoIA.
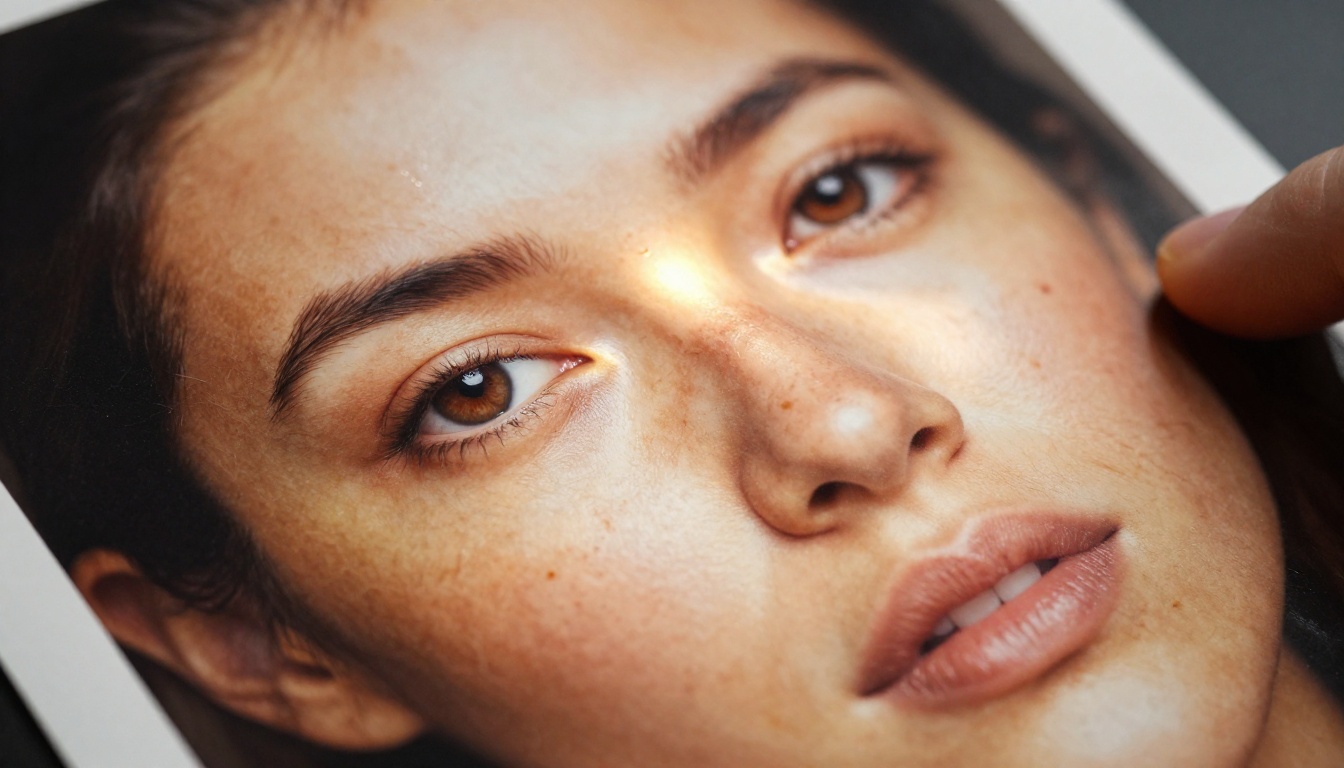
Portraits
Les portraits sont le cas d’usage le plus fort de l’animation photo vers vidéo. Un portrait bien éclairé, avec un arrière-plan propre ou doucement flou, offre au modèle un sujet isolé à la structure anatomique claire. Le modèle excelle dans la génération de micro-expressions réalistes, de mouvements naturels des cheveux, de plis de tissu qui se déplacent et de légers repositionnements de la tête. Utilisez un prompt de mouvement qui précise la direction et l’énergie : « lente rotation de la tête vers la gauche, léger sourire qui se dessine, cheveux qui retombent naturellement sur l’épaule, respiration légèrement visible. »
Paysages et nature
Les environnements naturels portent un potentiel de mouvement intégré : l’eau coule, les arbres bougent, les nuages dérivent et la lumière glisse sur le terrain. Une photo de paysage avec un horizon intéressant et une profondeur de composition marquée s’animera de façon convaincante. Essayez Wan 2.7 I2V pour l’animation de paysages en particulier. Il gère le mouvement de l’environnement, y compris l’eau qui coule et le feuillage réactif, avec une très grande cohérence temporelle sur l’ensemble du clip généré.
Les prompts de mouvement pour les paysages doivent se concentrer sur la physique de l’environnement : « les vagues se brisent puis se retirent, une mousse blanche s’étale sur le sable sombre avant de reculer, une mouette glisse lentement de droite à gauche dans le haut du ciel. »
Photographie produit et commerciale
La photographie produit est l’un des usages à plus forte valeur ajoutée de la photo vers vidéo pour les entreprises. Une simple photo de produit peut devenir un présentoir rotatif, une démonstration de versement de liquide ou une scène de vie montrant le produit en pleine utilisation.
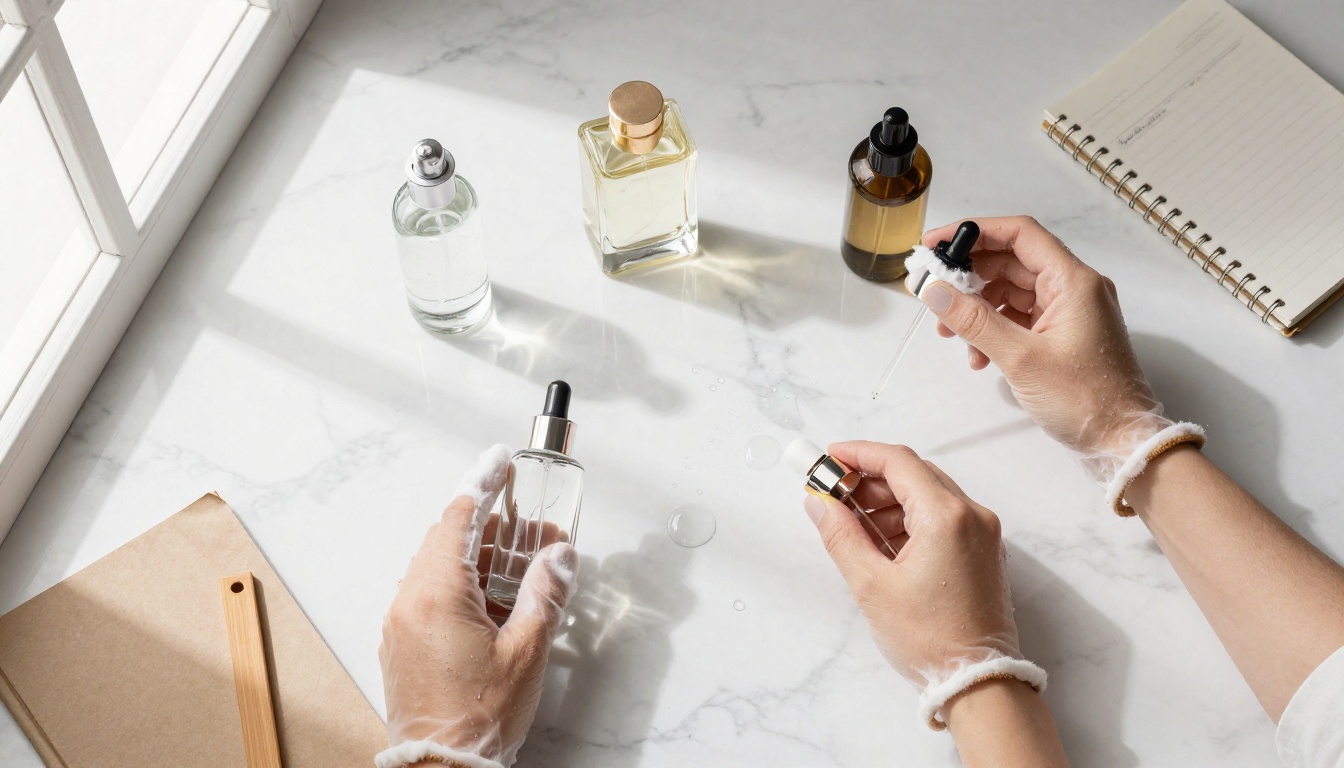
Pour la photographie produit, gardez un mouvement minimal et maîtrisé. Évitez les prompts qui demandent des mouvements de caméra spectaculaires ou des changements de scène à grande échelle. Essayez plutôt : « le flacon de parfum capte un léger reflet de lumière chaude qui glisse de gauche à droite, les gouttelettes de liquide sur la surface du verre se posent, l’étiquette gagne légèrement en netteté. »
P Video Animate sur PicassoIA mérite particulièrement d’être testé pour les contenus produits. Il est rapide, gère bien les détails fins des objets et produit des rendus propres, adaptés à un usage commercial sans stylisation excessive.
Images d’architecture
L’architecture offre de belles opportunités pour la photo vers vidéo. Le mouvement des nuages, la lumière changeante et le déplacement naturel des personnes et des véhicules dans la scène peuvent tous être générés de façon convaincante à partir d’une prise de vue statique, en extérieur ou en intérieur.
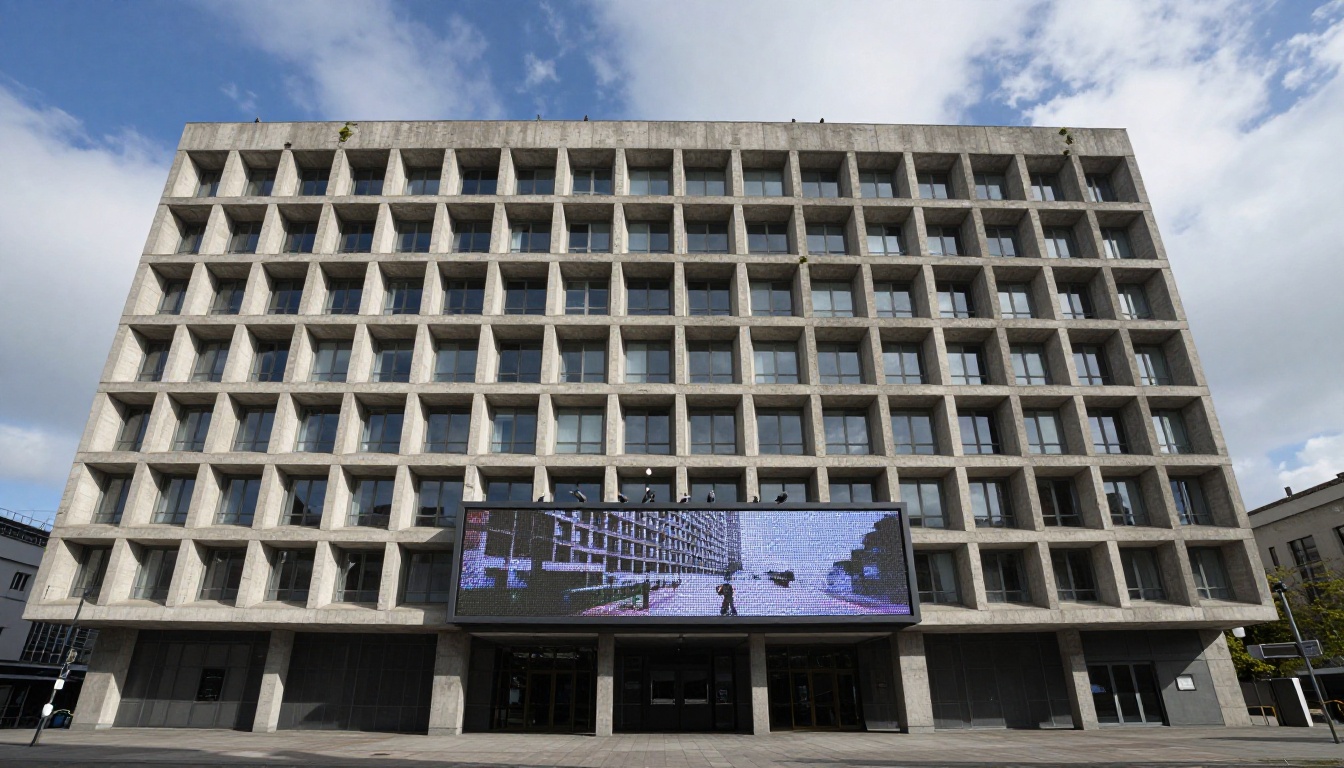
Les prises de vue architecturales en grand angle donnent les résultats les plus satisfaisants, car la scène contient davantage d’éléments d’ambiance que le modèle peut animer. Essayez : « les nuages dérivent lentement sur la partie haute du cadre, la lumière de fin d’après-midi rase la façade en béton, les lignes d’ombre se déplacent progressivement à mesure que le soleil avance. »
Photographie de rue
La photographie de rue est par nature documentaire, et l’animation photo vers vidéo peut restituer un sentiment de temps et de mouvement à ces instants figés. Le modèle peut prolonger de façon convaincante le mouvement suggéré déjà présent dans une scène de rue figée.
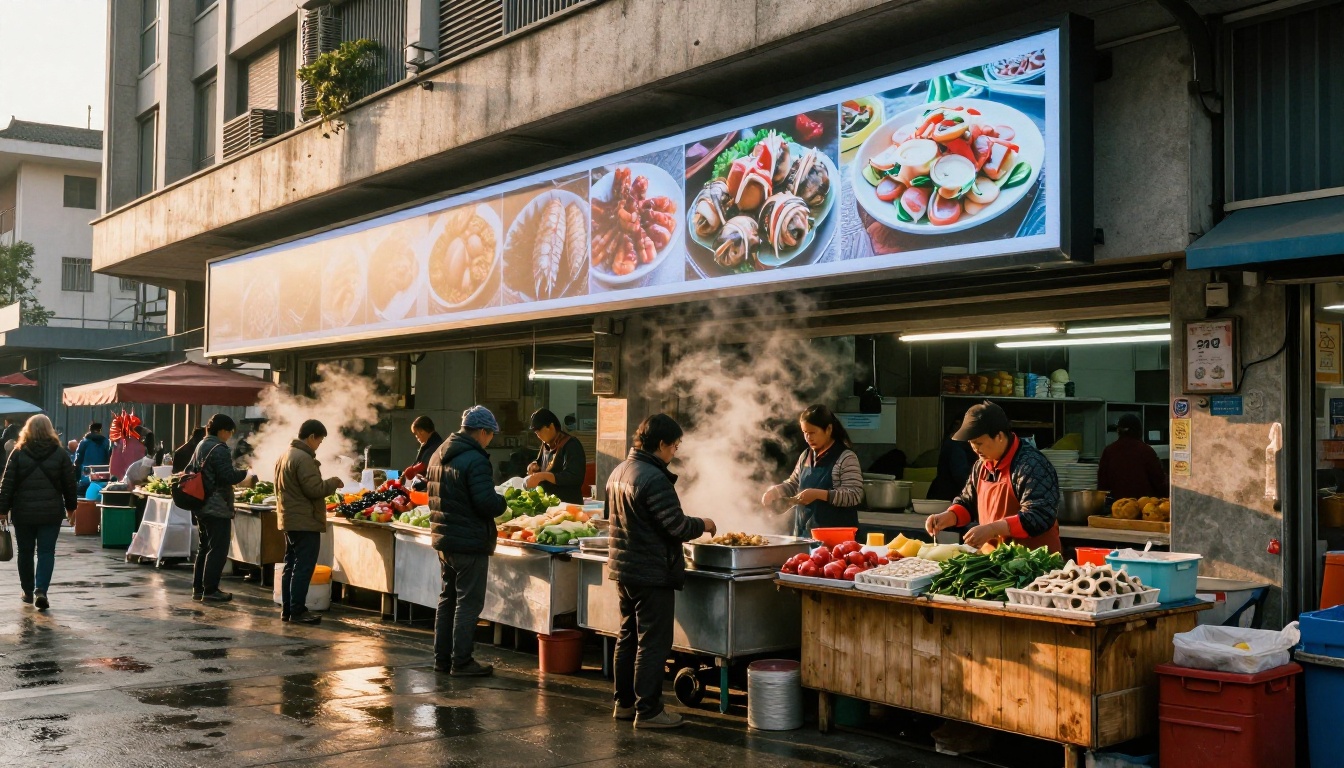
Les scènes de rue avec des personnes en plein mouvement, des commerçants au travail ou une activité de marché intense réagissent particulièrement bien à l’animation. Essayez Kling v3 Video pour l’animation de rue cinématographique, car il gère les scènes à plusieurs sujets avec une forte cohérence temporelle pour toutes sortes de sujets.
Une mauvaise qualité d’entrée dégrade chaque résultat
Les artefacts de compression JPEG, le bruit important dû aux réglages ISO élevés et le flou de bougé présent dans la photo d’origine réduisent tous la capacité du modèle à lire correctement la scène et à générer un mouvement cohérent. La règle est simple : la qualité maximale du résultat est fixée par la qualité de l’entrée. Si vous importez une photo précisément pour l’animer, choisissez la version de meilleure qualité disponible. Utilisez le fichier original non compressé ou peu compressé, plutôt qu’un export de réseau social ou une capture d’écran.
Si votre photo est sous-exposée, bruitée ou autrement dégradée, envisagez d’abord de la passer dans un outil de super-résolution ou de restauration. Les modèles de super-résolution et d’amélioration disponibles sur PicassoIA peuvent augmenter la résolution et réduire le bruit d’une image avant qu’elle n’entre dans le flux de génération vidéo, produisant souvent des animations nettement meilleures à partir de la version nettoyée.
Les prompts en conflit avec l’image
Le modèle utilise l’image comme ancrage solide pour la première image, mais un prompt qui tente de trop s’éloigner de la source produira un résultat confus ou incohérent. Si votre photo montre une personne regardant vers la gauche et que votre prompt indique « le sujet se tourne entièrement vers la caméra », le modèle doit concilier un conflit géométrique important. Cela aboutit généralement à des artefacts de déformation, à une dérive d’identité ou à une rupture visuelle brutale en cours de clip.
Restez dans la plage physique plausible suggérée par la photo. Si le sujet est de profil, animez un mouvement cohérent avec un profil. Si la scène se déroule de jour, à la lumière naturelle, ne demandez pas de changements d’éclairage nocturne spectaculaires ni une lumière artificielle à la dominante chaude forcée. Travaillez avec l’image plutôt que contre elle.
💡 Voyez les choses ainsi : le modèle prolonge une histoire déjà en cours. Votre prompt texte est la phrase suivante, pas une réécriture du chapitre.
Commencez à créer vos propres animations de photos
Les outils sont disponibles, la qualité est au rendez-vous et le flux de travail est suffisamment simple pour passer d’une photo à un clip vidéo fini en quelques minutes. Chaque photo que vous avez prise jusqu’ici est désormais un matériau source potentiel pour des contenus vidéo destinés aux réseaux sociaux, aux canaux commerciaux et à vos projets personnels.
PicassoIA vous donne un accès direct à HunyuanVideo, P Video Animate, Wan 2.7 I2V, Kling v2.1, Seedance 2.0, Gen4 Turbo, Hailuo 2.3 et plus de 80 autres modèles de génération de vidéos, tous accessibles dans un navigateur, sans configuration matérielle locale ni installation de logiciel.
Commencez par un portrait. Importez une photo que vous avez déjà, rédigez un prompt de mouvement simple centré sur ce qui doit bouger plutôt que sur ce qui se trouve dans le cadre, puis lancez la génération. Essayez ensuite un paysage, puis une photo produit. Chaque photo vous apprend quelque chose de différent sur la manière dont ces modèles lisent et animent le contenu visuel, et le style de prompt efficace se met en place rapidement après quelques itérations.
La meilleure photo de vos archives est peut-être déjà votre meilleure future vidéo.


