El sonido siempre ha sido la mitad olvidada del video. Podías construir una escena perfecta, con imágenes impresionantes, pero en cuanto la reproducías en silencio, algo fallaba. Esa carencia, la ausencia de sonido donde debería haberlo, fue durante años la limitación definitoria de la generación de video con IA. Veo 3.1 cierra esa brecha de una forma que se parece menos a una actualización de funciones y más a un cambio profundo en lo que la generación de video con IA es realmente.
Qué cambió entre Veo 3 y 3.1
El sonido siempre fue el eslabón débil
El Veo 3 original introdujo la generación de audio nativo en la línea de video con IA de Google, y en su momento resultó realmente impresionante. Pero los primeros usuarios notaron irregularidades. Una escena con olas rompiendo podía sonar demasiado limpia, demasiado uniforme, sin la superposición caótica del oleaje real. Una persona riendo en un video a menudo tenía un audio que no coincidía del todo con el momento en que se movía la boca. No eran fallos catastróficos, pero sí lo bastante evidentes como para requerir correcciones en postproducción.
Veo 3.1 no se limita a corregir esos problemas. Replantea desde cero la relación entre la generación visual y la generación de audio. El modelo trata el sonido como una salida de igual importancia, no como un añadido puesto encima de fotogramas de video ya terminados.
Tres capas de audio que Veo 3.1 puede manejar
Lo que hace que el audio de Veo 3.1 sea útil en la práctica es que trabaja con tres categorías de audio distintas al mismo tiempo:
- Paisajes sonoros ambientales: audio ambiental de fondo como viento, lluvia, tráfico, multitudes y naturaleza
- Diálogos y voz: palabras habladas, reacciones, risas y sonidos humanos no verbales
- Música diegética: música que se origina dentro de la propia escena, como una radio encendida o un músico que actúa en pantalla
Estos no son modos separados entre los que cambias. Veo 3.1 combina las tres capas en tiempo real según lo que entiende del contexto visual. Una escena con un músico callejero tocando cerca de una cafetería en una tarde lluviosa superpondrá a la vez el ambiente de lluvia, el murmullo de la gente y la actuación musical en directo, cada elemento con un volumen relativo adecuado.
Cómo funciona realmente la generación de audio
Parte del contexto, no de una base de datos
La mayoría de las primeras herramientas de audio con IA funcionaban emparejando el contenido visual con una base de datos de sonidos pregrabados. Obtenías un clip de "lluvia" o de "multitud" que sonaba razonable, pero nunca del todo bien, porque por naturaleza era genérico. Veo 3.1 sigue un enfoque fundamentalmente distinto.
El modelo genera el audio de la misma forma que genera el video: prediciendo qué debería venir después, con todo lo que entiende de la escena. No busca un "sonido de lluvia". Infiere cómo debería sonar la lluvia según la densidad de las nubes, la superficie sobre la que cae, si se trata de una llovizna ligera o de un aguacero, y la distancia de la cámara virtual respecto a la acción.
💡 Por eso el audio de Veo 3.1 suele sonar más preciso que el Foley hecho a mano en producciones de bajo presupuesto. El modelo ha absorbido patrones de una enorme cantidad de video real con sonido sincronizado, y aprende no solo cómo suenan las cosas, sino por qué suenan como suenan.
Razonamiento sonoro basado en la física
Uno de los aspectos técnicamente más impresionantes del pipeline de audio de Veo 3.1 es lo que los investigadores describen como modelado físico implícito. El modelo ha aprendido correlaciones profundas entre propiedades físicas y sus huellas sonoras.
El agua que golpea superficies distintas produce sonidos diferentes. Los pasos sobre grava, moqueta o madera dura tienen texturas distintas. Una puerta que se cierra en un baño pequeño con azulejos resuena de forma diferente a una que se cierra en un dormitorio con moqueta. Veo 3.1 detecta pistas visuales en la escena generada, como los materiales de las paredes, las proporciones de la habitación y las propiedades superficiales de los objetos, y las usa para dar forma a la salida acústica en consecuencia.
Esto produce una especie de realismo acústico que antes solo se conseguía con un trabajo profesional de diseño de sonido.
El papel de la alineación temporal
Lograr que el audio coincida con los visuales con precisión en el tiempo es, quizá, más difícil que hacer que suene bien en primer lugar. Un aplauso que llega medio segundo tarde, o una palabra que no se sincroniza con los labios en movimiento, rompe de inmediato la ilusión de realidad.
Veo 3.1 aborda esto mediante un enfoque de entrenamiento conjunto en el que los tokens visuales y los tokens de audio se generan en estrecha coordinación. En lugar de producir primero los fotogramas de video y asignar el audio después, el modelo construye ambas representaciones de forma simultánea durante la inferencia. El resultado es una sincronización de audio precisa por fotograma que se mantiene incluso en secuencias de mucho movimiento o de acción intensa.
Audio real que suena bien
Paisajes sonoros ambientales
Aquí es donde Veo 3.1 impresiona siempre más. El audio ambiental es el más difícil de falsear, porque los humanos estamos familiarizados de forma inconsciente con cómo suenan los lugares. Un bosque al amanecer suena distinto que ese mismo bosque al mediodía. Una playa en verano suena distinta que esa misma playa bajo un cielo nublado en otoño.
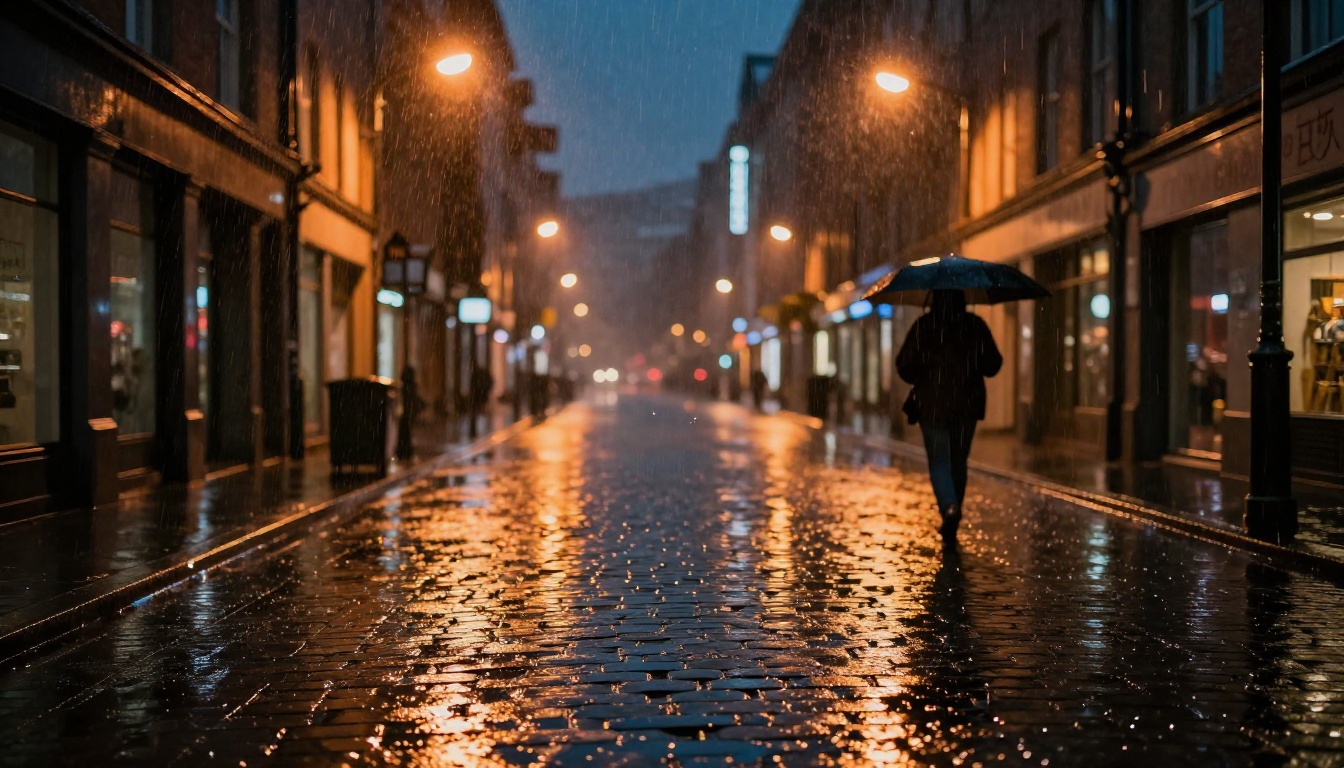
El modelo maneja estas diferencias con un nivel de matiz que las herramientas de video con IA anteriores no podían igualar. Un prompt que describe "una calle tranquila de una ciudad europea justo después de la lluvia" producirá un audio que incluye el carácter acústico concreto de la piedra mojada, el tráfico lejano filtrado entre los huecos de los edificios y el sonido ocasional de agua goteando de un toldo de lona, y no solo un clip genérico de "ambiente exterior".
Esa especificidad es lo que separa el resultado de Veo 3.1 de cualquier cosa que existiera antes en la generación de video con IA.
Voz humana y diálogo
Cuando una escena contiene personajes que parecen estar hablando, Veo 3.1 genera un audio que coincide con sus movimientos de boca y su registro emocional. En escenas en las que el contenido hablado concreto no forma parte del prompt, el modelo produce un audio a nivel de fonema que crea una impresión convincente de conversación sin generar un idioma identificable.
En escenas en las que las palabras habladas o la entrega emocional se especifican en el prompt, el modelo intenta ajustar la interpretación visual del hablante al ritmo y la cadencia del audio. La precisión aquí depende en gran medida de lo específico que sea el prompt. Los prompts vagos producen resultados aproximados. Los prompts detallados que describen el tono, el ritmo y el estado emocional producen una sincronización notablemente mejor.
💡 Consejo para el prompt: al escribir prompts para escenas con diálogo, especifica el trasfondo emocional en lugar de las palabras literales. "Una mujer que habla en voz baja y con urgencia a alguien al otro lado de una mesa de cafetería" producirá resultados mejor sincronizados que simplemente "dos personas hablando".
Música que encaja con el ambiente
La música diegética, es decir, la música que se origina dentro de la propia escena, se maneja con especial elegancia en Veo 3.1. Una escena en la que alguien toca la guitarra en un porche generará un audio que coincide con el estilo de interpretación aparente, ya sea con rasgueo de dedos o con púa, lento o animado. Una escena con un tocadiscos visible producirá un audio adecuado al género aparente y a la época aproximada que sugiere el contexto visual.
La música de fondo no diegética queda, por ahora, fuera del alcance principal de Veo 3.1. Pero para el contenido en el que la música debe venir de dentro del encuadre, la calidad de sincronización es realmente notable, y representa una de las mejoras más claras respecto a Veo 3.
Cómo usar Veo 3.1 en PicassoIA
Veo 3.1 está disponible directamente en PicassoIA junto con su variante más rápida, Veo 3.1 Fast, que sacrifica una pequeña parte de la fidelidad del audio a cambio de un tiempo de generación considerablemente menor. Así puedes obtener buenos resultados con ambos.
Preparar tu primer prompt
Paso 1: abre la página del modelo Veo 3.1 en PicassoIA.
Paso 2: escribe tu prompt de texto con indicaciones de audio explícitas incluidas. No des por hecho que el modelo inferirá el sonido solo a partir de lo visual. Menciona los elementos sonoros directamente como parte de la descripción de la escena.
Ejemplo de prompt: "Una mujer de treinta y tantos años camina por una calle de París empapada de lluvia al atardecer. El sonido de sus tacones sobre los adoquines mojados, el tráfico lejano filtrado entre los edificios y un músico callejero tocando el acordeón desde un portal a cincuenta metros."
Paso 3: selecciona la duración y la resolución que prefieras. Para mantener la coherencia del audio, los clips de 8 segundos o más dan al modelo más contexto temporal para mantener un diseño sonoro coherente a lo largo de todo el clip.
Paso 4: revisa el resultado. Comprueba que los eventos visuales coincidan con sus sonidos correspondientes. La sincronización de Veo 3.1 es sólida, pero los prompts inusuales o muy complejos pueden producir de forma ocasional pequeños desajustes de tiempo.
Paso 5: si la sincronización del audio no es del todo correcta, refina tu prompt para especificar con más detalle el momento y la causa física de los sonidos dentro de la escena.
Consejos para mejores resultados de audio
| Técnica | Por qué funciona |
|---|
| Nombra materiales concretos en la escena | El modelo usa las propiedades de las superficies para calcular la respuesta acústica |
| Describe con detalle la habitación o el espacio exterior | Los patrones de reverberación y eco dependen mucho del contexto espacial |
| Especifica la hora del día y las condiciones meteorológicas | Los perfiles de sonido ambiental cambian de forma notable según el estado del entorno |
| Incluye el comportamiento humano y el lenguaje corporal | La postura, los gestos y el movimiento de la boca informan la voz y la salida sonora |
| Evita paisajes sonoros demasiado llenos en un solo prompt | Varias fuentes de audio en competencia reducen la claridad de cada elemento |
| Usa Veo 3.1 Fast para iterar rápido | Prueba variaciones del prompt con rapidez y luego cambia a Veo 3.1 completo para el resultado final |
Veo 3.1 frente a otros modelos de video con IA que generan audio
Varios otros modelos ya ofrecen audio nativo o lo están incorporando activamente. Así se comparan en el uso práctico en las categorías que más importan.
La distancia entre Veo 3.1 y el resto del sector es considerable, sobre todo en el sonido ambiental y el audio diegético. La mayoría de los modelos de video con IA de la generación actual todavía producen salidas silenciosas o solo ofrecen una correspondencia de sonido básica. El salto de Veo 3 a 3.1 es significativo, pero incremental. La historia más importante es la ventaja que ambos modelos Veo le sacan a las alternativas que todavía no han apostado por la generación de video con prioridad al audio.
Cuando la generación de audio todavía tiene dificultades
Veo 3.1 impresiona en la mayoría de los casos de uso, pero conocer sus límites actuales te ayuda a planificar en torno a ellos de forma eficaz.
Paisajes sonoros con mucha gente
Cuando una escena contiene muchas fuentes de sonido simultáneas, como un mercado concurrido, una multitud en un festival o una secuencia de acción caótica con múltiples colisiones, el modelo tiende a producir una impresión sonora verosímil del entorno en lugar de superponer cada evento de audio distinto de forma auténtica. Obtienes una sensación global convincente de un lugar abarrotado, pero no la complejidad real de muchos sonidos individuales superpuestos, cada uno renderizado con plena fidelidad.
Cómo sortearlo: usa clips consecutivos más cortos para establecer cada elemento sonoro por separado. Un plano general inicial de un mercado, seguido de un primer plano de un puesto concreto, producirá un audio más detallado que intentar capturarlo todo en una sola generación.
Tiempo musical preciso
Cuando una escena incluye una interpretación musical sincronizada, como un batería marcando un patrón de compás concreto o un pianista tocando una melodía reconocible, el modelo maneja bien la impresión general de musicalidad, pero puede tener dificultades con el tiempo exacto de las notas, sobre todo en clips de más de diez segundos.
Conviene tenerlo en cuenta antes de usar Veo 3.1 para contenido de videoclip que requiera una sincronización de compás precisa. Para esos casos concretos, generar la pista visual por separado y sincronizar el audio manualmente en postproducción sigue dando resultados más fiables.
💡 Para la generación de música con IA sin video, PicassoIA también ofrece modelos especializados de generación de música con IA que crean bandas sonoras completas a partir de prompts de texto, que luego puedes combinar con tus videos de Veo 3.1 para un control creativo total.
Empieza a crear en PicassoIA
Lo más significativo de la capacidad de audio de Veo 3.1 no es la tecnología en sí. Es lo que supone para quién puede crear contenido de video de alta calidad. Antes, el diseño de sonido requería herramientas específicas, conocimientos especializados y, a menudo, a un profesional aparte. Veo 3.1 reúne todo ese proceso en un único prompt de texto.
Eso cambia la economía de la producción de video de una forma real y práctica. Un creador de redes sociales, un pequeño empresario o un cineasta independiente pueden producir hoy contenido de video con audio ambiental de calidad profesional sin un estudio de sonido, sin un artista de Foley ni un software de edición de audio. Lo que antes requería un flujo de postproducción ahora puede ocurrir en el mismo paso de generación que los visuales.
PicassoIA te da acceso tanto a Veo 3.1 como a Veo 3.1 Fast, junto con más de 87 otros modelos de generación de video, entre ellos Kling v3 Video, Wan 2.6 T2V y Hailuo 02. Puedes comparar resultados entre modelos, probar distintos enfoques de prompt y encontrar la combinación adecuada para tus necesidades creativas concretas.
Si todavía no has probado la generación de video con IA con audio nativo, ahora es el momento adecuado para empezar. Escribe una descripción detallada de la escena, incluye indicaciones de audio explícitas en tu prompt y mira lo que produce Veo 3.1. Los resultados suelen sorprender incluso a creadores de video experimentados que están acostumbrados a las limitaciones de las herramientas de IA anteriores.
La distancia entre lo que puede producir un prompt de texto y lo que requiere una producción profesional completa se está acortando rápidamente. Veo 3.1 es una razón importante de ello.