साउंड हमेशा से वीडियो का भूला हुआ आधा हिस्सा रहा है। आप एक शानदार विज़ुअल वाला सीन बना सकते थे, लेकिन जैसे ही उसे बिना आवाज़ के चलाया जाता, कुछ गड़बड़ लगता था। वह कमी, यानी जहाँ आवाज़ होनी चाहिए थी वहाँ उसका न होना, सालों तक AI वीडियो जनरेशन की निर्णायक सीमा रही। Veo 3.1 वह कमी दूर करता है, और यह किसी छोटे फ़ीचर अपडेट से ज़्यादा AI वीडियो जनरेशन के असली स्वरूप में एक बुनियादी बदलाव जैसा लगता है।
Veo 3 और 3.1 के बीच क्या बदला
साउंड हमेशा कमज़ोर कड़ी रहा
मूल Veo 3 ने Google की वीडियो AI लाइनअप में नेटिव ऑडियो जनरेशन जोड़ा, और अपने समय के हिसाब से यह सचमुच प्रभावशाली था। लेकिन शुरुआती उपयोगकर्ताओं ने कुछ असंगतियाँ देखीं। टूटती लहरों वाला सीन बहुत साफ़ और एकसार लग सकता था, जिसमें असली समुद्र की अराजक परतें नहीं होतीं। वीडियो में हँसता हुआ कोई व्यक्ति अक्सर ऐसी आवाज़ के साथ दिखता था जिसका समय उसके होंठों की हरकत से पूरी तरह नहीं मिलता था। ये बड़ी विफलताएँ नहीं थीं, लेकिन इतनी साफ़ ज़रूर थीं कि पोस्ट-प्रोडक्शन में सुधार की ज़रूरत पड़ जाए।
Veo 3.1 सिर्फ़ उन समस्याओं पर पैबंद नहीं लगाता। यह विज़ुअल जनरेशन और ऑडियो जनरेशन के रिश्ते को शुरुआत से नए सिरे से सोचता है। यह मॉडल साउंड को बराबर का आउटपुट मानता है, न कि पूरे हो चुके वीडियो फ़्रेमों पर बाद में चिपकाई गई चीज़।
Veo 3.1 जिन तीन ऑडियो परतों को संभाल सकता है
Veo 3.1 का ऑडियो व्यवहार में इसलिए अर्थपूर्ण है क्योंकि यह एक साथ तीन अलग-अलग ऑडियो श्रेणियों पर काम करता है:
- एंबिएंट साउंडस्केप: वातावरण की पृष्ठभूमि ध्वनियाँ जैसे हवा, बारिश, ट्रैफ़िक, भीड़ और प्रकृति
- संवाद और बोली: बोले गए शब्द, प्रतिक्रियाएँ, हँसी और बिना शब्दों वाली मानवीय ध्वनियाँ
- डायजेटिक संगीत: वह संगीत जो सीन के भीतर से ही आता है, जैसे चलता हुआ रेडियो या स्क्रीन पर परफ़ॉर्म करता कोई संगीतकार
ये तीन अलग मोड नहीं हैं जिनके बीच आप स्विच करते हों। Veo 3.1 विज़ुअल संदर्भ की समझ के आधार पर तीनों को रीयल टाइम में एक साथ मिलाता है। बारिश वाली दोपहर में कैफ़े के पास धुन बजाते किसी स्ट्रीट म्यूज़िशियन वाला एक सीन, बारिश की एंबिएंट आवाज़, भीड़ की भनभनाहट और लाइव संगीत प्रदर्शन, तीनों को एक साथ परतों में रखेगा, और हर तत्व अपने उचित सापेक्ष वॉल्यूम पर होगा।
ऑडियो जनरेशन असल में कैसे काम करता है
शुरुआत संदर्भ से होती है, डेटाबेस से नहीं
ज़्यादातर शुरुआती AI ऑडियो टूल्स विज़ुअल कंटेंट को पहले से रिकॉर्ड की गई ध्वनियों के डेटाबेस से मिलाकर काम करते थे। आपको "बारिश" या "भीड़" की एक क्लिप मिलती थी जो ठीक-ठाक लगती थी, लेकिन कभी पूरी तरह सही नहीं लगती थी, क्योंकि वह स्वभाव से ही सामान्य होती थी। Veo 3.1 एक बुनियादी रूप से अलग तरीका अपनाता है।
यह मॉडल ऑडियो को उसी तरह जनरेट करता है जैसे वीडियो जनरेट करता है: सीन के बारे में अपनी समझ के आधार पर यह अनुमान लगाता है कि आगे क्या होना चाहिए। यह "बारिश की आवाज़" खोजता नहीं है। यह अनुमान लगाता है कि बारिश कैसी सुनाई देनी चाहिए, यह देखते हुए कि बादल कितने घने हैं, बारिश किस सतह पर गिर रही है, यह हल्की फुहार है या तेज़ बौछार, और वर्चुअल कैमरा एक्शन से कितना करीब है।
💡 इसीलिए Veo 3.1 का ऑडियो अक्सर कम बजट वाले प्रोडक्शन की हाथ से बनी Foley से ज़्यादा सटीक लगता है। मॉडल ने बहुत बड़ी मात्रा में ऐसे असली वीडियो से पैटर्न सीखे हैं जिनमें सिंक्रनाइज़्ड साउंड था, और उसने सिर्फ़ यह नहीं सीखा कि चीज़ें कैसी आवाज़ करती हैं, बल्कि यह भी कि वे उसी तरह क्यों आवाज़ करती हैं।
फ़िज़िक्स-आधारित ध्वनि-तर्क
Veo 3.1 की ऑडियो पाइपलाइन का तकनीकी रूप से प्रभावशाली पहलुओं में से एक वह है जिसे शोधकर्ता इम्प्लिसिट फ़िज़िक्स मॉडलिंग कहते हैं। मॉडल ने भौतिक गुणों और उनकी ध्वनि-छापों के बीच गहरे संबंध सीखे हैं।
पानी अलग-अलग सतहों से टकराकर अलग-अलग आवाज़ें पैदा करता है। बजरी, कालीन और लकड़ी के फ़र्श पर चलते कदमों की बनावट अलग होती है। एक छोटे टाइल वाले बाथरूम में दरवाज़ा बंद होने की गूँज उस गूँज से अलग होती है जो कालीन वाले बेडरूम में होती है। Veo 3.1 जनरेट किए गए सीन के विज़ुअल संकेत पकड़ता है, जिनमें दीवारों की सामग्री, कमरे का अनुपात और वस्तुओं की सतह के गुण शामिल हैं, और उनके आधार पर ध्वनि आउटपुट को उसी हिसाब से आकार देता है।
इससे एक ऐसी ध्वनिक यथार्थता आती है जो पहले सिर्फ़ समर्पित पेशेवर साउंड डिज़ाइन के ज़रिए ही संभव थी।
टेम्पोरल अलाइनमेंट की भूमिका
ऑडियो को समय में विज़ुअल से बिल्कुल सही मिलाना शायद उसे शुरुआत में सही सुनाने से भी कठिन है। आधा सेकंड देर से आने वाली ताली, या होंठों की हरकत से न मिलता कोई शब्द, तुरंत वास्तविकता का भ्रम तोड़ देता है।
Veo 3.1 इसे एक जॉइंट ट्रेनिंग तरीके से हल करता है, जिसमें विज़ुअल टोकन और ऑडियो टोकन आपस में कसकर तालमेल के साथ जनरेट होते हैं। पहले वीडियो फ़्रेम बनाकर बाद में ऑडियो जोड़ने के बजाय, मॉडल इनफ़रेंस के दौरान दोनों प्रतिनिधित्व एक साथ बनाता है। नतीजा है फ़्रेम-स्तर तक सटीक ऑडियो सिंक्रनाइज़ेशन, जो तेज़ मोशन या भारी एक्शन वाले दृश्यों में भी टिकता है।
असली दुनिया जैसा सही लगने वाला ऑडियो
एंबिएंट साउंडस्केप
यहीं Veo 3.1 सबसे लगातार प्रभावित करता है। एंबिएंट ऑडियो को नकली बनाना सबसे कठिन है, क्योंकि इंसान अनजाने में ही जानते हैं कि जगहें कैसी सुनाई देती हैं। सुबह के जंगल की आवाज़ दोपहर के उसी जंगल से अलग होती है। गर्मियों के समुद्र तट की आवाज़ शरद ऋतु के बादलों वाले उसी तट से अलग होती है।
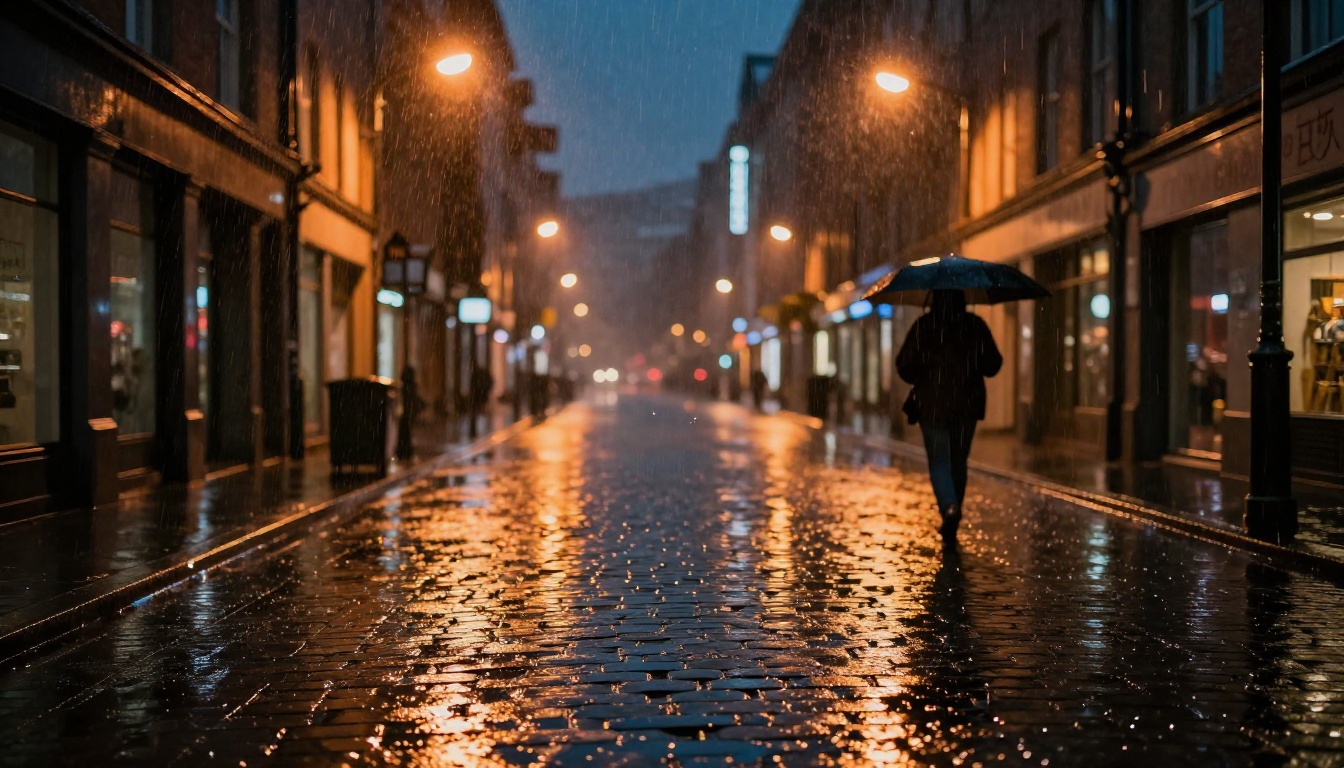
मॉडल इन अंतरों को ऐसी बारीकी से संभालता है जो पिछले AI वीडियो टूल्स नहीं कर पाते थे। "बारिश के बाद किसी यूरोपीय शहर की एक शांत गली" जैसा प्रॉम्प्ट ऐसा ऑडियो बनाएगा जिसमें भीगे पत्थर की खास ध्वनिक प्रकृति, इमारतों के बीच की खाली जगहों से छनकर आता दूर का ट्रैफ़िक, और कैनवस के शामियाने से टपकते पानी की कभी-कभार आने वाली आवाज़ शामिल होगी, सिर्फ़ कोई सामान्य "आउटडोर एंबिएंस" क्लिप नहीं।
यही बारीकी Veo 3.1 के आउटपुट को AI वीडियो जनरेशन में पहले आई किसी भी चीज़ से अलग करती है।
मानवीय आवाज़ और संवाद
जब किसी सीन में ऐसे किरदार हों जो बोलते हुए दिखते हैं, तो Veo 3.1 ऐसा ऑडियो जनरेट करता है जो उनकी होंठों की हरकत और भावनात्मक लहजे से मेल खाता है। जिन सीन में प्रॉम्प्ट का हिस्सा कोई खास बोला गया कंटेंट नहीं है, वहाँ मॉडल फ़ोनीम-स्तर का ऑडियो बनाता है, जो बिना पहचानी जा सकने वाली भाषा जनरेट किए बातचीत का विश्वसनीय एहसास देता है।
जिन सीन में प्रॉम्प्ट में बोले गए शब्द या भावनात्मक प्रस्तुति तय की गई हो, वहाँ मॉडल बोलने वाले के विज़ुअल प्रदर्शन को ऑडियो की लय और उतार-चढ़ाव से मिलाने की कोशिश करता है। यहाँ सटीकता काफ़ी हद तक प्रॉम्प्ट की साफ़गोई पर निर्भर करती है। अस्पष्ट प्रॉम्प्ट से अनुमानित नतीजे मिलते हैं। लहजे, गति और भावनात्मक स्थिति का वर्णन करने वाले विस्तृत प्रॉम्प्ट से सिंक्रनाइज़ेशन साफ़ तौर पर बेहतर होता है।
💡 प्रॉम्प्ट टिप: संवाद वाले सीन के लिए प्रॉम्प्ट लिखते समय शाब्दिक शब्दों के बजाय भावनात्मक अंतर्धारा बताएँ। "एक कैफ़े की मेज़ के उस पार किसी से धीमे और बेचैनी भरे लहजे में बात करती एक महिला" से बेहतर सिंक्रनाइज़्ड नतीजे मिलेंगे, बस "दो लोग बात कर रहे हैं" लिखने से नहीं।
ऐसा संगीत जो मूड में बैठे
डायजेटिक संगीत, यानी वह संगीत जो सीन के भीतर से ही आता है, Veo 3.1 में ख़ास सलीके से संभाला जाता है। पोर्च पर गिटार बजाते किसी व्यक्ति वाला सीन ऐसा ऑडियो जनरेट करेगा जो बजाने के स्पष्ट अंदाज़ से मेल खाता है, चाहे वह फ़िंगरपिक्ड हो या स्ट्रम्ड, धीमा हो या तेज़। जिस सीन में एक रिकॉर्ड प्लेयर दिख रहा हो, वह विज़ुअल संदर्भ से सुझाई गई संभावित शैली और लगभग दौर के हिसाब से उपयुक्त ऑडियो बनाएगा।
नॉन-डायजेटिक बैकग्राउंड स्कोरिंग फ़िलहाल Veo 3.1 के मुख्य दायरे से बाहर है। लेकिन जहाँ संगीत फ़्रेम के भीतर से आना चाहिए, वहाँ सिंक्रनाइज़ेशन की गुणवत्ता सचमुच उल्लेखनीय है, और यह Veo 3 की तुलना में सबसे साफ़ सुधारों में से एक है।
PicassoIA पर Veo 3.1 कैसे इस्तेमाल करें
Veo 3.1 PicassoIA पर सीधे उपलब्ध है, साथ में इसका तेज़ वर्ज़न Veo 3.1 Fast भी है, जो ऑडियो की गुणवत्ता में थोड़ी कमी के बदले जनरेशन का समय काफ़ी घटा देता है। दोनों से अच्छे नतीजे कैसे पाएँ, यह यहाँ है।
अपना पहला प्रॉम्प्ट सेट करना
चरण 1: PicassoIA पर Veo 3.1 मॉडल पेज खोलें।
चरण 2: अपना टेक्स्ट प्रॉम्प्ट लिखें, जिसमें स्पष्ट ऑडियो संकेत पहले से शामिल हों। यह न मान लें कि मॉडल सिर्फ़ विज़ुअल से आवाज़ का अनुमान लगा लेगा। सीन के वर्णन के हिस्से के रूप में ध्वनि वाले तत्वों का सीधा ज़िक्र करें।
उदाहरण प्रॉम्प्ट: "पेरिस की भीगी सड़क पर शाम के समय चलती 30 की उम्र की एक महिला। उसकी हील्स की भीगे पत्थरों पर चलने की आवाज़, इमारतों के बीच से छनकर आता दूर का ट्रैफ़िक, और पचास मीटर दूर एक दरवाज़े से अकॉर्डियन बजाता एक स्ट्रीट परफ़ॉर्मर।"
चरण 3: अपनी पसंद की अवधि और रिज़ॉल्यूशन चुनें। ऑडियो की निरंतरता के लिए, 8 सेकंड या उससे लंबी क्लिप मॉडल को पूरे समय में सुसंगत साउंड डिज़ाइन बनाए रखने के लिए ज़्यादा टेम्पोरल संदर्भ देती हैं।
चरण 4: अपना आउटपुट जाँचें। देखें कि विज़ुअल घटनाएँ अपनी संबंधित ध्वनियों के साथ मेल खाती हैं। Veo 3.1 का सिंक्रनाइज़ेशन मज़बूत है, लेकिन असामान्य या बहुत जटिल प्रॉम्प्ट कभी-कभी टाइमिंग में हल्का सा भटकाव पैदा कर सकते हैं।
चरण 5: अगर ऑडियो सिंक्रनाइज़ेशन पूरी तरह सही नहीं है, तो सीन में ध्वनियों के समय और भौतिक कारण के बारे में अपने प्रॉम्प्ट में और साफ़-साफ़ बताएँ, और उसे परिष्कृत करें।
बेहतर ऑडियो नतीजों के लिए टिप्स
| तकनीक | यह क्यों काम करती है |
|---|
| सीन में खास सामग्री के नाम बताएँ | मॉडल ध्वनिक प्रतिक्रिया की गणना के लिए सतह के गुणों का उपयोग करता है |
| कमरे या बाहरी जगह का विस्तार से वर्णन करें | रीवर्ब और इको के पैटर्न स्थानिक संदर्भ पर बहुत निर्भर करते हैं |
| दिन का समय और मौसम की स्थिति बताएँ | एंबिएंट साउंड प्रोफ़ाइल पर्यावरणीय स्थिति से काफ़ी बदलती हैं |
| मानवीय व्यवहार और शारीरिक भाषा शामिल करें | मुद्रा, हावभाव और होंठों की हरकत, सभी बोली और ध्वनि आउटपुट की जानकारी देते हैं |
| एक ही प्रॉम्प्ट में बहुत भीड़भाड़ वाले साउंडस्केप से बचें | कई प्रतिस्पर्धी ऑडियो स्रोत हर तत्व की स्पष्टता घटा देते हैं |
| तेज़ दोहराव के लिए Veo 3.1 Fast इस्तेमाल करें | प्रॉम्प्ट के वेरिएशन जल्दी आज़माएँ, फिर अंतिम आउटपुट के लिए पूरे Veo 3.1 पर जाएँ |
Veo 3.1 बनाम ऑडियो वाले अन्य AI वीडियो मॉडल
अब कई दूसरे मॉडल नेटिव ऑडियो देते हैं या उसे सक्रिय रूप से जोड़ रहे हैं। व्यावहारिक इस्तेमाल में सबसे ज़रूरी श्रेणियों पर वे कैसे तुलना में ठहरते हैं, यह यहाँ है।
Veo 3.1 और व्यापक क्षेत्र के बीच का अंतर महत्वपूर्ण है, खासकर एंबिएंट साउंड और डायजेटिक ऑडियो में। आज के ज़्यादातर AI वीडियो मॉडल अब भी बिना आवाज़ का आउटपुट देते हैं या सिर्फ़ बुनियादी साउंड मिलान देते हैं। Veo 3 से 3.1 तक की छलांग अर्थपूर्ण है लेकिन क्रमिक है। बड़ी कहानी यह है कि दोनों Veo मॉडल उन विकल्पों से कितने आगे हैं जिन्होंने अभी तक ऑडियो-फ़र्स्ट वीडियो जनरेशन को पूरी तरह नहीं अपनाया है।
जहाँ ऑडियो जनरेशन अब भी संघर्ष करता है
ज़्यादातर इस्तेमाल के मामलों में Veo 3.1 प्रभावशाली है, लेकिन इसकी मौजूदा सीमाएँ जानने से आप उनके आसपास बेहतर योजना बना सकते हैं।
भीड़भाड़ वाले साउंडस्केप
जब किसी सीन में एक साथ कई ध्वनि स्रोत हों, जैसे व्यस्त बाज़ार, त्योहार की भीड़, या कई टक्कर वाली घटनाओं वाला अराजक एक्शन सीक्वेंस, तो मॉडल वातावरण का विश्वसनीय सोनिक प्रभाव तो बनाता है, लेकिन हर अलग ऑडियो घटना को अलग-अलग परत में पूरी निष्ठा से नहीं रखता। आपको भीड़ वाली जगह का एक विश्वसनीय समग्र एहसास मिलता है, लेकिन कई आपस में मिली हुई व्यक्तिगत ध्वनियों की वह असली जटिलता नहीं मिलती जिसमें हर ध्वनि पूरी स्पष्टता से रेंडर हुई हो।
इस सीमा से जूझने का तरीका: अलग-अलग ध्वनि तत्वों को अलग से स्थापित करने के लिए कम अवधि की लगातार क्लिप इस्तेमाल करें। बाज़ार का एक वाइड शॉट, फिर किसी खास स्टॉल का क्लोज़-अप, एक ही जनरेशन में सब कुछ पकड़ने की कोशिश करने से ज़्यादा विस्तृत ऑडियो देगा।
सटीक संगीत टाइमिंग
जब किसी सीन में सिंक्रनाइज़्ड संगीत प्रदर्शन हो, जैसे ड्रमर का कोई खास बीट पैटर्न बजाना या पियानोवादक का कोई पहचानी जाने वाली धुन बजाना, तो मॉडल संगीतात्मकता का समग्र प्रभाव अच्छा संभालता है, लेकिन सटीक नोट टाइमिंग में चूक सकता है, खासकर दस सेकंड से लंबी क्लिप में।
म्यूज़िक वीडियो कंटेंट के लिए Veo 3.1 इस्तेमाल करने से पहले इसे ध्यान में रखना ज़रूरी है, जिसमें कसकर बीट सिंक्रनाइज़ेशन चाहिए। ऐसे खास मामलों के लिए, विज़ुअल ट्रैक अलग से बनाकर पोस्ट में ऑडियो मैन्युअली मिलाना अब भी ज़्यादा भरोसेमंद नतीजे देता है।
💡 बिना वीडियो के समर्पित AI म्यूज़िक जनरेशन के लिए, PicassoIA विशेष AI Music Generation मॉडल भी देता है, जो टेक्स्ट प्रॉम्प्ट से पूरे साउंडट्रैक बनाते हैं। इन्हें आप पूर्ण रचनात्मक नियंत्रण के लिए अपने Veo 3.1 वीडियो आउटपुट के साथ जोड़ सकते हैं।
PicassoIA पर बनाना शुरू करें
Veo 3.1 की ऑडियो क्षमता के बारे में सबसे महत्वपूर्ण बात तकनीक खुद नहीं है। सबसे अहम यह है कि इससे कौन उच्च गुणवत्ता वाला वीडियो कंटेंट बना सकता है। साउंड डिज़ाइन के लिए पहले समर्पित टूल्स, विशेषज्ञता और अक्सर एक अलग पेशेवर की ज़रूरत पड़ती थी। Veo 3.1 उस पूरी प्रक्रिया को एक ही टेक्स्ट प्रॉम्प्ट में समेट देता है।
इससे वीडियो प्रोडक्शन की अर्थव्यवस्था वास्तविक और व्यावहारिक तरीके से बदलती है। एक सोशल मीडिया क्रिएटर, एक छोटा व्यवसाय चलाने वाला मालिक, या एक स्वतंत्र फ़िल्मकार अब बिना साउंड स्टूडियो, Foley आर्टिस्ट या ऑडियो एडिटिंग सॉफ़्टवेयर के पेशेवर गुणवत्ता वाले एंबिएंट ऑडियो के साथ वीडियो कंटेंट बना सकता है। जिसके लिए पहले पोस्ट-प्रोडक्शन पाइपलाइन चाहिए थी, वह अब विज़ुअल के साथ उसी जनरेशन स्टेप में हो सकता है।
PicassoIA आपको Veo 3.1 और Veo 3.1 Fast दोनों के साथ-साथ 87+ अन्य वीडियो जनरेशन मॉडल तक पहुँच देता है, जिनमें Kling v3 Video, Wan 2.6 T2V और Hailuo 02 शामिल हैं। आप मॉडलों के आउटपुट की तुलना कर सकते हैं, अलग-अलग प्रॉम्प्ट तरीकों को आज़मा सकते हैं, और अपनी खास रचनात्मक ज़रूरतों के लिए सही संयोजन खोज सकते हैं।
अगर आपने नेटिव ऑडियो वाले AI वीडियो जनरेशन को अभी तक नहीं आज़माया है, तो शुरू करने का अभी सही समय है। एक विस्तृत सीन विवरण लिखें, अपने प्रॉम्प्ट में स्पष्ट ऑडियो संकेत शामिल करें, और देखें कि Veo 3.1 क्या बनाता है। नतीजे अक्सर उन अनुभवी वीडियो क्रिएटर्स को भी चौंका देते हैं जो पुराने AI टूल्स की सीमाओं के आदी हैं।
टेक्स्ट प्रॉम्प्ट से जो बन सकता है और जिसके लिए पूरे पेशेवर प्रोडक्शन सेटअप की ज़रूरत होती है, उनके बीच की दूरी तेज़ी से कम हो रही है। Veo 3.1 इसका एक बड़ा कारण है।