Si sigues el mundo de la generación de imágenes con IA, seguramente has visto que Leonardo Phoenix aparece con frecuencia. Es uno de los modelos más destacados de Leonardo.ai, construido en torno a dos cualidades que el equipo de la plataforma priorizó desde el principio: una gran adherencia al prompt y resultados fotorrealistas. La combinación suena sencilla, pero lograr ambas cosas a un nivel alto en el mismo modelo es más difícil de lo que parece. Este artículo desglosa qué hace Phoenix, cómo funciona, en qué destaca y qué conviene saber antes de empezar a usarlo en serio con prompts.
Qué es realmente Leonardo Phoenix
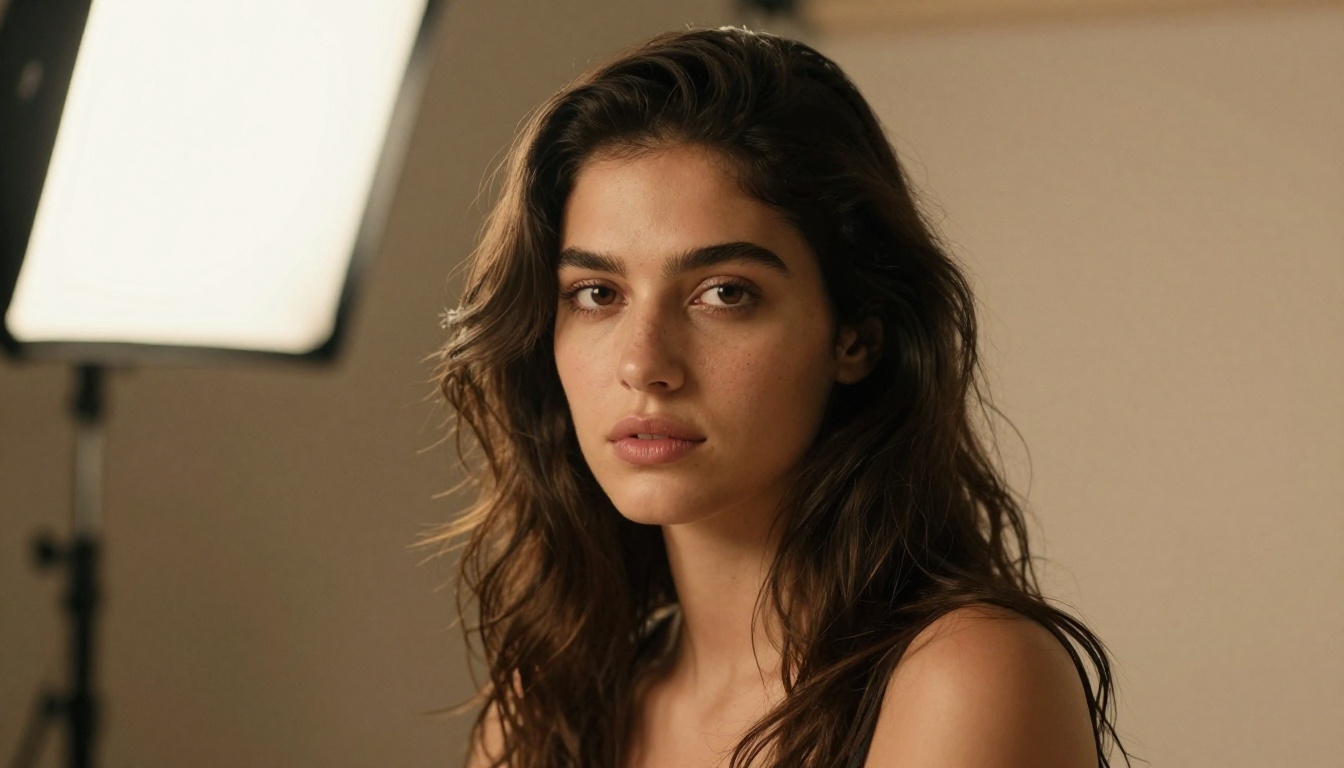
Leonardo Phoenix es el modelo texto a imagen insignia desarrollado por Leonardo.ai. Es un modelo propietario, no una versión de código abierto, lo que significa que su arquitectura y los detalles de su entrenamiento no se publican por completo. Lo que se sabe, a partir de las comunicaciones de la plataforma y de las pruebas de la comunidad, es que Phoenix se diseñó para resolver dos frustraciones persistentes de los modelos de difusión anteriores: elementos del prompt que se pierden y una calidad visual que se degrada en escenas complejas.
El modelo funciona exclusivamente en la plataforma de Leonardo.ai, que lo mantiene y lo actualiza como parte de su infraestructura de producto. Para los usuarios, esto significa que trabajan con un modelo que recibe un refinamiento constante con el tiempo, en lugar de un checkpoint estático que nunca mejora.
La arquitectura que hay detrás
Phoenix se basa en una arquitectura de difusión a gran escala con un ajuste fino propietario aplicado sobre un modelo base. Leonardo.ai ha confirmado el uso de RLHF (Reinforcement Learning from Human Feedback, aprendizaje por refuerzo a partir de retroalimentación humana) en su pipeline de entrenamiento, lo que explica por qué los resultados parecen más intencionados y menos aleatorios que las alternativas de código abierto comparables.
La capa de RLHF entrena al modelo para priorizar los resultados que los evaluadores humanos califican como de alta calidad, lo que en la práctica significa un mejor manejo de:
- Prompts con varios elementos, con sujetos y fondos distintos
- Distribución natural de la luz en escenas complejas
- Anatomía coherente y precisa en los sujetos humanos
- Detalle fino de textura en la piel, las telas y las superficies del entorno
Quién se beneficia más
Phoenix funciona bien en una gran variedad de casos de uso, pero es especialmente sólido para:
- Fotógrafos creativos y comerciales que prototipan conceptos visuales
- Cineastas y directores de arte que crean moodboards o material de previsualización
- Equipos de marketing y comercio electrónico que necesitan imágenes rápidas y de alta calidad
- Diseñadores de videojuegos que visualizan personajes y entornos
- Creadores de contenido para redes sociales que producen contenido editorial coherente en volumen
Funciones principales que lo diferencian
Una adherencia al prompt que se mantiene
Pregunta a cualquier usuario experimentado de generación de imágenes con IA cuál es su mayor frustración, y la deriva del prompt estará entre las primeras. Escribes un prompt detallado con cinco elementos concretos, y el modelo renderiza tres de ellos mientras ignora o deforma el resto. Phoenix se entrenó específicamente para reducir este problema.
En las pruebas de la comunidad y en las comparativas publicadas, Phoenix reproduce de forma constante más de los elementos previstos en el prompt en cada resultado. Esto se nota sobre todo en:
- Prompts con composiciones de escena concretas (colocación del sujeto, detalles del fondo)
- Prompts que incluyen descripciones de ropa o accesorios
- Prompts que combinan elementos del entorno y del sujeto en la misma escena
💡 Consejo: La estructura de prompt más fiable para Phoenix es: Sujeto + Acción/Estado + Entorno + Iluminación + Cámara/Estilo. Cada componente le da al modelo un conjunto de instrucciones distinto que procesar.
Fotorrealismo sin andamiaje de prompts
Los modelos anteriores obligaban a los usuarios a añadir palabras clave de mejora de calidad al final de cada prompt («photorealistic, hyperdetailed, 8K, sharp focus») solo para alcanzar un nivel básico de calidad. El resultado base de Phoenix ya tiende hacia el realismo visual.
La textura de la piel se renderiza con un detalle visible a nivel de poro. Los degradados de luz caen de forma natural sobre las superficies. El comportamiento de la profundidad de campo responde bien a las descripciones de distancia focal. Los usuarios dedican menos tiempo a esquivar las debilidades del modelo y más a dirigir sus fortalezas.
Cómo maneja las escenas complejas
Donde Phoenix se separa con más claridad de los modelos de gama media es en las escenas con varios sujetos y varios elementos. Cuando recibe un prompt con un sujeto en primer plano, un entorno de fondo detallado y una condición de luz concreta, Phoenix tiende a:
- Mantener una separación visual clara entre el primer plano y el fondo
- Distribuir la luz de forma realista entre todos los elementos de la escena
- Conservar relaciones espaciales precisas entre los sujetos
- Evitar el efecto de «sopa visual» habitual en los resultados de difusión de menor calidad
Esto hace que Phoenix sea especialmente útil para estilos de fotografía editorial, donde varios elementos deben convivir de forma coherente en un único encuadre.
El texto en las imágenes: hasta dónde llega Phoenix
Renderizar texto legible dentro de una imagen generada por IA ha sido una debilidad persistente en toda la categoría de modelos de difusión. La mayoría produce caracteres que se parecen visualmente a un texto, pero que no se pueden leer. Phoenix supone una mejora notable en este aspecto, aunque no es una solución completa.
Lo que sí puede hacer
Phoenix maneja cadenas de texto cortas con una precisión notable. Casos prácticos en los que funciona bien:
- Palabras sueltas en carteles, etiquetas o envases de productos
- Frases cortas (de 3 a 5 palabras) en pancartas o escaparates
- Texto del entorno, como señales de calle, carteles o lomos de libros
- Logotipos con elementos tipográficos sencillos
El modelo procesa con mayor prioridad el texto entre comillas dentro del prompt. Escribir el texto deseado entre comillas en el prompt produce de forma constante resultados más precisos.
Los límites realistas
Para cualquier cosa que requiera un control tipográfico exacto, Phoenix todavía se queda por detrás de las herramientas de diseño especializadas. Las fuentes concretas, el interletraje preciso y los textos largos de cuerpo siguen siendo poco fiables. El modelo maneja mejor el texto contextualmente correcto, es decir, el que encaja de forma natural y se lee bien en su contexto, que el texto tipográficamente preciso.
💡 Consejo: Cuando pidas texto en una imagen, escríbelo entre comillas directamente en tu prompt: a storefront sign that reads "OPEN DAILY". Esta sintaxis mejora de forma constante la precisión del texto en los resultados de Phoenix.
Gama de estilos y flexibilidad
Phoenix tiende por defecto al fotorrealismo, pero su entrenamiento abarca una gama estilística amplia. Dirigirlo hacia estéticas concretas funciona bien con el lenguaje de prompt adecuado.
Retrato y fotografía de moda
Es donde Phoenix rinde mejor entre las categorías con sujetos humanos. La textura de la piel, la separación de los mechones de pelo, la claridad de los ojos y la sutileza expresiva se renderizan a un nivel que aguanta la inspección de cerca. Para trabajos editoriales de moda o fotografía de estilo de vida, Phoenix produce resultados que los fotógrafos suelen considerar útiles tanto como material de referencia como recursos finales.
Imágenes cinematográficas y atmosféricas
Los planos cinematográficos de gran angular, los paisajes atmosféricos y las composiciones centradas en el entorno encajan bien con Phoenix. La luz volumétrica, la niebla, la bruma y los degradados de la hora dorada se renderizan con caídas de luz naturales, en lugar de los bordes duros y artificiales que aparecen en modelos de menor calidad. Cuando los prompts incluyen descriptores de luz (volumétrica, direccional, difusa, contraluz), Phoenix los interpreta con precisión.
Ilustración y trabajo estilizado
Aunque el fotorrealismo es su opción por defecto, Phoenix responde bien a cambios de estilo. Los prompts que incluyen términos como «oil painting texture», «film noir», «editorial illustration» o «vintage photography» desplazan con éxito el resultado hacia esas estéticas, manteniendo el nivel de calidad base. El modelo adapta el lenguaje visual del estilo pedido a lo largo de toda la imagen, no solo como un filtro superficial.
Rendimiento por estilo de un vistazo
| Tipo de estilo | Rendimiento de Phoenix | Notas |
|---|
| Retrato / Primer plano de rostro | Excelente | Gran detalle de la piel y respuesta natural a la luz |
| Plano cinematográfico amplio | Excelente | Maneja bien la profundidad atmosférica y la luz volumétrica |
| Moda / Editorial | Muy bueno | Textura de tela y precisión de la pose constantes |
| Arquitectónico | Bueno | La precisión de la perspectiva es fiable |
| Escenas con mucho texto | Aceptable | Mejor que la competencia, pero todavía imperfecto a gran escala |
| Abstracto / Surrealista | Bueno | Resultados irregulares, pero viables con prompts específicos |
Leonardo Phoenix funciona en la plataforma de Leonardo.ai. Estos son los puntos clave para sacar el mejor resultado, junto con estrategias de prompt que se aplican a cualquier modelo similar de texto a imagen.
Cómo estructurar tu prompt
El formato de prompt más fiable sigue una estructura por capas:
[Sujeto] + [Acción o estado] + [Entorno] + [Iluminación] + [Cámara u objetivo] + [Modificador de estilo]
Ejemplo:
A woman in a white silk dress standing on a coastal cliff at sunset, warm volumetric golden light from the left, 85mm lens, shallow depth of field, photorealistic RAW
Cada capa le da al modelo una instrucción distinta que procesar. El sujeto define quién o qué aparece en el encuadre. El entorno aporta el contexto espacial. La iluminación define el ambiente y la temperatura visual. Los descriptores de cámara y objetivo indican al modelo cómo debe encuadrarse la escena y cómo debe comportarse la profundidad.
Cuanto más completa sea cada capa, menos rellenará el modelo los huecos con valores genéricos por defecto.
Prompts negativos que vale la pena usar
Phoenix responde bien a los prompts negativos. Las siguientes entradas merece la pena incluirlas en la mayoría de los casos:
blurry, soft focus, low resolution, watermark, text overlaydistorted face, extra fingers, anatomical errorsoverexposed, underexposed, flat lighting
Mantén los prompts negativos concisos. Sobrecargarlos con 40 o más entradas puede generar artefactos visuales inesperados. Una lista corta y concreta funciona mejor que una exhaustiva.
Resolución y relación de aspecto
Phoenix admite varias relaciones de aspecto sin una degradación notable de la calidad a resoluciones altas. Para contenido editorial y cinematográfico, 16:9 es el encuadre más natural. Para retrato y moda, 4:5 o 2:3 enmarcan a los sujetos de forma más natural. El formato cuadrado funciona bien para imágenes de producto o recursos para redes sociales.
Ajustes de guidance scale
El Guidance Scale (CFG) controla cuán estrictamente el modelo sigue tu prompt frente a cuánta libertad interpretativa se toma. En Phoenix, el rango óptimo suele estar entre 7 y 11:
- CFG 6-8: Resultado equilibrado. Bueno para prompts creativos en los que se agradece cierta variación.
- CFG 9-11: Seguimiento estricto. Ideal cuando deben aparecer en el resultado elementos visuales concretos.
- CFG 12 o más: Puede introducir artefactos visuales, sobre todo en escenas complejas con varios elementos.
💡 Consejo: Si Phoenix sigue eliminando un elemento concreto de tu prompt, subir el CFG a 10-11 y volver a generar suele solucionarlo. También puedes mover el elemento que se pierde al principio del prompt.
Errores habituales al usar Phoenix
Sobrecargar el prompt
Existe la creencia extendida de que los prompts más largos dan mejores resultados. En la práctica, los prompts de más de 80-100 palabras tienden a hacer que el modelo promedie instrucciones contradictorias en lugar de priorizar las importantes. Los prompts concisos y por capas superan de forma constante a los prolijos.
Olvidar la capa de preajustes de estilo
Leonardo.ai incluye preajustes de estilo que se superponen a tu prompt a nivel de plataforma. Aplicar los preajustes «Photography» o «Cinematic» sobre un prompt bien escrito suele dar mejores resultados que un prompt detallado por sí solo. Los preajustes aportan una orientación de estilo a nivel de modelo que refuerza la dirección de tu prompt sin necesidad de más palabras.
No generar varias versiones
Phoenix, como todos los modelos generativos, produce resultados variables en distintas ejecuciones con el mismo prompt. Generar el mismo prompt de 3 a 5 veces y elegir el mejor resultado es un flujo de trabajo profesional estándar, no un parche para un mal prompt. Incorporar la evaluación en tu proceso de generación es más rápido que intentar escribir el prompt perfecto en el primer intento.
Cómo se compara Phoenix con otros modelos
Esta comparación refleja la generación actual de los mejores modelos de texto a imagen:
| Modelo | Adherencia al prompt | Fotorrealismo | Renderizado de texto | Velocidad |
|---|
| Leonardo Phoenix | Excelente | Excelente | Bueno | Media |
| Flux Dev | Muy buena | Excelente | Aceptable | Rápida |
| Stable Diffusion 3 | Buena | Buena | Aceptable | Rápida |
| Midjourney v6 | Buena | Muy buena | Aceptable | Media |
| DALL-E 3 | Excelente | Buena | Muy bueno | Media |
| GPT Image 2 | Excelente | Muy buena | Excelente | Media |
Phoenix ocupa una posición sólida cuando la adherencia al prompt y el fotorrealismo son prioridades al mismo tiempo. DALL-E 3 y GPT Image 2 siguen por delante en la precisión del renderizado de texto. Flux Dev y Stable Diffusion 3 ofrecen velocidades de generación más altas con una calidad de imagen competitiva. La mejor opción depende de lo que exija específicamente tu flujo de trabajo.
Para quienes priorizan el realismo visual en escenas complejas y necesitan una interpretación fiable de prompts detallados, Phoenix se sitúa actualmente a la cabeza de su categoría.
Alternativas sólidas en PicassoIA
Leonardo Phoenix no está disponible actualmente como modelo en PicassoIA, pero la plataforma alberga varios de los mejores modelos de texto a imagen, que cubren casos de uso similares y a menudo solapados.
Modelos Flux para trabajo de calidad de producción
Flux Redux Dev, de Black Forest Labs, es una de las alternativas de código abierto más sólidas a Phoenix. Produce resultados fotorrealistas con un excelente nivel de detalle en una gran variedad de estilos visuales. Para flujos de trabajo que requieren iterar creativamente mediante variaciones de imagen, es especialmente adecuado.
Otras variantes de Flux disponibles en PicassoIA incluyen Flux Fill Pro para inpainting y relleno de detalles, y Flux Depth Pro para generación con control de estructura. Juntas forman un conjunto completo de herramientas para la producción de imágenes de nivel profesional sin salir de la plataforma.
Opciones de alta resolución y especializadas
Stable Diffusion 3, de Stability AI, sigue siendo una opción fiable, con una amplia gama estilística y un fuerte respaldo de la comunidad. Para salidas de ultra alta resolución en calidad 4K, Seedream 4.5, de ByteDance, y Wan 2.7 Image Pro ofrecen de forma constante un detalle listo para producción que compite con la calidad de salida de Phoenix.
Para la precisión del texto dentro de la imagen en concreto, GPT Image 2, de OpenAI, sigue siendo la opción más sólida disponible actualmente. Maneja superposiciones de texto complejas dentro de las imágenes mejor que cualquier otro modelo de esta categoría.
💡 PicassoIA reúne más de 91 modelos de texto a imagen en una sola plataforma. No necesitas instalación local ni lidiar con la API. Eliges un modelo, escribes un prompt y generas directamente en el navegador.
Qué hace que un flujo de trabajo de imágenes con IA sea sólido
Los principios que hay detrás de un buen resultado con IA de imágenes apenas cambian entre modelos. Tanto si trabajas con Phoenix, con Flux o con cualquier modelo comparable, estos patrones producen de forma constante mejores resultados:
La precisión vale más que la cantidad. Tres detalles precisos dan mejor resultado que diez vagos. «Luz de sol de la tarde que entra a raudales por ventanas orientadas al oeste» es más útil que «buena iluminación con tonos cálidos bonitos».
La iluminación es la variable de mayor impacto. Describir la dirección, la intensidad y la temperatura de color de la luz tiene de forma constante el mayor impacto individual en la calidad del resultado. «Luz volumétrica de la mañana desde la izquierda» afecta a toda la composición de la escena, no solo a la parte de iluminación.
El lenguaje de cámara y objetivo funciona. Expresiones como «85 mm f/1.4» o «gran angular de 24 mm» influyen en la distorsión de perspectiva, en el comportamiento de la profundidad de campo y en la sensación compositiva de los modelos bien entrenados. No son etiquetas estéticas: tienen un significado fotográfico real que los modelos entrenados han interiorizado a partir de enormes conjuntos de datos de fotografía.
Iterar forma parte del proceso. Ningún prompt consigue la imagen perfecta en la primera generación todas las veces. Un proceso de trabajo sólido consiste en generar varias versiones, elegir la mejor y refinar a partir de ahí. Aceptarlo reduce la presión sobre cualquier intento concreto de prompt y acelera el camino hacia un resultado de calidad.
Pruébalo en PicassoIA ahora mismo
Leonardo Phoenix representa hacia dónde se dirigen los mejores modelos de texto a imagen: mejor seguimiento de instrucciones, realismo más constante y resultados que no requieren experiencia en ingeniería de prompts para tener un aspecto profesional. Tanto si generas imágenes editoriales, conceptos creativos, contenido de moda o recursos comerciales, conviene conocer el nivel de calidad que marca.
Si quieres experimentar con modelos que funcionan a ese mismo nivel ahora mismo, PicassoIA te da acceso directo a más de 90 modelos de texto a imagen en un solo lugar. Flux Redux Dev, Seedream 4.5, Stable Diffusion 3, Wan 2.7 Image Pro y GPT Image 2 están disponibles sin instalación, sin configuración de API y sin requisitos de hardware local.
Elige un prompt, prueba varias versiones con distintos modelos y comprueba lo que la generación actual de IA de imágenes produce a plena calidad. Los resultados suelen hablar por sí solos.


