Se você acompanha o universo da geração de imagens por IA, provavelmente já viu o Leonardo Phoenix aparecer com frequência. Ele é um dos modelos de destaque da Leonardo.ai, construído em torno de duas qualidades que a equipe da plataforma priorizou desde o início: forte aderência ao prompt e resultados fotorrealistas. A combinação parece simples, mas alcançar as duas em alto nível no mesmo modelo é mais difícil do que parece. Este artigo detalha o que o Phoenix faz, como funciona, onde ele se sai melhor e o que saber antes de começar a escrever prompts para ele com seriedade.
O que é realmente o Leonardo Phoenix
O Leonardo Phoenix é o modelo principal de texto para imagem desenvolvido pela Leonardo.ai. Trata-se de um modelo proprietário, não de uma versão pública de código aberto, o que significa que sua arquitetura e os detalhes de treinamento não são totalmente divulgados. O que se sabe, pelas comunicações da plataforma e pelos testes da comunidade, é que o Phoenix foi projetado para resolver duas frustrações recorrentes em modelos de difusão anteriores: elementos do prompt que eram ignorados e qualidade visual que se degradava em cenas complexas.
O modelo roda exclusivamente na plataforma Leonardo.ai, que o mantém e atualiza como parte da sua infraestrutura de produto. Para você, isso significa trabalhar com um modelo que recebe refinamentos constantes ao longo do tempo, e não com um checkpoint estático que nunca melhora.
A arquitetura por trás dele
O Phoenix é construído sobre uma arquitetura de difusão em larga escala, com fine-tuning proprietário aplicado sobre um modelo base. A Leonardo.ai confirmou o uso de RLHF (Aprendizado por Reforço com Feedback Humano) em seu pipeline de treinamento, o que explica por que os resultados tendem a parecer mais intencionais e menos aleatórios do que alternativas comparáveis de código aberto.
A camada de RLHF treina o modelo para priorizar resultados que avaliadores humanos classificam como de alta qualidade, o que, na prática, significa melhor tratamento de:
- Prompts com múltiplos elementos, com sujeitos e fundos distintos
- Distribuição natural da luz em cenas complexas
- Precisão anatômica consistente em sujeitos humanos
- Detalhes finos de textura em pele, tecido e superfícies do ambiente
Quem mais se beneficia
O Phoenix tem bom desempenho em uma ampla gama de casos de uso, mas é particularmente forte para:
- Fotógrafos criativos e comerciais que criam protótipos de conceitos visuais
- Cineastas e diretores de arte que montam painéis de referência ou materiais de pré-visualização
- Equipes de marketing e e-commerce que precisam de imagens rápidas e de alta qualidade
- Designers de jogos que visualizam personagens e ambientes
- Criadores de conteúdo para redes sociais que produzem conteúdo editorial consistente em volume
Recursos principais que o diferenciam
Aderência ao prompt que realmente se mantém
Pergunte a qualquer usuário experiente de geração de imagens por IA qual é a sua maior frustração, e a deriva do prompt estará entre as primeiras. Você escreve um prompt detalhado com cinco elementos específicos, e o modelo renderiza três deles enquanto ignora ou deforma os demais. O Phoenix foi treinado especificamente para reduzir esse problema.
Em testes da comunidade e comparações publicadas, o Phoenix reproduz de forma consistente mais dos elementos pretendidos do prompt em cada resultado. Isso é especialmente visível em:
- Prompts com composições de cena específicas (posicionamento do sujeito, detalhes do fundo)
- Prompts que incluem descrições de roupas ou acessórios
- Prompts que combinam elementos do ambiente e do sujeito na mesma cena
💡 Dica: A estrutura de prompt mais confiável para o Phoenix é: Sujeito + Ação/Estado + Ambiente + Iluminação + Câmera/Estilo. Cada componente dá ao modelo um conjunto separado de instruções para processar.
Fotorrealismo sem estrutura de apoio no prompt
Os modelos anteriores exigiam que os usuários acrescentassem palavras-chave de melhoria de qualidade no fim de cada prompt ("photorealistic, hyperdetailed, 8K, sharp focus") só para chegar a um nível básico de qualidade. O resultado base do Phoenix já tende ao realismo visual.
A textura da pele é renderizada com detalhe visível em nível de poros. Os gradientes de luz caem naturalmente sobre as superfícies. O comportamento da profundidade de campo responde corretamente às descrições de distância focal. Você passa menos tempo contornando as fraquezas do modelo e mais tempo direcionando seus pontos fortes.
Lidando com cenas complexas
É em cenas com múltiplos sujeitos e múltiplos elementos que o Phoenix se separa mais claramente dos modelos de nível intermediário. Quando recebe um prompt com um sujeito em primeiro plano, um ambiente de fundo detalhado e uma condição de iluminação específica, o Phoenix tende a:
- Manter uma separação visual clara entre primeiro plano e fundo
- Distribuir a luz de forma realista entre todos os elementos da cena
- Preservar relações espaciais precisas entre os sujeitos
- Evitar o efeito de "sopa visual" comum em resultados de difusão de menor qualidade
Isso torna o Phoenix particularmente útil para estilos de fotografia editorial, em que vários elementos precisam coexistir de forma coerente em um único quadro.
Texto em imagens: onde o Phoenix avança
Renderizar texto legível dentro de uma imagem gerada por IA tem sido uma fraqueza persistente em toda a categoria de modelos de difusão. A maioria dos modelos produz caracteres que se parecem visualmente com texto, mas que não podem ser lidos de fato. O Phoenix traz uma melhora significativa nesse ponto, embora não seja uma solução completa.
O que ele realmente consegue fazer
O Phoenix lida com sequências curtas de texto com precisão notável. Casos de uso práticos em que ele tem bom desempenho:
- Palavras isoladas em placas, rótulos ou embalagens de produtos
- Frases curtas (de 3 a 5 palavras) em banners ou fachadas de lojas
- Textos do ambiente, como placas de rua, cartazes ou lombadas de livros
- Logotipos com elementos tipográficos simples
O modelo processa com maior prioridade o texto entre aspas no prompt. Colocar o texto desejado entre aspas dentro do prompt produz resultados mais precisos de forma consistente.
Os limites reais
Para qualquer coisa que exija controle tipográfico exato, o Phoenix ainda fica aquém das ferramentas de design feitas para isso. Fontes específicas, kerning preciso e blocos longos de texto corrido continuam pouco confiáveis. O modelo lida melhor com texto contextualmente correto, ou seja, texto que se encaixa naturalmente e se lê bem no contexto, do que com texto tipograficamente preciso.
💡 Dica: Ao pedir texto em uma imagem, escreva-o entre aspas diretamente no seu prompt: a storefront sign that reads "OPEN DAILY". Essa sintaxe melhora de forma consistente a precisão do texto nos resultados do Phoenix.
Variedade de estilos e flexibilidade
O Phoenix tem o fotorrealismo como padrão, mas seu treinamento abrange uma ampla gama de estilos. Direcioná-lo para estéticas específicas funciona de forma confiável com a linguagem de prompt certa.
Retrato e fotografia de moda
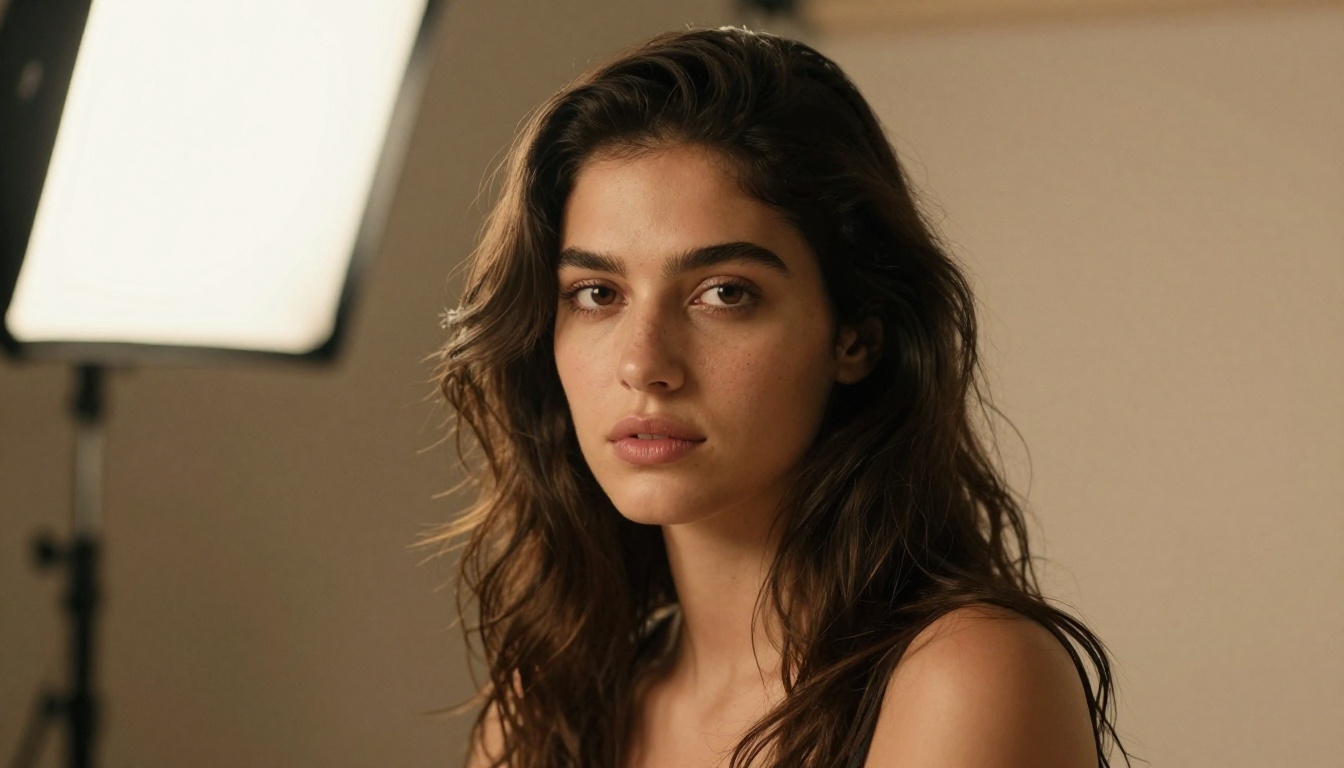
É aqui que o Phoenix tem o melhor desempenho entre as categorias com sujeitos humanos. Textura da pele, separação dos fios de cabelo, nitidez dos olhos e sutilezas de expressão são renderizados em um nível que se sustenta sob inspeção de perto. Para trabalhos editoriais de vanguarda na moda ou fotografia de estilo de vida, o Phoenix produz resultados que fotógrafos costumam considerar úteis tanto como material de referência quanto como ativos finalizados.
Imagens cinematográficas e atmosféricas
Planos cinematográficos em grande angular, paisagens atmosféricas e composições centradas no ambiente combinam bem com o Phoenix. Iluminação volumétrica, neblina, névoa e gradientes de hora dourada são renderizados com transições naturais, e não com as bordas duras artificiais que aparecem em modelos de menor qualidade. Quando os prompts incluem descritores de iluminação (volumétrica, direcional, difusa, contraluz), o Phoenix os interpreta com precisão.
Ilustração e trabalhos estilizados
Embora o fotorrealismo seja seu padrão, o Phoenix responde bem a redirecionamentos estilísticos. Prompts que incluem termos como "textura de pintura a óleo", "film noir", "ilustração editorial" ou "fotografia vintage" direcionam com sucesso o resultado para essas estéticas, mantendo o nível básico de qualidade. O modelo adapta a linguagem visual do estilo solicitado em toda a imagem, e não apenas como um filtro superficial.
Desempenho por estilo, em resumo
| Tipo de estilo | Desempenho do Phoenix | Observações |
|---|
| Retrato / Headshot | Excelente | Forte detalhe de pele e resposta natural à iluminação |
| Plano cinematográfico amplo | Excelente | Lida bem com profundidade atmosférica e luz volumétrica |
| Moda / Editorial | Muito bom | Textura de tecido consistente e precisão de pose |
| Arquitetônico | Bom | A precisão de perspectiva é confiável |
| Cenas com muito texto | Razoável | Melhor que os concorrentes, mas ainda imperfeito em escala |
| Abstrato / Surreal | Bom | Resultados variáveis, mas viáveis com prompts específicos |
O Leonardo Phoenix roda na plataforma Leonardo.ai. Veja o que saber para obter os melhores resultados, junto com estratégias de prompt que se aplicam a qualquer modelo semelhante de texto para imagem.
Estruturando seu prompt
O formato de prompt mais confiável segue uma estrutura em camadas:
[Sujeito] + [Ação ou Estado] + [Ambiente] + [Iluminação] + [Câmera ou Lente] + [Modificador de Estilo]
Exemplo:
A woman in a white silk dress standing on a coastal cliff at sunset, warm volumetric golden light from the left, 85mm lens, shallow depth of field, photorealistic RAW
Cada camada dá ao modelo uma instrução distinta para processar. O sujeito define quem ou o que está no quadro. O ambiente fornece o contexto espacial. A iluminação define o clima e a temperatura visual. Os descritores de câmera e lente indicam como a cena deve ser enquadrada e como a profundidade deve se comportar.
Quanto mais completa for cada camada, menos o modelo preencherá as lacunas com padrões genéricos.
Prompts negativos que valem a pena usar
O Phoenix responde bem a prompts negativos. As entradas a seguir valem a pena para a maioria dos casos de uso:
blurry, soft focus, low resolution, watermark, text overlaydistorted face, extra fingers, anatomical errorsoverexposed, underexposed, flat lighting
Mantenha os prompts negativos concisos. Sobrecarregá-los com 40 ou mais entradas pode criar artefatos visuais inesperados. Uma lista curta e direcionada tem desempenho melhor do que uma lista exaustiva.
Resolução e proporção
O Phoenix suporta várias proporções sem degradação significativa de qualidade em resoluções mais altas. Para conteúdo editorial e cinematográfico, 16:9 produz o enquadramento mais natural. Para retrato e moda, 4:5 ou 2:3 enquadram os sujeitos de forma mais natural. O formato quadrado funciona bem para imagens de produtos ou para ativos de redes sociais.
Configurações de guidance scale
A Guidance Scale (CFG) controla o quanto o modelo segue o seu prompt de forma estrita, em oposição à liberdade de interpretação que ele assume. Para o Phoenix, a faixa ideal costuma ficar entre 7 e 11:
- CFG 6-8: Resultado equilibrado. Bom para prompts criativos em que alguma variação é bem-vinda.
- CFG 9-11: Seguimento estrito. Melhor quando elementos visuais específicos precisam aparecer no resultado.
- CFG 12+: Pode introduzir artefatos visuais, especialmente em cenas complexas com múltiplos elementos.
💡 Dica: Se o Phoenix continuar deixando de lado um elemento específico do seu prompt, aumentar o CFG para 10-11 e gerar de novo costuma resolver. Como alternativa, mova o elemento que está sendo ignorado para o início do prompt.
Erros comuns ao usar o Phoenix
Excesso de prompt
Há uma crença difundida de que prompts mais longos produzem melhores resultados. Na prática, prompts com mais de 80-100 palavras tendem a levar o modelo a fazer uma média das instruções concorrentes, em vez de priorizar as importantes. Prompts enxutos e em camadas superam os prolixos de forma consistente.
Ignorar a camada de predefinições de estilo
A Leonardo.ai inclui predefinições de estilo que se sobrepõem ao seu prompt no nível da plataforma. Aplicar as predefinições "Photography" ou "Cinematic" sobre um prompt bem escrito costuma produzir resultados melhores do que um prompt detalhado sozinho. As predefinições oferecem orientação de estilo no nível do modelo, que reforça a direção do seu prompt sem exigir mais palavras.
Não gerar várias versões
O Phoenix, como todos os modelos generativos, produz resultados variáveis em execuções diferentes com o mesmo prompt. Gerar o mesmo prompt de 3 a 5 vezes e escolher o melhor resultado é um fluxo de trabalho profissional padrão, não um contorno para um prompt mal feito. Incluir a avaliação no seu processo de geração é mais rápido do que tentar escrever o prompt perfeito na primeira tentativa.
Como o Phoenix se compara a outros modelos
Esta comparação reflete a geração atual de modelos de texto para imagem de ponta:
| Modelo | Aderência ao prompt | Fotorrealismo | Renderização de texto | Velocidade |
|---|
| Leonardo Phoenix | Excelente | Excelente | Boa | Média |
| Flux Dev | Muito boa | Excelente | Razoável | Rápida |
| Stable Diffusion 3 | Boa | Boa | Razoável | Rápida |
| Midjourney v6 | Boa | Muito bom | Razoável | Média |
| DALL-E 3 | Excelente | Boa | Muito boa | Média |
| GPT Image 2 | Excelente | Muito bom | Excelente | Média |
O Phoenix ocupa uma posição forte quando aderência ao prompt e fotorrealismo são prioridades ao mesmo tempo. DALL-E 3 e GPT Image 2 ainda estão à frente na precisão da renderização de texto. Flux Dev e Stable Diffusion 3 são mais rápidos na geração, com qualidade de imagem competitiva. A melhor escolha depende do que o seu fluxo de trabalho exige especificamente.
Para quem prioriza realismo visual em cenas complexas e precisa de interpretação confiável de prompts detalhados, o Phoenix hoje está entre os melhores da sua categoria.
Alternativas fortes no PicassoIA
O Leonardo Phoenix não está disponível atualmente como modelo no PicassoIA, mas a plataforma hospeda vários dos melhores modelos de texto para imagem, que atendem a casos de uso semelhantes e muitas vezes sobrepostos.
Modelos Flux para trabalhos de qualidade de produção
O Flux Redux Dev, da Black Forest Labs, está entre as alternativas de código aberto mais fortes ao Phoenix. Ele produz resultados fotorrealistas com excelente retenção de detalhes em uma ampla gama de estilos visuais. Para fluxos de trabalho que exigem iteração criativa por meio de variações de imagem, ele é particularmente adequado.
Outras versões do Flux no PicassoIA incluem o Flux Fill Pro, para inpainting e preenchimento de detalhes, e o Flux Depth Pro, para geração com controle de estrutura. Juntos, eles formam um conjunto completo de ferramentas para produção de imagens em nível profissional sem sair da plataforma.
Opções de alta resolução e especializadas
O Stable Diffusion 3, da Stability AI, continua sendo uma escolha confiável, com ampla variedade de estilos e forte comunidade de apoio. Para saída em altíssima resolução, em qualidade 4K, o Seedream 4.5, da ByteDance, e o Wan 2.7 Image Pro entregam de forma consistente detalhes prontos para produção que rivalizam com a qualidade de saída do Phoenix.
Para precisão de texto dentro da imagem especificamente, o GPT Image 2, da OpenAI, continua sendo a opção mais forte disponível hoje. Ele lida com sobreposições de texto complexas dentro das imagens melhor do que qualquer outro modelo nessa faixa.
💡 O PicassoIA hospeda mais de 91 modelos de texto para imagem em uma única plataforma. Não é preciso instalação local nem lidar com APIs. Você escolhe um modelo, escreve um prompt e gera diretamente no navegador.
Os princípios por trás de uma boa saída de imagens por IA não mudam muito de um modelo para outro. Seja trabalhando com o Phoenix, o Flux ou qualquer modelo comparável, estes padrões produzem resultados melhores de forma consistente:
Especificidade vence quantidade. Três detalhes precisos superam dez vagos. "Luz quente do fim da tarde entrando por janelas voltadas para o oeste" é mais útil do que "boa iluminação com tons quentes bonitos".
A iluminação é a variável de maior impacto. Descrever de forma consistente a direção, a intensidade e a temperatura de cor da luz tem o maior impacto individual sobre a qualidade do resultado. "Luz volumétrica da manhã vinda da esquerda" afeta a composição da cena inteira, não apenas a parte de iluminação.
A linguagem de câmera e lente funciona. Expressões como "85mm f/1.4" ou "24mm grande angular" influenciam a distorção de perspectiva, o comportamento da profundidade de campo e o estilo da composição em modelos bem treinados. Esses termos não são rótulos estéticos; eles carregam um significado fotográfico real, que os modelos treinados internalizaram a partir de vastos conjuntos de dados de fotografia.
A iteração faz parte do processo. Nenhum prompt produz a imagem perfeita na primeira geração todas as vezes. Um processo de trabalho eficiente significa gerar várias variações, escolher a melhor e refinar a partir dela. Aceitar isso reduz a pressão sobre qualquer tentativa de prompt e ajuda a chegar mais rápido a um resultado final de qualidade.
Experimente no PicassoIA agora mesmo
O Leonardo Phoenix representa para onde os melhores modelos de texto para imagem estão caminhando: melhor seguimento de instruções, realismo mais consistente e resultados que não exigem experiência em engenharia de prompt para parecerem profissionais. Seja para gerar imagens editoriais, conceitos criativos, conteúdo de moda ou ativos comerciais, vale a pena conhecer o padrão de qualidade que ele estabelece.
Se você quiser testar modelos que operam nesse mesmo nível agora, o PicassoIA oferece acesso direto a mais de 90 modelos de texto para imagem em um só lugar. O Flux Redux Dev, o Seedream 4.5, o Stable Diffusion 3, o Wan 2.7 Image Pro e o GPT Image 2 estão todos disponíveis, sem instalação, sem configuração de API e sem exigências de hardware local.
Escolha um prompt, faça algumas variações em modelos diferentes e veja o que a geração atual de IA para imagens realmente produz em qualidade máxima. Os resultados costumam falar por si.


