Poner GPT-5.6 a trabajar en una base de código real
Una mirada práctica a cómo se comporta GPT-5.6 en bases de código de producción reales. Analiza la configuración de la API, el comportamiento de la ventana de contexto, la revisión de código a gran escala, la refactorización de código heredado, la generación de tests y una comparación directa con modelos rivales como Claude Sonnet 5, Grok 4 y Deepseek R1, disponibles en PicassoIA.
Seguramente ya has probado un LLM capaz con un puñado de funciones aisladas. Una utilidad limpia, una clase sencilla, quizá un componente de React sin dependencias externas. Esas demos siempre parecen impresionantes. Pero una base de código de producción es otra historia: tiene dependencias circulares, casos límite sin documentar escondidos en la lógica de negocio, módulos escritos por personas que ya no trabajan en la empresa y tests que técnicamente pasan pero que en realidad no prueban lo que dicen probar.
Poner GPT-5.6 a trabajar en una base de código real significa lanzarlo a ese caos y ver qué sobrevive. Este artículo es un relato práctico de exactamente eso, escrito después de ejecutar tres variantes de GPT-5.6 contra un monorepo de 140 000 líneas en TypeScript y Python durante varias semanas.
Qué aporta GPT-5.6 de verdad
La generación GPT-5.6 no es un único modelo. Se distribuye en tres versiones distintas del modelo, cada una afinada para un punto concreto de equilibrio entre costo y rendimiento. Si esperas encontrar un único endpoint de API que lo haga todo, te llevarás una decepción de entrada. Saber qué variante usar y cuándo es la primera habilidad real que hay que desarrollar.
Una ventana de contexto que abarca archivos completos
La principal diferencia de GPT-5.6 es la ventana de contexto. Con 256k tokens en las variantes de gama alta, puedes cargar en un solo prompt un módulo de servicio completo, sus definiciones de tipos, sus tests y su cadena de importaciones sin truncar nada. Suena a detalle menor hasta que has pasado horas fragmentando a mano un archivo de 3000 líneas en varias llamadas a la API, uniendo las salidas y depurando las costuras donde el modelo olvidó lo que había dicho 8000 tokens antes.
Con un contexto lo bastante grande como para contener archivos reales, ciertas tareas cambian de naturaleza. Una sugerencia de refactorización ya no tiene que adivinar cómo es el resto del archivo. Una auditoría de tests puede ver cada test junto a la función fuente que cubre. Un rastreo de dependencias puede seguir las importaciones sin que tú construyas a mano una ruta de migas en el prompt.
Esto no significa "enviarlo todo de una vez y esperar que salga bien". La estructura del prompt sigue importando muchísimo. Pero sí significa que el techo de lo que puedes pedir sin una ingeniería de prompts heroica ha subido de forma notable.
GPT 5.6 Luna es la variante que conectas a tu extensión del editor. La latencia es lo bastante baja como para no interrumpir el flujo de trabajo. GPT 5.6 Terra se sitúa en el término medio: suficientemente capaz para tareas serias y lo bastante rápido como para no pasarte 30 segundos mirando un indicador de carga. GPT 5.6 Sol es la opción para los problemas difíciles: rastrear un error poco frecuente a través de cinco servicios, generar un diagrama de arquitectura preciso a partir del código fuente o razonar sobre una refactorización que afecta a 40 archivos.
La diferencia de costo entre Luna y Sol es sustancial, y usar Sol para todo es la forma en que las facturas de la API crecen de manera inesperada y muy rápida.
Configurar GPT-5.6 con un repositorio real
Poner la API en marcha lleva unos diez minutos. El problema más difícil es construir la infraestructura que hace que las llamadas a la API resulten realmente útiles a escala de base de código.
Límites de tasa y estrategia de fragmentación
Incluso con una ventana de contexto grande, alcanzarás los límites de tasa en operaciones por lotes pesadas. Algunos patrones que funcionan en la práctica:
Llamadas por archivo: envía un módulo por llamada en lugar de todo el repositorio. Así las solicitudes mantienen un tamaño predecible y es trivial paralelizarlas.
Caché de resúmenes: ejecuta una llamada barata a GPT 5.6 Luna para resumir cada módulo una sola vez. Guarda esos resúmenes en caché. Úsalos como contexto en llamadas más caras a GPT 5.6 Sol sin volver a enviar el código fuente completo.
Reintentos con retroceso exponencial: los errores de límite de tasa son transitorios. Un sencillo envoltorio de reintentos con esperas de 2, 4 y 8 segundos resuelve la gran mayoría sin intervención manual.
La cuestión de la fragmentación importa sobre todo en las refactorizaciones. Si le pides al modelo que renombre un tipo en toda una base de código, debes fragmentar por archivo, ejecutar cada fragmento y aplicar los parches de forma programática. Pedir un renombrado global en un solo prompt y esperar que el modelo se mantenga coherente en 80 archivos no es una estrategia fiable.
Elegir la variante adecuada para cada tarea
Un árbol de decisión práctico para enrutar tareas:
¿Es un autocompletado rápido o una sugerencia breve en línea? Usa GPT 5.6 Luna.
¿Es un borrador de una funcionalidad nueva o la generación de documentación? Usa GPT 5.6 Terra.
¿Es un rastreo de error complejo, una pregunta de arquitectura o un plan de refactorización de varios archivos? Usa GPT 5.6 Sol.
Enrutar bien desde el principio evita una parte considerable del gasto innecesario en la API y acelera tu ciclo de iteración.
Dónde GPT-5.6 se gana su lugar
No todas las afirmaciones que se hacen sobre los LLM en el desarrollo de software resisten en condiciones reales. Algunas sí. Aquí es donde GPT-5.6 aporta valor real en una base de código de producción.
Revisión de código a gran escala
GPT-5.6 es realmente útil para revisar código cuando le das el alcance adecuado. El patrón que funciona: envía el diff completo de una pull request junto con los archivos fuente relevantes que toca el diff. Pide categorías de revisión concretas en lugar de un genérico "revisa este código".
Los prompts de revisión eficaces se centran en:
Identificación de casos límite: "Enumera cada condición de entrada en la que esta función podría fallar o producir una salida incorrecta."
Lagunas de seguridad de tipos: "Encuentra cada lugar donde se hace una aserción de tipo sin una comprobación correspondiente."
Coherencia de patrones: "Este código usa el patrón repositorio para el acceso a datos. ¿Esta PR se desvía de ese patrón en algún punto?"
💡 Tip: La especificidad del prompt lo es todo. "Revisa este código" produce una salida genérica. "Enumera cada lugar donde esta función modifica su argumento de entrada" produce algo que puedes aplicar de inmediato.
En un lote de 30 pull requests revisadas durante una semana, GPT 5.6 Sol detectó 14 problemas que los revisores humanos ya habían marcado como aprobados. Siete eran errores legítimos, tres eran regresiones de rendimiento y cuatro eran incoherencias en la documentación. La tasa de falsos positivos rondó el 20 %, lo que significa que aproximadamente uno de cada cinco elementos marcados requería un juicio humano para descartarlo.
Refactorizar código heredado
Este es el caso de uso de mayor impacto y mayor riesgo. GPT-5.6 puede tomar una clase de 500 líneas con responsabilidades enredadas y producir una propuesta de descomposición bien pensada en menos de un minuto. Las propuestas suelen ser estructuralmente sólidas. El riesgo está en confiar en la salida sin verificarla contra los puntos de llamada reales.
El patrón seguro para refactorizar con GPT-5.6:
Pide al modelo un plan de refactorización, no el código refactorizado.
Revisa el plan e identifica qué puntos de llamada no tiene a la vista.
Proporciona esos puntos de llamada como contexto adicional y pide al modelo que revise el plan.
Solo entonces genera el código refactorizado.
Ejecuta tu suite de tests completa. Trata los resultados en rojo como la señal principal, no la confianza declarada del modelo.
Saltarse el paso cuatro y fiarse de la confianza del modelo sobre su propia salida es el punto en el que la mayoría de las refactorizaciones asistidas por LLM salen mal.
Escribir tests desde cero
Para código nuevo que necesita cobertura de tests, GPT-5.6 es el camino más rápido hacia un archivo de tests funcional. Dada la función fuente y las firmas de tipos de sus dependencias, produce en la mayoría de los casos tests bien estructurados con casos límite realistas.
La calidad varía según la complejidad de la función. Funciones puras sin efectos secundarios: salida de tests excelente, casi siempre utilizable directamente. Funciones con dependencias simuladas (mocks): buena estructura, pero algún error de tipos ocasional en la configuración de los mocks que requiere corrección manual. Funciones que dependen del estado de la base de datos o de servicios externos: la estructura del test es útil, pero los fixtures suelen estar mal y necesitan una edición profunda.
Una expectativa razonable es que GPT 5.6 Terra reduzca el tiempo de escritura de tests entre un 50 y un 60 % para la mayoría de los desarrolladores cuando se usa bien. No elimina la necesidad de leer y verificar cada test que produce.
Dónde todavía se queda corto
Saber dónde falla GPT-5.6 es tan útil como saber dónde acierta.
Importaciones y dependencias alucinadas
GPT-5.6 alucina importaciones de bibliotecas con una frecuencia que resulta molesta pero no catastrófica. Las alucinaciones tienden a caer en dos patrones:
Nombres de paquetes plausibles pero incorrectos: el modelo inventa un paquete que no existe o usa un nombre antiguo para un paquete que se renombró en una versión mayor.
Suposiciones de versión erróneas: importa una función que se eliminó en una actualización reciente, o usa una firma de parámetros de una versión anterior de la API a la que fija tu proyecto.
La solución es sencilla pero exige disciplina: ejecuta siempre una comprobación package.json o requirements.txt sobre cualquier importación que haga el modelo antes de ejecutar el código generado. Una búsqueda rápida con grep de cualquier importación añadida por el modelo que no aparezca en tu archivo de bloqueo detecta el 90 % de estos problemas antes de que te hagan perder tiempo.
Coherencia en archivos largos
Cuando envías a GPT-5.6 un archivo grande y pides cambios en varios puntos, el modelo a veces introduce incoherencias entre secciones. Puede renombrar una variable en el cuerpo de la función pero no en el comentario JSDoc de encima, o cambiar un patrón de manejo de errores en una rama y dejar el patrón antiguo en una rama hermana.
Esto no es un fallo de razonamiento. Es una consecuencia de la generación a nivel de token en un contexto muy largo, donde la atención a las secciones anteriores se degrada. La solución práctica: divide los cambios que afectan a varias ubicaciones en llamadas separadas, un cambio por prompt. Es más lento, pero la calidad de la salida es notablemente más constante y puedes verificar cada cambio por separado antes de aplicar el siguiente.
GPT-5.6 frente a otros LLM de programación
GPT-5.6 no es el único modelo capaz para tareas de desarrollo de software. El panorama de los LLM a mediados de 2026 es realmente competitivo, y ningún modelo gana en todas las categorías.
Claude Sonnet 5 es el competidor más cercano de GPT-5.6 en tareas de programación. Produce menos importaciones alucinadas y maneja mejor la coherencia en archivos largos en la mayoría de los casos. Grok 4 tiene un techo de contexto más pequeño, pero razona bien sobre la complejidad algorítmica, lo que lo hace valioso cuando necesitas evaluar el perfil de rendimiento de una función. Deepseek R1 se gana su lugar en tareas con mucho razonamiento en las que quieres ver una cadena de pensamiento antes de decidirte por una solución.
La respuesta honesta es que alternar entre modelos según el tipo de tarea funciona mejor que apostar por un único modelo para todo. GPT-5.6 Sol gana en potencia pura de razonamiento sobre código. Claude Sonnet 5 gana en coherencia y calidad de la documentación. Kimi K2 Instruct merece la pena incluirlo para tareas en línea sensibles a la velocidad.
Usar LLM en PicassoIA para programar
PicassoIA ofrece acceso directo a las tres variantes de GPT-5.6 junto con todo el panorama competitivo de LLM capaces de programar. Esto significa que puedes ejecutar GPT 5.6 Luna para una iteración rápida sobre una funcionalidad, cambiar a GPT 5.6 Sol cuando te topes con una pregunta de arquitectura y comparar la salida con Claude Sonnet 5 o Claude Fable 5 sin cambiar de plataforma ni gestionar varias credenciales de API.
GPT-5.6 Luna para iteraciones rápidas
GPT 5.6 Luna está diseñada para tareas de baja latencia en las que necesitas una respuesta en menos de dos segundos. En un flujo de trabajo de programación, eso significa completados en línea, explicaciones rápidas del comportamiento de una función y comprobaciones rápidas de firmas de tipos. En PicassoIA está disponible sin restricciones de tasa durante el uso estándar, lo que lo hace práctico para flujos de trabajo en el editor con mucho volumen.
Tareas concretas en las que Luna saca partido a su velocidad:
Autocompletar la firma de una función a partir de su docstring
Explicar en lenguaje llano una expresión regular críptica
Generar un test unitario rápido para una función pura antes de pasar a la siguiente tarea
Traducir un fragmento de Python a TypeScript manteniendo la seguridad de tipos
GPT-5.6 Sol para razonamiento complejo
GPT 5.6 Sol es donde inviertes más tiempo en construir el prompt, porque la tarea lo justifica. En PicassoIA, Sol usa los mismos pesos del modelo disponibles mediante acceso directo a la API. No hay penalización de calidad en comparación con llamar al endpoint directamente.
Casos de uso que justifican la profundidad de razonamiento de Sol:
Rastrear una condición de carrera en una base de código asíncrona
Diseñar un plan de migración para un cambio de esquema de base de datos que afecta a 15 tablas
Producir una auditoría de seguridad de un módulo de autenticación con un razonamiento detallado para cada patrón señalado
Planificar un cambio de API que rompe compatibilidad, con un análisis de compatibilidad hacia atrás
Para los modelos que se sitúan entre Luna y Sol en su perfil de capacidad, Granite 8B Code Instruct 128K merece la pena evaluarlo por su entrenamiento específico en código con 128k. Funciona bien en tareas a nivel de repositorio en las que el requisito principal es seguir una convención de código coherente a lo largo de un archivo largo.
Construir un flujo de trabajo de prompts que aguante
El uso táctico de LLM sirve para tareas puntuales. Si quieres integrar GPT-5.6 en un flujo de trabajo de equipo, necesitas una infraestructura de prompts: plantillas reutilizables, prompts de sistema versionados y convenciones claras sobre qué modelo se encarga de cada tipo de tarea.
Plantillas de prompts para tareas de código
Los patrones de prompt más duraderos para tareas de código siguen esta estructura:
Role: You are a senior {language} engineer reviewing production code.
Context: {file_content}
Constraint: {specific_rule}
Task: {specific_ask}
Output format: Numbered list. Each item: LINE NUMBER, ISSUE TYPE, EXPLANATION, SUGGESTED FIX
El campo Output format tiene un efecto desproporcionado en la usabilidad. Cuando el modelo sabe que debe producir una lista numerada con un esquema concreto, la salida se puede procesar directamente con un script que crea comentarios en GitHub, tickets en Jira o notificaciones en Slack. La prosa sin estructura cuesta más integrarla y es más probable que se ignore en la práctica.
Guarda estas plantillas en el propio repositorio, versionadas junto al código. Así cualquier miembro del equipo puede mejorar un prompt mediante una pull request normal, y tienes un registro natural de lo que funcionó y lo que no.
💡 Tip: Fija la versión de tu plantilla junto con el nombre del modelo en tu configuración de CI. Una actualización del prompt debe ser un cambio deliberado y revisado, no algo que altere el comportamiento en silencio en cada ejecución.
Integrar tu pipeline de CI
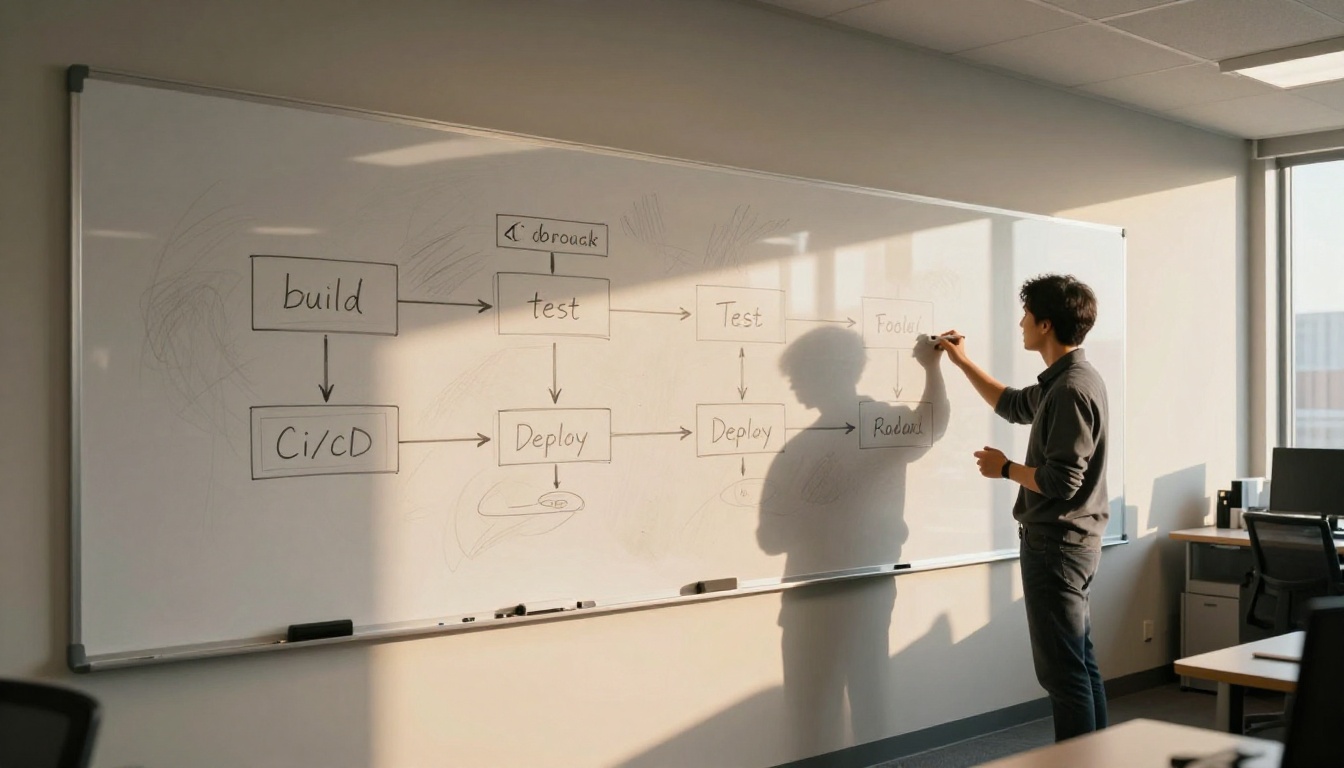
El retorno de inversión más constante de GPT-5.6 en un entorno de equipo llega al ejecutarlo cuando se abre una pull request. Un trabajo de CI que:
Extrae el diff de la PR
Carga los archivos fuente afectados
Los envía a GPT 5.6 Sol con una plantilla de revisión
Publica los elementos marcados como comentarios en línea de la PR
...no sustituye la revisión humana. Significa que, cuando una persona revisora abre la PR, los problemas mecánicos ya están identificados. La atención de la persona revisora puede centrarse en las decisiones de criterio que requieren contexto humano: la validez de la lógica de negocio, las contrapartidas arquitectónicas y las preocupaciones sobre la mantenibilidad a largo plazo.
La implementación ronda entre 80 y 100 líneas de código, según tu sistema de CI. La inversión de tiempo se amortiza en las dos o tres primeras PR en las que la revisión automática detecta un error real antes de que una persona tuviera que localizarlo.
El punto de partida práctico: toma una pull request real de tu sprint actual. Envía su diff junto con los archivos afectados a GPT 5.6 Sol con un prompt de revisión concreto. Compara lo que detecta con lo que encontraron las personas revisoras de tu equipo. Ese único experimento te dirá más sobre el retorno real que cualquier benchmark.
Si quieres ir más allá, el modelo GPT 5 Pro de PicassoIA incluye cadenas de razonamiento extendido que resultan útiles para decisiones de arquitectura en las que quieres rastrear el razonamiento del modelo antes de confiar en su salida. Para equipos que trabajan con varios lenguajes de programación en el mismo repositorio, Claude Opus 4.7 gestiona bases de código políglotas con una coherencia notablemente sólida entre lenguajes.
Montar un flujo de trabajo productivo con GPT-5.6 en una base de código real lleva una o dos semanas de iteración. Los patrones descritos aquí son los que sobrevivieron al contacto con las condiciones reales de producción. Elige el que aborde el dolor más recurrente de tu equipo, ponlo en marcha durante una semana y mide la calidad de la salida frente a tu referencia inicial. Ese ciclo de retroalimentación es lo que separa una mejora real del flujo de trabajo de la simple adopción de una herramienta para la galería.
Ve a PicassoIA y ejecuta hoy tu primer prompt sobre una base de código real. Los modelos te esperan, y tu próxima pull request es el banco de pruebas perfecto.