Colocando o GPT-5.6 para trabalhar em uma base de código real
Um olhar prático sobre como o GPT-5.6 se sai em bases de código reais de produção. Analisa a configuração da API, o comportamento da janela de contexto, revisão de código em escala, refatoração de código legado, geração de testes e uma comparação direta com modelos concorrentes como Claude Sonnet 5, Grok 4 e Deepseek R1, disponíveis no PicassoIA.
Você provavelmente já testou um LLM capaz em algumas funções isoladas. Um utilitário limpo, uma classe simples, talvez um componente React sem dependências externas. Essas demonstrações sempre parecem impressionantes. Mas uma base de código de produção é um animal bem diferente: tem dependências circulares, casos extremos não documentados embutidos na lógica de negócio, módulos escritos por pessoas que não trabalham mais na empresa e testes que tecnicamente passam, mas não testam de fato o que dizem testar.
Usar o GPT-5.6 em uma base de código real significa jogá-lo nessa bagunça e ver o que sobrevive. Este artigo é um relato prático exatamente disso, escrito depois de rodar três variantes do GPT-5.6 contra um monorepo de 140.000 linhas em TypeScript e Python ao longo de várias semanas.
O que o GPT-5.6 realmente traz
A geração GPT-5.6 não é um modelo único. Ela vem em três variantes distintas, cada uma ajustada para um ponto específico de custo e desempenho. Se você chegar esperando um único endpoint de API que dê conta de tudo, vai se decepcionar logo de cara. Saber qual variante chamar e quando é a primeira habilidade real a desenvolver.
Janela de contexto que engole arquivos inteiros
A grande diferença do GPT-5.6 é a janela de contexto. Com 256 mil tokens nas variantes de nível mais alto, você pode carregar um módulo de serviço inteiro, suas definições de tipo, seus testes e sua cadeia de importações em um único prompt, sem truncar nada. Isso parece um detalhe pequeno até você ter passado horas dividindo manualmente um arquivo de 3.000 linhas em várias chamadas de API, juntando as saídas e depurando as emendas onde o modelo esqueceu o que tinha dito 8.000 tokens antes.
Com um contexto grande o bastante para conter arquivos reais, certas tarefas mudam de natureza. Uma sugestão de refatoração não precisa mais adivinhar como é o resto do arquivo. Uma auditoria de testes consegue ver todos os testes ao lado da função de origem que cobrem. Um rastreamento de dependências consegue seguir as importações sem que você precise montar uma trilha manual no prompt.
Isso não quer dizer "mandar tudo de uma vez e torcer". A estrutura do prompt continua importando muito. Mas significa que o limite do que você pode pedir sem engenharia de prompt heroica subiu de forma significativa.
GPT 5.6 Luna é a variante que você conecta à extensão do seu editor. A latência é baixa o suficiente para não interromper o fluxo. GPT 5.6 Terra fica no meio: capaz o bastante para tarefas sérias, rápido o bastante para você não ficar olhando um spinner por 30 segundos. GPT 5.6 Sol é para os problemas difíceis: rastrear um bug obscuro em cinco serviços, gerar um diagrama de arquitetura preciso a partir do código-fonte ou raciocinar sobre uma refatoração que toca 40 arquivos.
A diferença de custo entre Luna e Sol é substancial, e usar Sol para tudo é a forma como as contas de API crescem de forma inesperada e rápida.
Configurando o GPT-5.6 em um repositório real
Colocar a API para funcionar leva cerca de dez minutos. O problema mais difícil é construir a estrutura que faz as chamadas de API realmente úteis em escala de base de código.
Limites de taxa e estratégia de fragmentação
Mesmo com uma janela de contexto grande, você vai atingir limites de taxa durante operações em lote pesadas. Alguns padrões que funcionam na prática:
Chamadas por arquivo: envie um módulo por chamada em vez do repositório inteiro. Isso mantém o tamanho de cada requisição previsível e torna trivial paralelizar.
Cache de resumos: rode uma chamada barata de GPT 5.6 Luna para resumir cada módulo uma vez. Guarde esses resumos em cache. Use-os como contexto em chamadas mais caras de GPT 5.6 Sol sem reenviar o código-fonte completo.
Nova tentativa com backoff exponencial: erros de limite de taxa são transitórios. Um wrapper de nova tentativa simples, com atrasos de 2, 4 e 8 segundos, resolve a grande maioria sem intervenção manual.
A questão da fragmentação importa mais nas refatorações. Se você pede ao modelo para renomear um tipo em uma base de código inteira, precisa fragmentar por arquivo, rodar cada fragmento e aplicar os patches de forma programática. Pedir uma renomeação global em um único prompt e esperar que o modelo se mantenha consistente em 80 arquivos não é uma estratégia confiável.
Escolhendo a variante certa para a tarefa
Uma árvore de decisão de roteamento prática:
É um autocompletar rápido ou uma sugestão curta em linha? Use GPT 5.6 Luna.
É um rascunho de nova funcionalidade ou geração de documentação? Use GPT 5.6 Terra.
É um rastreamento de bug complexo, uma questão de arquitetura ou um plano de refatoração de vários arquivos? Use GPT 5.6 Sol.
Rotear corretamente desde o início evita uma parcela significativa de gastos desnecessários com API e acelera seu ciclo de iteração.
Onde o GPT-5.6 conquista seu lugar
Nem toda afirmação feita sobre LLMs no desenvolvimento de software se sustenta em condições reais. Algumas se sustentam. Veja onde o GPT-5.6 realmente entrega em uma base de código de produção.
Revisão de código em escala
O GPT-5.6 é genuinamente útil para revisão de código quando você lhe dá o escopo certo. O padrão que funciona: envie o diff completo de um pull request junto com os arquivos de código-fonte relevantes que o diff toca. Peça categorias específicas de revisão em vez de um genérico "revise este código".
Prompts de revisão eficazes se concentram em:
Identificação de casos extremos: "Liste cada condição de entrada em que esta função poderia entrar em pânico ou produzir uma saída incorreta."
Lacunas de segurança de tipo: "Encontre todos os pontos em que uma asserção de tipo é feita sem uma verificação correspondente."
Consistência de padrões: "Esta base de código usa o padrão repositório para acesso a dados. Este PR se desvia desse padrão em algum ponto?"
💡 Dica: a especificidade do prompt é tudo. "Revise este código" produz uma saída genérica. "Liste todos os pontos em que esta função altera seu argumento de entrada" produz algo que você pode usar imediatamente.
Em um lote de 30 pull requests revisados ao longo de uma semana, GPT 5.6 Sol apontou 14 problemas que revisores humanos já tinham marcado como aprovados. Sete eram bugs legítimos, três eram regressões de desempenho e quatro eram inconsistências de documentação. A taxa de falsos positivos ficou em torno de 20%, o que significa que cerca de um em cada cinco itens sinalizados exigiu um julgamento humano para ser descartado.
Refatorando código legado
Este é o caso de uso de maior impacto e também o de maior risco. O GPT-5.6 consegue pegar uma classe de 500 linhas com responsabilidades emaranhadas e propor uma decomposição bem pensada em menos de um minuto. As propostas costumam ser estruturalmente sólidas. O risco está em confiar no resultado sem verificá-lo contra os pontos de chamada reais.
O padrão seguro para refatorar com o GPT-5.6:
Peça ao modelo um plano de refatoração, não o código refatorado.
Revise o plano e identifique para quais pontos de chamada ele não tem visibilidade.
Forneça esses pontos de chamada como contexto adicional e peça ao modelo para revisar.
Só então gere o código refatorado.
Rode sua suíte de testes completa. Trate as falhas de teste como o sinal principal, não a confiança declarada do modelo.
Pular o passo quatro e confiar na confiança do modelo sobre a própria saída é onde a maioria das refatorações assistidas por LLM dá errado.
Escrevendo testes do zero
Para código novo que precisa de cobertura de testes, o GPT-5.6 é o caminho mais rápido até um arquivo de teste funcional. Dada a função de origem e as assinaturas de tipo de suas dependências, ele produz testes bem estruturados com casos extremos realistas na maioria dos casos.
A qualidade varia conforme a complexidade da função. Funções puras, sem efeitos colaterais: saída de teste excelente, quase sempre utilizável diretamente. Funções com dependências simuladas (mocks): boa estrutura, mas erros de tipo ocasionais na configuração dos mocks que precisam de correção manual. Funções que dependem de estado de banco de dados ou de serviços externos: a estrutura do teste é útil, mas as fixtures costumam estar erradas e precisam de bastante edição.
Uma expectativa razoável é que GPT 5.6 Terra reduza em 50-60% o tempo de escrita de testes para a maioria dos desenvolvedores, quando usado corretamente. Ele não elimina a necessidade de ler e verificar cada teste que produz.
Onde ele ainda fica devendo
Saber onde o GPT-5.6 falha é tão útil quanto saber onde ele acerta.
Importações e dependências alucinadas
O GPT-5.6 alucina importações de bibliotecas em um ritmo que é inconveniente, mas não catastrófico. As alucinações tendem a cair em dois padrões:
Nomes de pacotes plausíveis, mas errados: o modelo inventa um pacote que não existe, ou usa um nome antigo para um pacote que foi renomeado em uma versão principal.
Suposições erradas de versão: ele importa uma função que foi removida em uma atualização recente, ou usa uma assinatura de parâmetro de uma versão mais antiga da API do que a que seu projeto fixa.
A correção é simples, mas exige disciplina: sempre rode uma verificação package.json ou requirements.txt contra tudo o que o modelo importa antes de executar o código gerado. Uma busca rápida por qualquer importação que o modelo adicionou e que não aparece no seu arquivo de lock pega 90% desses problemas antes que eles façam você perder tempo.
Consistência em arquivos longos
Quando você envia um arquivo grande ao GPT-5.6 e pede mudanças em vários pontos, o modelo às vezes introduz inconsistências entre as seções. Ele pode renomear uma variável no corpo da função, mas não no comentário JSDoc acima dela, ou mudar um padrão de tratamento de erros em um ramo e deixar o padrão antigo em um ramo irmão.
Isso não é uma falha de raciocínio. É uma consequência da geração em nível de token em um contexto muito longo, em que a atenção às seções anteriores enfraquece. A solução prática: quebre as mudanças em vários pontos em chamadas separadas, uma mudança por prompt. É mais lento, mas a qualidade da saída fica significativamente mais consistente, e você pode verificar cada mudança individualmente antes de aplicar a próxima.
GPT-5.6 comparado com outros LLMs de programação
O GPT-5.6 não é o único modelo capaz para tarefas de desenvolvimento de software. O cenário de LLMs em meados de 2026 é genuinamente competitivo, e nenhum modelo único vence em todas as categorias.
Claude Sonnet 5 é o concorrente mais próximo do GPT-5.6 em tarefas de código. Ele produz menos importações alucinadas e lida melhor com a consistência em arquivos longos na maioria dos casos. Grok 4 tem um teto de contexto menor, mas raciocina bem sobre complexidade algorítmica, o que o torna útil quando você precisa avaliar o perfil de desempenho de uma função. Deepseek R1 se justifica em tarefas com muito raciocínio, em que você quer uma saída de cadeia de pensamento antes de se comprometer com uma solução.
A resposta honesta é que alternar entre modelos conforme o tipo de tarefa funciona melhor do que apostar em um único modelo para tudo. O GPT-5.6 Sol vence em poder bruto de raciocínio sobre código. Claude Sonnet 5 vence em consistência e qualidade de documentação. Kimi K2 Instruct vale a pena para tarefas em linha sensíveis à velocidade.
Usando LLMs no PicassoIA para programação
O PicassoIA oferece acesso direto às três variantes do GPT-5.6, junto com todo o cenário competitivo de LLMs capazes de programar. Isso significa que você pode rodar GPT 5.6 Luna para iteração rápida em uma funcionalidade, mudar para GPT 5.6 Sol quando surgir uma questão de arquitetura e comparar a saída com Claude Sonnet 5 ou Claude Fable 5 sem trocar de plataforma nem gerenciar várias credenciais de API.
GPT-5.6 Luna para iterações rápidas
GPT 5.6 Luna foi projetado para tarefas de baixa latência em que você precisa de uma resposta em menos de dois segundos. Em um fluxo de programação, isso significa completações em linha, explicações rápidas sobre o comportamento de uma função e verificações rápidas de assinaturas de tipo. No PicassoIA, ele está disponível sem restrições de taxa durante o uso padrão, o que o torna prático para fluxos de trabalho de alto volume no editor.
Tarefas específicas em que a Luna justifica sua vantagem de velocidade:
Autocompletar a assinatura de uma função a partir da sua docstring
Explicar uma expressão regular obscura em linguagem simples
Gerar um teste unitário rápido para uma função pura antes de passar para a próxima tarefa
Traduzir um trecho de Python para TypeScript mantendo a segurança de tipo
GPT-5.6 Sol para raciocínio complexo
GPT 5.6 Sol é onde você investe mais tempo na construção do prompt, porque a tarefa justifica. No PicassoIA, o Sol roda os mesmos pesos de modelo disponíveis por acesso direto à API. Não há perda de qualidade em comparação com chamar o endpoint diretamente.
Casos de uso que justificam a profundidade de raciocínio do Sol:
Rastrear uma condição de corrida em uma base de código assíncrona
Desenhar um plano de migração para uma mudança de esquema de banco de dados que afeta 15 tabelas
Produzir uma auditoria de segurança de um módulo de autenticação, com raciocínio detalhado para cada padrão sinalizado
Planejar uma mudança de API que quebra compatibilidade, com análise de compatibilidade retroativa
Para modelos que ficam entre Luna e Sol em perfil de capacidade, vale avaliar o Granite 8B Code Instruct 128K pelo seu treinamento específico em código com 128k. Ele se sai bem em tarefas no nível de repositório em que o requisito principal é seguir uma convenção de código consistente ao longo de um arquivo extenso.
Construindo um fluxo de prompts que se sustenta
O uso tático de LLMs é adequado para tarefas pontuais. Se você quer o GPT-5.6 integrado a um fluxo de trabalho de equipe, precisa de infraestrutura de prompts: modelos reutilizáveis, prompts de sistema versionados e convenções claras sobre qual modelo cuida de cada tipo de tarefa.
Modelos de prompt para tarefas de código
Os padrões de prompt mais duradouros para tarefas de código seguem esta estrutura:
Role: You are a senior {language} engineer reviewing production code.
Context: {file_content}
Constraint: {specific_rule}
Task: {specific_ask}
Output format: Numbered list. Each item: LINE NUMBER, ISSUE TYPE, EXPLANATION, SUGGESTED FIX
O campo Output format tem um efeito desproporcional na usabilidade. Quando o modelo sabe que precisa produzir uma lista numerada com um esquema específico, a saída pode ser lida diretamente por um script que cria comentários no GitHub, tickets no Jira ou notificações no Slack. Prosa não estruturada é mais difícil de integrar e tem mais chances de ser ignorada na prática.
Guarde esses modelos no próprio repositório, versionados junto com o código. Assim, qualquer membro da equipe pode melhorar um prompt por meio de um pull request normal, e você ganha um registro natural do que funcionou e do que não funcionou.
💡 Dica: fixe a versão do seu modelo de prompt junto com o nome do modelo na sua configuração de CI. Uma atualização de prompt deve ser uma mudança deliberada e revisada, e não algo que altere o comportamento silenciosamente a cada execução.
Integrando ao seu pipeline de CI
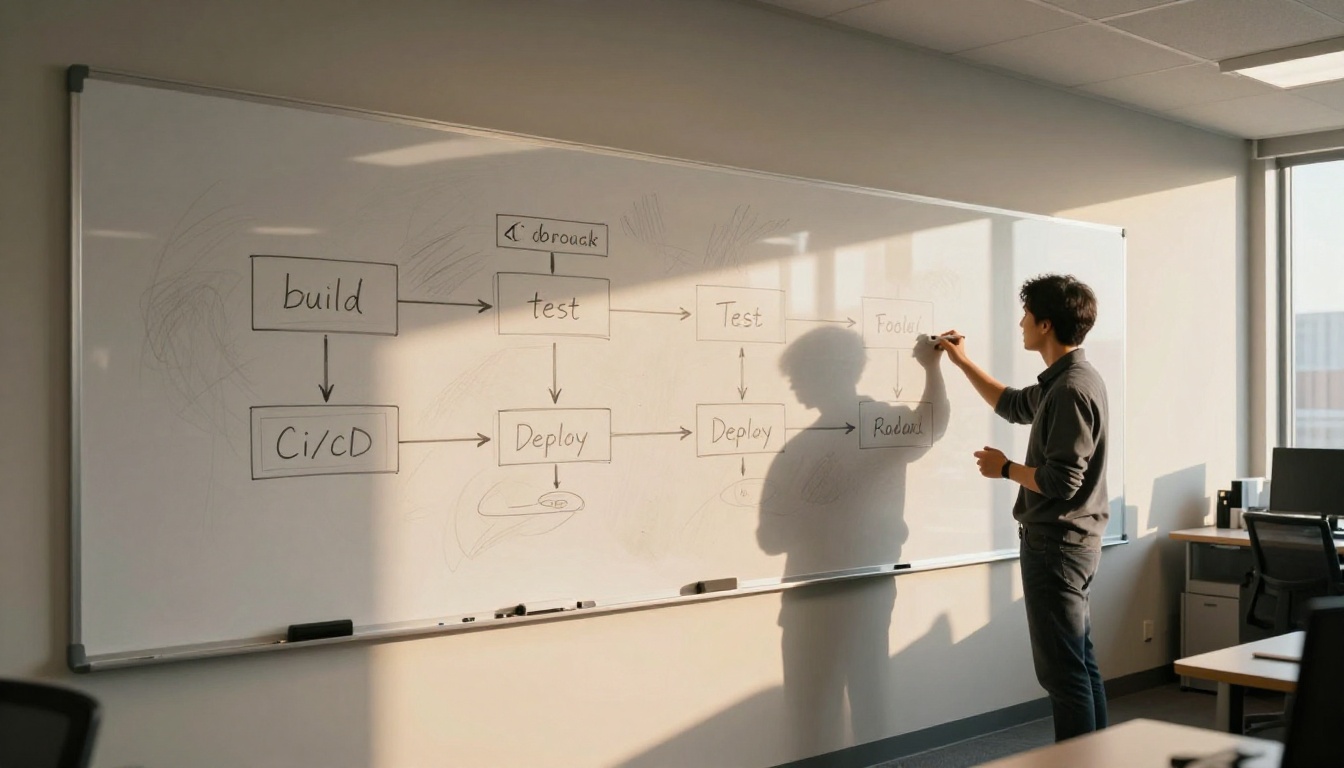
O retorno mais consistente do GPT-5.6 em um ambiente de equipe vem de rodá-lo no momento em que um pull request é aberto. Um job de CI que:
Extrai o diff do PR
Carrega os arquivos de código-fonte afetados
Envia tudo para GPT 5.6 Sol com um modelo de revisão
Publica os itens sinalizados como comentários inline no PR
...não substitui a revisão humana. Significa que, quando um revisor humano abre o PR, os problemas mecânicos já foram identificados. A atenção do revisor pode ir para os julgamentos que exigem contexto humano: validade da lógica de negócio, trade-offs de arquitetura e preocupações de manutenibilidade de longo prazo.
A implementação tem cerca de 80 a 100 linhas de código, dependendo do seu sistema de CI. O investimento de tempo se paga nos dois ou três primeiros PRs em que a revisão automatizada pega um bug real antes de um humano precisar percebê-lo.
O lugar prático para começar: pegue um pull request real da sua sprint atual. Envie o diff e os arquivos afetados para GPT 5.6 Sol com um prompt de revisão focado. Compare o que ele aponta com o que os revisores humanos da sua equipe pegaram. Esse único experimento vai te dizer mais sobre o retorno real do que qualquer benchmark.
Se você quiser ir além, o modelo GPT 5 Pro no PicassoIA inclui cadeias de raciocínio estendido úteis para decisões de arquitetura, em que você quer acompanhar o raciocínio do modelo antes de confiar na saída. Para equipes que trabalham com várias linguagens de programação no mesmo repositório, o Claude Opus 4.7 lida com bases de código poliglotas com consistência notavelmente forte entre linguagens.
Construir um fluxo de trabalho produtivo com o GPT-5.6 em uma base de código real leva uma ou duas semanas de iteração. Os padrões descritos aqui são os que sobreviveram ao contato com condições reais de produção. Escolha o que atende à dor mais constante da sua equipe, rode por uma semana e meça a qualidade da saída em relação à sua referência. Esse ciclo de feedback é o que separa uma melhoria genuína no fluxo de trabalho da adoção de ferramentas só de fachada.
Vá até o PicassoIA e rode hoje o seu primeiro prompt em uma base de código real. Os modelos estão esperando, e o seu próximo pull request é o campo de prova perfeito.