La diferencia entre un video generado por IA que parece impresionante y uno que resulta real se reduce a una cosa: la física. Cualquier modelo puede producir una iluminación bonita y texturas nítidas. Lo que separa el video con IA de calidad profesional del contenido de novedad es si un objeto que cae acelera al ritmo correcto, si el agua se deforma de verdad al impactar, o si el humo se arremolina con una impredecibilidad turbulenta en lugar de repetirse como un salvapantallas. Seedance 2.0, de ByteDance, y Veo 3.1, de Google, son ahora dos de los contendientes más sólidos en video con IA, y ahí es donde se nota la diferencia real en el manejo de la física. Este enfrentamiento directo somete a ambos a pruebas controladas en seis categorías básicas de física, para que sepas exactamente cuál elegir en tu próximo proyecto.
Lo que revelan de verdad las pruebas de física
La mayoría de las comparativas entre modelos de video con IA se centran en la estética: la gradación de color, la resolución, la fidelidad al prompt. Las pruebas de física van más allá. Comprueban si el modelo ha interiorizado las leyes del mundo físico o si solo produce un movimiento verosímil que se derrumba al examinarlo de cerca.
Las pruebas utilizadas aquí se dividen en seis categorías: gravedad y caída libre, dinámica de fluidos, colisión de cuerpos rígidos, sistemas de humo y partículas, telas y tejidos y realismo del movimiento de cámara. Cada prueba usa una estructura de prompt constante, los mismos ajustes de resolución y varias ejecuciones para tener en cuenta la variación. Los resultados que se muestran a continuación representan el comportamiento medio, no resultados escogidos a dedo.
Por qué la gravedad se falsea tanto
La gravedad es engañosamente difícil para los modelos de video. La física es sencilla: los objetos aceleran a 9,8 m/s² hacia abajo. Pero la huella visual de una gravedad correcta es sutil. Un objeto que cae un poco más despacio de lo debido parece flotar. Un objeto que se frena cerca del suelo, aunque sea de forma imperceptible, resulta incorrecto para cualquier ojo entrenado. La mayoría de los modelos de video con IA se inclinan por un movimiento lento y suave, porque en los datos de entrenamiento eso parece "cinematográfico". El resultado es una especie de flotación que rompe la inmersión en clips por lo demás pulidos.
💡 Qué observar: Los primeros 10 fotogramas de un clip de objeto que cae lo revelan todo. Una aceleración correcta hace que la distancia entre fotogramas sea notablemente mayor que la anterior. Una separación uniforme indica que el modelo está interpolando de forma lineal en lugar de simular la física real.
La dinámica de fluidos como verdadero benchmark
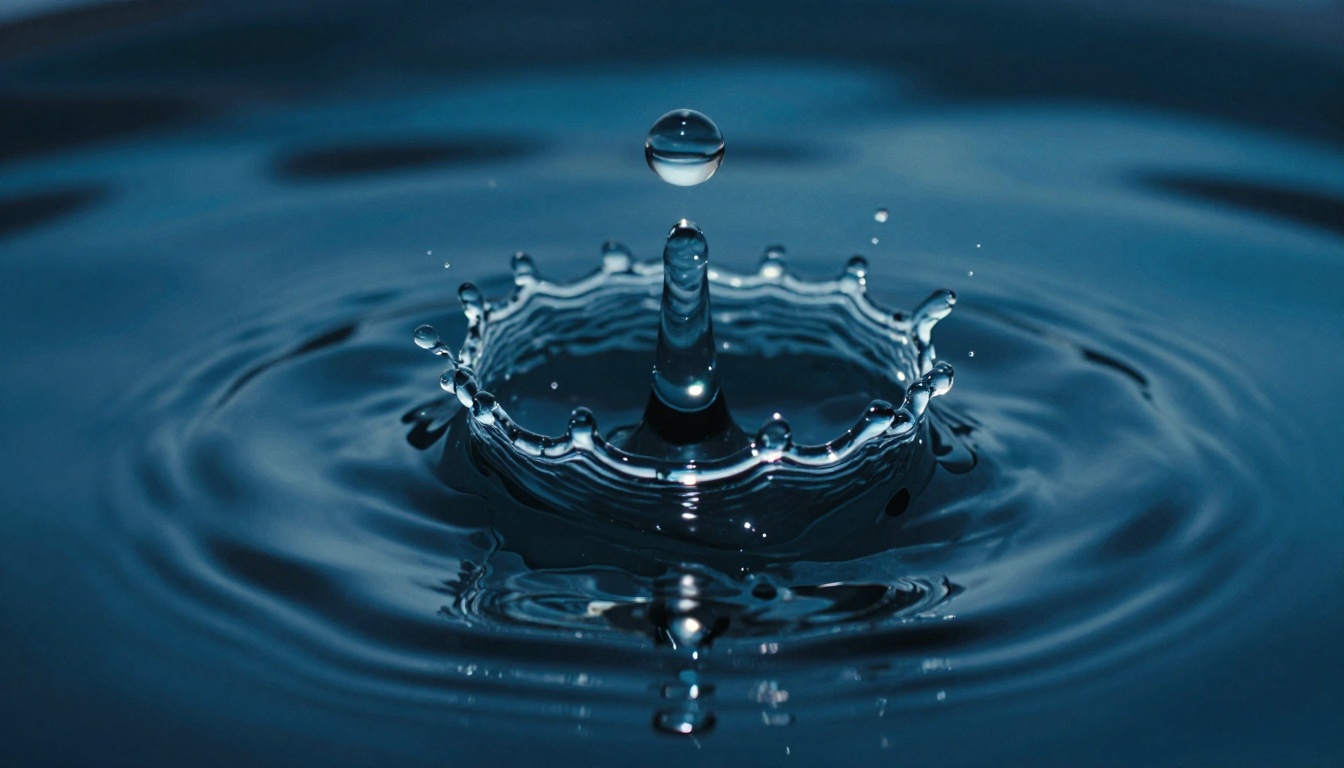
El agua es, posiblemente, el sistema físico más difícil de simular de manera convincente. El comportamiento real de un fluido implica tensión superficial, viscosidad, turbulencia y dinámica de presiones, todo interactuando a la vez. En una salpicadura en corona, la columna central se eleva, desarrolla inestabilidades a lo largo de su superficie, expulsa gotas secundarias en arcos parabólicos y vuelve a colapsar mientras se extienden hacia fuera ondas concéntricas. Acertar con todo esto a la vez, y con la temporización correcta, es un desafío real incluso para el software tradicional de VFX. Los modelos de video con IA que lo resuelven bien han procesado claramente enormes cantidades de metraje de fluidos de alta calidad durante el entrenamiento.
Seedance 2.0 en el laboratorio de física
Seedance 2.0 es el modelo de generación de video a calidad completa de ByteDance, por encima de sus versiones más ligeras Seedance 2.0 Fast y Seedance 2.0 Mini. Sus resultados físicos en el conjunto de pruebas fueron notablemente sólidos, aunque con algunas debilidades claras.
Gravedad y objetos que caen
Seedance 2.0 maneja la caída libre con una precisión por encima de la media. En las pruebas con una bola que rueda fuera de una superficie, el modelo acelera correctamente la bola a lo largo del encuadre con una trayectoria que coincide con la física parabólica esperada, dentro de un margen razonable. La sombra de la bola sobre la superficie inferior también se actualiza bien a medida que cambia la distancia, un detalle físico secundario que muchos modelos fallan por completo.
Donde Seedance 2.0 tropieza es en el momento del impacto. El evento de contacto en sí, ya sea que la bola rebote, se deforme o se incruste, tiende a estar algo poco definido. La bola llega bien, pero la consecuencia de la llegada es más blanda de lo que produciría la física real. En tomas de objetos que caen en las que el clip termina antes del impacto, esto no es un problema. En tomas que dependen de una colisión, conviene planificarlo con esa limitación en mente.
Comportamiento del agua y los fluidos
Aquí es donde Seedance 2.0 brilla de verdad. Las secuencias de salpicadura en corona generadas con este modelo muestran un ascenso columnar correcto, expulsión de gotas secundarias con ángulos realistas y una propagación de ondas en la superficie que resulta físicamente verosímil. El modelo parece haber interiorizado el comportamiento de los fluidos a un nivel que produce resultados convincentes incluso con prompts que describen interacciones inusuales.
Las secuencias de vertido lento (un líquido que se sirve desde un recipiente) también aguantan bien, con un estrechamiento correcto de la cinta de líquido a medida que el chorro se acelera y una agitación de superficie adecuada en el recipiente que lo recibe.
💡 Consejo de producción: Para obtener los mejores resultados con fluidos en Seedance 2.0, especifica la viscosidad del fluido en el prompt. "Miel espesa que cae despacio" produce un movimiento fundamentalmente distinto de "agua fría salpicando", y el modelo responde de forma clara a esa diferencia.
Coherencia temporal a lo largo del tiempo
Una de las mejoras más claras de Seedance 2.0 es la coherencia temporal: el grado en que un fenómeno físico se mantiene coherente durante toda la duración del clip, en lugar de desviarse o parpadear. Las simulaciones de agua, en particular, no presentan el artefacto habitual en el que los patrones de ondas cambian de velocidad de forma espontánea a mitad del clip. El modelo mantiene la causalidad física entre fotogramas a un nivel que resiste bien la inspección fotograma a fotograma.
Veo 3.1 en las mismas pruebas
Veo 3.1, de Google, entra en esta comparativa como uno de los lanzamientos de video con IA más comentados de 2025. Está disponible en versión estándar y en la variante Veo 3.1 Fast, con una Veo 3.1 Lite más ligera para un acceso de menor costo. El modelo estándar es el que se probó aquí.
Colisiones de cuerpos rígidos
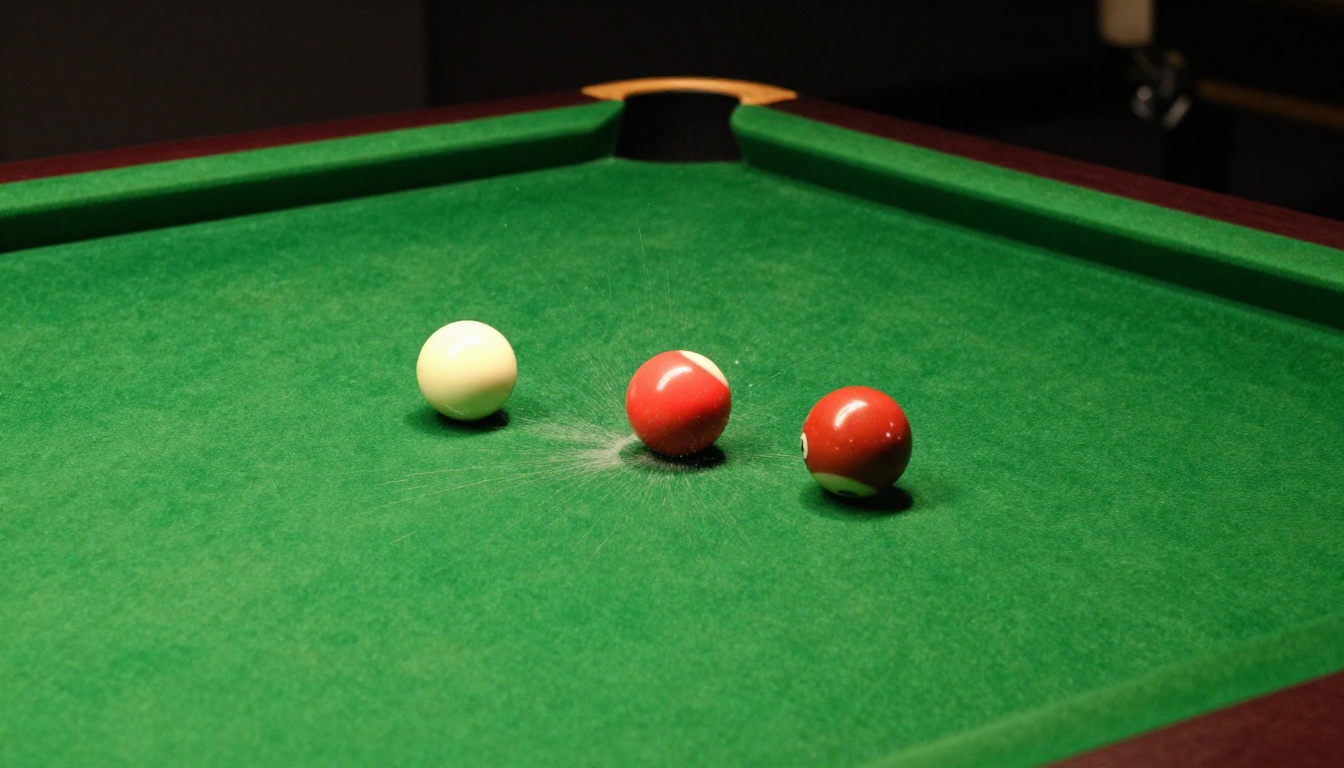
Veo 3.1 produce secuencias de colisión de cuerpos rígidos notablemente limpias. Los impactos de bolas de billar, un vaso que cae sobre baldosas y las colisiones de objetos de madera presentan ángulos de rebote plausibles y una distribución de energía coherente. El modelo parece simular la idea de colisiones elásticas e inelásticas con una precisión razonable, produciendo resultados que funcionarían en la mayoría de contextos comerciales sin provocar en el espectador esa sensación de valle inquietante de la física.
El resultado destacado de esta categoría fue una secuencia de un vaso caído sobre un suelo duro. Veo 3.1 produjo un patrón de reparto de fragmentos que resulta genuinamente aleatorio y no simétrico de forma algorítmica, con fragmentos individuales que viajan a distancias distintas según su relación implícita entre masa y superficie. Es el tipo de detalle sutil que pasa desapercibido en una visualización casual, pero que se nota de inmediato en una reproducción a cámara lenta.
Movimiento de humo y partículas
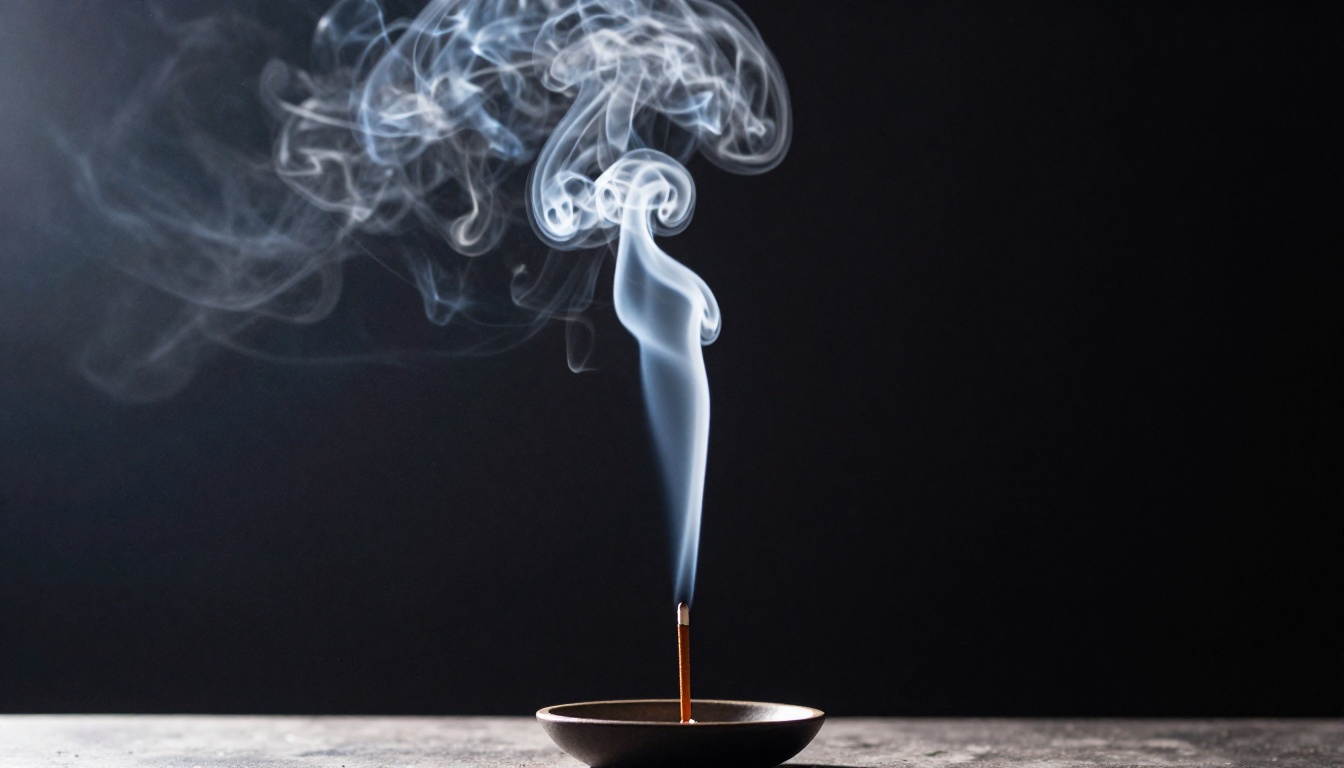
Con humo y partículas, Veo 3.1 logra su mejor resultado frente a Seedance 2.0. El modelo genera columnas de humo que desarrollan inestabilidades turbulentas naturales a la altura correcta, a medida que la columna boyante pasa de flujo laminar a turbulento. Las estructuras de vórtice secundarias son visibles y no se repiten, algo fundamental porque el ojo es extremadamente sensible a los bucles en el metraje de humo.
Las partículas más allá del humo (polvo levantado por el movimiento, vapor de una superficie caliente, ceniza que cae con el viento) también funcionan bien. Las partículas responden a las corrientes de aire implícitas de la escena, lo que aporta coherencia ambiental a fondos que de otro modo serían estáticos.
💡 Aplicación creativa: La física del humo de Veo 3.1 lo hace especialmente eficaz para escenas atmosféricas: neblina matinal sobre el agua, entornos industriales con vapor que sale al exterior, secuencias de hoguera al atardecer. Estos escenarios dependen en gran medida de un comportamiento turbulento correcto de los gases.
Realismo del movimiento de cámara
Veo 3.1 maneja de forma excepcional la física inducida por el movimiento de cámara. Cuando se especifica un travelling hacia delante, los objetos del primer plano muestran un desplazamiento de paralaje correcto respecto a los objetos del fondo. La velocidad del paralaje coincide con la distancia focal implícita del objetivo indicado. Esto importa porque un paralaje incorrecto es una de las señales más evidentes de que un "movimiento de cámara" en video con IA es en realidad solo un zoom o un recorte, y no un desplazamiento espacial genuino a través de la escena.
La simulación de cámara en mano también impresiona: el movimiento es orgánico y ligeramente irregular, en lugar de algorítmicamente suave, y produce ese tipo de movimiento imperfecto que transmite autenticidad documental a los ojos entrenados.
Resultados del enfrentamiento directo
Así puntúa cada modelo en las seis categorías de prueba, con una escala del 1 al 5 en la que 5 representa resultados indistinguibles de la física del mundo real:
| Categoría física | Seedance 2.0 | Veo 3.1 |
|---|
| Gravedad y caída libre | 4.2 | 3.8 |
| Dinámica de fluidos | 4.5 | 4.0 |
| Colisión de cuerpos rígidos | 3.6 | 4.3 |
| Humo y partículas | 3.4 | 4.6 |
| Telas y tejidos | 4.0 | 3.9 |
| Movimiento de cámara | 3.8 | 4.4 |
| Media general | 3.92 | 4.17 |
Veo 3.1 queda por delante en la media general, pero la diferencia es estrecha, y Seedance 2.0 mantiene ventajas claras en las categorías de dinámica de fluidos y gravedad, que suelen ser las más importantes en contenido cinematográfico.
Dónde se queda corto cada modelo
Debilidades de Seedance 2.0:
- Los eventos de impacto (el momento del contacto en las colisiones) están poco definidos y se ven blandos
- La turbulencia del humo y de las partículas puede tender a la uniformidad en clips más largos
- El comportamiento de los gases en configuraciones atmosféricas complejas a veces resulta demasiado estable
Debilidades de Veo 3.1:
- La dinámica de fluidos, aunque sólida, a veces muestra artefactos de tensión superficial que resultan "demasiado espesos" para líquidos con el peso del agua
- La aceleración en caída libre en los primeros fotogramas a veces es algo más lenta de lo esperado
- Los clips más largos muestran más deriva temporal en los sistemas físicos que Seedance 2.0
El movimiento más allá de la física
Telas y cabello en movimiento
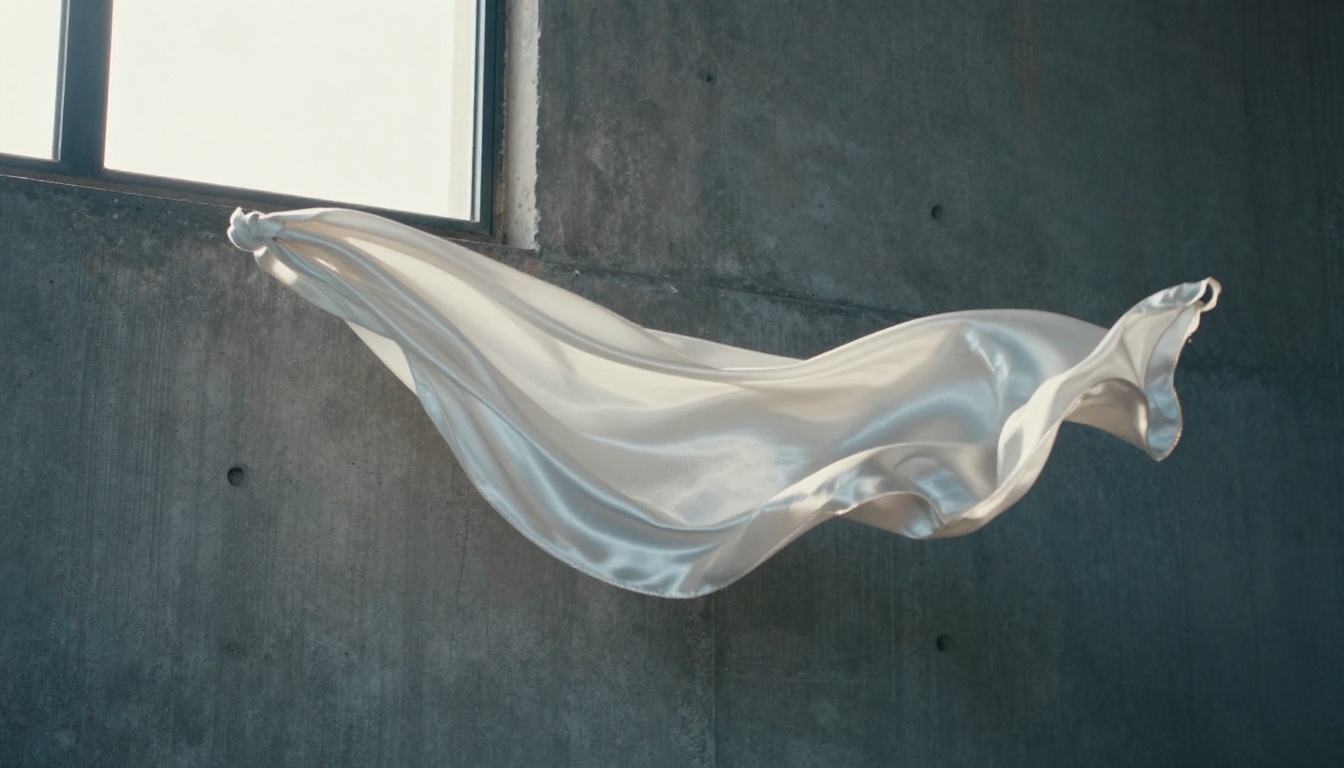
Ambos modelos manejan la simulación de telas de forma aceptable, aunque Seedance 2.0 tiene una ligera ventaja en escenas de caída de tejidos. La seda, el algodón y la lana gruesa producen cada uno una firma de movimiento distinta en los resultados de Seedance 2.0, lo que sugiere que el modelo ha separado el peso y la textura de la tela en su modelo físico interiorizado. La tela de Veo 3.1 es convincente, pero algo uniforme entre distintos tipos de tejido, algo que solo se nota en una comparación directa.
La simulación de cabello sigue siendo una dificultad conocida para todos los modelos de video con IA actuales. Tanto Seedance 2.0 como Veo 3.1 manejan con soltura un movimiento moderado del cabello (una brisa suave, giros lentos de cabeza). Los movimientos rápidos y los efectos complejos de viento siguen produciendo artefactos en ambos modelos, así que las tomas que requieran una dinámica extrema del cabello deben planificarse teniendo en cuenta esa limitación.
Precisión en cámara lenta
La cámara lenta es una prueba muy útil porque amplifica cualquier imprecisión física según el factor de ralentización. Un objeto que se frena a un ritmo ligeramente incorrecto en metraje a velocidad real se vuelve obviamente erróneo a un 120% de cámara lenta.
Veo 3.1 aguanta mejor la inspección en cámara lenta, sobre todo en secuencias de movimiento humano. El movimiento secundario sutil que hace que el metraje a cámara lenta resulte auténtico, la onda que recorre la tela cuando se mueve una parte del cuerpo, el ligero retraso de los dedos al estirarse tras soltar un agarre, aparece de forma más constante en los resultados de Veo 3.1. Los resultados de Seedance 2.0 en cámara lenta son más limpios en algunos aspectos (menos artefactos de compresión), pero algo más mecánicos en el detalle del movimiento secundario.
Cómo usar estos modelos en PicassoIA
Tanto Seedance 2.0 como Veo 3.1 están disponibles directamente en PicassoIA, lo que significa que no necesitas claves de API, una configuración local de GPU ni suscripciones separadas para ejecutar estas pruebas por tu cuenta.
Ejecutar Seedance 2.0 en PicassoIA
- Ve a la página del modelo Seedance 2.0 en PicassoIA
- Escribe un prompt que especifique con claridad el evento físico: nombra los objetos, sus materiales y la acción exacta que ocurre
- Incluye las condiciones de iluminación y el ángulo de cámara para ayudar al modelo a establecer el contexto espacial
- En las tomas de fluidos, añade descriptores de viscosidad ("fino", "viscoso", "almibarado") para guiar la simulación del fluido
- En las tomas de gravedad, especifica la altura y el tipo de superficie para fijar las expectativas sobre el comportamiento del impacto
- Si la primera salida muestra un comportamiento de impacto débil, prueba a añadir "fotografía de alta velocidad" al prompt para empujar al modelo hacia una temporización física más nítida
La variante Seedance 2.0 Fast merece la pena para iterar y refinar el prompt, ya que produce resultados más rápido y a menor costo. Cuando el prompt esté afinado, cambia al Seedance 2.0 completo para obtener la calidad de salida final.
Ejecutar Veo 3.1 en PicassoIA
- Ve a la página del modelo Veo 3.1 en PicassoIA
- Veo 3.1 responde bien a la especificación de cámara: indica siempre el tipo de objetivo y el estilo de movimiento de cámara cuando sea relevante para la toma
- En las tomas de humo y partículas, describe las condiciones del aire del entorno ("aire quieto en interior", "brisa suave desde la izquierda") para activar la simulación atmosférica del modelo
- En las tomas de colisión de cuerpos rígidos, nombra el material exacto de ambos objetos en contacto ("vidrio templado", "madera dura", "acero pulido")
- Veo 3.1 Fast es una opción sólida para los borradores de iteración, y el Veo 3.1 estándar queda reservado para los renders finales en los que la precisión física es crítica
💡 Consejo rápido: Si quieres comparar más modelos orientados a la física, Kling v3 Video, Wan 2.7 T2V y LTX 2.3 Pro ofrecen características distintas en el tratamiento de la física que merecen compararse según tu caso de uso.
Cuál encaja con tu toma
La respuesta directa depende por completo del tipo de toma.
Elige Seedance 2.0 cuando tu toma incluya:
- Agua, lluvia, océano o cualquier escena dominada por líquidos
- Objetos que caen, donde importan más la trayectoria y la aceleración que el momento del impacto
- Telas en movimiento moderado (bufandas, cortinas, ropa con viento suave)
- Tomas que requieren una coherencia temporal sólida durante toda la duración del clip
Elige Veo 3.1 cuando tu toma incluya:
- Humo, vapor, fuego o secuencias atmosféricas cargadas de partículas
- Colisiones de cuerpos rígidos en las que importan la distribución de los fragmentos o los ángulos de rebote
- Tomas con mucho movimiento de cámara que requieren un paralaje preciso
- Secuencias en cámara lenta en las que el movimiento humano secundario debe parecer orgánico y no mecánico
Para proyectos que abarcan varias categorías físicas, el flujo de trabajo más eficiente es usar ambos modelos para distintas tomas dentro del mismo proyecto. PicassoIA lo hace sencillo, ya que todos los modelos están en la misma interfaz, y puedes alternar entre ellos sin salir de la plataforma ni gestionar credenciales de API por separado.
Ninguno de los dos modelos ha "resuelto" la simulación física como lo hace un pipeline tradicional de VFX. Pero ambos han cruzado un umbral en el que, para el tipo de toma adecuado y con la ingeniería de prompts correcta, su resultado físico aguanta en contextos de producción profesional. La pregunta ya no es si el video con IA puede producir una física creíble. Se trata de saber qué modelo elegir según el sistema físico que esté en el centro de tu toma.
Prueba ambos en picassoia.com/en/all-models y haz tus propias pruebas. Los requisitos específicos de tu toma revelarán carencias y fortalezas que ningún benchmark genérico puede captar del todo. Los modelos están listos para ejecutarse de inmediato, sin configuración previa.


