A diferença entre um vídeo gerado por IA que parece impressionante e um vídeo que parece real se resume a uma coisa: física. Qualquer modelo consegue produzir iluminação bonita e texturas nítidas. O que separa vídeo com IA de nível profissional de conteúdo de novidade é se um objeto que cai acelera na taxa certa, se a água realmente se deforma no impacto, se a fumaça redemoinha com imprevisibilidade turbulenta em vez de se repetir como um protetor de tela. O Seedance 2.0, da ByteDance, e o Veo 3.1, do Google, são atualmente dois dos concorrentes mais fortes em vídeo com IA, e é no tratamento da física que a diferença real aparece. Este duelo direto põe os dois para rodar em testes controlados em seis categorias centrais de física, para que você saiba exatamente qual escolher para o seu próximo projeto.
O que os testes de física realmente revelam
A maioria das comparações entre modelos de vídeo com IA se concentra na estética: gradação de cor, resolução, aderência ao prompt. Os testes de física vão mais fundo. Eles verificam se o modelo internalizou as regras do mundo físico ou se apenas produz um movimento com aparência plausível que desmorona quando é examinado de perto.
Os testes usados aqui se dividem em seis categorias: gravidade e queda livre, dinâmica de fluidos, colisão de corpos rígidos, sistemas de fumaça e partículas, panos e tecidos e realismo do movimento de câmera. Cada teste usa uma estrutura de prompt consistente, as mesmas configurações de resolução e várias execuções para levar em conta a variação. Os resultados abaixo representam o comportamento médio, não saídas escolhidas a dedo.
Por que a gravidade costuma ser mal simulada
A gravidade é enganosamente difícil para modelos de vídeo. A física é simples: objetos aceleram a 9,8 m/s² para baixo. Mas a assinatura visual de uma gravidade correta é sutil. Um objeto que cai um pouco devagar demais parece flutuar. Um objeto que desacelera perto do chão, mesmo de forma imperceptível, parece errado para qualquer olho treinado. A maioria dos modelos de vídeo com IA tende a exagerar na lentidão e prefere movimentos suaves, porque isso parece "cinematográfico" nos dados de treinamento. O resultado é uma espécie de qualidade flutuante que quebra a imersão em clipes que são, de resto, bem acabados.
💡 O que observar: Os primeiros 10 quadros de um clipe de objeto caindo revelam tudo. Uma aceleração correta faz com que cada intervalo entre quadros seja visivelmente maior que o anterior. Um intervalo uniforme indica que o modelo está interpolando de forma linear em vez de simular a física real.
Dinâmica de fluidos como o verdadeiro benchmark
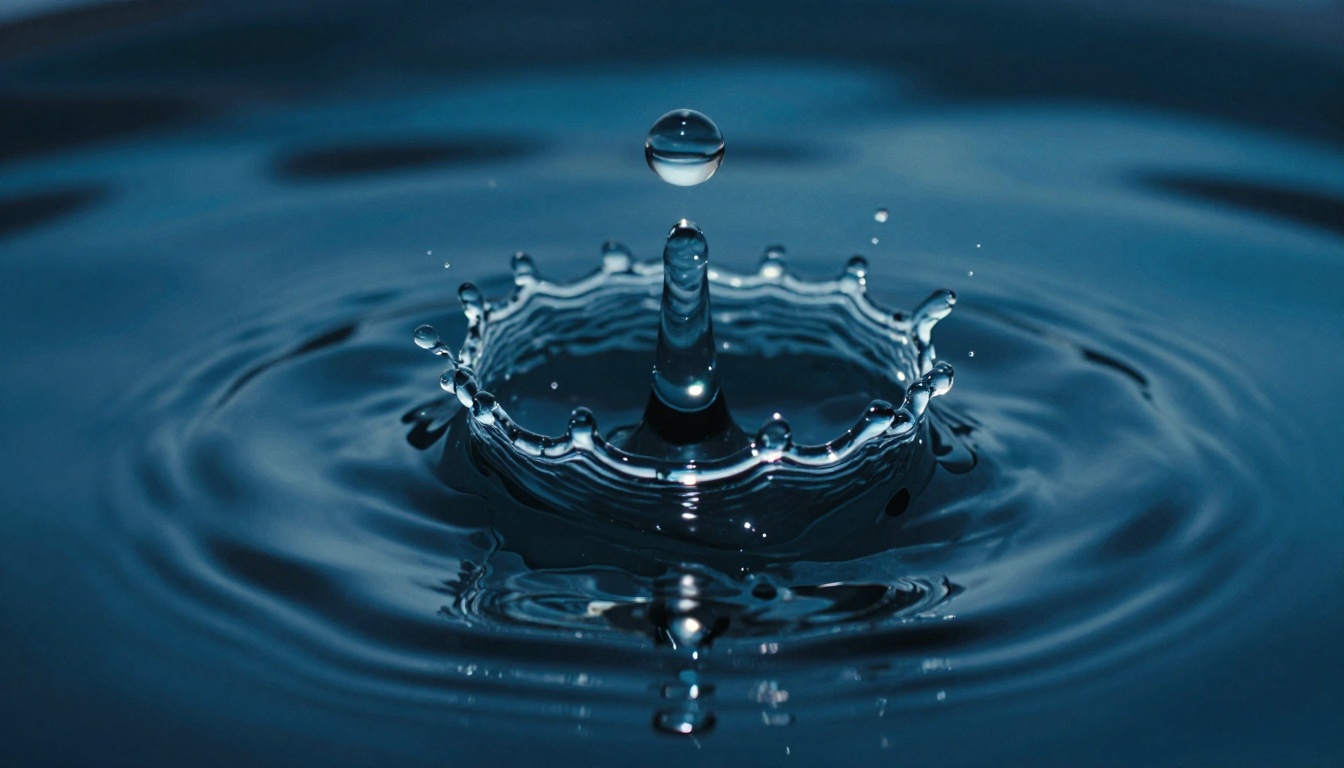
A água é, sem dúvida, o sistema físico mais difícil de simular de forma convincente. O comportamento real de um fluido envolve tensão superficial, viscosidade, turbulência e dinâmica de pressão, tudo interagindo ao mesmo tempo. Em um respingo em forma de coroa, a coluna central sobe, desenvolve instabilidades ao longo da superfície, ejeta gotas secundárias em arcos parabólicos e volta a colapsar enquanto ondulações concêntricas se espalham para fora. Acertar tudo isso ao mesmo tempo, com o tempo certo, é um desafio genuíno até mesmo para softwares tradicionais de VFX. Os modelos de vídeo com IA que lidam bem com isso claramente processaram uma enorme quantidade de imagens de fluidos de alta qualidade durante o treinamento.
Seedance 2.0 no laboratório de física
O Seedance 2.0 é o modelo de geração de vídeo em qualidade total da ByteDance, posicionado acima das versões mais leves Seedance 2.0 Fast e Seedance 2.0 Mini. Seus resultados de física em toda a bateria de testes foram notavelmente fortes, com algumas fraquezas bem definidas.
Gravidade e objetos em queda
O Seedance 2.0 lida com a queda livre com precisão acima da média. Em testes com uma bola rolando para fora de um tampo de mesa, o modelo acelera corretamente a bola pelo quadro, com uma trajetória que corresponde à física parabólica esperada dentro de uma margem razoável. A sombra da bola na superfície abaixo também se atualiza corretamente conforme a distância muda, um indício físico secundário sutil que muitos modelos erram por completo.
Onde o Seedance 2.0 tropeça é no momento do impacto. O evento de contato em si, seja a bola quicando, se deformando ou se encravando, tende a ser levemente pouco especificado. A bola chega corretamente, mas a consequência da chegada é mais suave do que a física real produziria. Para tomadas estritamente de objetos em queda em que o clipe termina antes do impacto, isso não é um problema. Para tomadas que dependem de colisão, você vai precisar planejar em torno disso.
Comportamento da água e dos fluidos
É aqui que o Seedance 2.0 realmente brilha. Sequências de respingo em coroa geradas com este modelo mostram a subida colunar correta, ejeção de gotas secundárias em ângulos realistas e propagação de ondas na superfície que parece fisicamente plausível. O modelo parece ter internalizado o comportamento dos fluidos em um nível que produz resultados convincentes mesmo em prompts que descrevem interações de fluidos incomuns.
Sequências de derramamento lento (líquido sendo vertido de um recipiente) também se sustentam bem, com o estreitamento correto da linha de líquido conforme o fluxo acelera e a agitação adequada da superfície no recipiente que recebe.
💡 Dica de produção: Para obter os melhores resultados de fluidos com o Seedance 2.0, especifique a viscosidade do fluido no prompt. "Mel grosso escorrendo devagar" produz um movimento fundamentalmente diferente de "água fria respingando", e o modelo responde de forma significativa a essa distinção.
Consistência temporal ao longo do tempo
Uma das vantagens mais claras do Seedance 2.0 é a consistência temporal: o grau em que um evento físico permanece coerente durante toda a duração do clipe, em vez de derivar ou tremeluzir. Simulações de água, em particular, não exibem o artefato comum em que os padrões de ondulação mudam de velocidade de forma espontânea no meio do clipe. O modelo mantém a causalidade física entre os quadros em um nível que se sustenta bem na inspeção quadro a quadro.
Veo 3.1 nos mesmos testes
O Veo 3.1, do Google, entra nesta comparação e talvez seja o lançamento de vídeo com IA mais comentado de 2025. Ele está disponível nas versões padrão e Veo 3.1 Fast, com um Veo 3.1 Lite mais leve para acesso de menor custo. O modelo padrão foi o testado aqui.
Colisões de corpos rígidos
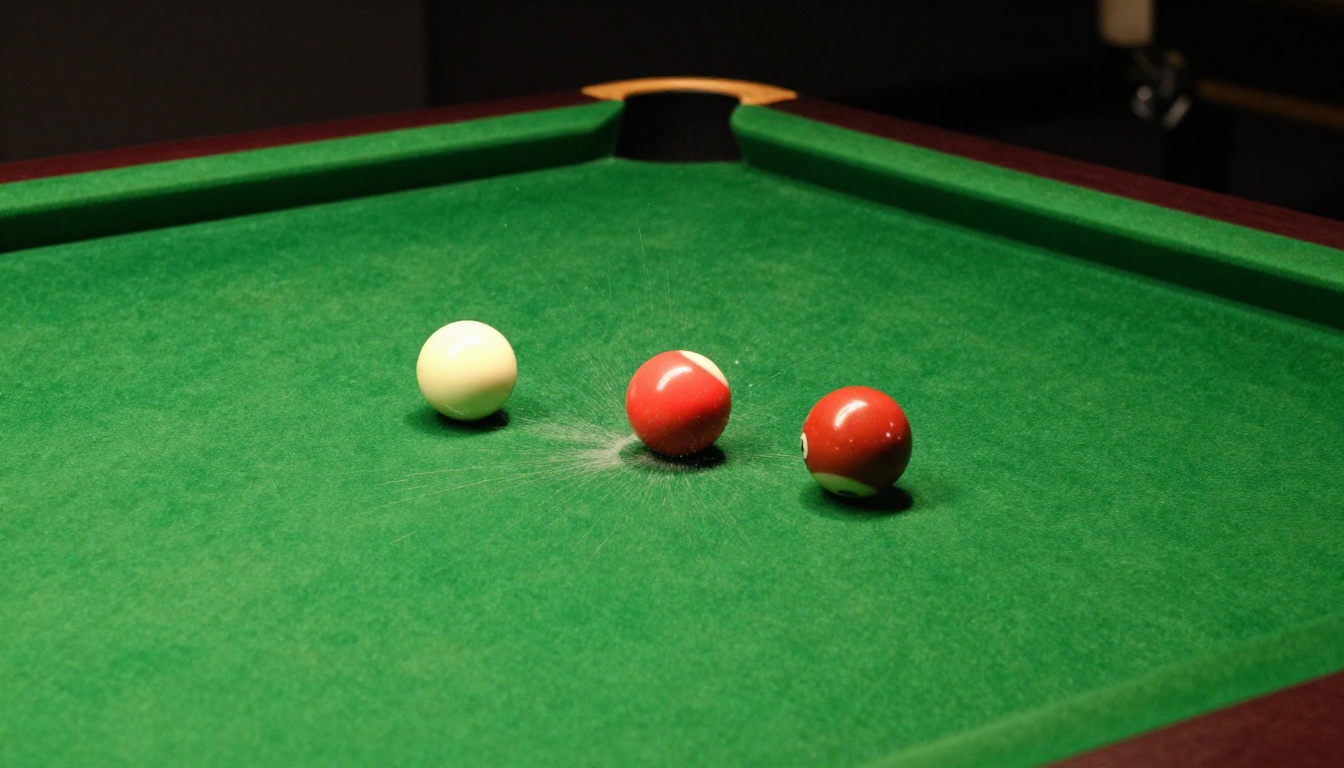
O Veo 3.1 produz sequências de colisão de corpos rígidos notavelmente limpas. Impactos de bolas de bilhar, um copo caindo sobre piso de cerâmica e colisões de objetos de madeira apresentam ângulos de rebote e distribuição de energia plausíveis. O modelo parece simular a ideia de colisões elásticas e inelásticas com precisão razoável, produzindo resultados que funcionariam na maioria dos contextos comerciais sem acionar uma reação de vale da estranheza física nos espectadores.
O resultado de destaque nesta categoria foi uma sequência de um copo caindo sobre um piso duro. O Veo 3.1 produziu um padrão de distribuição de cacos que parece genuinamente aleatório, e não algoritmicamente simétrico, com cada caco viajando a distâncias diferentes de acordo com a razão implícita entre massa e área de superfície. É o tipo de detalhe sutil que passaria despercebido numa visualização casual, mas que é notado de imediato na reprodução em câmera lenta.
Movimento de fumaça e partículas
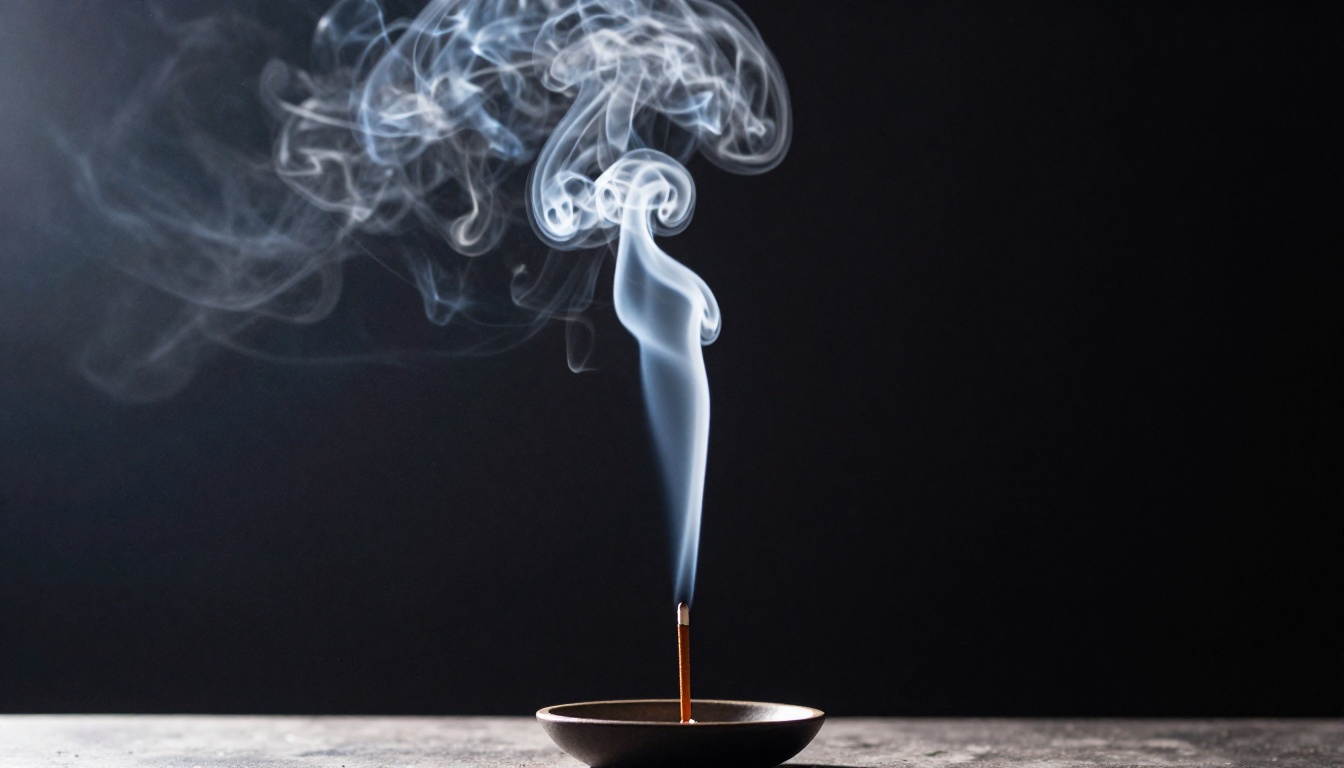
Sistemas de fumaça e partículas são onde o Veo 3.1 mostra seu melhor resultado em relação ao Seedance 2.0. O modelo gera colunas de fumaça que desenvolvem instabilidades turbulentas naturais na altura correta, à medida que a coluna de ar quente passa de fluxo laminar para turbulento. Estruturas secundárias de vórtice são visíveis e não se repetem, o que é fundamental, porque o olho é extremamente sensível a repetições em imagens de fumaça.
Sistemas de partículas além da fumaça (poeira levantada pelo movimento, vapor de uma superfície quente, cinzas caindo com o vento) também têm bom desempenho. As partículas respondem às correntes de ar implícitas na cena de um jeito que acrescenta coerência ambiental a fundos que, de outra forma, seriam estáticos.
💡 Aplicação criativa: A física de fumaça do Veo 3.1 o torna particularmente eficaz para cenas atmosféricas: névoa da manhã sobre a água, ambientes industriais com vapor saindo de respiradouros, sequências de fogueira ao entardecer. Esses cenários dependem fortemente de um comportamento correto de gases turbulentos.
Realismo do movimento de câmera
O Veo 3.1 lida excepcionalmente bem com a física induzida pelo movimento de câmera. Quando um travelling para a frente é especificado, os objetos em primeiro plano mostram o deslocamento de paralaxe correto em relação aos objetos do fundo. A taxa de paralaxe corresponde à distância focal implícita da lente especificada. Isso importa porque uma paralaxe incorreta é um dos sinais mais óbvios de que um "movimento de câmera" em vídeo com IA é, na verdade, apenas um zoom ou um recorte, e não um deslocamento espacial genuíno através de uma cena.
A simulação de câmera na mão também impressiona: o movimento é orgânico e levemente irregular, em vez de algoritmicamente suave, produzindo o tipo de movimento imperfeito que sinaliza autenticidade documental para olhos treinados.
Resultados do duelo direto
Veja como os dois modelos pontuam nas seis categorias de teste, usando uma escala de 1 a 5, em que 5 representa resultados indistinguíveis da física do mundo real:
| Categoria de física | Seedance 2.0 | Veo 3.1 |
|---|
| Gravidade e queda livre | 4,2 | 3,8 |
| Dinâmica de fluidos | 4,5 | 4,0 |
| Colisão de corpos rígidos | 3,6 | 4,3 |
| Fumaça e partículas | 3,4 | 4,6 |
| Tecido e tecidos | 4,0 | 3,9 |
| Movimento de câmera | 3,8 | 4,4 |
| Média geral | 3,92 | 4,17 |
O Veo 3.1 fica à frente na média geral, mas a diferença é pequena, e o Seedance 2.0 mantém vantagens claras nas categorias de dinâmica de fluidos e gravidade, que costumam ser as mais importantes para conteúdo cinematográfico.
Onde cada modelo fica aquém
Fraquezas do Seedance 2.0:
- Eventos de impacto (o momento do contato nas colisões) são pouco especificados e visualmente suaves
- A turbulência de fumaça e partículas pode tender à uniformidade em clipes mais longos
- O comportamento de gases em configurações atmosféricas complexas às vezes parece estável demais
Fraquezas do Veo 3.1:
- A dinâmica de fluidos, embora forte, às vezes apresenta artefatos de tensão superficial que parecem "espessos demais" para líquidos com peso de água
- A aceleração em queda livre nos primeiros quadros é, às vezes, um pouco mais lenta do que o esperado
- Clipes mais longos mostram mais deriva temporal nos sistemas físicos em comparação com o Seedance 2.0
Movimento além da física
Tecido e cabelo em movimento
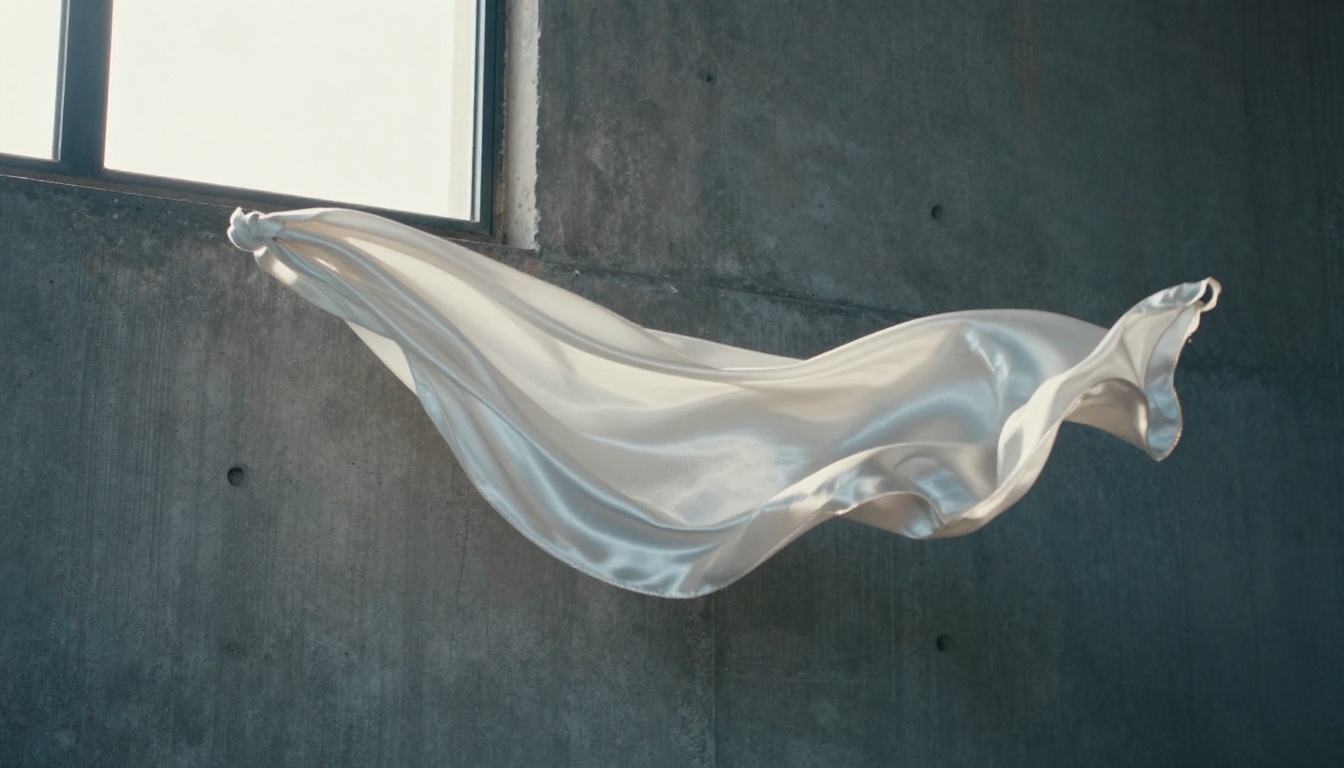
Os dois modelos lidam com a simulação de tecido de forma aceitável, com o Seedance 2.0 levemente à frente em cenários de caimento de tecido. Seda, algodão e lã pesada produzem assinaturas de movimento distintas nas saídas do Seedance 2.0, o que sugere que o modelo separou peso e textura do tecido em seu modelo físico internalizado. O tecido do Veo 3.1 é convincente, mas um pouco uniforme entre os diferentes tipos de tecido, o que só se torna perceptível em comparação direta.
O cabelo continua sendo uma dificuldade conhecida para todos os modelos atuais de vídeo com IA. Tanto o Seedance 2.0 quanto o Veo 3.1 lidam de forma adequada com movimento moderado de cabelo (brisa suave, viradas lentas de cabeça). Movimentos rápidos e efeitos de vento complexos ainda produzem artefatos nos dois modelos, então tomadas que exigem dinâmica extrema de cabelo devem ser planejadas levando essa limitação em conta.
Precisão em câmera lenta
A câmera lenta é um teste convincente porque amplifica qualquer imprecisão física pelo fator da câmera lenta. Um objeto que desacelera a uma taxa levemente errada em imagens em tempo real se torna obviamente errado a 120% de câmera lenta.
O Veo 3.1 se sustenta melhor na inspeção em câmera lenta, especialmente em sequências de movimento humano. O movimento secundário sutil que faz as imagens em câmera lenta parecerem autênticas, a ondulação que percorre o tecido quando uma parte do corpo se move, o pequeno atraso dos dedos ao se esticarem depois que uma pegada é solta, está mais consistentemente presente nas saídas do Veo 3.1. Os resultados do Seedance 2.0 em câmera lenta são mais limpos em alguns aspectos (menos artefatos de compressão), mas um pouco mais mecânicos nos detalhes do movimento secundário.
Como usar esses modelos no PicassoIA
Tanto o Seedance 2.0 quanto o Veo 3.1 estão disponíveis diretamente no PicassoIA, o que significa que você não precisa de chaves de API, configuração de GPU local nem assinaturas separadas para executar esses testes por conta própria.
Executando o Seedance 2.0 no PicassoIA
- Acesse a página do modelo Seedance 2.0 no PicassoIA
- Escreva um prompt que especifique o evento físico com clareza: nomeie os objetos, seus materiais e a ação exata que acontece
- Inclua condições de iluminação e ângulo de câmera para ajudar o modelo a estabelecer o contexto espacial
- Para tomadas com fluidos, adicione descritores de viscosidade ("fino", "viscoso", "xaroposo") para orientar a simulação do fluido
- Para tomadas de gravidade, especifique a altura e o tipo de superfície para definir expectativas sobre o comportamento no impacto
- Se a primeira saída mostrar um comportamento de impacto fraco, tente acrescentar "fotografia em alta velocidade" ao prompt para empurrar o modelo em direção a uma temporização física mais nítida
A variante Seedance 2.0 Fast vale a pena para iterar e refinar o prompt, já que produz resultados mais rápido e com custo menor. Depois que o prompt estiver ajustado, mude para o Seedance 2.0 completo para a qualidade final da saída.
Executando o Veo 3.1 no PicassoIA
- Acesse a página do modelo Veo 3.1 no PicassoIA
- O Veo 3.1 responde bem à especificação de câmera: sempre informe o tipo de lente e o estilo do movimento de câmera quando isso for relevante para a tomada
- Para tomadas de fumaça e partículas, descreva as condições do ar do ambiente ("ar parado em ambiente interno", "vento leve vindo da esquerda") para ativar a simulação atmosférica do modelo
- Para tomadas de colisão de corpos rígidos, nomeie o material exato dos dois objetos em contato ("vidro temperado", "madeira de lei", "aço polido")
- O Veo 3.1 Fast é uma opção sólida para iterações de rascunho, com o Veo 3.1 padrão reservado para renderizações finais em que a precisão física é crítica
💡 Dica de velocidade: Se você quiser comparar outros modelos voltados para física, o Kling v3 Video, o Wan 2.7 T2V e o LTX 2.3 Pro oferecem características distintas de tratamento de física que valem ser avaliadas para o seu caso de uso específico.
Qual serve para a sua tomada
A resposta direta depende totalmente do tipo de tomada.
Escolha o Seedance 2.0 quando sua tomada envolver:
- Água, chuva, oceano ou qualquer cena dominada por líquidos
- Objetos em queda em que a trajetória e a aceleração importam mais do que o momento do impacto
- Tecido em movimento moderado (lenços, cortinas, roupas com vento leve)
- Tomadas que exigem forte consistência temporal ao longo de toda a duração do clipe
Escolha o Veo 3.1 quando sua tomada envolver:
- Fumaça, vapor, fogo ou sequências atmosféricas carregadas de partículas
- Colisões de corpos rígidos em que a distribuição de cacos ou os ângulos de rebote importam
- Tomadas com muito movimento de câmera que exigem comportamento de paralaxe preciso
- Sequências em câmera lenta em que o movimento humano secundário precisa parecer orgânico e não mecânico
Para projetos que abrangem várias categorias de física, o fluxo de trabalho mais eficiente é usar os dois modelos em tomadas diferentes dentro do mesmo projeto. O PicassoIA facilita isso, já que todos os modelos ficam na mesma interface, e você pode alternar entre eles sem sair da plataforma nem gerenciar credenciais de API separadas.
Nenhum dos dois modelos "resolveu" a simulação de física da forma como um pipeline tradicional de VFX faz. Mas ambos cruzaram um limiar em que, para o tipo certo de tomada e com a engenharia de prompt certa, a saída de física se sustenta em contextos de produção profissional. A questão já não é se o vídeo com IA consegue produzir física crível. É saber qual modelo escolher conforme o sistema físico que está no centro da sua tomada.
Experimente os dois em picassoia.com/en/all-models e faça seus próprios testes. Os requisitos específicos da sua tomada vão revelar lacunas e pontos fortes que nenhum benchmark genérico consegue capturar por completo. Os modelos estão prontos para rodar imediatamente, sem nenhuma configuração.


