Si alguna vez escribiste una frase y viste cómo un equipo generaba una imagen fotorrealista de la nada, ya has visto un modelo de difusión en acción. Estos modelos están detrás de la mayoría de los grandes generadores de imágenes con IA de hoy, desde Stable Diffusion hasta Flux Dev, y su funcionamiento es mucho más sencillo de entender de lo que la mayoría espera. Este artículo explica los modelos de difusión sin ecuaciones, sin jerga y sin saltarse las partes que de verdad importan.
El problema del ruido del que nadie habla
La mayoría de las explicaciones sobre modelos de difusión empiezan con matemáticas complicadas. Ese no es el lugar correcto para empezar. El punto de partida adecuado es una pregunta mucho más sencilla: ¿y si pudieras enseñarle a un equipo a deshacer la aleatoriedad?
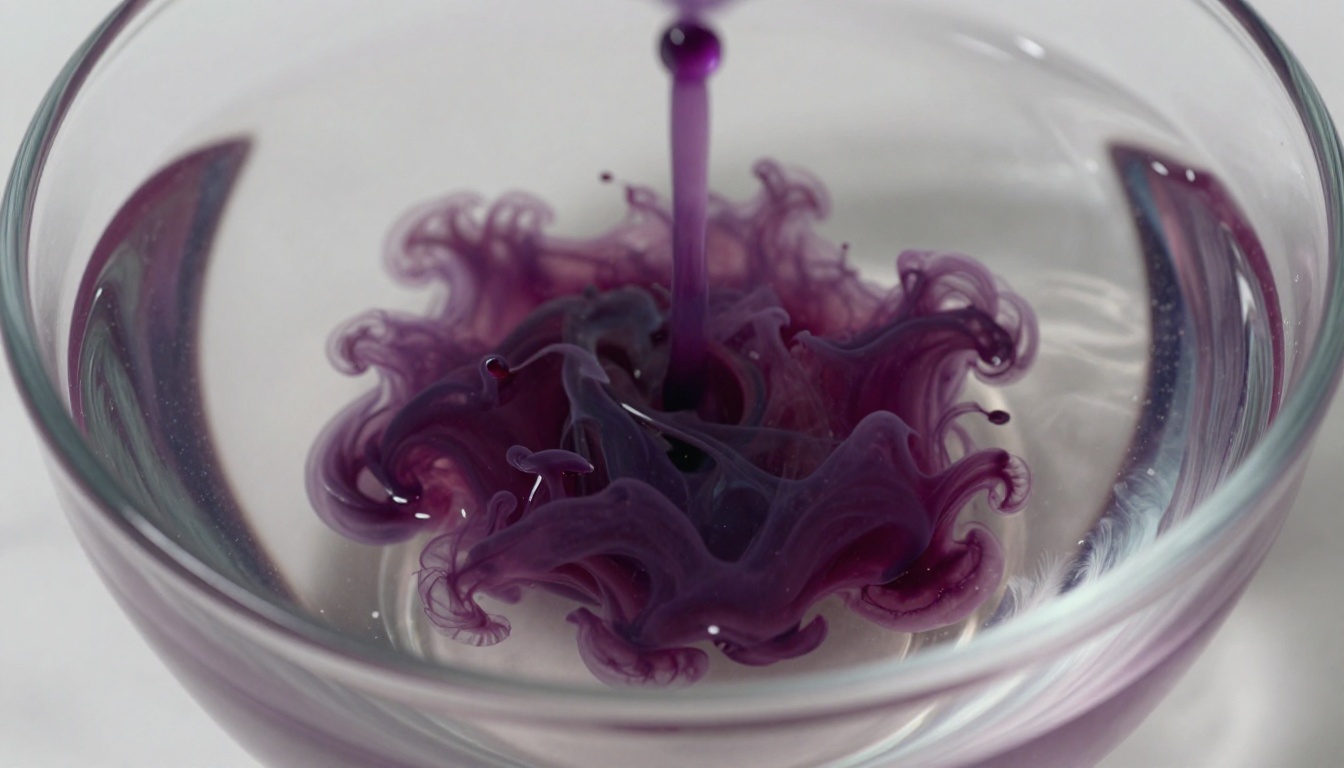
Piensa en lo que pasa cuando mezclas una gota de tinta en un vaso de agua. La tinta se extiende, se mezcla y, al final, no puedes saber dónde empezó. Ese proceso de dispersarse, volverse uniforme y perder estructura se llama difusión. Ocurre con la tinta en el agua, con el calor a través de una barra de metal y con un perfume en una habitación.
Los modelos de difusión toman esa idea y la ejecutan al revés.
Por qué el ruido tiene sentido como punto de partida
En el mundo de las imágenes, el "ruido" son valores de píxel aleatorios. Toma cualquier fotografía y añade suficientes valores aleatorios a cada píxel, y acabarás con estática, como la de un televisor averiado. La imagen original desaparece por completo.
Ese es el punto de partida de todo modelo de difusión. No porque sea interesante, sino porque es útil. El ruido puro es fácil de generar. No necesitas un conjunto de imágenes para producir píxeles aleatorios. Puedes crearlos al instante, de la nada.
La idea que hizo prácticos a los modelos de difusión es esta: si puedes entrenar una red neuronal para que tome una imagen ligeramente ruidosa y prediga cómo se ve la versión limpia, puedes encadenar ese proceso cientos de veces para pasar del ruido puro a una imagen coherente.
Cómo funciona realmente un modelo de difusión
En esencia, un modelo de difusión es una red neuronal con una única tarea: predecir el ruido de una imagen. Suena casi demasiado simple, pero esa capacidad, escalada con suficientes datos y cómputo, produce los resultados fotorrealistas que ves hoy.
El paso uno es destrucción pura
El entrenamiento empieza destruyendo imágenes a propósito. Los investigadores toman millones de fotografías reales y, de forma controlada, les añaden ruido gaussiano aleatorio en muchos niveles distintos. En el nivel de ruido 1, la imagen parece casi normal, solo un poco granulada. En el nivel 500, está muy degradada. En el nivel 1.000, es estática pura.
Para cada versión ruidosa, a la red se le dice: aquí tienes la imagen con ruido, aquí tienes el nivel de ruido, ahora predice cómo es el ruido. Tras millones de ejemplos de entrenamiento, la red se vuelve muy buena reconociendo patrones de ruido en cada nivel de intensidad.
En el paso dos ocurre la magia
Una vez entrenado, ejecutas el modelo al revés. Empiezas con una imagen de ruido completamente aleatoria, se la das a la red, le pides que prediga el ruido del paso 1.000, restas parte de ese ruido, luego le pides que prediga el ruido del paso 999, vuelves a restar y repites.
Tras 1.000 de estos pequeños pasos de eliminación de ruido, la estática se ha convertido en una imagen coherente. A la red nunca se le dijo que dibujara algo concreto. Solo se le dijo que eliminara ruido. Pero, como aprendió de millones de fotografías reales, la imagen que surge parece una fotografía real.
💡 La idea central: Los modelos de difusión no generan imágenes dibujando desde cero. Generan restando, eliminando ruido hasta que aparece la estructura.
Lo que aprende realmente la red
Lo más sorprendente de los modelos de difusión es lo que la red neuronal aprende realmente durante el entrenamiento. No aprende a dibujar ojos, árboles o caras. Aprende la estructura estadística de las imágenes, los patrones que hacen que las disposiciones de píxeles parezcan cosas reales y no ruido aleatorio.
El bucle de entrenamiento explicado
Así es el bucle de entrenamiento, en términos sencillos:
- Toma una imagen real del conjunto de datos
- Elige un nivel de ruido aleatorio entre 1 y 1.000
- Añade exactamente esa cantidad de ruido a la imagen
- Muestra a la red la imagen con ruido y el nivel de ruido
- Pídele a la red que prediga el ruido original que se añadió
- Compara su predicción con el ruido real
- Ajusta los pesos de la red para que la siguiente predicción sea un poco mejor
- Repite miles de millones de veces
Después de suficientes iteraciones, la red ha visto tantos ejemplos que ha interiorizado lo que significa "imagen natural" a un nivel estadístico profundo. Sabe, sin que se le diga explícitamente, que los píxeles del cielo tienden a aparecer por encima de los del suelo, que las caras tienen cierta simetría y que las texturas se repiten de formas predecibles.
Por qué 1.000 pasos lo cambian todo
Los primeros enfoques de difusión intentaban ir directamente del ruido a la imagen de una sola vez. Los resultados eran pobres. El salto era demasiado grande y había que inferir demasiada información de golpe.
Dividir el proceso en 1.000 pasos pequeños cambia de forma notable la dificultad de cada paso. En cada uno, la red solo necesita hacer una pequeña corrección. Las pequeñas correcciones son más fáciles de predecir con precisión. La acumulación de 1.000 correcciones pequeñas y precisas produce un resultado grande y preciso.
Por eso, trabajos posteriores se centraron mucho en reducir el número de pasos necesarios, usando SDXL Lightning 4Step para lograr resultados de calidad en tan solo 4 pasos, o Flux Schnell, que produce imágenes nítidas en segundos.
Directo e inverso en términos sencillos
Las dos mitades de un modelo de difusión tienen nombres formales: el proceso directo y el proceso inverso. En la práctica, son sencillos de describir.
Una dirección destruye, la otra construye
| Proceso | Dirección | Qué ocurre | Cuándo se ejecuta |
|---|
| Directo | Imagen a ruido | Añade ruido gaussiano de forma gradual hasta destruir la imagen | Solo durante el entrenamiento |
| Inverso | Ruido a imagen | Elimina ruido de forma gradual hasta reconstruir la imagen | Durante la inferencia (generación de imágenes) |
El proceso directo no tiene parámetros entrenables. Es simplemente una fórmula matemática que añade ruido. El proceso inverso es donde vive la red neuronal. Toda la inteligencia está en aprender a ejecutar esa segunda dirección.
El papel de la U-Net
La arquitectura de red neuronal que usan la mayoría de los modelos de difusión se llama U-Net. El nombre viene de su forma: comprime la imagen hasta una representación pequeña (la parte inferior de la U) y luego la expande de nuevo al tamaño completo (el lado derecho de la U), con conexiones entre los niveles correspondientes de cada lado.
Esta arquitectura es especialmente buena para procesar imágenes porque:
- La compresión captura la estructura global (¿es una escena exterior o interior?)
- La expansión reconstruye los detalles finos (¿cómo es la textura de la hierba en este punto?)
- Las conexiones de salto permiten que los detalles finos pasen directamente de la compresión a la expansión sin perderse
Modelos más recientes como Flux Dev han pasado a arquitecturas basadas en transformers en lugar de U-Nets, que manejan resoluciones muy altas de forma más eficiente y permiten seguir los prompts con más matices.
Los prompts de texto y cómo guían el ruido
Explicar cómo un modelo de difusión genera imágenes a partir del ruido es la primera parte de la historia. La segunda parte es explicar cómo los prompts de texto controlan qué imagen surge. Aquí es donde los modelos de texto a imagen se diferencian de los modelos de difusión simples.
CLIP y el puente entre palabras e imágenes
Los modelos de difusión guiados por texto usan un modelo aparte llamado CLIP (o codificadores de texto similares) para traducir tu prompt escrito a una representación numérica. CLIP se entrenó con cientos de millones de pares imagen-texto de internet, aprendiendo qué palabras y frases suelen aparecer junto a qué conceptos visuales.
Cuando escribes un prompt, CLIP lo convierte en un vector, una lista de números que representa el significado semántico de tu texto en un espacio donde los conceptos relacionados están cerca. Un prompt como "una manzana roja sobre una mesa de madera" produce un vector que está matemáticamente cerca de los vectores de conceptos relacionados como "fruta", "bodegón de cocina" y "luz natural".
Ese vector se introduce en el modelo de difusión en cada paso de eliminación de ruido, actuando como una guía constante que empuja la imagen que surge hacia el concepto descrito. Sin esa guía, el modelo generaría imágenes fotorrealistas aleatorias sin ninguna relación con tus palabras.
Guía sin clasificador
Existe una técnica llamada guía sin clasificador (classifier-free guidance) que hace que los resultados de texto a imagen sean notablemente más nítidos y se ajusten mejor al prompt. Esta es la idea básica:
En cada paso de eliminación de ruido, el modelo se ejecuta dos veces:
- Una vez con el prompt de texto, prediciendo el ruido condicionado por tu descripción
- Una vez sin ningún prompt, prediciendo el ruido solo a partir de la imagen
La predicción final de ruido combina ambas: parte de la predicción sin prompt y suma una versión amplificada de la diferencia entre las predicciones con y sin prompt. Esta amplificación (el ajuste de guidance scale que verás en muchas interfaces) empuja el resultado con más fuerza hacia tu prompt, a costa de cierta diversidad en la imagen.
💡 Consejo práctico: Los valores altos de guidance scale (7-10) producen imágenes que coinciden muy literalmente con tu prompt. Los valores bajos (3-5) producen resultados más creativos, pero a veces inesperados.
Los modelos de difusión más populares ahora mismo
El panorama de los modelos de difusión ha cambiado muy rápido. Un modelo que era lo más avanzado hace dos años suele quedar muy por detrás de lo que hay disponible hoy. Así están las cosas.
Stable Diffusion y sus versiones
Stable Diffusion fue el modelo que acercó la generación de imágenes por difusión al público. Lanzado en 2022 por Stability AI, fue el primer gran modelo de texto a imagen con pesos abiertos, lo que significa que cualquiera podía ejecutarlo en su propio hardware.
Su innovación central fue la difusión latente: en lugar de ejecutar el proceso de eliminación de ruido directamente sobre los valores de píxel (algo costoso computacionalmente en resoluciones altas), lo ejecuta en un "espacio latente" comprimido y solo decodifica el resultado a píxeles al final. Esto hizo práctica la generación de alta calidad en equipos de consumo.
Desde entonces, la familia se ha expandido considerablemente:
- Stable Diffusion 3.5 Large usa una arquitectura basada en transformers para seguir mucho mejor los prompts y renderizar mejor los detalles finos
- Stable Diffusion 3.5 Medium ofrece un buen equilibrio entre calidad y velocidad de generación para el uso diario
- SDXL introdujo una resolución nativa más alta y un mejor manejo de composiciones complejas con varios sujetos
Flux y la nueva generación
La familia Flux de Black Forest Labs representa la vanguardia actual de los modelos de difusión de código abierto. Creada por muchos de los mismos investigadores que desarrollaron Stable Diffusion, Flux usa un enfoque de flow matching en lugar de la difusión tradicional, lo que técnicamente lo convierte en un pariente cercano más que en un modelo de difusión puro, pero opera con los mismos principios básicos y se entrena de la misma manera.
| Modelo | Ideal para | Velocidad |
|---|
| Flux Schnell | Prototipado rápido, gran volumen | Muy rápida (1-4 pasos) |
| Flux Dev | Trabajo creativo de calidad | Moderada |
| Flux Pro | Resultados de nivel comercial | Moderada |
| Flux 1.1 Pro | Producción de máxima calidad | Moderada |
| Flux 2 Pro | Generación y edición de imágenes | Moderada |
Lo que distingue a Flux es su manejo excepcional del texto dentro de las imágenes, el detalle anatómico fino y la precisión con los prompts. Donde los modelos anteriores tenían problemas para renderizar una mano coherente o una palabra legible en una escena, Flux maneja ambas cosas con fiabilidad.
Otros modelos destacados
El ecosistema de modelos de difusión va mucho más allá de estas dos familias. Algunos otros que merece la pena conocer:
- Imagen 4 de Google ofrece un fotorrealismo rico y una fidelidad de iluminación excepcional en una gran variedad de sujetos
- Kandinsky 2 de AI Forever ofrece un sólido soporte para prompts multilingües, lo que lo hace más accesible en todo el mundo
- Material Diffusion se especializa en generar texturas sin costuras y repetibles en mosaico para trabajos 3D, desarrollo de videojuegos y diseño de producto
- Realistic Vision v5.1 está ajustado específicamente para retratos fotorrealistas y fotografía de estilo de vida
Prueba estos modelos ahora mismo
No necesitas una GPU, un entorno de Python ni conocimientos técnicos para ejecutar estos modelos hoy. PicassoIA te da acceso directo a más de 91 modelos de difusión de texto a imagen a través de una interfaz de navegador, sin instalación.
Esto es lo que puedes hacer ahora mismo:
- Genera retratos, paisajes y fotos de producto con Flux Dev o Stable Diffusion 3.5 Large
- Experimenta con velocidad frente a calidad comparando Flux Schnell con Flux 1.1 Pro Ultra
- Edita fotos existentes con herramientas de inpainting y outpainting que usan la difusión para rellenar o extender imágenes de forma natural
- Escala y restaura imágenes con modelos de superresolución que aplican principios de eliminación de ruido similares para recuperar detalles finos
La mejor forma de entender qué hace un modelo de difusión es usar uno. Escribe un prompt, observa el resultado, cambia una palabra y mira cómo cambia. La intuición que obtienes en unos pocos minutos de práctica vale más que horas de lectura de explicaciones.
Los modelos de difusión funcionan porque aprendieron del mundo. Cada imagen que generan lleva la huella estadística de millones de fotografías reales. Cuando escribes una descripción y aparece una imagen, lo que ves es un modelo que dedicó miles de millones de pasos de entrenamiento a responder una pregunta: ¿cómo se ve el mundo cuando se elimina toda la aleatoriedad?
Esa pregunta, planteada a gran escala, acaba produciendo algo muy cercano a la realidad.


