Si vous avez déjà tapé une phrase et vu un ordinateur générer une image photoréaliste à partir de rien, vous avez déjà vu un modèle de diffusion à l’œuvre. Ces modèles se trouvent derrière la plupart des grands générateurs d’images d’IA actuels, de Stable Diffusion à Flux Dev, et leur fonctionnement est bien plus simple à saisir que la plupart des gens ne le pensent. Cet article explique les modèles de diffusion sans équations, sans jargon et sans passer sous silence les éléments qui comptent vraiment.
Le problème du bruit dont personne ne parle
La plupart des explications sur les modèles de diffusion commencent par des mathématiques complexes. Ce n’est pas le bon point de départ. Le bon point de départ est une question bien plus simple : et si vous pouviez apprendre à un ordinateur à défaire le hasard ?
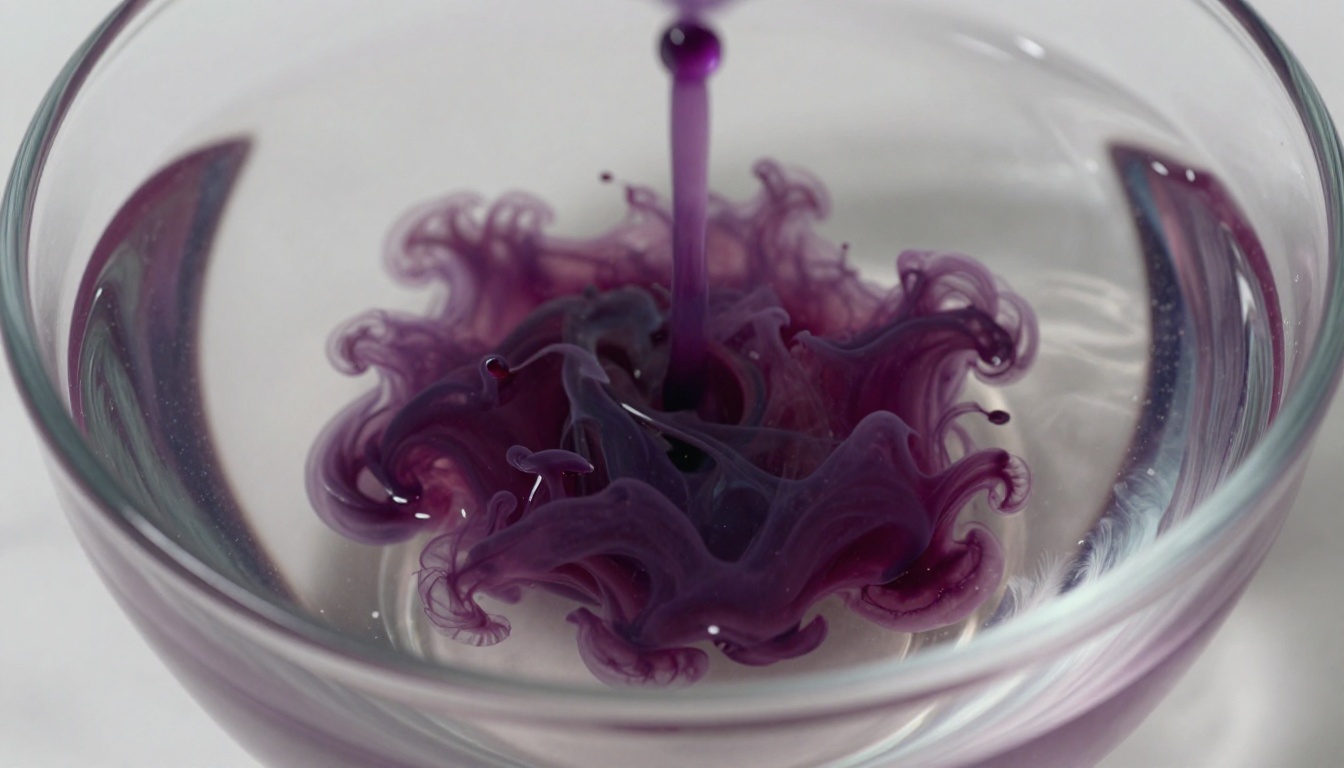
Pensez à ce qui se passe quand vous versez une goutte d’encre dans un verre d’eau et que vous remuez. L’encre se répand, se mélange et finit par être impossible à localiser. Ce processus de dispersion, d’uniformisation, de perte de structure, s’appelle la diffusion. Il se produit avec l’encre dans l’eau, avec la chaleur qui traverse une tige de métal, et avec un parfum dans une pièce.
Les modèles de diffusion reprennent cette idée et la font fonctionner à l’envers.
Pourquoi le bruit est un point de départ logique
Dans le monde des images, le « bruit » désigne des valeurs de pixels aléatoires. Prenez n’importe quelle photographie, ajoutez suffisamment de valeurs aléatoires à chaque pixel, et vous obtenez de la neige, comme sur un téléviseur en panne. L’image d’origine a totalement disparu.
C’est le point de départ de tout modèle de diffusion. Non pas parce que c’est intéressant, mais parce que c’est utile. Le bruit pur est facile à générer. Vous n’avez pas besoin d’un jeu de données d’images pour produire des pixels aléatoires. Vous pouvez les créer instantanément, à partir de rien.
L’idée qui a rendu les modèles de diffusion praticables est la suivante : si vous pouvez entraîner un réseau de neurones à prendre une image légèrement bruitée et à prédire à quoi ressemble la version propre, vous pouvez enchaîner ce processus des centaines de fois pour passer du bruit pur à une image cohérente.
Au fond, un modèle de diffusion est un réseau de neurones qui a une seule mission : prédire le bruit dans une image. Cela paraît presque trop simple, mais cette seule capacité, à grande échelle avec suffisamment de données et de calcul, produit les résultats photoréalistes que vous voyez aujourd’hui.
La première étape consiste à détruire
L’entraînement commence par la destruction volontaire d’images. Les chercheurs prennent des millions de photographies réelles et, de manière contrôlée, y ajoutent un bruit gaussien aléatoire à de nombreux niveaux différents. Au niveau de bruit 1, l’image paraît presque normale, juste un peu granuleuse. Au niveau 500, elle est fortement dégradée. Au niveau 1 000, ce n’est plus que de la neige.
Pour chaque version bruitée, on indique au réseau : voici l’image bruitée, voici le niveau de bruit, maintenant prédisez à quoi ressemble le bruit. Au fil de millions d’exemples d’entraînement, le réseau apprend très bien à reconnaître des motifs de bruit à tous les niveaux d’intensité.
La deuxième étape est là où opère la magie
Une fois entraîné, vous faites fonctionner le modèle à l’envers. Vous partez d’une image de bruit totalement aléatoire, vous la donnez au réseau, vous lui demandez de prédire le bruit à l’étape 1 000, de soustraire une partie de ce bruit, puis de prédire le bruit à l’étape 999, de soustraire à nouveau, et ainsi de suite.
Après 1 000 de ces petites étapes de débruitage, la neige s’est transformée en une image cohérente. Le réseau n’a jamais reçu l’instruction de dessiner quoi que ce soit de précis. On lui a seulement demandé de retirer du bruit. Mais comme il a appris à partir de millions de photographies réelles, l’image qui émerge ressemble à une vraie photographie.
💡 L’idée centrale : les modèles de diffusion ne génèrent pas d’images en dessinant à partir de zéro. Ils génèrent par soustraction, en retirant le bruit jusqu’à ce que la structure apparaisse.
Ce que le réseau apprend réellement
Ce qui surprend le plus dans les modèles de diffusion, c’est ce que le réseau de neurones apprend réellement pendant l’entraînement. Il n’apprend pas à dessiner des yeux, des arbres ou des visages. Il apprend la structure statistique des images, les motifs qui font que des arrangements de pixels ressemblent à de vraies choses plutôt qu’à du bruit aléatoire.
Le fonctionnement de la boucle d’entraînement
Voici à quoi ressemble la boucle d’entraînement, en termes simples :
- Prendre une image réelle dans le jeu de données
- Choisir un niveau de bruit aléatoire entre 1 et 1 000
- Ajouter exactement cette quantité de bruit à l’image
- Montrer l’image bruitée et le niveau de bruit au réseau
- Demander au réseau de prédire le bruit original qui a été ajouté
- Comparer la prédiction au bruit réel
- Ajuster les poids du réseau pour que la prédiction suivante soit légèrement meilleure
- Répéter des milliards de fois
Après suffisamment d’itérations, le réseau a vu tellement d’exemples qu’il a intériorisé ce que signifie une « image naturelle » à un niveau statistique profond. Il sait, sans qu’on le lui dise explicitement, que les pixels du ciel apparaissent généralement au-dessus des pixels du sol, que les visages présentent une certaine symétrie, que les textures se répètent de façons prévisibles.
Pourquoi 1 000 étapes changent tout
Les premières approches de diffusion essayaient de passer directement du bruit à l’image en une seule fois. Les résultats étaient médiocres. Le saut était trop grand, trop d’informations devaient être déduites d’un coup.
Découper le processus en 1 000 petites étapes change radicalement la difficulté de chaque étape. À chaque étape, le réseau n’a besoin de faire qu’une petite correction. Les petites corrections sont plus faciles à prédire avec précision. L’accumulation de 1 000 petites corrections précises produit un résultat grand et précis.
C’est pourquoi les travaux ultérieurs se sont fortement concentrés sur la réduction du nombre d’étapes nécessaires, avec SDXL Lightning 4Step, qui permet d’obtenir des résultats de qualité en seulement 4 étapes, ou Flux Schnell, qui produit des images nettes en quelques secondes.
Direct ou inverse, en termes simples
Les deux moitiés d’un modèle de diffusion ont des noms formels : le processus direct et le processus inverse. En pratique, ils sont simples à décrire.
Un sens détruit, l’autre construit
| Processus | Sens | Ce qui se passe | Quand il s’exécute |
|---|
| Direct | De l’image vers le bruit | Ajoute progressivement du bruit gaussien jusqu’à détruire l’image | Uniquement pendant l’entraînement |
| Inverse | Du bruit vers l’image | Retire progressivement le bruit jusqu’à reconstruire l’image | Pendant l’inférence (génération d’images) |
Le processus direct n’a aucun paramètre apprenable. Ce n’est qu’une formule mathématique qui ajoute du bruit. Le processus inverse, lui, est là où vit le réseau de neurones. Toute l’intelligence réside dans l’apprentissage de ce second sens.
Le rôle du U-Net
L’architecture de réseau de neurones qu’utilisent la plupart des modèles de diffusion s’appelle un U-Net. Le nom vient de sa forme : il compresse l’image en une petite représentation (le bas du U), puis la réétend à sa taille complète (le côté droit du U), avec des connexions entre les niveaux correspondants de chaque côté.
Cette architecture est particulièrement efficace pour traiter les images, car :
- La compression capture la structure globale (s’agit-il d’une scène en extérieur ou en intérieur ?)
- L’expansion reconstruit les détails fins (à quoi ressemble la texture de l’herbe ici ?)
- Les connexions de saut laissent les détails fins passer directement de la compression à l’expansion sans se perdre
Des modèles plus récents comme Flux Dev sont passés à des architectures basées sur les transformeurs plutôt qu’aux U-Net, qui gèrent plus efficacement les très hautes résolutions et permettent de suivre les prompts de façon plus nuancée.
Les prompts textuels et la façon dont ils orientent le bruit
Expliquer comment un modèle de diffusion génère des images à partir du bruit n’est que la première partie de l’histoire. La seconde consiste à expliquer comment les prompts textuels contrôlent l’image qui émerge. C’est là que les modèles texte vers image se distinguent des modèles de diffusion simples.
CLIP, le pont entre les mots et les images
Les modèles de diffusion guidés par texte utilisent un modèle séparé appelé CLIP (ou d’autres encodeurs de texte similaires) pour traduire votre prompt écrit en une représentation numérique. CLIP a été entraîné sur des centaines de millions de paires image-texte issues d’internet, apprenant quels mots et expressions apparaissent généralement avec quels concepts visuels.
Quand vous tapez un prompt, CLIP le convertit en un vecteur, une liste de nombres qui représente le sens de votre texte dans un espace où les concepts apparentés sont proches. Un prompt du type « une pomme rouge sur une table en bois » produit un vecteur mathématiquement proche de vecteurs liés à des concepts comme « fruit », « nature morte de cuisine » et « lumière naturelle ».
Ce vecteur est ensuite transmis au modèle de diffusion à chaque étape de débruitage, faisant office de guide constant qui oriente l’image en train de se former vers le concept décrit. Sans ce guidage, le modèle générerait simplement des images photoréalistes aléatoires, sans lien avec vos mots.
Le guidage sans classifieur
Il existe une technique appelée guidage sans classifieur (classifier-free guidance) qui rend les résultats texte vers image nettement plus nets et plus fidèles au prompt. Voici l’idée de base :
À chaque étape de débruitage, le modèle s’exécute deux fois :
- Une fois avec le prompt textuel, en prédisant le bruit conditionné par votre description
- Une fois sans aucun prompt, en prédisant le bruit à partir de l’image seule
La prédiction finale du bruit combine les deux : on part de la prédiction sans prompt et on ajoute une version amplifiée de la différence entre la prédiction avec prompt et la prédiction sans prompt. Cette amplification (le réglage du guidance scale que vous voyez dans de nombreuses interfaces) pousse le résultat plus fortement vers votre prompt, au prix d’une certaine diversité de l’image.
💡 Conseil pratique : des valeurs élevées de guidance scale (7 à 10) produisent des images qui correspondent très littéralement à votre prompt. Des valeurs plus basses (3 à 5) donnent des résultats plus créatifs, mais parfois inattendus.
Les modèles de diffusion populaires aujourd’hui
Le paysage des modèles de diffusion a évolué rapidement. Un modèle à la pointe il y a deux ans est souvent largement dépassé par ce qui est disponible aujourd’hui. Voici où en sont les choses.
Stable Diffusion et ses versions
Stable Diffusion a été le modèle qui a rendu la génération d’images par diffusion accessible au public. Publié en 2022 par Stability AI, c’était le premier grand modèle texte vers image à poids ouverts, ce qui signifie que chacun pouvait le faire tourner sur son propre matériel.
Son innovation majeure était la diffusion latente : au lieu d’exécuter le processus de débruitage directement sur les valeurs des pixels (ce qui est coûteux en calcul à haute résolution), il s’exécute dans un « espace latent » compressé et ne décode le résultat en pixels qu’à la toute fin. Cela a rendu la génération de haute qualité praticable sur du matériel grand public.
Depuis, la famille s’est considérablement étoffée :
- Stable Diffusion 3.5 Large utilise une architecture basée sur les transformeurs pour un respect du prompt et un rendu des détails fins nettement meilleurs
- Stable Diffusion 3.5 Medium offre un bon équilibre entre qualité et vitesse de génération pour un usage quotidien
- SDXL a introduit une résolution native plus élevée et une meilleure gestion des compositions complexes à plusieurs sujets
Flux et la nouvelle génération
La famille Flux de Black Forest Labs représente la pointe actuelle des modèles de diffusion open source. Conçue par bon nombre des mêmes chercheurs qui ont créé Stable Diffusion, Flux utilise une approche d’appariement de flux (flow matching) plutôt que la diffusion traditionnelle, ce qui en fait techniquement un proche parent plutôt qu’un modèle de diffusion pur, mais il repose sur les mêmes principes fondamentaux et est entraîné de la même manière.
| Modèle | Idéal pour | Vitesse |
|---|
| Flux Schnell | Prototypage rapide, gros volumes | Très rapide (1 à 4 étapes) |
| Flux Dev | Travail créatif de qualité | Modérée |
| Flux Pro | Résultats de qualité commerciale | Modérée |
| Flux 1.1 Pro | Production à qualité maximale | Modérée |
| Flux 2 Pro | Génération et retouche d’images | Modérée |
Ce qui distingue Flux, c’est sa gestion exceptionnelle du texte dans les images, de la finesse de l’anatomie et de la précision du prompt. Là où les modèles précédents peinaient à rendre une main cohérente ou un mot lisible dans une scène, Flux gère les deux de façon fiable.
Autres modèles notables
L’écosystème des modèles de diffusion dépasse largement ces deux familles. Quelques autres à connaître :
- Imagen 4 de Google offre un photoréalisme riche et une fidélité d’éclairage exceptionnelle sur un large éventail de sujets
- Kandinsky 2 d’AI Forever propose une prise en charge solide des prompts multilingues, ce qui le rend plus accessible à l’échelle mondiale
- Material Diffusion est spécialisé dans la génération de textures sans couture et répétables pour la 3D, le développement de jeux et le design de produits
- Realistic Vision v5.1 est spécifiquement affiné pour la photographie de portrait et la photographie de mode de vie photoréaliste
Essayez ces modèles dès maintenant
Vous n’avez besoin ni de GPU, ni d’environnement Python, ni de connaissances techniques pour faire tourner ces modèles aujourd’hui. PicassoIA vous donne un accès direct à plus de 91 modèles de diffusion texte vers image via une interface de navigateur, sans aucune installation.
Voici ce que vous pouvez faire dès maintenant :
- Générer des portraits, des paysages et des photos de produits avec Flux Dev ou Stable Diffusion 3.5 Large
- Comparer vitesse et qualité en mettant Flux Schnell face à Flux 1.1 Pro Ultra
- Retoucher des photos existantes avec des outils d’inpainting et d’outpainting qui utilisent la diffusion pour compléter ou étendre les images naturellement
- Augmenter la résolution et restaurer des images à l’aide de modèles de super-résolution qui appliquent des principes de débruitage similaires pour retrouver les détails fins
La meilleure façon de comprendre ce que fait un modèle de diffusion est d’en utiliser un. Tapez un prompt, observez le résultat, changez un mot, regardez-le changer. L’intuition que vous acquérez en quelques minutes de pratique vaut plus que des heures de lecture d’explications.
Les modèles de diffusion fonctionnent parce qu’ils ont appris du monde. Chaque image qu’ils génèrent porte l’empreinte statistique de millions de photographies réelles. Quand vous tapez une description et qu’une image apparaît, ce que vous voyez est un modèle qui a passé des milliards d’étapes d’entraînement à répondre à une seule question : à quoi ressemble le monde lorsque tout le hasard a été retiré ?
Posée à grande échelle, cette question produit, étonnamment, quelque chose de très proche de la réalité.


