El mundo de la generación de imágenes con IA se ha vuelto aún más interesante. Z-Image, un modelo de código abierto recién publicado, ha dado que hablar en los círculos de aprendizaje automático por una razón sencilla: sus resultados rivalizan con algunos de los sistemas propietarios más caros disponibles hoy, y lo hace con pesos públicamente disponibles que cualquiera puede descargar, ejecutar y ajustar. Esa combinación, acceso gratuito y una calidad de salida seria, es algo por lo que la comunidad de código abierto lleva años trabajando.
Si llevas tiempo siguiendo la evolución de los modelos de texto a imagen, ya sabes lo rápido que avanza este campo. Flux Kontext Dev, Stable Diffusion 3, Seedream 4.5 e Imagen 4 Ultra han ampliado los límites de distintas formas. Z-Image entra en este campo con un enfoque propio, y merece la pena tomárselo en serio.
Qué es Z-Image en realidad
Z-Image es un modelo de difusión de texto a imagen construido sobre una arquitectura de código abierto y publicado con pesos totalmente accesibles. A diferencia de los modelos que están detrás de muros de pago de API o de licencias propietarias, Z-Image te pone el modelo real en las manos. Puedes ejecutar inferencia localmente, crear aplicaciones sobre él o modificarlo para tareas especializadas sin pedir permiso a ningún proveedor.
El nombre es sencillo: la Z indica el enfoque del modelo para la síntesis de imágenes en el espacio latente, un guiño a la variable latente Z que se usa en los marcos variacionales. Es un poco de marca, pero con raíces en el diseño técnico.
La arquitectura que hay detrás
Z-Image usa un backbone de difusión basado en transformers, alejándose de las arquitecturas U-Net que definieron las primeras versiones de Stable Diffusion. Esta decisión arquitectónica encaja con las tendencias generales del campo: los modelos de difusión basados en transformers, como Flux 2 Klein 9B, han demostrado un mejor comportamiento al escalar y una mayor coherencia espacial a larga distancia que los equivalentes con U-Net.
Propiedades técnicas clave:
- Difusión latente en un espacio comprimido para una inferencia más rápida sin sacrificar la resolución de salida
- Objetivo de entrenamiento por flow matching, que produce gradientes más limpios y un entrenamiento más estable que los enfoques DDPM estándar
- Soporte nativo de 1024x1024 con opciones para generar en resoluciones más altas mediante tiling
- Condicionamiento multimodal que acepta tanto prompts de texto como imágenes de referencia como señales de guía
Según se informa, el conjunto de datos de entrenamiento se nutre de miles de millones de pares imagen-texto, con un filtrado exigente por calidad, diversidad y derechos de uso, aunque los detalles concretos de la composición del conjunto siguen parcialmente sin revelar en la publicación inicial.
Por qué el código abierto cambia las cosas
Cuando un modelo así se publica con pesos abiertos, la comunidad puede hacer cosas que una API cerrada nunca permite. Los investigadores lo ajustan con datos de un dominio concreto en cuestión de horas. Los desarrolladores lo integran en aplicaciones sin estructuras de costo por consulta. Los artistas lo adaptan a su estética personal sin negociar licencias comerciales.
Esto importa porque la mayoría de los modelos realmente capaces en 2027 siguen cerrados. GPT Image 2 de OpenAI produce resultados impresionantes, pero cobra por cada generación. Imagen 4 Ultra de Google requiere acceso mediante API. Z-Image cambia esa ecuación en la síntesis de imágenes.
💡 Los pesos abiertos no significan solo gratis. Significan que se pueden bifurcar, auditar y adaptar de un modo que los modelos cerrados sencillamente no permiten.
Z-Image frente a la competencia
Frente a los modelos propietarios
Comparar Z-Image con las opciones propietarias revela un panorama matizado. En los benchmarks de fotorrealismo puro, se sitúa en un rango competitivo con modelos que cuestan bastante más de ejecutar a escala.
Los modelos propietarios todavía tienen ventaja en ciertas dimensiones de calidad, sobre todo en la renderización de texto y en la composición de escenas complejas. Pero la diferencia es menor que hace dos años. Para la mayoría de los casos de uso en producción, la salida de Z-Image es totalmente suficiente.
Frente a otros modelos abiertos
Dentro del panorama de código abierto, Z-Image compite directamente con Stable Diffusion 3 y Flux Schnell LoRA. La comparación es instructiva:
- Z-Image frente a SD3: Z-Image supera ligeramente en fotorrealismo con un número comparable de pasos de inferencia, sobre todo en retratos y texturas orgánicas. SD3 conserva ventajas en flexibilidad estilística y en la profundidad de su ecosistema de ajuste fino.
- Z-Image frente a Flux Schnell LoRA: Flux sigue siendo más rápido con pocos pasos gracias a la destilación. Z-Image reduce la diferencia de calidad cuando se le dan 20 pasos o más, sobre todo en escenas de mucho detalle.
Lo que hace destacar a Z-Image
Calidad de imagen de un vistazo
Las tres áreas en las que Z-Image impresiona de forma constante son:
1. Renderizado de piel y texturas orgánicas
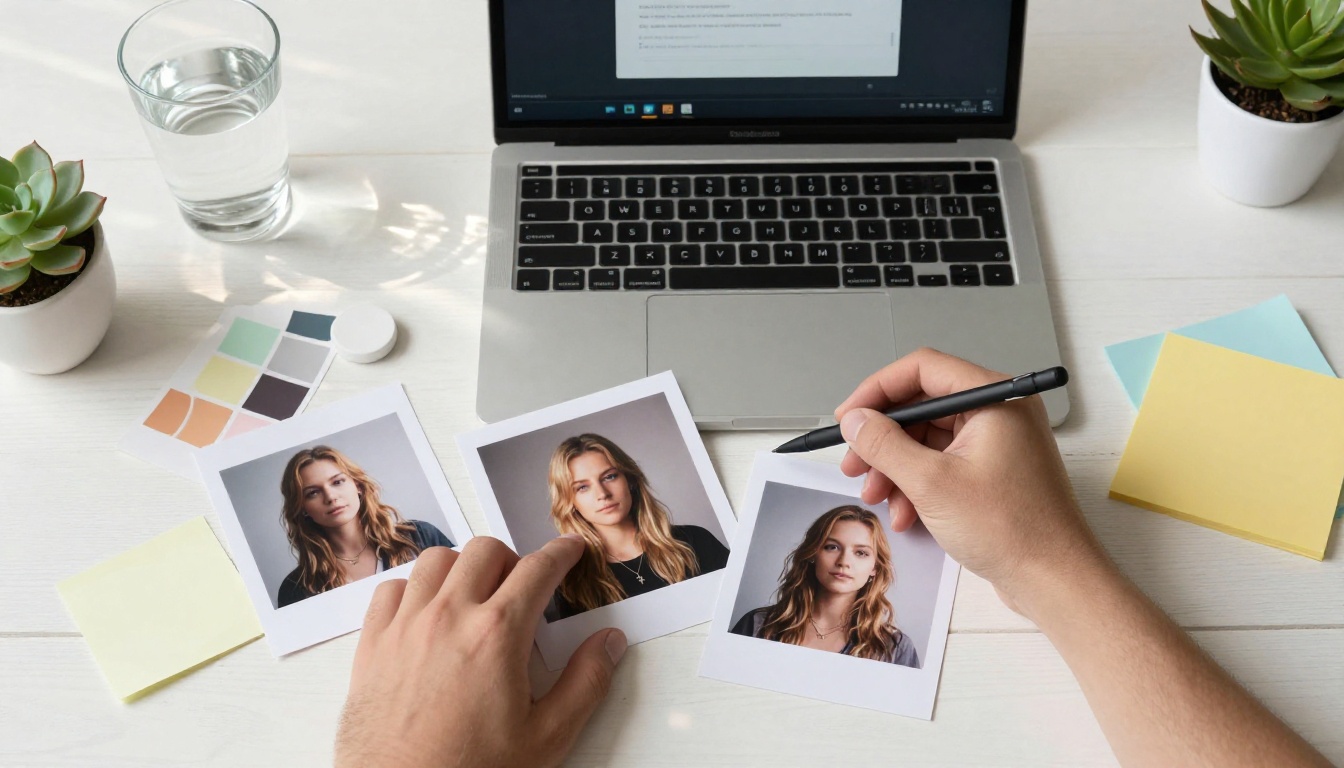
Los resultados de retratos muestran un microdetalle excepcional, poros visibles, dispersión subsuperficial realista y una separación natural de los mechones de pelo. Es el problema más difícil de la generación fotorrealista, y Z-Image lo resuelve con menos artefactos que la mayoría de sus predecesores de código abierto.
2. Coherencia de la iluminación
La luz volumétrica, la ubicación de las sombras y los brillos especulares se comportan de forma físicamente coherente en todo el encuadre. No verás direcciones de sombra desajustadas ni fuentes de luz flotantes, que sí afectaban a los modelos de difusión anteriores.
3. Claridad compositiva
Los mecanismos de atención global del backbone de transformers producen imágenes con una jerarquía clara entre sujeto y fondo. El espacio negativo se usa correctamente y las señales de profundidad se conservan durante todo el proceso de generación.
💡 La prueba más reveladora de cualquier modelo de imagen es cómo gestiona las manos. Z-Image lo hace mejor que la media, aunque las poses de manos complejas siguen produciendo errores anatómicos ocasionales, como ocurre con todos los modelos actuales.
Velocidad y eficiencia
En una GPU de consumo con 12 GB de VRAM, Z-Image genera una imagen de 1024x1024 en unos 8 a 12 segundos con 30 pasos de inferencia usando la programación DPM++ 2M Karras. Eso está dentro de un rango práctico para flujos de trabajo creativos.
Con menos pasos (de 10 a 15), la calidad se degrada menos que con los modelos antiguos entrenados con DDPM, y eso es un beneficio directo del objetivo de entrenamiento por flow matching. Esto hace que Z-Image sea realmente útil en escenarios de iteración en tiempo real, cuando pruebas variaciones de prompt con rapidez.
Casos de uso reales
Para creadores de contenido
Los creadores de contenido son la mayor base de usuarios potenciales de Z-Image. La salida fotorrealista del modelo lo hace directamente aplicable a:
- Flujos de trabajo de fotografía de stock: genera tomas de referencia, paneles de inspiración y recursos de maqueta sin pagar licencias
- Contenido para redes sociales: imágenes de estilo retrato, tomas de estilo de vida y visualización de productos con una calidad que pasa la inspección visual
- Ilustración editorial: imágenes conceptuales para artículos, presentaciones y narración visual en las que el fotorrealismo es la estética objetivo
- Creación de activos de marca: generación de personajes y entornos coherentes en varias piezas mediante ajuste fino con LoRA
Si ya usas P Image o Recraft 20B, Z-Image añade otra opción de alta calidad a la rotación, sobre todo para tomas que requieren sujetos humanos de aspecto natural.
Para desarrolladores
Los pesos abiertos aportan un valor significativo a los desarrolladores de aplicaciones. Entre los escenarios concretos se incluyen:
- Pipelines de ajuste fino personalizados: entrena LoRA específicos de dominio con los pesos base para aplicaciones en imagen médica, fotografía de producto, inmobiliaria o moda
- Despliegue en el borde: las versiones cuantizadas de Z-Image pueden ejecutarse en equipos con 8 GB de VRAM o menos, lo que abre aplicaciones de inferencia en local que no dependen de la conexión a la nube
- Integración con pipelines multimodales: usa Z-Image como paso de generación visual en flujos de trabajo más amplios que combinan generación de texto, análisis de imágenes y creación de resultados
- Pipelines de pruebas A/B: ejecuta experimentos de generación con variantes de prompt usando la arquitectura constante como variable controlada
La ventaja del código abierto
Ajuste fino y personalización
Con pesos abiertos, Z-Image es un punto de partida, no un producto terminado. La comunidad de IA ya ha empezado a crear versiones ajustadas por dominio y adaptadores LoRA que llevan sus capacidades en direcciones concretas.
Enfoques de ajuste fino que funcionan bien con la arquitectura de Z-Image:
- DreamBooth: personalización de un sujeto concreto para generar personajes coherentes en distintos prompts
- LoRA (Low-Rank Adaptation): ajuste ligero de estilo o de sujeto que añade tan solo entre 2 y 4 MB al tamaño del modelo base
- Textual Inversion: embeddings de concepto para capturar cualidades estéticas concretas sin modificar el modelo completo
- Ajuste fino completo: reentrenamiento específico de dominio con conjuntos de datos curados para aplicaciones profesionales especializadas
El backbone de transformers hace que la adaptación con LoRA sea especialmente limpia, con menos particularidades por capa que el ajuste fino de una U-Net.
Ejecutarlo en local
Para los desarrolladores que quieren control total, ejecutar Z-Image en local es sencillo con una GPU de consumo moderna. La configuración recomendada es:
- Mínimo: 10 GB de VRAM, 16 GB de RAM del sistema
- Recomendado: de 12 a 16 GB de VRAM para resolución nativa sin tiling
- Óptimo: 24 GB de VRAM para generación en alta resolución y procesamiento por lotes
Herramientas como Automatic1111, ComfyUI e InvokeAI ya han añadido compatibilidad con Z-Image, lo que hace que la configuración sea accesible para quienes no son especialistas y pueden usar flujos de trabajo con interfaz gráfica que ya conocen.
💡 Si quieres evitarte por completo la configuración en local, plataformas como Picasso IA te dan acceso inmediato a potentes modelos de texto a imagen, entre ellos Flux Kontext Dev, Seedream 4.5 y Hunyuan Image 2.1, sin necesidad de GPU.
Dónde se sitúa Z-Image en 2027
Recepción de la comunidad
La publicación generó una actividad notable en Hugging Face durante su primera semana, con el repositorio del modelo acumulando decenas de miles de descargas y miembros de la comunidad compartiendo rápidamente comparaciones de resultados. La recepción inicial fue positiva, sobre todo entre usuarios centrados en casos de uso de fotografía de retrato y de estilo de vida.
Varios benchmarks de la comunidad situaron a Z-Image en el nivel más alto de los modelos de código abierto en fotorrealismo, aunque los distintos marcos de evaluación producen clasificaciones algo diferentes. Benchmarks como FID (Frechet Inception Distance), las puntuaciones de alineación CLIP y los estudios de preferencia humana cuentan historias distintas sobre la calidad de un modelo, y el rendimiento de Z-Image varía según la métrica. Puntúa especialmente bien en las valoraciones de preferencia humana para imágenes de retrato y escenas exteriores.
La comunidad de ajuste fino ya ha producido varios cientos de adaptadores LoRA que cubren estilos estéticos que van desde simulaciones de grano de película hasta especializaciones en fotografía de arquitectura.
Qué viene para los modelos abiertos
Z-Image representa parte de una tendencia más amplia: la diferencia de calidad entre los modelos de imagen de código abierto y los propietarios se reduce cada trimestre. Cuando DALL-E 3 tenía una ventaja clara y notable sobre cualquier opción de uso libre, modelos como Z-Image, Flux 2 Klein 9B y Stable Diffusion 3 han reducido bastante esa distancia.
Lo que conviene vigilar en los próximos meses:
- Variantes destiladas: versiones más rápidas y con menos pasos que sacrifican algo de calidad a cambio de ganancias de velocidad de inferencia de 2x a 4x
- Extensión de video: el potencial de extensión temporal de la arquitectura para generar clips cortos a partir de prompts estáticos
- Condicionamiento multimodal: capacidades de imagen a imagen mejoradas que se apoyan en el soporte actual de imágenes de referencia
- Equivalentes de ControlNet: adaptadores de condicionamiento por pose, profundidad y bordes que amplían la controlabilidad de Z-Image
Escribir prompts para Z-Image
Para obtener los mejores resultados con cualquier modelo de difusión hay que entender cómo interpreta el lenguaje. Z-Image responde bien a prompts estructurados y específicos que definen, en orden, el sujeto, el entorno, la iluminación y las características de la cámara.
Lo que funciona:
- Descripciones de iluminación concretas ("luz matinal volumétrica desde la izquierda", "relleno difuso de cielo nublado y suave")
- Referencias de objetivos de cámara ("85 mm f/1.4", "gran angular de 35 mm", "macro de 100 mm")
- Detalles de material y textura ("grano de película Kodak Portra 400", "poros visibles en la piel")
- Encuadre compositivo ("plano contrapicado desde abajo", "vista aérea cenital", "primer plano cerrado")
Lo que conviene evitar:
- Descriptores estéticos vagos sin base técnica ("bonito", "impresionante", "increíble")
- Señales de estilo contradictorias en un mismo prompt
- Sobrecargar un solo prompt con demasiados sujetos o entornos
El entrenamiento por flow matching hace que Z-Image sea más robusto ante la complejidad del prompt que los modelos DDPM anteriores, pero la precisión sigue dando mejores resultados que la ambigüedad.
Pruébalo ahora en Picasso IA
El panorama de la generación de imágenes con IA de código abierto nunca había sido tan capaz, y Z-Image es una incorporación genuina al grupo de los mejores modelos de generación de acceso libre. Su arquitectura de transformers, el entrenamiento por flow matching y sus sólidos resultados en benchmarks de fotorrealismo lo colocan en competencia directa con modelos por los que hay que pagar para acceder.
Tanto si eres desarrollador y creas aplicaciones, como creador que produce contenido visual o investigador que pone a prueba los límites del ajuste fino de modelos abiertos, Z-Image merece un sitio en tu conjunto de herramientas de trabajo.
Si quieres empezar a generar imágenes fotorrealistas de inmediato, sin configurar entornos locales ni gestionar recursos de GPU, Picasso IA te da acceso a más de 90 modelos de texto a imagen en un solo lugar. Prueba Flux Kontext Dev para edición de imágenes con contexto, Seedream 4.5 para resultados 4K impresionantes o Imagen 4 Ultra para máximo detalle y fidelidad. La calidad está ahí. La única variable es lo que decides crear.