Le domaine de la génération d’images par IA devient plus intéressant. Z-Image, un modèle open source récemment publié, fait parler de lui dans les cercles du machine learning pour une raison simple : il produit des résultats qui rivalisent avec certains des systèmes propriétaires les plus coûteux disponibles aujourd’hui, et il le fait avec des poids accessibles publiquement que chacun peut télécharger, exécuter et fine-tuner. Cette combinaison, un accès gratuit associé à une qualité de sortie sérieuse, est ce vers quoi la communauté open source travaille depuis des années.
Si vous suivez l’évolution des modèles de texte vers image, vous savez déjà à quelle vitesse ce domaine avance. Flux Kontext Dev, Stable Diffusion 3, Seedream 4.5 et Imagen 4 Ultra ont tous repoussé les limites de différentes manières. Z-Image entre dans ce domaine avec une approche qui lui est propre, et elle mérite d’être prise au sérieux.
Ce qu’est vraiment Z-Image
Z-Image est un modèle de génération de texte vers image fondé sur la diffusion, construit sur une architecture open source et publié avec des poids entièrement accessibles. Contrairement aux modèles verrouillés derrière des API payantes ou des accords de licence propriétaires, Z-Image vous met le modèle lui-même entre les mains. Vous pouvez effectuer l’inférence en local, créer des applications à partir de celui-ci ou le modifier pour des tâches spécialisées, sans l’autorisation d’un fournisseur.
Le nom est simple : le Z désigne l’approche de l’espace latent utilisée pour la synthèse d’images, en référence à la variable latente Z employée dans les cadres variationnels. C’est un peu de marketing, mais avec des racines dans la conception technique.
L’architecture derrière le modèle
Z-Image utilise un backbone de diffusion basé sur des transformers, en rupture avec les architectures U-Net qui caractérisaient les premières versions de Stable Diffusion. Ce choix architectural s’inscrit dans les tendances générales du domaine : les modèles de diffusion à base de transformers, comme Flux 2 Klein 9B, ont démontré un comportement de montée en échelle supérieur et une meilleure cohérence spatiale à longue distance par rapport aux équivalents U-Net.
Propriétés techniques clés :
- Diffusion latente dans un espace compressé pour une inférence plus rapide sans sacrifier la résolution de sortie
- Objectif d’entraînement en flow matching, qui produit des gradients plus propres et un entraînement plus stable qu’avec les approches DDPM classiques
- Prise en charge native de la résolution 1024x1024, avec des options pour générer à plus haute résolution grâce au tiling
- Conditionnement multimodal qui accepte à la fois des prompts textuels et des images de référence comme signaux de guidage
Le jeu de données d’entraînement puiserait, selon certaines informations, dans des milliards de paires image-texte, avec un filtrage poussé sur la qualité, la diversité et la validation des droits, bien que la composition précise du jeu de données reste en partie non divulguée dans la version initiale.
Pourquoi l’open source change la donne
Lorsqu’un modèle de ce type est publié avec des poids ouverts, la communauté peut faire ce qu’une API fermée ne permettra jamais. Les chercheurs le fine-tunent sur des données spécifiques à un domaine en quelques heures. Les développeurs l’intègrent dans des applications sans structure de coût par requête. Les artistes l’adaptent à leur esthétique personnelle sans négocier de licences commerciales.
Cela compte parce que la plupart des modèles réellement performants en 2027 restent verrouillés. GPT Image 2 d’OpenAI produit des résultats saisissants, mais facture chaque génération. Imagen 4 Ultra de Google nécessite un accès API. Z-Image change cette équation pour la synthèse d’images.
💡 Des poids ouverts ne signifient pas seulement gratuits. Ils signifient modifiables, auditables et adaptables à un niveau que les modèles fermés ne peuvent tout simplement pas atteindre.
Z-Image face à la concurrence
Face aux modèles propriétaires
Comparer Z-Image aux options propriétaires révèle un tableau nuancé. En matière de benchmarks de photoréalisme brut, il se situe dans une fourchette compétitive avec des modèles dont l’exécution à grande échelle coûte nettement plus cher.
Les modèles propriétaires gardent un avantage sur certaines dimensions de qualité, notamment le rendu du texte et la composition de scènes complexes. Mais l’écart est plus étroit qu’il y a deux ans. Pour la plupart des cas d’usage en production, les résultats de Z-Image sont tout à fait suffisants.
Face aux autres modèles open source
Dans le paysage open source, Z-Image rivalise directement avec Stable Diffusion 3 et Flux Schnell LoRA. La comparaison est instructive :
- Z-Image contre SD3 : Z-Image prend un léger avantage en photoréalisme à nombre d’étapes d’inférence comparable, surtout pour les portraits et les textures organiques. SD3 conserve des atouts en matière de souplesse stylistique et de profondeur de son écosystème de fine-tuning.
- Z-Image contre Flux Schnell LoRA : Flux reste plus rapide avec peu d’étapes grâce à la distillation. Z-Image comble l’écart de qualité à partir de 20 étapes ou plus, en particulier dans les scènes très détaillées.
Ce qui distingue Z-Image
La qualité d’image en un coup d’œil
Les trois domaines dans lesquels Z-Image impressionne de façon constante sont :
1. Rendu de la peau et des textures organiques
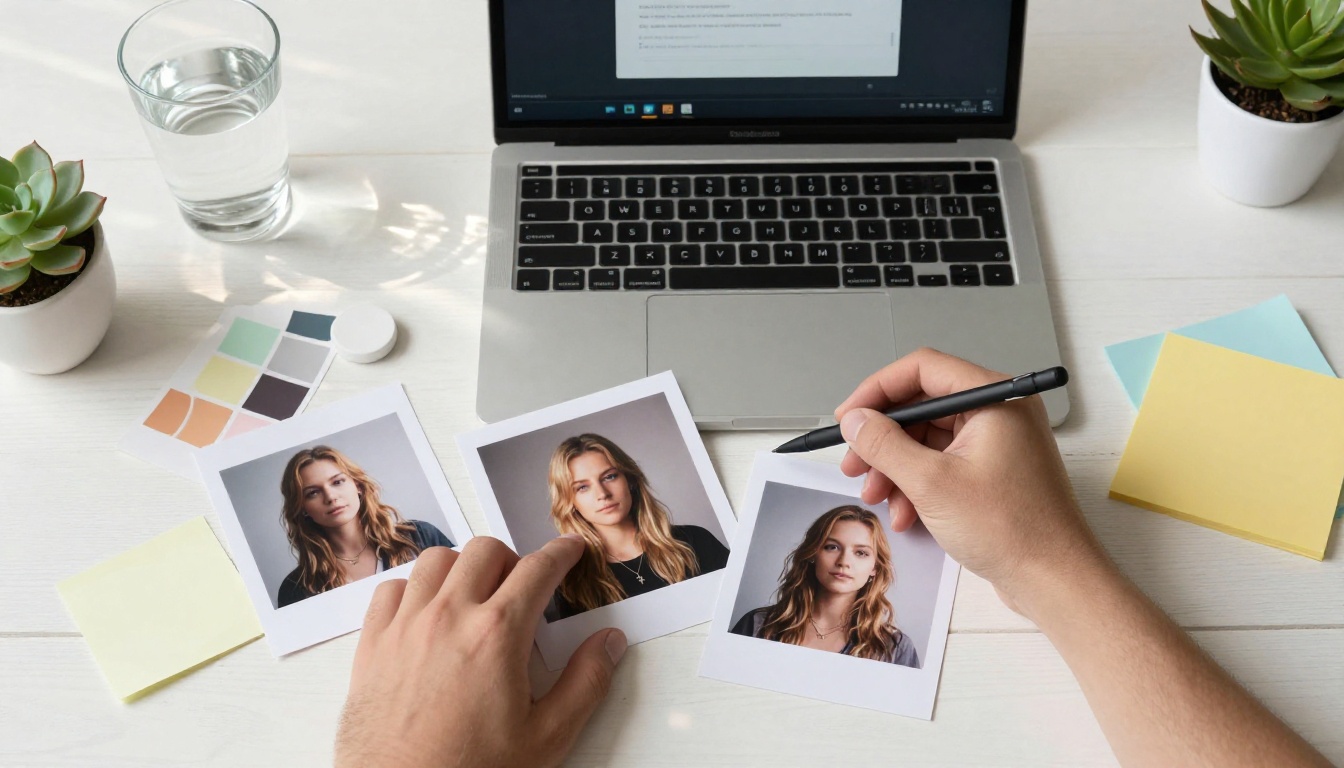
Les sorties de portraits montrent un micro-détail exceptionnel, des pores visibles, une diffusion sous-cutanée réaliste et une séparation naturelle des mèches de cheveux. C’est le problème le plus difficile de la génération photoréaliste, et Z-Image le traite avec moins d’artefacts que la plupart de ses prédécesseurs open source.
2. Cohérence de l’éclairage
L’éclairage volumétrique, le placement des ombres et les reflets spéculaires se comportent physiquement de manière cohérente sur toute l’image. Vous ne verrez pas de directions d’ombres incohérentes ni de sources de lumière flottantes, qui gênaient les premiers modèles de diffusion.
3. Clarté de la composition
Les mécanismes d’attention globale du backbone transformer produisent des images avec une hiérarchie nette entre sujet et arrière-plan. L’espace négatif est utilisé correctement, et les indices de profondeur sont préservés tout au long du processus de génération.
💡 Le test le plus révélateur pour un modèle d’image est sa façon de gérer les mains. Z-Image fait mieux que la moyenne sur ce point, même si les poses de mains complexes produisent encore parfois des erreurs anatomiques, comme avec tous les modèles actuels.
Vitesse et efficacité
Sur un GPU grand public doté de 12 Go de VRAM, Z-Image génère une image 1024x1024 en environ 8 à 12 secondes avec 30 étapes d’inférence et l’ordonnanceur DPM++ 2M Karras. C’est dans la fourchette pratique pour les flux de travail créatifs.
Avec un nombre d’étapes plus faible (10 à 15 étapes), la qualité se dégrade moins qu’avec les anciens modèles entraînés en DDPM, ce qui est un bénéfice direct de l’objectif d’entraînement en flow matching. Cela rend Z-Image réellement utilisable dans les scénarios d’itération en temps réel, où vous testez rapidement des variations de prompts.
Cas d’usage concrets
Pour les créateurs de contenu
Les créateurs de contenu représentent la plus grande base d’utilisateurs potentiels de Z-Image. Le rendu photoréaliste du modèle le rend directement applicable à :
- Flux de travail de photos de banques d’images : générez des images de référence, des planches d’ambiance et des visuels provisoires sans frais de licence
- Contenus pour les réseaux sociaux : images de type portrait, photos de style de vie et visualisation de produits, avec une qualité qui résiste à un contrôle visuel
- Illustration éditoriale : imagerie conceptuelle pour articles, présentations et récits visuels, lorsque le photoréalisme est l’esthétique visée
- Création d’actifs de marque : génération cohérente de personnages et d’environnements sur plusieurs supports grâce au fine-tuning LoRA
Pour les créateurs qui utilisent déjà P Image ou Recraft 20B, Z-Image ajoute une option de haute qualité supplémentaire à leur sélection, en particulier pour les plans nécessitant des sujets humains naturalistes.
Pour les développeurs
Les poids ouverts apportent une valeur importante aux développeurs d’applications. Parmi les scénarios concrets :
- Pipelines de fine-tuning personnalisés : entraînez des LoRA spécifiques à un domaine à partir des poids de base pour des applications en imagerie médicale, photographie de produits, immobilier ou mode
- Déploiement en périphérie : les versions quantifiées de Z-Image peuvent tourner sur des appareils dotés de 8 Go de VRAM ou moins, ce qui ouvre la voie à des applications d’inférence locale qui ne dépendent pas de la connectivité cloud
- Intégration dans des pipelines multimodaux : utilisez Z-Image comme étape de génération visuelle dans des flux plus larges combinant génération de texte, analyse d’images et création de sorties
- Pipelines de tests A/B : lancez des expériences de génération sur des variantes de prompts en utilisant l’architecture constante comme variable contrôlée
L’avantage de l’open source
Fine-tuning et personnalisation
Avec des poids ouverts, Z-Image est un point de départ et non un produit fini. La communauté de l’IA a déjà commencé à produire des fine-tunes spécifiques à un domaine et des adaptateurs LoRA qui poussent ses capacités dans des directions ciblées.
Approches de fine-tuning qui fonctionnent bien avec l’architecture de Z-Image :
- DreamBooth : personnalisation d’un sujet pour une génération cohérente de personnages à travers différents prompts
- LoRA (Low-Rank Adaptation) : adaptation légère de style ou de sujet qui n’ajoute que 2 à 4 Mo à la taille du modèle de base
- Textual Inversion : embedding de concept pour capturer des qualités esthétiques précises sans modification complète du modèle
- Fine-tuning complet : réentraînement spécifique à un domaine sur des jeux de données sélectionnés pour des applications professionnelles spécialisées
Le backbone transformer rend l’adaptation LoRA particulièrement propre, avec moins de particularités propres aux couches par rapport au fine-tuning U-Net.
Exécuter le modèle en local
Pour les développeurs qui veulent un contrôle total, exécuter Z-Image en local est simple avec un GPU grand public récent. La configuration recommandée :
- Minimum : 10 Go de VRAM, 16 Go de RAM système
- Recommandé : 12 à 16 Go de VRAM pour la résolution native sans tiling
- Optimal : 24 Go de VRAM pour la génération en haute résolution et le traitement par lots
Des outils comme Automatic1111, ComfyUI et InvokeAI ont déjà ajouté la prise en charge de Z-Image, rendant la configuration accessible aux non-spécialistes qui peuvent utiliser des flux de travail GUI familiers.
💡 Si vous voulez vous passer complètement de configuration locale, des plateformes comme Picasso IA vous donnent un accès immédiat à de puissants modèles de texte vers image, dont Flux Kontext Dev, Seedream 4.5 et Hunyuan Image 2.1, sans GPU requis.
Où se situe Z-Image en 2027
Accueil de la communauté
La sortie a suscité une activité importante sur Hugging Face dès la première semaine, le dépôt du modèle accumulant des dizaines de milliers de téléchargements et les membres de la communauté partageant rapidement des comparaisons de résultats. L’accueil a été globalement positif, en particulier chez les utilisateurs centrés sur les usages de photographie de portrait et de style de vie.
Plusieurs benchmarks communautaires ont placé Z-Image parmi les meilleurs modèles open source en matière de photoréalisme, même si les différents cadres d’évaluation produisent des classements légèrement différents. Des benchmarks comme la FID (Frechet Inception Distance), les scores d’alignement CLIP et les études de préférence humaine ne racontent pas la même histoire sur la qualité des modèles, et les performances de Z-Image varient selon les métriques. Il obtient de très bons résultats dans les évaluations de préférence humaine pour les images de portrait et les scènes en extérieur.
La communauté du fine-tuning a déjà produit plusieurs centaines d’adaptateurs LoRA couvrant des styles esthétiques allant des simulations de grain de film aux spécialisations en photographie d’architecture.
Et ensuite pour les modèles ouverts
Z-Image s’inscrit dans une tendance plus large : l’écart de qualité entre les modèles d’images open source et propriétaires se réduit à chaque trimestre. Là où DALL-E 3 avait autrefois une avance visible et significative sur tout ce qui était disponible gratuitement, des modèles comme Z-Image, Flux 2 Klein 9B et Stable Diffusion 3 ont nettement réduit cet écart.
Points à surveiller dans les mois à venir :
- Variantes distillées : des versions plus rapides et à moins d’étapes, qui sacrifient une partie de la qualité pour des gains de vitesse d’inférence de 2x à 4x
- Extension vidéo : le potentiel d’extension temporelle de l’architecture pour générer de courts clips à partir de prompts statiques
- Conditionnement multimodal : capacités image vers image améliorées, s’appuyant sur la prise en charge existante des images de référence
- Équivalents de ControlNet : adaptateurs de conditionnement par pose, profondeur et contours qui étendent la contrôlabilité de Z-Image
Rédiger des prompts pour Z-Image
Pour obtenir les meilleurs résultats avec n’importe quel modèle de diffusion, il faut comprendre la façon dont il interprète le langage. Z-Image répond bien aux prompts structurés et précis qui définissent dans l’ordre le sujet, l’environnement, l’éclairage et les caractéristiques de la caméra.
Ce qui fonctionne :
- Descriptions d’éclairage précises (« lumière matinale volumétrique venant de la gauche », « lumière diffuse et douce de ciel couvert »)
- Références d’objectifs (« 85 mm f/1.4 », « grand angle 35 mm », « macro 100 mm »)
- Précisions sur les matières et les textures (« grain de film Kodak Portra 400 », « pores visibles sur la peau »)
- Cadrage (« contre-plongée vers le haut », « vue aérienne en plongée », « gros plan serré »)
Ce qu’il faut éviter :
- Descripteurs esthétiques vagues sans fondement technique (« beau », « époustouflant », « incroyable »)
- Signaux de style contradictoires dans un même prompt
- Surcharger un prompt avec trop de sujets ou d’environnements
L’entraînement en flow matching rend Z-Image plus robuste à la complexité des prompts que les anciens modèles DDPM, mais la précision produit toujours de meilleurs résultats que l’ambiguïté.
Essayer Picasso IA dès maintenant
Le paysage de la génération d’images IA open source n’a jamais été aussi performant, et Z-Image constitue un véritable ajout parmi les meilleurs modèles de génération accessibles gratuitement. Son architecture transformer, son entraînement en flow matching et ses solides résultats aux benchmarks de photoréalisme le placent en concurrence directe avec des modèles payants.
Que vous soyez développeur d’applications, créateur de contenu visuel ou chercheur qui teste les limites du fine-tuning de modèles ouverts, Z-Image mérite sa place dans votre boîte à outils.
Si vous voulez commencer à générer des images photoréalistes immédiatement, sans configurer d’environnement local ni gérer de ressources GPU, Picasso IA vous donne accès à plus de 90 modèles de texte vers image au même endroit. Essayez Flux Kontext Dev pour l’édition d’images tenant compte du contexte, Seedream 4.5 pour des sorties 4K saisissantes, ou Imagen 4 Ultra pour un maximum de détails et de fidélité. La qualité est là. La seule variable, c’est ce que vous choisissez de créer.