La vidéo IA est devenue vraiment impressionnante. Des modèles comme Veo 3, Kling v3 et Seedance 2.5 peuvent produire des clips qui arrêtent les gens en plein défilement. Mais un écart subsiste. Vous le repérez sans doute dès que vous le voyez : le mouvement est un peu trop lisse, la peau capte la lumière comme de la cire, une feuille reste parfaitement immobile dans un vent censé souffler, ou une personne marche avec une physique qui paraît légèrement décalée. Ces indices ne viennent pas de modèles médiocres, mais du fait que la plupart des gens génèrent la vidéo de la mauvaise façon.
Bonne nouvelle : corriger cela ne demande ni de changer de modèle ni de dépenser davantage. Il faut revoir la manière d’aborder la génération elle-même. Ces 6 méthodes s’attaquent aux causes profondes de la vidéo IA à l’aspect artificiel, et elles s’appliquent que vous utilisiez le texte vers vidéo, l’image vers vidéo ou une combinaison des deux.
Pourquoi la plupart des vidéos IA ont encore l’air fausses
Avant d’entrer dans les solutions, il est utile de nommer précisément le problème. La vidéo IA échoue au test du réalisme dans trois grandes catégories :
- Artefacts de mouvement : des objets bougent d’une manière qui viole la physique. Les cheveux ondulent de façon uniforme. L’eau forme des ondulations répétitives. Les foules bougent à l’unisson.
- Incohérence des surfaces : la peau, les tissus et les textures des matières changent d’une image à l’autre. Un pull change légèrement de couleur. Un visage perd une ride au milieu du clip.
- Immobilité de l’environnement : les éléments d’arrière-plan sont figés alors que les éléments du premier plan bougent. Les environnements réels ont un mouvement constant et superposé à chaque profondeur.
Ces trois problèmes peuvent tous être résolus par la construction du prompt, le choix du modèle et le post-traitement. Voici comment faire.
Méthode 1 : utiliser l’image vers vidéo, pas le texte vers vidéo
C’est le plus gros gain de réalisme que la plupart des créateurs peuvent obtenir, et il ne demande aucune compétence supplémentaire. Les modèles de texte vers vidéo doivent tout inventer à partir de rien. Les modèles d’image vers vidéo partent d’une image fixe et photoréaliste et l’animent à partir de là. L’image de base ancre toute la physique, l’éclairage et les proportions.
Votre image de base est la fondation
Lorsque vous fournissez une image nette et photoréaliste comme première image, le modèle dispose d’une référence précise sur la façon dont la lumière interagit avec les surfaces, sur les proportions du sujet et sur l’endroit où tombent les ombres. Cela réduit fortement la liberté du modèle pour inventer des incohérences.
Les meilleurs modèles d’image vers vidéo disponibles actuellement comprennent :
Ce qui fait une bonne image source
Toutes les images photoréalistes ne font pas une bonne base. Les meilleures images sources ont :
- Une profondeur claire : des couches de premier plan, de plan intermédiaire et d’arrière-plan bien distinctes. Les modèles animent la profondeur séparément, donc des couches définies réduisent la contamination croisée.
- Un éclairage naturel et directionnel : un éclairage latéral ou de contour crée des dégradés d’ombre qui ancrent le mouvement de façon réaliste. Un éclairage frontal et plat supprime les indices de profondeur.
- Du détail de texture : une texture fine dans le tissu, la peau ou les surfaces donne au modèle quelque chose de réel sur quoi travailler. Les images lisses et sans texture tendent à produire une animation cireuse.
💡 Générez d’abord votre image de base avec un modèle de texte vers image haute résolution, puis transmettez-la à votre modèle d’image vers vidéo. Cette approche en deux étapes surpasse systématiquement la génération directe de texte vers vidéo en matière de réalisme.
Méthode 2 : des prompts qui décrivent la physique
L’erreur la plus courante dans le prompting vidéo IA consiste à décrire à quoi les choses ressemblent au lieu de décrire comment elles se comportent. Les prompts d’apparence fonctionnent bien pour la génération d’images. Pour la vidéo, il faut de la physique et du mouvement.
Décrivez le comportement, pas seulement l’apparence
Comparez ces deux prompts :
Faible : « Une femme marchant dans une forêt en automne »
Fort : « Une femme en manteau marron marchant lentement dans une forêt, des feuilles sèches se soulevant légèrement du sentier à chaque pas, le tissu de son manteau ondulant au rythme du balancement de son bras, une lumière matinale filtrant à travers la canopée et créant des taches lumineuses mouvantes sur le sol devant elle, la caméra suivant à allure de marche lente à trois mètres derrière elle »
Le second prompt décrit ce qui bouge, ce qui provoque ce mouvement et ce que fait la caméra. Chaque détail donne au modèle une contrainte physique à respecter.
Les briques de prompt physique
Utilisez ces catégories pour construire des prompts riches en mouvement :
- Comportement du sujet : « marche avec une légère hésitation », « expire un souffle visible dans l’air froid », « les doigts serrent la tasse avec une légère tension »
- Réaction de l’environnement : « l’herbe plie légèrement sous le vent », « la flamme de la bougie vacille avec le courant d’air », « la surface de la flaque est troublée à chaque pas »
- Couches atmosphériques : « particules de poussière en suspension et dérivant lentement », « brouillard roulant à hauteur de chevilles », « faisceaux de lumière traversant les feuilles »
- Comportement de la caméra : « travelling lent vers l’avant », « dérive légère à l’épaule », « plan fixe verrouillé avec seul le mouvement de l’environnement »
💡 La précision se cumule. Décrire trois systèmes de mouvement distincts dans une même scène (sujet, environnement, atmosphère) est ce qui produit le mouvement superposé qui donne l’impression d’une prise de vue réelle.
Méthode 3 : contrôler les mouvements de caméra délibérément
La vidéo IA à l’aspect artificiel présente souvent l’un de deux problèmes de caméra : la caméra est complètement figée pendant que tout le reste bouge, ou elle bouge d’une façon qu’aucun opérateur de prise de vue réel ne choisirait. Les deux sont faciles à corriger.
Le mouvement lent et motivé gagne toujours
Les opérateurs de prise de vue réels déplacent les caméras pour une raison : suivre un sujet, révéler un nouvel espace ou créer une charge émotionnelle. La vidéo IA paraît le plus réaliste lorsque le prompt décrit le mouvement de caméra avec la même intention.
Les mouvements de caméra réalistes les plus fiables :
- Travelling avant lent : la caméra avance de 2 à 3 mètres sur toute la durée du clip. Crée de l’intimité sans paraître mécanique.
- Panoramique doux suivant un sujet : la caméra suit une personne ou un objet latéralement, en le gardant dans le cadre. Ajoute de la vie sans distraire.
- Plan fixe verrouillé : aucun mouvement de caméra. Souvent le choix le plus réaliste, car il force le modèle à concentrer toute son énergie sur le mouvement dans la scène.
- Légère dérive à l’épaule : mouvement subtil et irrégulier qui imite une caméra portée à l’épaule. À utiliser avec parcimonie.
💡 Le modèle Kling v3 Motion Control accepte spécifiquement des instructions de trajectoire de caméra. Si un contrôle précis de la caméra compte pour votre projet, c’est par là qu’il faut commencer.
À éviter
- Les panoramiques ou zooms rapides. Ce sont les artefacts les plus fréquents de la vidéo IA.
- Demander un mouvement de caméra sans préciser sa vitesse. « Un panoramique » est vague. « Un panoramique lent vers la gauche sur cinq secondes » est précis.
- Demander plusieurs mouvements de caméra dans un seul clip court. Choisissez-en un.
Méthode 4 : la précision de l’éclairage change tout
L’éclairage est ce qui fait croire au cerveau qu’une scène est réelle. Lorsque l’éclairage est vague dans un prompt, le modèle se rabat sur une lumière diffuse et uniforme qui ressemble à un éclairage de studio sans source. Les environnements réels ont une lumière directionnelle, avec des températures de couleur définies, des bords durs ou doux, et un comportement dynamique.
Précisez la source, la direction et la qualité
Un prompt d’éclairage réaliste répond à trois questions :
- D’où vient la lumière ? (fenêtre, soleil à 30 degrés au-dessus de l’horizon, néon au plafond, bougie sur la table)
- Dans quelle direction frappe-t-elle le sujet ? (depuis la gauche, contre-jour en contour depuis l’arrière, éclairage par le bas depuis le hors-champ)
- Quelle est sa qualité ? (douce et diffuse, dure avec des ombres nettes, vacillante, chaude et dorée, froide et bleutée)
Vague : « bel éclairage »
Précis : « lumière dorée de l’heure dorée venant de la droite de la caméra, projetant de longues ombres vers la gauche, température de couleur chaude de 3200 K, léger reflet de lentille dans le coin supérieur droit »
L’interaction de la lumière avec les surfaces
Les clips de vidéo IA les plus réalistes montrent une lumière qui se comporte correctement sur différents types de surfaces :
- Peau : la diffusion sous la surface crée une légère translucidité sur le bord des oreilles et des doigts en contre-jour
- Tissu : il crée des motifs distincts de reflets et d’ombres qui se déplacent avec le mouvement
- Eau : elle réfléchit et réfracte la lumière de façons qui changent constamment
Lorsque vous décrivez explicitement ces interactions, le modèle produit une matière bien plus convaincante. « La lumière du soleil traversant ses cheveux crée une translucidité chaude sous la surface sur les bords » donne un résultat fondamentalement différent de « éclairée à contre-jour par le soleil ».
Trois conditions d’éclairage qui paraissent toujours réelles
- Heure dorée : chaude, directionnelle, avec de longues ombres. Convient à presque toutes les scènes en extérieur.
- Lumière de jour couverte : uniforme, douce, sans ombres dures. Extrêmement flatteuse pour la peau et produit une couleur naturelle sans que le modèle invente de la saturation.
- Source pratique unique : plan d’intérieur éclairé par une seule lampe, une cheminée ou une fenêtre. Oblige le modèle à s’en tenir à une seule logique d’éclairage, ce qui crée de la cohérence.
Méthode 5 : augmenter la résolution avant de partager
Les sorties brutes de vidéo IA sont souvent générées en 480p ou en 720p, même lorsque le modèle annonce des résolutions plus élevées. Plus important encore, la compression de la vidéo IA introduit des artefacts subtils au niveau des pixels, moins visibles aux résolutions élevées. Augmenter la résolution de la vidéo avant de la partager est l’un des moyens les plus fiables de réduire l’écart entre contenu IA et contenu filmé.
Pourquoi la résolution masque les artefacts
Le cerveau traite la vidéo de manière globale. Les artefacts individuels, les incohérences de texture et les saccades de mouvement sont beaucoup moins visibles lorsqu’ils occupent moins de pixels dans le champ de vision du spectateur. Une version en 4K d’un clip vidéo IA qui paraîtrait manifestement artificielle en 720p passe souvent pour réelle, car l’œil ne peut pas suivre les pixels d’artefacts individuels en pleine résolution.
Deux outils qui fonctionnent
Video Upscale by Topaz Labs est la référence du secteur pour l’augmentation de la résolution de vidéos IA. Il ne se contente pas d’augmenter la résolution. Il utilise un réseau de neurones entraîné sur des séquences réelles pour reconstruire les détails que la génération originale a manqués. La texture de la peau gagne en netteté. Les détails fins des bords des vêtements deviennent nets. La sortie en 4K et 120 fps convainc régulièrement les spectateurs qui avaient rejeté le même clip en 720p.
Upscale v1 by Runway est une alternative plus rapide qui offre de bons résultats en 4K avec un temps de traitement réduit. Les deux sont disponibles directement sur PicassoIA, vous pouvez donc générer et augmenter la résolution dans le même flux de travail sans changer de plateforme.
💡 Augmentez toujours la résolution avant d’appliquer un étalonnage des couleurs ou des effets. Une augmentation de résolution après un travail sur les couleurs peut introduire des bandes et des artefacts de compression qui annulent les gains de réalisme.
Méthode 6 : ajouter un son natif pour renforcer l’illusion
Le son est l’élément le plus sous-estimé du réalisme de la vidéo IA. Le cerveau utilise l’audio comme référence constante de ce qu’il voit. Lorsque vous regardez une scène où les pas tombent en silence, où le vent ambiant est absent ou où une foule n’a aucun bruit de fond, votre cerveau signale immédiatement une anomalie, même si les images sont excellentes.
Le son amène le cerveau à accepter les images
La recherche en psychoacoustique montre de façon constante que la qualité perçue d’une vidéo augmente lorsque l’audio correspond au contenu visuel. Un clip vidéo légèrement imparfait accompagné d’un son précis et de haute qualité paraît plus authentique qu’un clip visuellement soigné sans son ou avec un son mal assorti.
C’est pourquoi les modèles vidéo qui génèrent un son natif, adapté à la scène, produisent systématiquement des clips que les spectateurs jugent plus réalistes, même lorsque le contenu visuel est comparable à celui des modèles sans audio.
Modèles à génération audio intégrée
Plusieurs modèles génèrent désormais l’audio nativement avec la vidéo. Voici les plus performants :
| Modèle | Type d’audio | Point fort notable |
|---|
| Veo 3 | Entièrement natif | Meilleure combinaison ambiance et dialogue |
| Veo 3.1 | Entièrement natif | 1080p avec audio synchronisé |
| Seedance 2.0 | Audio intégré | Son environnemental naturel |
| Hailuo 2.3 | Audio natif | Compositions cinématographiques |
| Grok Imagine Video 1.5 | Avec audio | Grande cohérence |
Lorsque vous utilisez des modèles sans audio natif, décrivez quand même l’environnement sonore souhaité dans votre prompt. Beaucoup de modèles récents utilisent ces descriptions pour influencer la représentation visuelle des éléments qui produisent du son, un drapeau dans le vent, une eau qui s’écrase, un feu qui crépite, ce qui donne à la scène une dimension plus auditive, même avant l’ajout du son.
PicassoIA vous donne accès à plus de 87 modèles de texte vers vidéo et d’image vers vidéo dans une seule interface, sans abonnements séparés.
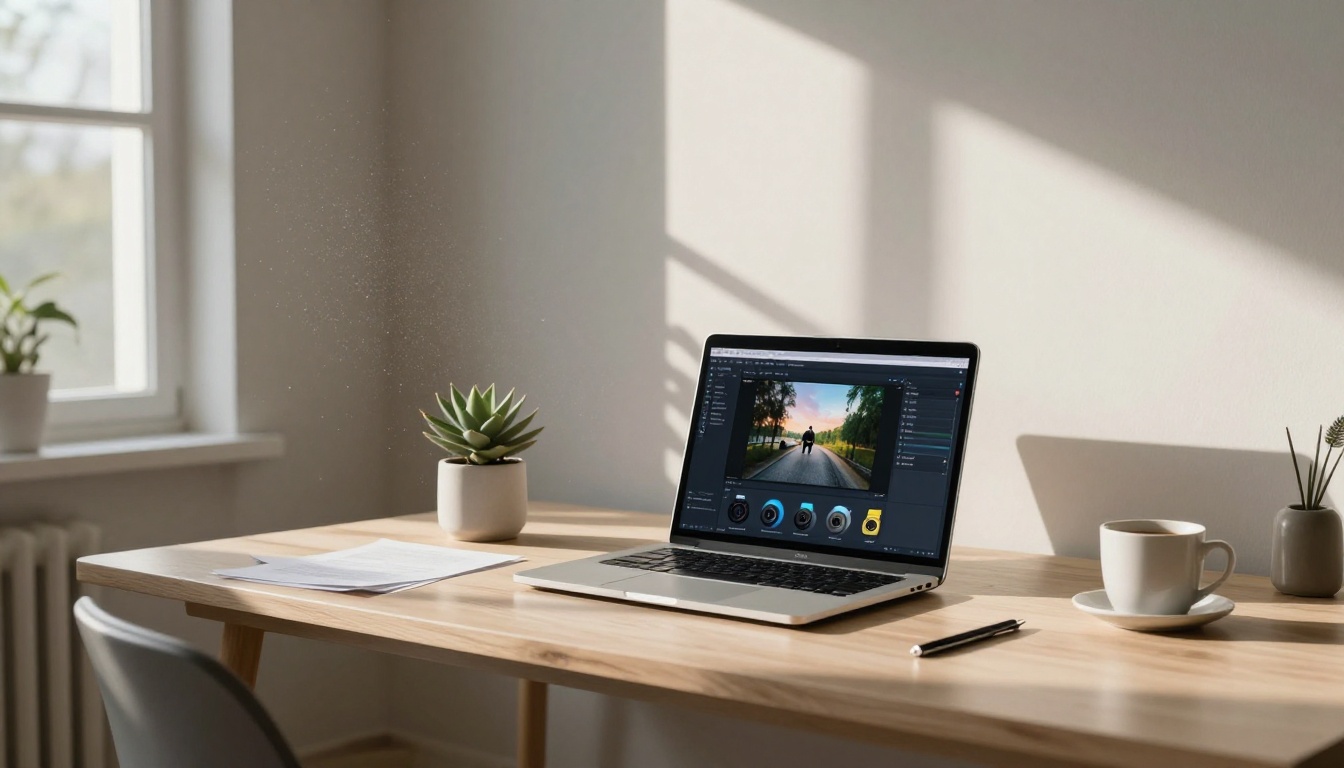
Le flux de travail recommandé
Étape 1 : générez votre image de base. Utilisez la section texte vers image pour créer une scène photoréaliste avec l’éclairage et la composition souhaités. Elle deviendra votre première image.
Étape 2 : choisissez votre modèle vidéo. Pour un réalisme maximal, commencez par Kling v3 Video, Wan 2.7 I2V ou LTX 2.3 Pro pour votre premier essai. Chacun gère mieux certains types de scènes :
Étape 3 : appliquez l’upscaling. Passez la sortie dans Video Upscale by Topaz pour affiner les détails fins et relever le seuil minimal de qualité visuelle.
Étape 4 : comparez et itérez. Générez deux versions avec des descriptions de mouvement de caméra ou des spécifications d’éclairage différentes. La différence entre un plan fixe et un travelling avant lent sur la même scène détermine souvent si le clip paraît réel.
Les réglages qui comptent le plus
Lorsque vous soumettez une génération sur PicassoIA :
- Résolution : visez toujours 720p au minimum. Utilisez le 1080p lorsque la plateforme le prend en charge pour le modèle choisi.
- Durée : les clips courts (5 secondes) sont plus cohérents que les longs. Pour les scènes complexes, générez des segments de 5 secondes et assemblez-les.
- Longueur du prompt : pour la vidéo, plus long est mieux que pour les images. Utilisez 100 à 150 mots de description de mouvement. Incluez le comportement du sujet, la réaction de l’environnement, le mouvement de caméra et l’éclairage dans chaque prompt.
💡 Sauvegardez vos meilleurs prompts. Une fois que vous avez trouvé une formule combinant éclairage, caméra et mouvement qui produit des résultats systématiquement réalistes, réutilisez cette structure pour différents sujets et scènes.
Passez à la pratique
L’écart entre la vidéo IA et les séquences réelles se réduit plus vite que ce que la plupart des gens imaginent. Des modèles comme Veo 3.1 et LTX 2.3 Pro produisent des résultats qui semblaient impossibles il y a deux ans. Mais le plafond de qualité n’est atteint que lorsque le prompting et le flux de travail correspondent aux capacités du modèle.
Les six méthodes ci-dessus, utilisées ensemble, sont ce qui distingue les créateurs qui génèrent de la vidéo IA de ceux qui la produisent avec intention. Des images de base photoréalistes, des prompts fondés sur la physique, des mouvements de caméra délibérés, un éclairage précis, l’augmentation de la résolution et le son natif ne sont pas des astuces séparées. Ce sont un système en couches où chaque élément renforce les autres.
PicassoIA réunit au même endroit chaque modèle cité dans cet article, sans comptes ni abonnements séparés. Que vous créiez une démo de produit, un court métrage ou du contenu pour les réseaux sociaux, le flux de travail part d’une seule image et du bon prompt. Commencez par là, appliquez l’une de ces six méthodes et générez dès maintenant votre premier clip sur picassoia.com/en/all-models.


