Le phénomène a discrètement changé en 2024. Ce qui n’était au départ que des chatbots accompagnés de photos de profil anime statiques est devenu quelque chose avec lequel les gens ont vraiment envie de passer du temps : des compagnons IA qui discutent avec une personnalité, parlent avec de vraies voix et ressemblent à des personnages sortis tout droit d’une série anime haut de gamme. Si vous suivez ce domaine, vous savez déjà que l’écart entre ce qui était possible il y a deux ans et ce que vous pouvez créer aujourd’hui est vertigineux.
Cet article explique précisément comment fonctionnent ces compagnons à travers trois couches, quels modèles d’IA alimentent chacune d’elles, et comment vous pouvez créer le vôtre sur PicassoIA dès aujourd’hui.
Ce qui fait réellement fonctionner un compagnon IA à l’allure anime
Trois couches, une seule expérience
Un compagnon IA à l’allure anime n’est pas une technologie unique. Ce sont trois systèmes d’IA distincts qui travaillent ensemble si harmonieusement que la jointure entre eux disparaît :
- La couche conversationnelle gère la personnalité, la mémoire et le dialogue naturel. C’est là que vivent les grands modèles de langage.
- La couche vocale convertit les réponses textuelles du compagnon en une parole expressive qui correspond au ton émotionnel du personnage.
- La couche visuelle génère et maintient l’apparence du compagnon, du portrait statique aux expressions animées.
Si vous réussissez les trois, le résultat paraît véritablement vivant. Si vous en ratez une seule, l’illusion s’effondre.
Pourquoi l’esthétique anime a un effet si particulier
Le design des personnages anime obéit à une grammaire visuelle spécifique que des millions de personnes reconnaissent instantanément : de grands yeux expressifs, des cheveux aux couleurs précisément codées, des traits nets qui communiquent la personnalité d’un seul coup d’œil. Ces traits ne sont pas arbitraires. Ils résultent d’un siècle d’affinage itératif du design, visant un seul objectif : rendre un personnage lisible et émotionnellement parlant le plus vite possible.
C’est exactement ce que vous recherchez dans un compagnon. Un personnage qui paraît immédiatement chaleureux, curieux ou fougueux n’a pas besoin de paragraphes de backstory. L’image fait la moitié du travail.
La couche conversationnelle : des LLM qui donnent vie aux personnages
La couche conversationnelle est l’épine dorsale de tout compagnon IA à l’allure anime. Sans elle, vous n’avez qu’une jolie image qui ne dit rien. La qualité du grand modèle de langage que vous choisissez détermine si le compagnon donne l’impression d’une personne ou d’un distributeur automatique.
Des modèles conçus pour la personnalité
Tous les grands modèles de langage ne gèrent pas le jeu de rôle de personnages avec la même aisance. Certains ont été ajustés par instructions d’une manière qui les rend rigides lorsque vous tentez d’établir une persona durable. D’autres s’en sortent avec une fluidité surprenante. Voici où se situent les meilleurs modèles de PicassoIA en ce moment :
| Modèle | Idéal pour | Souplesse de personnalité |
|---|
| GPT 5 | Conversations longues, arrière-plan nuancé | Élevée |
| Claude Sonnet 5 | Voix de personnage cohérente, écriture créative | Très élevée |
| Gemini 3.5 Flash | Réponses rapides, prise en compte du contexte visuel | Élevée |
| Kimi K2.6 | Tâches d’agent au sein d’une conversation | Moyenne à élevée |
| Deepseek R1 | Raisonnement sur des scénarios émotionnels complexes | Élevée |
💡 Astuce : Pour les applications de compagnon, les prompts système sont tout. Un descriptif de personnage de 300 mots fourni à Claude Sonnet 5 donnera une persona plus cohérente qu’un descriptif de 10 mots, quel que soit le modèle.
GPT 5 ou Claude Sonnet 5 pour la conversation de compagnon
La question revient constamment, réglons-la directement. GPT 5 a un léger avantage pour les compagnons qui doivent faire référence à des connaissances du monde réel en cours de conversation. Claude Sonnet 5 a tendance à mieux rester dans le personnage au fil des sessions longues. Aucun des deux n’est définitivement meilleur ; ils conviennent à des personnalités de compagnon différentes.
Pour un compagnon anime studieux et intellectuel : GPT 5. Pour un compagnon émotionnellement attentif et chaleureux : Claude Sonnet 5. Pour quelque chose qui doit réagir aux images que vous partagez dans le chat : Gemini 3.5 Flash gère nativement les entrées multimodales.
Options open source à considérer
Si vous construisez une application de compagnon privée et que la souveraineté de vos données compte pour vous, Llama 4 Maverick Instruct de Meta est le modèle à poids ouverts le plus performant pour ce cas d’usage. Deepseek v3.1 est un autre choix solide, notamment pour les utilisateurs qui veulent un modèle entraîné sur des données culturellement proches.
Les deux sont disponibles sur PicassoIA, ce qui signifie que vous n’avez pas besoin de les héberger vous-même pour les tester dans votre flux de travail.
La couche vocale : une synthèse vocale qui sonne comme de l’anime
La voix change tout. La même réponse textuelle, qui paraît chaleureuse et affectueuse dans un chat classique, devient profondément personnelle lorsqu’elle est délivrée avec une voix dotée du rythme, de la hauteur et de la texture émotionnelle appropriés. C’est là que l’expérience passe de « c’est cool » à « j’ai envie de revenir ».
ElevenLabs v3 pour des voix expressives
ElevenLabs v3 est actuellement le meilleur modèle disponible pour une synthèse vocale expressive et à forte variation émotionnelle. Il sait gérer les changements de rythme, les soupirs légers, les pics d’enthousiasme et les hésitations d’une manière que les modèles moins chers ne maîtrisent pas. Pour un compagnon dont l’expressivité émotionnelle fait partie du design du personnage, c’est le point de départ approprié.
La fonctionnalité de clonage vocal est particulièrement utile ici : vous pouvez cloner un profil vocal précis et l’utiliser de manière constante dans toute la parole du compagnon, ce qui crée une forte identité de personnage uniquement par le son.
Speech 2.8 HD pour une qualité de studio
Lorsque vous voulez un audio qui semble appartenir à une production anime, Speech 2.8 HD de MiniMax est le modèle à privilégier. La variante HD sacrifie la faible latence de la version turbo au profit d’une fidélité nettement supérieure. Il gère naturellement les emprunts au japonais et les onomatopées, ce qui compte beaucoup lorsque votre compagnon parle dans un style qui mêle l’anglais et des expressions japonaises.
Speech 2.8 Turbo est le meilleur choix si vous construisez une boucle de conversation en temps réel où une latence de réponse supérieure à 300 ms casse le rythme.
Voix en temps réel pour les conversations en direct
Deux modèles se distinguent pour une synthèse vocale quasi instantanée :
- Realtime TTS 2 d’Inworld : conçu spécifiquement pour les applications de personnages IA, avec une latence inférieure à 100 ms.
- Flash v2.5 d’ElevenLabs : ultra-rapide, prise en charge de 32 langues, idéal pour les compagnons qui passent de l’anglais au japonais en cours de conversation.
💡 Astuce d’architecture : Utilisez un modèle rapide comme Flash v2.5 pour les réponses parlées en temps réel, et envoyez les réponses explicatives plus longues du compagnon par Speech 2.8 HD pour une lecture audio de meilleure qualité.
Pour le clonage vocal et la création d’une voix signature pour votre personnage, Chatterbox Pro de Resemble AI reste l’un des modèles les plus contrôlables disponibles. Ses paramètres de contrôle émotionnel vous permettent de régler précisément où, entre le joyeux et le mélancolique, une réplique doit se situer.
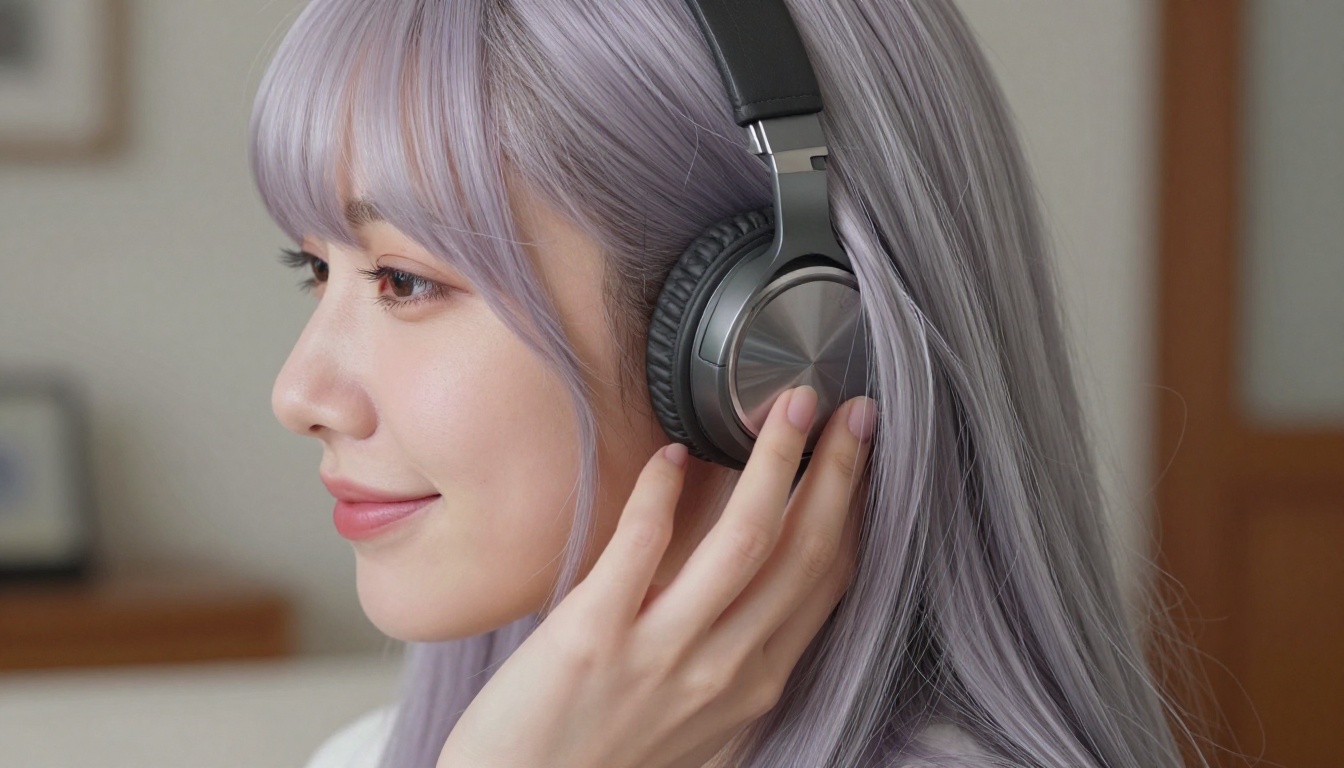
C’est la couche sur laquelle la plupart des gens se concentrent en premier, et c’est aussi là que les plus grands progrès ont eu lieu. Il fallait autrefois des heures d’itérations de prompts pour générer un seul portrait statique à l’esthétique anime. Aujourd’hui, vous pouvez produire un personnage photoréaliste aux traits esthétiques cohérents en une seule génération.
Ce qui crée une esthétique anime dans les images générées par IA
Le terme « esthétique anime » est souvent mal compris comme signifiant « dessiné ». Les compagnons IA les plus convaincants ne ressemblent pas à des captures d’écran d’une série anime. Ils ressemblent à une vraie personne qui possède les traits visuels associés au design de personnages anime : de grands yeux lumineux, des textures de cheveux spécifiques, une peau nette, une couleur de cheveux vive. L’image se lit toujours comme la photographie d’une vraie personne.
Cette distinction compte pour l’immersion. Un personnage clairement illustré vous garde à distance. Une personne photoréaliste aux traits de style anime invite à une véritable connexion émotionnelle.
Les modèles d’image sur PicassoIA
La collection texte vers image de PicassoIA comprend plus de 90 modèles capables de générer des portraits à l’esthétique anime. Les outils de génération de la plateforme gèrent particulièrement bien le style photoréaliste proche de l’anime, en produisant des images dotées de l’éclairage naturel et du grain de pellicule qui distinguent un travail de portrait professionnel d’un rendu d’IA plat.
Paramètres de génération importants pour les portraits de compagnons anime :
- Format : 16:9 pour le contexte de scène ; 1:1 ou 9:16 pour les plans centrés sur le portrait
- Émulation d’objectif : 85 mm f/1.4 pour la légère compression et le bokeh qui flattent les visages
- Direction de l’éclairage : Précisez si la lumière vient de la gauche, de la droite ou du dessus. Les images éclairées de face perdent en profondeur.
- Type de pellicule : Kodak Portra 400 dans les prompts produit de manière fiable des tons chauds et flatteurs pour la peau
Des portraits aux scènes
Un seul portrait établit une identité. Une série d’images placées dans différents environnements construit un univers. Lorsque vous générez des visuels de compagnon, pensez en termes de scénarios plutôt que de photos de tête :
- Matin : chambre, lumière du soleil, vêtements décontractés
- Soir : café, lampes chaudes, expression détendue
- Extérieur : rue, ville, langage corporel animé
- Concentration : bureau, étude, posture de réflexion
Chaque scénario ajoute une facette à la personnalité perçue du personnage, sans qu’il soit nécessaire d’écrire un seul mot.
Vous n’avez pas besoin d’intégrer trois API distinctes. PicassoIA héberge les trois couches au même endroit.
Étape 1 : générer l’identité visuelle du personnage
Commencez dans la collection texte vers image de PicassoIA. Rédigez un prompt qui établit les traits visuels essentiels du personnage : couleur et longueur des cheveux, couleur des yeux, style vestimentaire, l’émotion que vous voulez que l’expression par défaut transmette. Générez 4 à 6 variations et sélectionnez celle qui paraît la plus proche du personnage que vous avez en tête.
💡 Conseil de cohérence : Enregistrez le numéro de seed de votre génération préférée. En faisant varier cette seed avec de petites modifications du prompt, vous obtenez des images apparentées qui semblent représenter la même personne dans des scènes différentes.
Étape 2 : rédiger le prompt système du personnage
Le prompt système du LLM est l’endroit où vit la personnalité du compagnon. Un prompt bien construit couvre :
- Nom et arrière-plan : qui elle est et d’où elle vient
- Schémas de langage : formel ou familier, usage des honorifiques japonais, tics verbaux
- Réactions émotionnelles par défaut : est-elle chaleureuse et ouverte, ou réservée et sèche ?
- Connaissances et centres d’intérêt : de quoi parle-t-elle avec assurance et sur quoi s’en remet-elle ?
- Dynamique relationnelle : comment elle se rapporte à l’utilisateur en particulier
Donnez ce texte à GPT 5 ou Claude Sonnet 5 et testez avec 10 à 15 messages ouverts avant de le finaliser.
Étape 3 : sélectionner et configurer la voix
Rendez-vous dans la collection synthèse vocale et auditionnez des voix sur un extrait des réponses textuelles du compagnon. La bonne voix paraîtra immédiatement juste pour le design visuel du personnage. Un décalage entre l’apparence d’un compagnon et sa personnalité vocale brise l’immersion plus vite que presque tout le reste.
Pour un compagnon plutôt chaleureux et doux, ElevenLabs v3 avec un profil vocal léger fonctionne bien. Pour quelque chose de plus énergique, Qwen3 TTS gère la parole rapide sans distorsion.
Qui utilise réellement les compagnons IA à l’allure anime
Le public réel
L’idée reçue veut que les compagnons IA à l’allure anime servent uniquement à lutter contre l’isolement social. Le public réel est plus large et plus varié :
- Apprenants de langues : pratique de conversation immersive en japonais avec un compagnon qui corrige avec tact et ajuste le vocabulaire au niveau de l’apprenant
- Auteurs et créateurs d’univers : utilisation des compagnons comme outils interactifs de développement de personnages, pour tester des backstories et des dialogues en conversation réelle
- Personnes qui travaillent leur anxiété sociale : environnement de pratique à faible enjeu pour les compétences conversationnelles avant de les appliquer dans la vraie vie
- Divertissement : plaisir simple d’une expérience narrative interactive avec un personnage dont elles ont contribué à façonner la personnalité
💡 Aucun de ces usages n’exige que le compagnon remplace les relations humaines. Ils sont complémentaires, et non substitutifs.
Applications de compagnon ou créations sur mesure
Plusieurs applications de compagnon soignées existent sur le marché, avec des personnages anime préconçus. L’avantage de créer sur PicassoIA à la place :
| Applications préconçues | Création sur mesure avec PicassoIA |
|---|
| Contrôle du personnage | Préréglages limités | Liberté de conception totale |
| Qualité des modèles | Souvent des modèles plus anciens | Modèles actuels de premier plan |
| Personnalisation de la voix | Voix fixe ou variations mineures | Conception vocale complète |
| Confidentialité | Variable selon le fournisseur | Vos données, votre création |
| Coût | Abonnement | Paiement à l’usage |
Les applications préconçues ont du sens pour une expérimentation occasionnelle. Si vous voulez un compagnon qui soit vraiment le vôtre, l’approche sur mesure l’emporte en matière de tout ce qui compte.
Ce qui est réellement possible aujourd’hui
De vraies conversations avec mémoire
Les LLM modernes peuvent maintenir le contexte sur de très longues conversations. GPT 5 Pro avec sa fenêtre de contexte étendue, et Kimi K2.6, conçu pour la mémoire à longue portée, gèrent tous deux la continuité sur plusieurs sessions mieux que les modèles d’il y a déjà 18 mois. Le compagnon peut se souvenir de ce que vous lui avez confié lors de la première session lorsque vous revenez à la vingtième.
Une voix qui réagit au contexte émotionnel
Les meilleurs modèles de synthèse vocale savent désormais repérer les indices émotionnels du texte qu’on leur fournit. Donnez à Chatterbox Pro une réplique qui paraît enthousiaste, et il accélérera le rythme et relèvera légèrement la hauteur, sans instruction explicite. Donnez-lui une réplique triste, et il s’adoucit. Ce n’est pas de la magie ; c’est ce à quoi ressemble une bonne synthèse vocale émotionnelle en 2027.
Cohérence visuelle d’une scène à l’autre
En utilisant les outils de génération d’images de PicassoIA avec des seeds constantes, des prompts négatifs et des descriptifs de personnage détaillés, vous pouvez générer le même personnage dans des dizaines d’environnements différents tout en conservant des traits reconnaissables. L’écart entre « le même personnage » et « une personne semblable au hasard » s’est nettement réduit.
Les limites qui subsistent
L’honnêteté compte ici. Plusieurs choses restent réellement difficiles :
- Mémoire entre les sessions sans stockage externe : les LLM ne se souviennent pas nativement d’une session API à l’autre. Vous devez mettre en place vous-même une couche de mémoire, généralement en résumant le contexte précédent et en le réinjectant.
- Visages parfaitement cohérents d’une génération à l’autre : aucun modèle d’image ne produit des visages cohérents à 100 % à travers des prompts très différents. Attente réaliste : une forte ressemblance familiale entre les images, et non une identité photographique.
- Voix en streaming en temps réel avec une latence nulle : une synthèse vocale inférieure à 50 ms est disponible dans certaines configurations, mais la synchronisation des mouvements des lèvres sur les avatars animés ajoute une complexité importante.
Ce sont des problèmes d’ingénierie pour lesquels des solutions sont en cours de développement, et non des obstacles qui vous empêchent de créer quelque chose de convaincant dès aujourd’hui.
Essayez par vous-même
Tout ce qui est décrit dans cet article est disponible sur PicassoIA dès maintenant. Les outils texte vers image génèrent le visuel. Les grands modèles de langage alimentent la conversation. Les modèles de synthèse vocale lui donnent une voix.
Le véritable travail créatif réside dans les choix de design : qui est ce personnage, comment sonne-t-il, qu’est-ce qui compte pour lui, comment se rapporte-t-il à vous ? Cette partie vous appartient entièrement.
Choisissez un modèle dans la collection de grands modèles de langage, trouvez une voix dans la synthèse vocale, générez le portrait du personnage dans la collection d’images et voyez jusqu’où vous pouvez aller. Les outils sont prêts quand vous l’êtes.


