Imaginez taper quelques mots et voir une image photoréaliste prendre forme sous vos yeux. Ce n’est pas de la science-fiction : c’est la réalité de la technologie de conversion texte vers image par l’IA, déjà disponible. Le processus transforme de simples descriptions textuelles en contenus visuels saisissants, avec une rapidité et une qualité inédites.
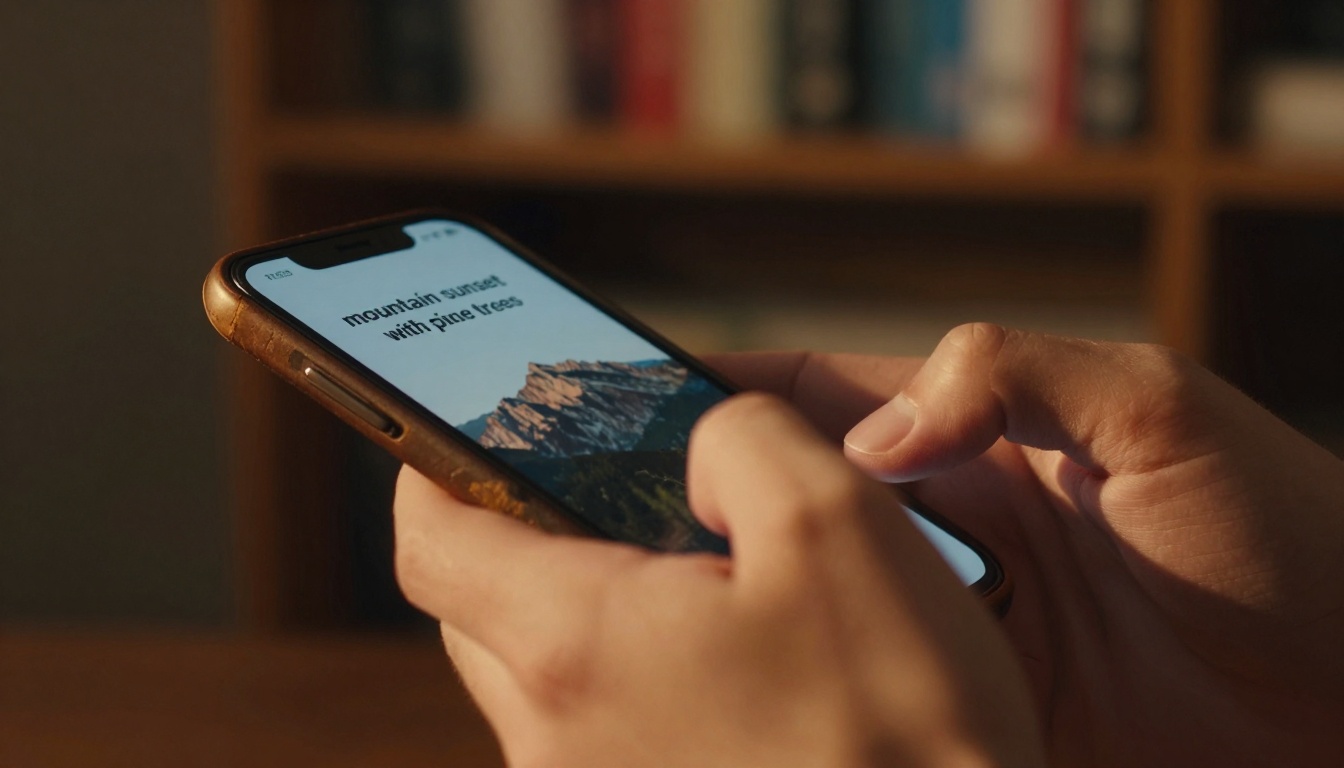
Les modèles de conversion texte vers image reposent sur un principe fondamental : ils ont appris le lien entre le langage et les concepts visuels en analysant des millions de paires image-texte. Lorsque vous tapez « coucher de soleil sur les montagnes », l’IA ne se contente pas de faire correspondre des mots-clés. Elle comprend les conditions atmosphériques, les dégradés de couleurs, les formations géologiques et les caractéristiques de lumière associées à cette expression.
La technologie repose sur des modèles de diffusion qui partent d’un bruit aléatoire et l’affinent progressivement pour obtenir une image cohérente, guidée par votre texte. Chaque mot a un poids précis : des adjectifs comme « doré » ou « brumeux » influencent les palettes de couleurs et les effets atmosphériques.
💡 Rédiger des prompts efficaces : commencez par le sujet principal, ajoutez des adjectifs descriptifs, précisez l’environnement, indiquez les conditions d’éclairage, et terminez par des modificateurs de style comme « photoréaliste » ou « qualité 8K ».
Les principaux acteurs de la génération texte vers image
Plusieurs modèles de référence dominent le marché, chacun avec des atouts propres :
| Modèle | Atout principal | Idéal pour |
|---|
| flux-2-klein-4b | Équilibre entre vitesse et qualité | Projets créatifs du quotidien |
| qwen-image-2512 | Rendu photoréaliste | Visualisation de produits |
| p-image | Temps de génération rapides | Prototypage rapide |
| gpt-image-1.5 | Compréhension des prompts complexes | Création de scènes détaillées |
| flux-2-max | Qualité de sortie maximale | Œuvres artistiques professionnelles |
Du texte au résultat visuel : les étapes de l’évolution
Le chemin qui mène des mots tapés à l’image finale comprend plusieurs phases distinctes :
- Analyse du texte : l’IA décompose votre prompt en composantes sémantiques
- Mise en correspondance des concepts : chaque mot correspond à des caractéristiques visuelles dans l’espace latent du modèle
- Génération du bruit : point de départ d’un bruit purement aléatoire
- Affinement itératif : le bruit prend progressivement des formes reconnaissables
- Amélioration des détails : ajout de textures fines et d’effets de lumière
- Rendu final : production de l’image achevée
Applications concrètes dans tous les secteurs
Marketing et publicité
- Visualisation de produits avant la production physique
- Visuels de campagne adaptés à des publics spécifiques
- Contenus pour les réseaux sociaux générés à la demande
Éducation et formation
- Reconstitutions historiques pour un apprentissage immersif
- Visualisation scientifique de concepts complexes
- Supports de formation à style visuel cohérent
Divertissement et médias
- Concept art pour films et jeux
- Storyboards avec des personnages à design cohérent
- Illustrations de couverture pour des publications
Architecture et design
- Visualisation d’intérieurs à partir de briefs descriptifs
- Scénarios d’urbanisme
- Itérations de design produit
Erreurs courantes dans la rédaction des prompts
Les descriptions vagues produisent des résultats génériques. Au lieu de « un beau paysage », essayez « coucher de soleil sur les Montagnes Rocheuses, pins au premier plan, lumière de l’heure dorée, brume dans les vallées, photoréaliste, 8K ».
Surcharger de détails peut dérouter le modèle. Concentrez-vous sur 3 à 5 éléments clés plutôt que de lister toutes les caractéristiques possibles.
Négliger les modificateurs de style fait perdre des occasions d’améliorer la qualité. Incluez toujours des termes comme « éclairage cinématographique », « photoréaliste » ou « photographie professionnelle ».
Oublier le format conduit à des compositions recadrées. Précisez le format souhaité : « paysage 16:9 » ou « carré 1:1 ».
Les caractéristiques techniques qui comptent
Résolution et qualité
Les modèles récents comme stable-diffusion-3.5-large produisent des images allant jusqu’à 2048x2048 pixels, avec une qualité de niveau commercial. La version flux-2-pro est spécialisée dans les sorties haute fidélité adaptées à l’impression.
Vitesse de génération
Les modèles varient fortement en temps de traitement :
Capacités spécialisées
Certains modèles excellent dans des domaines précis :
La révolution du flux de travail créatif
La création d’images traditionnelle exigeait des logiciels spécialisés, une compétence artistique et des heures de travail. La conversion texte vers image par l’IA ramène ce délai à quelques secondes, tout en conservant une qualité professionnelle. Les conséquences pour les professionnels de la création sont profondes :
L’itération rapide permet de tester des dizaines de concepts visuels dans le temps qu’il fallait auparavant pour un seul.
La collaboration avec les clients gagne en efficacité lorsque vous pouvez générer des options pendant les réunions.
La réduction des coûts pour les photos de banques d’images et les illustrations sur mesure atteint 90 % ou plus.
L’accessibilité ouvre la création visuelle aux non-designers tout en renforçant les capacités des professionnels.
Comparaison de la qualité : création humaine et création par l’IA
La cohérence : l’IA maintient un style uniforme sur plusieurs images, ce qui est difficile pour des artistes humains sous la pression des délais.
La vitesse : l’IA génère en quelques secondes ce que les humains réalisent en heures, voire en jours.
Le coût : l’IA fonctionne à un coût marginal par image, contre des tarifs horaires pour les professionnels.
L’adaptabilité : l’IA passe instantanément d’un style, d’un sujet ou d’une composition à l’autre.
Les limites : l’IA peine parfois sur la précision anatomique, les détails propres à une marque et les sujets très pointus pour lesquels les données d’entraînement sont limitées.
Les évolutions à venir
La technologie progresse rapidement :
L’intégration multimodale réunit génération de texte, d’images et de vidéos dans des interfaces unifiées.
La génération en temps réel réduit la latence à des niveaux imperceptibles pour les applications interactives.
La création de modèles 3D à partir de descriptions textuelles, pour les actifs de jeux et la visualisation architecturale.
Le transfert de style qui conserve l’identité du sujet tout en appliquant des traitements artistiques.
Le filtrage collaboratif qui apprend des préférences des utilisateurs pour améliorer les suggestions de prompts.
Premiers pas avec votre première image
-
Choisissez votre modèle : commencez par p-image pour la rapidité, ou flux-2-klein-4b pour la qualité.
-
Rédigez un prompt structuré : sujet + description + environnement + éclairage + style.
-
Réglez les paramètres : format (16:9 pour les paysages), résolution, seed pour la reproductibilité.
-
Générez et affinez : créez plusieurs variantes et ajustez vos prompts selon les résultats.
-
Retouchez si nécessaire : effectuez de petits ajustements dans un logiciel d’édition classique.
Impact économique et croissance du marché
Le secteur de la conversion texte vers image connaît une croissance explosive :
- Taille du marché projetée à 15,7 milliards de dollars d’ici 2028
- Adoption par les entreprises en hausse de 300 % d’une année sur l’autre
- Professionnels de la création signalant un gain de temps de 40 %
- Petites entreprises accédant à des contenus visuels auparavant inabordables
Cas d’usage courants avec des prompts précis
Photos de produits e-commerce : « Photographie produit professionnelle d’un casque sans fil sur une surface en marbre, éclairage studio, surfaces réfléchissantes, style catalogue commercial »
Contenus voyage : « Vue aérienne d’une plage tropicale aux eaux turquoise, palmiers le long du rivage, coucher de soleil à l’heure dorée, photographie de magazine de voyage »
Photographie culinaire : « Pizza artisanale au fromage fondu et basilic frais, prise de vue en plongée, four à bois en arrière-plan, style photo de blog culinaire »
Portraits : « Portrait professionnel d’une femme d’affaires dans un bureau moderne, lumière naturelle de fenêtre, expression assurée, photographie corporate »
L’entraînement consiste à analyser des millions de paires image-légende, afin d’apprendre :
- La sémantique visuelle : à quoi ressemble une « montagne » dans des contextes variés
- Le transfert de style : en quoi « impressionniste » diffère de « photoréaliste »
- Les règles de composition : cadrage naturel, principes d’éclairage, harmonie des couleurs
- Les relations entre objets : comment les éléments interagissent dans une scène
Le modèle stable-diffusion-3.5-medium illustre cette approche d’entraînement, avec des performances équilibrées sur des sujets variés.
Bonnes pratiques pour des résultats professionnels
Génération par lots : créez 5 à 10 variantes de chaque concept pour retenir la plus forte.
Bibliothèques de prompts : conservez des prompts classés par catégorie pour des visuels de marque cohérents.
Contrôle du seed : utilisez des seeds fixes lorsque vous avez besoin de variantes reproductibles.
Spécialisation des modèles : adaptez le modèle à votre besoin spécifique, nano-banana-pro pour les concepts créatifs, realistic-vision-v5.1 pour les portraits.
Vérification de la qualité : examinez les images à 100 % de zoom pour repérer les artefacts ou les incohérences.
L’essentiel pour les créatifs
La conversion texte vers image ne remplace pas la créativité humaine, elle l’amplifie. Les professionnels se concentrent désormais sur la direction conceptuelle, la sélection et l’affinement, plutôt que sur le rendu manuel. Les outils gèrent l’exécution technique, tandis que l’humain apporte la vision artistique.
Les utilisateurs les plus efficaces associent la génération par IA aux compétences traditionnelles : sélectionner les meilleurs résultats, effectuer des ajustements précis et intégrer les images dans des flux de travail créatifs plus vastes.
Commencez à expérimenter dès aujourd’hui avec l’un des modèles mentionnés ci-dessus. Tapez une phrase descriptive, observez la transformation du texte en image et découvrez comment cette technologie peut enrichir vos projets visuels. La barrière entre l’imagination et la visualisation n’a jamais été aussi basse.


