Si vous avez déjà travaillé avec des générateurs d’images ou de vidéos par IA, vous connaissez cette frustration. Vous créez un personnage parfait. Le visage, les cheveux, l’ambiance, exactement ce que vous vouliez. Puis vous tentez de générer ce même personnage dans une autre scène, et il ressemble à une tout autre personne. C’est précisément le problème que Higgsfield Soul ID a été conçu pour résoudre.
Ce que fait réellement Higgsfield Soul ID
Soul ID est la réponse de Higgsfield AI au problème de la cohérence des personnages. Il crée une identité numérique persistante pour un personnage, qui peut ensuite être utilisée dans plusieurs images et séquences vidéo générées sans perdre les attributs visuels essentiels qui rendent ce personnage reconnaissable.
Le principe est simple en apparence : vous importez une image de référence d’une personne (réelle ou générée par IA), et Soul ID extrait une représentation mathématique de son identité. Ensuite, lorsque vous générez de nouveaux contenus, le système utilise cet embedding d’identité pour garder le visage, les proportions et l’apparence générale cohérents, quoi qu’il change autour.
Le problème de la cohérence des personnages
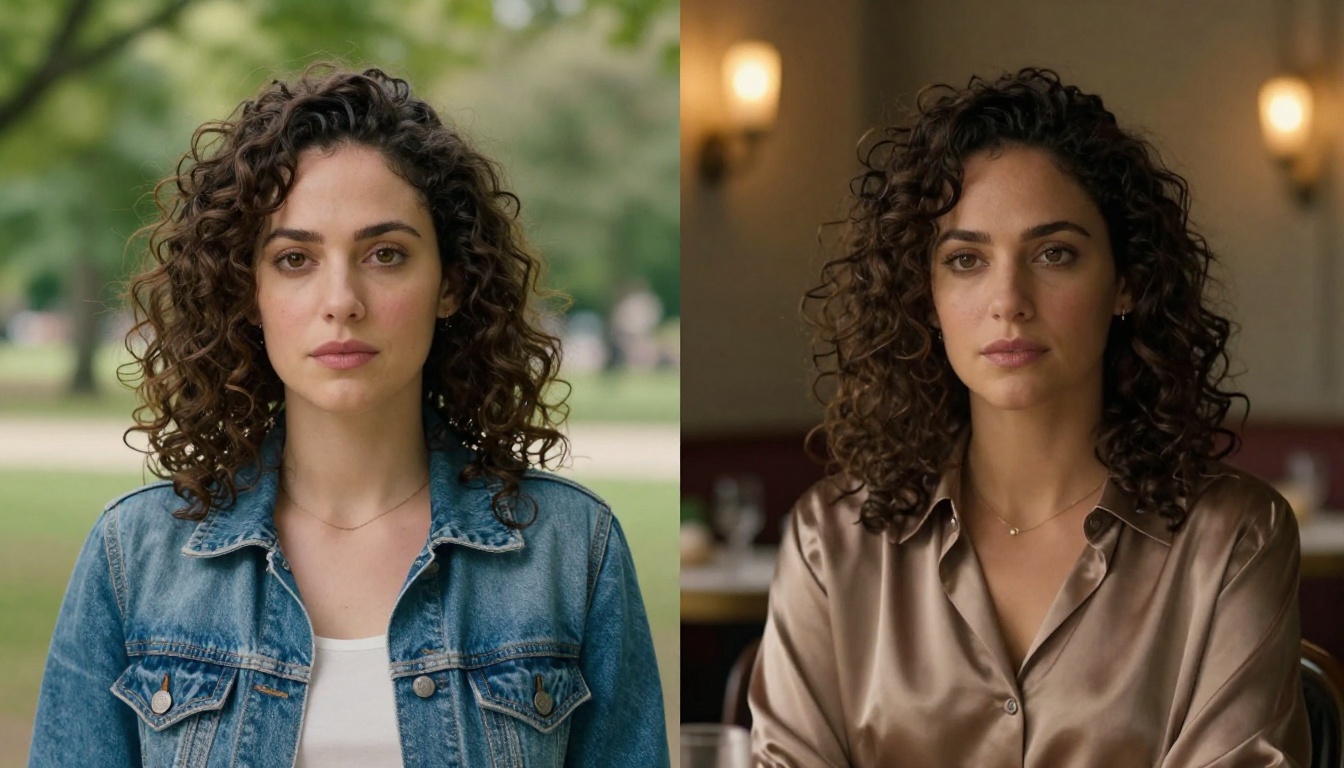
Les générateurs d’IA sont sans mémoire par défaut. Chaque génération est une inférence nouvelle à partir d’un prompt textuel, et sauf si vous incluez des contraintes techniques très précises, le modèle n’a aucun souvenir de l’apparence de votre personnage la dernière fois. Vous pouvez décrire « une femme aux cheveux auburn et aux yeux bleus » cent fois et obtenir cent femmes différentes.
Cette limitation pose de vrais problèmes pour :
- Les conteurs qui ont besoin du même protagoniste tout au long d’un récit visuel
- Les créateurs de marques qui veulent une mascotte ou un porte-parole constant
- Les séries de contenus où la reconnaissance du personnage fidélise l’audience
- Les créateurs sur les réseaux sociaux qui veulent une persona IA signature dans leurs publications
Soul ID traite ce problème au niveau du modèle, plutôt que de s’appuyer sur des astuces de prompt engineering, et c’est ce qui le rend remarquable.
Comment Soul ID extrait l’identité
Le processus technique fonctionne à peu près ainsi :
- Une image de référence passe par un encodeur d’identité dédié
- L’encodeur produit un vecteur d’identité à haute dimension, en substance une empreinte numérique du visage
- Ce vecteur est injecté dans les couches de cross-attention du pipeline de génération
- Pendant l’inférence, le mécanisme d’attention ramène sans cesse le résultat vers l’identité enregistrée
Ce procédé diffère d’un simple image-to-image avec un fort denoise strength, qui tend à copier toute la composition plutôt que seulement l’identité. Soul ID isole spécifiquement la structure du visage, les proportions et les traits caractéristiques, tout en laissant la pose, l’éclairage, l’expression et le décor varier librement.
Le concept d’embedding d’identité n’est pas propre à Higgsfield. Il s’appuie sur des années de recherche en reconnaissance faciale, sur les architectures IP-Adapter et sur la diffusion à personnage constant. Ce que Soul ID apporte, c’est une implémentation aboutie et prête pour la production, conçue pour les créateurs grand public plutôt que pour les chercheurs.
Traitement de l’image de référence
Lorsque vous importez une image de référence dans Soul ID, le système :
- Détecte et recadre automatiquement la zone du visage
- Normalise la pose du visage vers une position frontale canonique
- Exécute l’encodeur pour produire le vecteur latent d’identité
- Enregistre le vecteur rattaché à un profil Soul ID nommé
Ce dernier point compte pour le flux de travail. Soul ID n’est pas une opération ponctuelle. Vous créez des profils nommés qui persistent dans votre compte, et vous pouvez les réutiliser indéfiniment. Créez « Emma » une seule fois, et Emma est disponible pour chaque génération future.
Espace latent et injection d’identité
Fonctionnement : le vecteur d’identité vit dans le même espace latent à haute dimension que celui qu’utilise le modèle de diffusion pendant la génération. En l’injectant par cross-attention, le modèle traite « le visage de ce personnage » comme un signal conditionnel aux côtés de votre prompt textuel.
Le résultat est que votre prompt textuel contrôle la scène, la pose, la tenue et l’ambiance. Soul ID contrôle qui se trouve dans la scène. Ces deux signaux fonctionnent en grande partie de manière indépendante, ce qui vous permet d’écrire « Emma randonnant dans les montagnes à l’aube » et d’obtenir une silhouette reconnaissable comme Emma dans un décor entièrement nouveau.
Cohérence image par image dans la vidéo
Pour la génération vidéo de Higgsfield, Soul ID s’étend à la cohérence temporelle. Chaque image reçoit la même injection d’identité, ce qui évite la dérive qui ferait sinon évoluer l’apparence d’un personnage au fil de la séquence vidéo. C’est nettement plus difficile à obtenir en vidéo qu’en image isolée, car les modèles vidéo doivent équilibrer la fidélité de l’identité et la naturalité du mouvement.
Cas d’usage concrets de Soul ID
Séries sur les réseaux sociaux
Le cas d’usage le plus courant, de loin. Les créateurs qui bâtissent une audience autour d’une persona IA spécifique ont besoin que cette persona reste reconnaissablement cohérente d’une publication à l’autre. Sans cohérence, le personnage passe pour une production IA générique. Avec elle, il peut gagner en reconnaissance et même créer un lien émotionnel avec son audience.
Soul ID rend cela durable. Au lieu de passer vingt minutes en prompt engineering et en itérations pour approcher l’apparence du personnage de la semaine dernière, vous appelez le profil enregistré et la cohérence est gérée automatiquement.
Court métrage et narration visuelle
Le contenu narratif visuel repose entièrement sur la continuité du personnage. Le spectateur doit suivre un protagoniste à travers les scènes, les lieux et les arcs émotionnels. Soul ID le rend possible à un niveau pratique pour les créateurs solo qui, sans lui, ne pourraient pas produire un court métrage visuellement cohérent avec l’IA générative.
L’usage narratif s’étend à :
- Les webcomics générés avec des personnages cohérents d’une case à l’autre
- Les illustrations de livres pour enfants où le même jeune protagoniste apparaît dans chaque double page
- Les démonstrations de produits mettant en scène un ambassadeur de marque constant
- Les miniatures YouTube avec un personnage récurrent que les spectateurs reconnaissent instantanément
Mascottes et porte-parole de marque
Les entreprises qui créent des contenus marketing générés par IA ont besoin de cohérence pour la reconnaissance de marque. Une mascotte qui change d’apparence à chaque publicité n’est pas une mascotte. Soul ID donne aux équipes marketing un moyen de figer l’identité visuelle d’un personnage et de l’utiliser de manière fiable dans toutes leurs campagnes, sans passer par un pipeline de production complet à chaque fois.
Les limites à connaître
Soul ID est vraiment impressionnant, mais il présente des contraintes qu’il vaut la peine de connaître avant d’intégrer votre flux de travail.
Quand Soul ID atteint ses limites
| Scénario | Ce qui se passe | Gravité |
|---|
| Changements de pose extrêmes (vue de profil, tête inclinée à 90°) | Les traits du visage dérivent de façon notable | Modérée |
| Éclairage très différent (lumière latérale dure) | La fidélité de l’identité diminue | Mineure |
| Styles non photoréalistes | L’injection d’identité entre en concurrence avec le guidage du style | Modérée |
| Images de référence de faible qualité | L’encodeur produit un embedding bruité | Majeure |
| Enfants ou structures faciales inhabituelles | Moins de données d’entraînement, résultat moins fiable | Modérée |
Le système donne de meilleurs résultats avec des images de référence de haute qualité, bien éclairées, frontales ou presque frontales. Plus votre entrée est bonne, plus le verrouillage de l’identité est serré.
Restrictions de la plateforme
Soul ID de Higgsfield est verrouillé dans l’écosystème Higgsfield. Vous ne pouvez pas exporter le vecteur d’identité et l’utiliser dans un autre outil. Vos profils de personnages vivent dans l’infrastructure de Higgsfield, ce qui pose des questions de dépendance si votre flux de travail exige de la souplesse entre plusieurs plateformes.
De plus, Higgsfield fonctionne avec un modèle de crédits qui peut devenir coûteux pour la production de contenus à fort volume. Si vous générez des centaines d’images par mois, le coût par génération s’accumule rapidement.
La cohérence des personnages sur PicassoIA
PicassoIA propose plusieurs approches de la cohérence des personnages qui ne vous enferment pas dans l’écosystème d’une seule plateforme. La démarche est différente : plutôt qu’un système « Soul ID » propriétaire unique, PicassoIA vous donne accès à un large ensemble de modèles et de méthodes que vous pouvez combiner pour obtenir des résultats cohérents et fiables.
Les modèles FLUX pour une génération à identité stable
Les modèles FLUX 1.1 Pro et FLUX 1.1 Pro Ultra montrent une adhérence au prompt inhabituellement forte pour la cohérence faciale. Lorsque vous décrivez un personnage précis avec des attributs physiques détaillés, FLUX tend à respecter ces attributs de manière plus fiable que les architectures plus anciennes.
FLUX Dev et FLUX Pro sont particulièrement efficaces lorsque vous :
- Rédigez des descriptions de personnages détaillées et précises (couleur des cheveux, couleur des yeux, structure du visage, teint)
- Utilisez une valeur de seed pour ancrer le point de départ aléatoire de la génération
- Gardez la description de base du personnage identique d’un prompt à l’autre en ne faisant varier que les éléments de la scène
Astuce : fixez le seed de votre personnage dans FLUX et réutilisez la même description physique détaillée d’un prompt à l’autre. La combinaison de l’ancrage par seed et de la bonne adhérence au prompt de FLUX produit des résultats nettement plus cohérents que la plupart des autres modèles du marché.
RealVisXL pour les personnages photoréalistes
RealVisXL v3 Turbo excelle dans la génération de portraits photoréalistes. Pour les créateurs qui ont besoin d’un personnage qui paraît être une vraie personne plutôt qu’un rendu d’IA, RealVisXL offre une texture de peau naturelle, une interaction réaliste avec la lumière et des proportions faciales authentiques d’une génération à l’autre.
ControlNet pour la cohérence structurelle
Le SDXL Multi-ControlNet LoRA apporte un contrôle au niveau de la structure qui complète le contrôle au niveau de l’identité. En utilisant une pose de référence ou une carte de profondeur issue d’une image existante de personnage, vous pouvez conserver non seulement le visage, mais aussi les proportions générales du corps et la relation spatiale d’une génération à l’autre.
SDXL avec le pipeline ControlNet forme une combinaison puissante pour les créateurs qui ont besoin de leur personnage dans des poses précises tout en gardant son identité visuelle intacte.
Voici un flux de travail pratique pour la cohérence des personnages sur PicassoIA, sans avoir besoin d’un système d’identité propriétaire :
Étape 1 : créez votre référence canonique
Commencez par FLUX 1.1 Pro ou Realistic Vision v5.1. Générez votre personnage dans une pose neutre, sur un fond neutre, avec un éclairage doux et uniforme. Notez ensuite, en détail, chaque attribut physique.
Étape 2 : construisez votre chaîne de description du personnage
Rédigez une description de personnage réutilisable que vous collerez dans chaque prompt. Par exemple :
« Femme de 30 ans, cheveux noirs et raides coupés aux épaules, yeux ambre clair, mâchoire bien dessinée, petit nez retroussé, peau mate claire, petite cicatrice au-dessus du sourcil gauche »
Cette chaîne devient l’ancre d’identité. Elle est portable, indépendante de la plateforme, et vous en êtes entièrement propriétaire.
Étape 3 : fixez le seed (facultatif mais puissant)
Lorsque vous utilisez FLUX Schnell ou FLUX Dev, définissez un seed qui donne une bonne correspondance avec la description de votre personnage. Notez ce seed. Le réutiliser avec la même description maintient les résultats dans une plage visuelle beaucoup plus resserrée.
Étape 4 : contrôlez la structure avec ControlNet
Pour les scènes qui exigent des poses précises, prenez votre image de référence canonique et passez-la dans SDXL Multi-ControlNet LoRA comme référence de pose. Le modèle adoptera la pose tout en suivant votre description du personnage pour les détails du visage et du corps.
Étape 5 : upscalez et affinez
Utilisez les outils de super-résolution de PicassoIA pour affiner vos rendus finaux et corriger toute légère dérive des traits du visage grâce à un inpainting ciblé sur des zones précises.
Soul ID face aux autres approches
| Critère | Higgsfield Soul ID | PicassoIA (FLUX + ControlNet) | Prompt engineering seul |
|---|
| Temps de configuration | Rapide (import de la référence, terminé) | Moyen (nécessite la mise en place d’un flux de travail) | Minimal |
| Score de cohérence | Très élevé | Élevé | Faible à modéré |
| Enfermement dans la plateforme | Élevé | Aucun | Aucun |
| Coût | Crédits par génération | Crédits par génération | Identique |
| Prise en charge de la vidéo | Oui (native) | Via des modèles vidéo séparés | Limitée |
| Souplesse de style | Bonne | Excellente | Totale |
| Export et portabilité | Non | Oui | Oui |
| Variété de modèles | Limitée à Higgsfield | Plus de 90 modèles | Dépend de la plateforme |
La comparaison honnête : Soul ID est plus clé en main pour son usage spécifique. Mais l’approche de PicassoIA vous donne davantage de contrôle, plus de choix de modèles et aucun enfermement. Pour les créateurs qui veulent maîtriser leur flux de travail, l’approche PicassoIA l’emporte en matière de souplesse. Pour les créateurs qui veulent le chemin le plus rapide vers la cohérence des personnages en vidéo, l’intégration vidéo native de Soul ID a pour l’instant une longueur d’avance.
Essayez et constatez la différence
La cohérence des personnages compte parmi les problèmes les plus difficiles de la création de contenu par IA, et voir émerger des outils dédiés pour s’y attaquer est vraiment passionnant pour les créateurs de tous horizons. Soul ID en est une réponse solide. Mais l’approche multi-modèles disponible sur PicassoIA en est une autre, qui sacrifie un peu de commodité au profit d’une liberté considérable.
Si vous voulez voir à quoi ressemble concrètement la génération de personnages cohérents, commencez par FLUX 1.1 Pro sur PicassoIA. Rédigez une description détaillée du personnage, fixez un seed qui vous donne un bon résultat, puis ne faites varier que les éléments de la scène sur vos cinq prochains prompts. La cohérence obtenue avec ce flux de travail simple pourrait vous surprendre.
Ensuite, ajouter SDXL Multi-ControlNet LoRA pour le contrôle de la pose et RealVisXL v3 Turbo pour le photoréalisme vous donne un pipeline complet de cohérence des personnages. Aucun système propriétaire n’est nécessaire, aucune dépendance à une plateforme, et l’accès à plus de 90 modèles de texte vers image dès que vous voulez tester une autre direction visuelle pour votre personnage.


