Votre visage est en train de transmettre des informations que vous n’avez jamais consciemment décidé de partager. La légère tension de vos sourcils, la micro-contraction au coin de vos yeux, l’asymétrie à peine perceptible de votre expression au repos : un système d’IA bien entraîné lit tout cela en moins de 40 millisecondes. La reconnaissance faciale des émotions est passée du stade de curiosité de laboratoire à celui de technologie prête pour la production, et les mécanismes qui la sous-tendent sont bien plus précis que ce que la plupart des gens imaginent.
Il ne s’agit pas de la simple classification « heureux/triste » que vous avez peut-être rencontrée avec les premiers chatbots. L’IA émotionnelle moderne repose sur un empilement en couches de vision par ordinateur, de réseaux de neurones et de recherches en psychologie comportementale, qui ont demandé des décennies pour être mises au point. Voici comment elle fonctionne réellement.
Votre visage en dit plus que vous ne le pensez
Le visage humain peut produire environ 10 000 expressions distinctes. La plupart d’entre elles sont involontaires. Lorsque vous ressentez un bref éclair de mépris, votre muscle élévateur de la lèvre supérieure et de l’aile du nez se contracte pendant une fraction de seconde avant que vous ayez pu le réprimer. Lorsque vous recevez une bonne nouvelle inattendue, votre grand zygomatique s’active avant que votre esprit conscient ait pleinement traité ce qui s’est passé.
Les 43 muscles qui vous trahissent
Votre visage est commandé par 43 muscles, répartis en deux systèmes : volontaire et involontaire. Le système volontaire est celui qui vous permet de poser pour une photo et de réaliser des expressions travaillées. Le système involontaire est la cible de l’IA.
Les marqueurs de Duchenne en sont l’exemple le plus net. Un sourire sincère mobilise à la fois le grand zygomatique (qui relève les coins des lèvres) et l’orbiculaire de l’œil (qui plisse le coin externe des yeux). Un sourire joué ne sollicite que le grand zygomatique. La différence est visible sur des images haute résolution, et une IA bien entraînée la détecte avec une grande constance.
Ce que sont réellement les micro-expressions
Les recherches de Paul Ekman, dans les années 1970, ont identifié une catégorie d’expressions appelées micro-expressions : de brefs mouvements faciaux involontaires, d’une durée comprise entre 1/25e et 1/5e de seconde. Elles apparaissent avant que la personne ait eu le temps de masquer consciemment sa réaction.
💡 Les micro-expressions sont trop rapides pour être détectées par la plupart des humains sans formation spécifique, mais les systèmes d’IA fonctionnant à 30 ou 60 images par seconde les capturent et les classent avec une précision remarquable.
Ces expressions constituent la référence absolue pour les entrées de l’IA émotionnelle, car il est presque impossible de les simuler. Elles expliquent aussi pourquoi les caméras à haute vitesse, plutôt que les photos fixes, représentent le format d’entrée le plus précis pour les systèmes de reconnaissance émotionnelle en production.
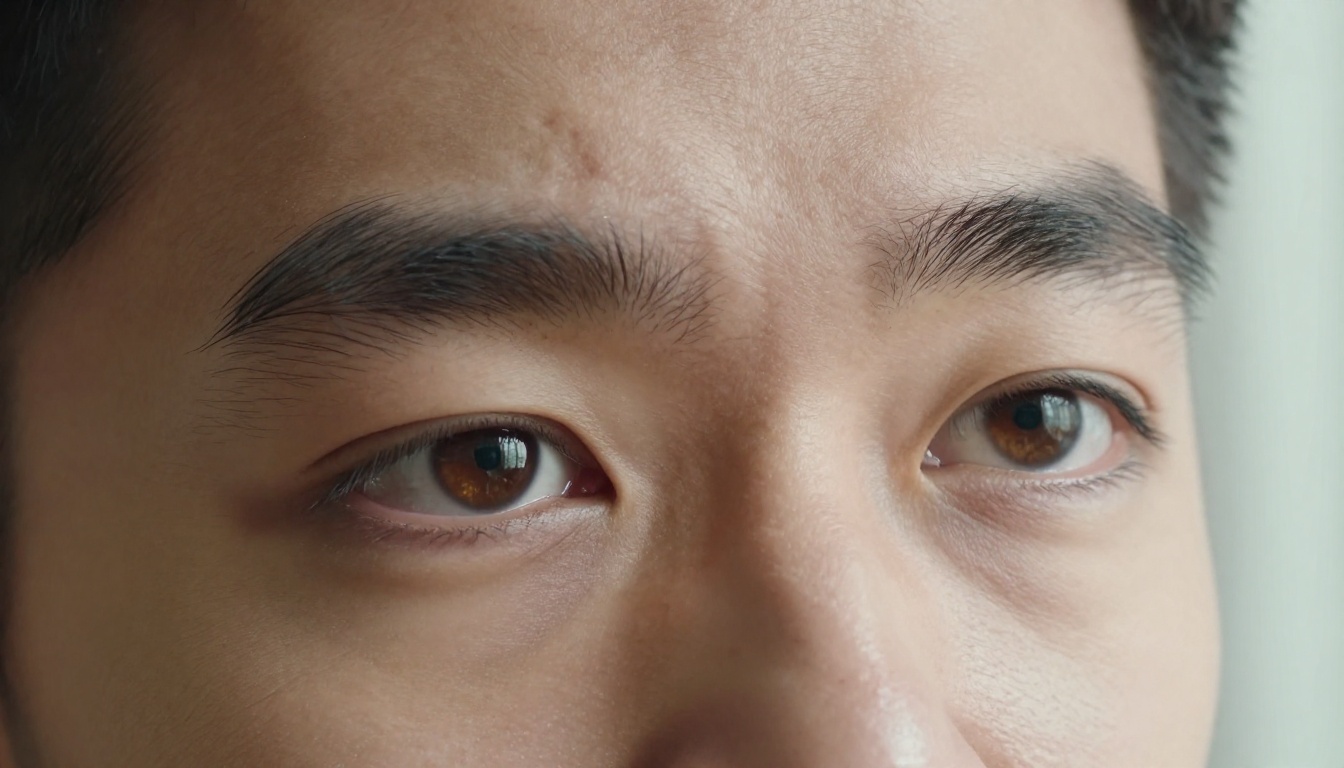
Avant tout traitement émotionnel, l’IA doit résoudre un problème plus fondamental : localiser le visage dans l’image et en cartographier la structure avec précision.
Des pixels aux points de repère
La première étape est la détection des points de repère faciaux. Un modèle entraîné identifie entre 68 et 468 points de référence précis sur le visage : les coins des yeux, le bout du nez, l’arc de Cupidon de la lèvre supérieure, les points de jonction des lobes d’oreilles. Ces points forment une carte géométrique appelée maillage facial.
Le maillage facial remplit deux fonctions simultanément :
- Il normalise le visage malgré les variations de pose, de distance et d’éclairage
- Il fournit les données de coordonnées brutes que les classifieurs d’émotions utilisent en entrée
Les détecteurs de points de repère modernes fonctionnent en temps réel sur du matériel grand public, en traitant des maillages faciaux complets à plus de 60 images par seconde sur le processeur d’un ordinateur portable standard.
Le rôle des réseaux de neurones convolutifs
Une fois le maillage facial établi, l’essentiel du travail revient aux réseaux de neurones convolutifs (CNN). Les CNN excellent dans la reconnaissance de motifs spatiaux, ce qui les rend idéaux pour le traitement des visages.
Le réseau est entraîné à associer certaines configurations spatiales de points de repère, ainsi que les intensités de pixels situées entre eux, à des étiquettes émotionnelles. Pour cela, il ingère de vastes jeux de données annotés, qui contiennent parfois des millions d’images faciales annotées, réparties selon différentes caractéristiques démographiques.
| Type de couche CNN | Ce qu’elle traite |
|---|
| Convolutionnelle | Contours, textures, motifs locaux |
| Pooling | Réduction spatiale, robustesse aux petits décalages |
| Entièrement connectée | Combinaisons de caractéristiques de haut niveau |
| Sortie Softmax | Distribution de probabilités entre les classes d’émotions |
Le résultat n’est pas un verdict binaire « heureux ou pas heureux ». C’est un vecteur de probabilités : 0,72 heureux, 0,14 surpris, 0,08 neutre, 0,06 autre. Cette sortie probabiliste permet à l’IA de traiter les cas réellement ambigus, qui dominent l’expression humaine réelle.
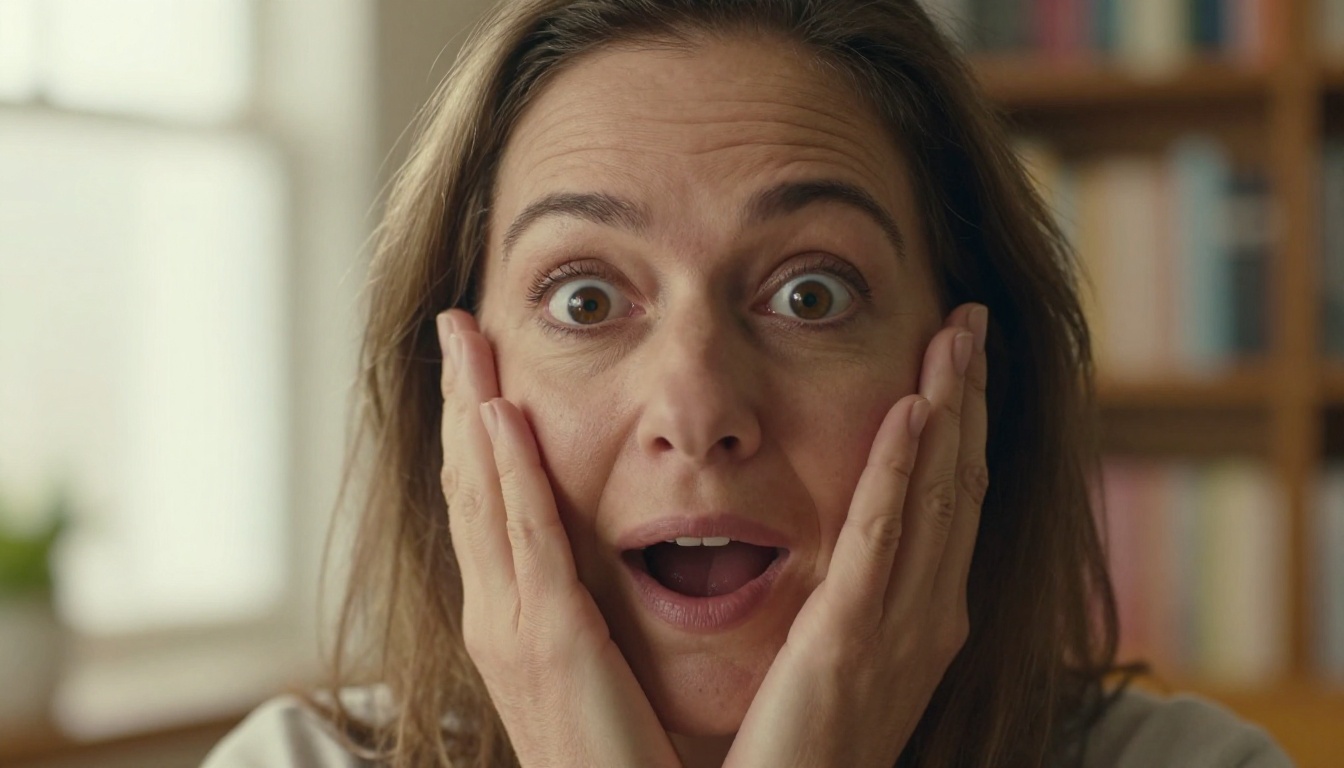
Lire les unités d’action
Le cadre le plus rigoureux pour l’IA émotionnelle n’a pas été conçu par un informaticien. Il vient d’un psychologue.
Ce que le FACS a appris à l’IA
Paul Ekman et Wallace Friesen ont développé le Facial Action Coding System (FACS) en 1978. Le FACS décompose tous les mouvements du visage en unités d’action (AU) distinctes, chacune correspondant à la contraction d’un ou plusieurs muscles faciaux spécifiques.
Le FACS définit 44 unités d’action. Chacune possède une notation standard :
- AU1 : élévation de la partie interne du sourcil (frontal, portion médiale)
- AU4 : abaisseur du sourcil (corrugateur du sourcil)
- AU6 : élévateur de la joue (orbiculaire de l’œil, portion orbitale)
- AU12 : tireur des coins de la lèvre (grand zygomatique)
- AU17 : élévateur du menton (mentonnier)
L’IA de reconnaissance des émotions est entraînée à détecter ces unités d’action individuellement, avant de les combiner en classifications émotionnelles. C’est bien plus robuste qu’un entraînement direct sur « à quoi ressemble la joie » dans son ensemble.
Associer des combinaisons d’AU aux émotions
Chaque émotion de base possède une signature caractéristique d’unités d’action :
| Émotion | Unités d’action principales |
|---|
| Joie | AU6 + AU12 |
| Tristesse | AU1 + AU4 + AU15 |
| Surprise | AU1 + AU2 + AU5 + AU26 |
| Peur | AU1 + AU2 + AU4 + AU5 + AU7 + AU20 + AU26 |
| Dégoût | AU9 + AU15 + AU16 |
| Colère | AU4 + AU5 + AU7 + AU23 + AU24 |
| Mépris | AU12R + AU14R (unilatéral) |
💡 Le mépris est la seule émotion de base asymétrique. L’activation musculaire ne se produit que d’un côté du visage, ce qui le rend particulièrement distinctif dans la détection automatisée.
Les émotions complexes, qui représentent l’essentiel de ce que les gens ressentent d’un instant à l’autre, font intervenir des combinaisons d’AU qui se chevauchent et des signaux contextuels. C’est là que les systèmes d’IA actuels rencontrent leur plus grand défi.
Les 7 émotions de base que l’IA reconnaît
L’hypothèse fondatrice de l’IA émotionnelle s’inspire des recherches interculturelles d’Ekman, qui affirmaient que six émotions sont universelles dans toutes les cultures humaines : la joie, la tristesse, la colère, la peur, le dégoût et la surprise. Le mépris a été ajouté par la suite comme septième.
Les systèmes d’IA modernes sont principalement entraînés sur ces sept catégories, car elles apparaissent de manière constante dans les données d’entraînement collectées auprès de populations variées. Ce sont les plus fiablement annotées, les plus étudiées et les plus pertinentes sur le plan commercial pour les applications concrètes.
Là où la science se complique
L’hypothèse des « émotions universelles » n’est pas exempte de critiques. Depuis les travaux originaux d’Ekman, les recherches ont mis en évidence une variation culturelle importante dans la manière dont les émotions s’expriment et s’interprètent. Un sourcil levé n’a pas la même signification au Japon qu’au Brésil. Le deuil contenu est fréquent dans les cultures où les normes de régulation émotionnelle sont fortes, ce qui le rend presque invisible pour une IA entraînée sur des données occidentales.
Le paysage émotionnel réel est dimensionnel, et non catégoriel. Le modèle valence-activation, utilisé par de nombreux chercheurs, place les émotions sur deux axes continus :
- Valence : négative à positive (désagréable à agréable)
- Activation : faible à élevée (calme à excité)
Dans ce modèle, « heureux » et « enthousiaste » ne sont pas des catégories distinctes, mais des points dans un espace continu. Certains systèmes d’IA modernes adoptent cette approche dimensionnelle plutôt que des étiquettes discrètes, ce qui produit des résultats plus nuancés et reflète mieux la complexité de l’expérience émotionnelle vécue.
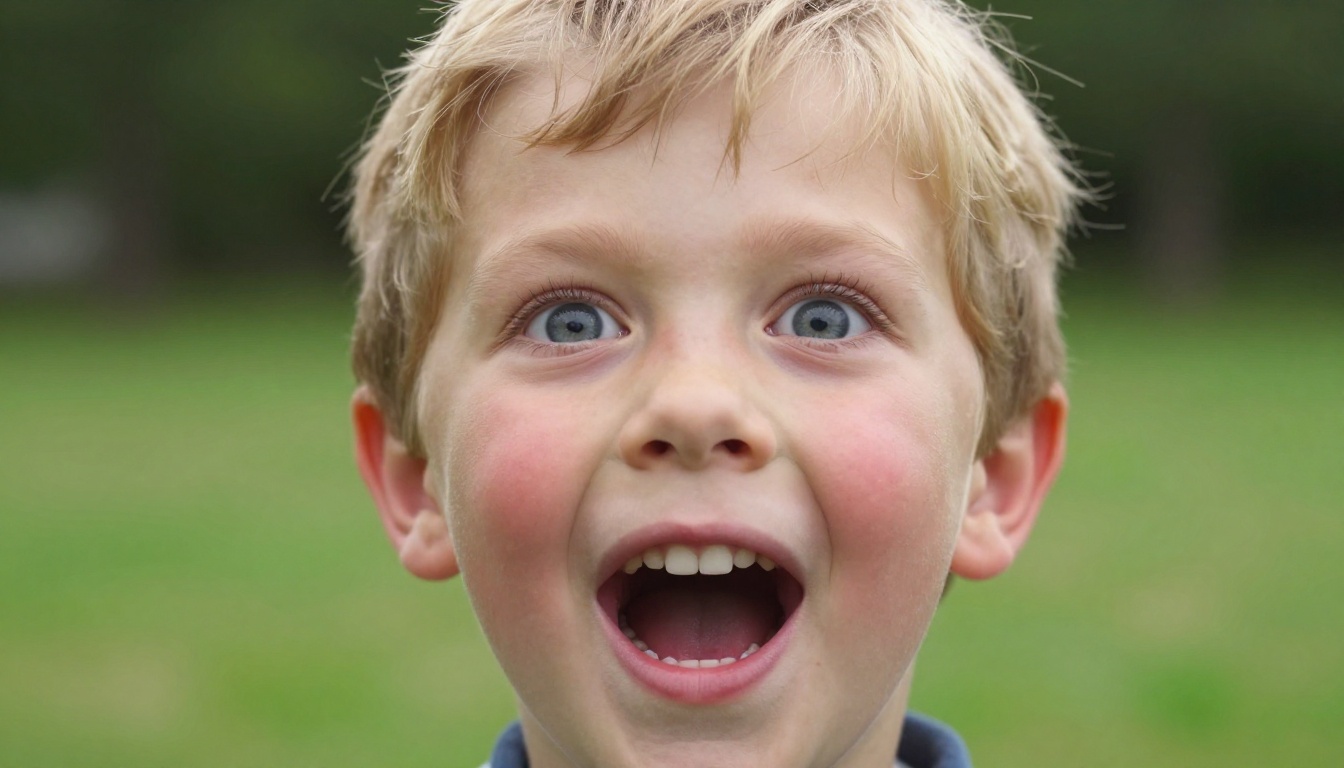
Le suivi émotionnel en temps réel en pratique
La précision en laboratoire et la performance en conditions réelles sont deux choses différentes. Un modèle qui atteint 95 % de précision sur un jeu de données contrôlé peut se montrer nettement moins performant face aux entrées désordonnées et variables qui caractérisent un déploiement réel.
Vitesse ou précision
Le suivi émotionnel en temps réel impose des compromis. Les modèles plus grands et plus précis demandent plus de temps de calcul. Les modèles assez rapides pour un usage en temps réel, sous les 100 millisecondes par image, sacrifient souvent une partie de leur précision de classification pour atteindre ce seuil.
Le pipeline de production typique fonctionne ainsi :
- Détection du visage (modèle léger) : ~5 ms
- Extraction des points de repère (modèle moyen) : ~10 ms
- Détection des AU (modèle spécialisé) : ~15 ms
- Classification des émotions (classifieur léger) : ~5 ms
- Lissage des sorties (moyenne temporelle sur les images) : ~2 ms
Total : environ 37 ms par image, ce qui permet un fonctionnement en temps réel à plus de 27 images par seconde sur un GPU grand public.
Le problème de l’éclairage dont personne ne parle
L’éclairage est la principale source de dégradation des performances de l’IA émotionnelle en conditions réelles. Un même visage photographié dans des conditions différentes se comporte de manière radicalement différente :
- Éclairage fluorescent plafonnier uniforme : les ombres des AU s’aplatissent, les signaux asymétriques se perdent
- Éclairage latéral fort : crée de fausses ombres qui imitent des contractions d’AU absentes de la musculature
- Faible luminosité ou contre-jour : perte de détails de texture qui soutiennent la détection des micro-expressions
C’est précisément pour cette raison que les données d’entraînement synthétiques photoréalistes, générées avec un éclairage contrôlé et varié, peuvent améliorer de manière significative la robustesse des modèles en conditions réelles. La génération d’images par IA n’est pas seulement un outil créatif : elle devient de plus en plus un outil de production de données pour entraîner les modèles de perception.
Là où l’IA émotionnelle échoue
Aucune technologie n’est exempte de modes de défaillance, et l’IA émotionnelle en présente plusieurs qu’il faut prendre au sérieux avant de la déployer dans des contextes sensibles.
Les biais culturels dans les données d’entraînement
La plupart des grands jeux de données sur les émotions ont été collectés principalement auprès de sujets d’Amérique du Nord et d’Europe occidentale. Les modèles entraînés sur ces données transmettent ce biais géographique et culturel dans les environnements de production.
Des recherches menées par le MIT Media Lab et d’autres équipes ont montré que les systèmes commerciaux de reconnaissance des émotions produisent des taux d’erreur nettement plus élevés pour :
- Les teints de peau foncés, sur plusieurs catégories d’émotions
- Les femmes exprimant la colère, qui sont plus souvent classées à tort comme « dégoûtées »
- Les structures faciales et les normes d’expression non occidentales
- Les visages âgés, où les changements naturels de la peau affectent la précision de la détection des points de repère
Ce ne sont pas des cas marginaux. Ils représentent la majorité des visages humains sur Terre, ce qui signifie que le biais n’est pas un simple problème de calibrage mineur. C’est un défaut structurel dans la manière dont les données d’entraînement ont été collectées jusqu’ici.
La mauvaise lecture du visage neutre
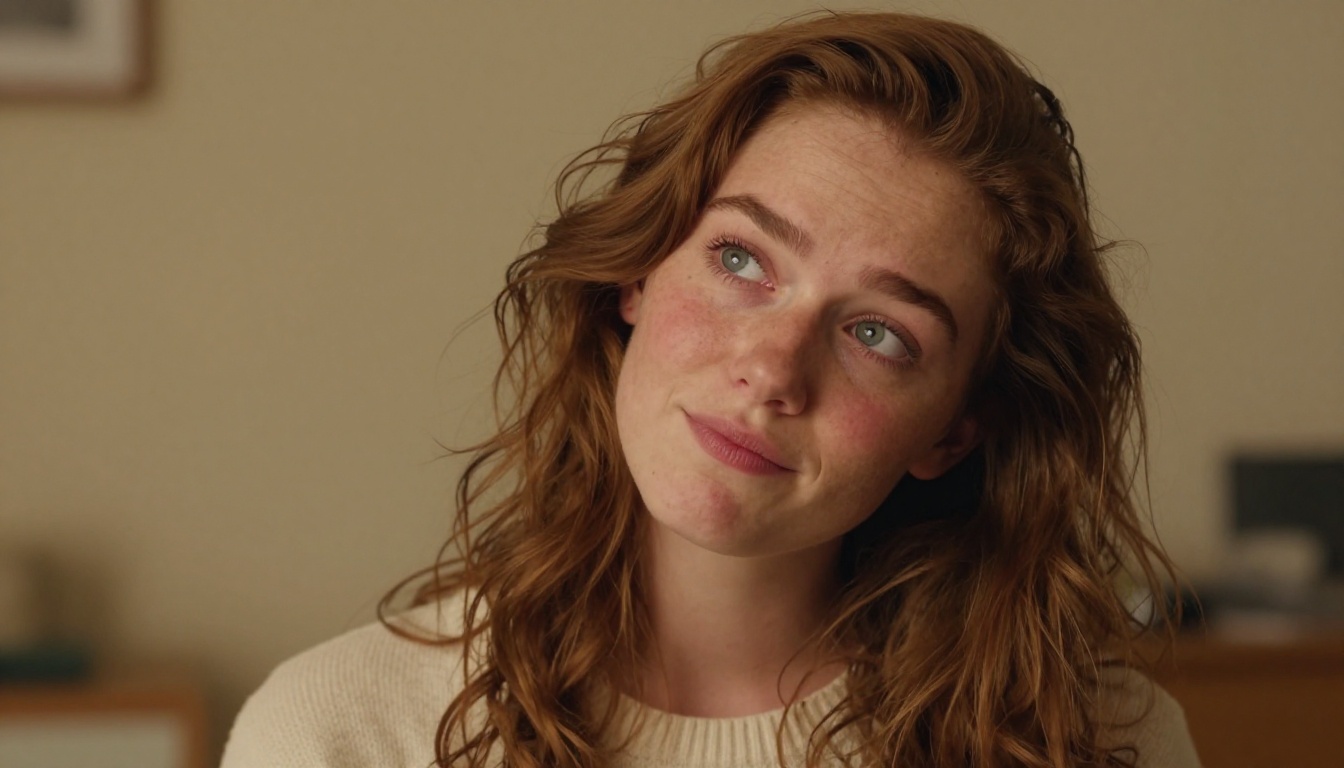
Beaucoup de personnes ont une expression au repos qui paraît négative, aussi bien aux humains qu’aux machines. Les classifieurs d’émotions traitent les expressions neutres ambiguës en se rapprochant de la catégorie entraînée la plus proche, qui est souvent la tristesse ou le déplaisir.
Cela produit de faux positifs dont les conséquences sont réelles dans les applications à fort enjeu : outils de tri des candidatures RH, systèmes de sécurité ou aides au diagnostic médical. Une IA qui lit à tort un visage neutre comme hostile ou en détresse peut causer un préjudice considérable.
💡 Un déploiement responsable de l’IA émotionnelle exige une relecture humaine dans tout contexte de prise de décision, plutôt qu’une action automatisée fondée sur le seul résultat d’un modèle.
L’IA émotionnelle dans la génération de portraits
Le lien entre la reconnaissance des émotions et la génération d’images est plus étroit qu’il n’y paraît. Les deux reposent sur le même savoir sous-jacent : ce qui rend un visage émotionnellement authentique au niveau du pixel.
Créer des portraits qui paraissent vivants
Lorsque vous générez un portrait photoréaliste avec un modèle d’IA de génération d’images, la qualité de l’expression émotionnelle dépend de la qualité avec laquelle les données d’entraînement ont capturé l’authenticité émotionnelle. Les modèles entraînés sur des données émotionnelles plates, posées ou mal étiquetées produisent des visages techniquement corrects, mais émotionnellement vides.
Les meilleurs modèles de portraits génératifs ont été entraînés, ou affinés, sur des données dotées d’un étiquetage émotionnel précis. C’est pourquoi certains modèles restituent de véritables sourires de Duchenne, tandis que d’autres produisent cette approximation légèrement dérangeante, qui paraît « presque juste » sans jamais vraiment convaincre.
Comment l’IA de vision lit les visages sur PicassoIA
Plusieurs modèles d’IA multimodaux disponibles sur PicassoIA peuvent évaluer directement le contenu émotionnel des photos. Ce sont des modèles dotés de capacités de vision, qui vous permettent d’importer une image de visage et d’obtenir une analyse détaillée de l’expression, de l’humeur et des signaux émotionnels présents.
GPT-4o fait partie des modèles de vision les plus performants pour cette tâche. Il peut décrire les traits du visage qui contribuent à une lecture émotionnelle, expliquer en langage courant les observations au niveau des AU et comparer les expressions de plusieurs images au cours d’une même session.
Gemini 2.5 Flash offre un traitement multimodal rapide et des capacités de vision solides, utile pour le travail par lots ou pour les applications où la rapidité de réponse compte autant que la profondeur d’analyse.
Gemini 3 Flash combine chat et vision dans une formule efficace, adaptée au travail itératif sur des images de visages et des contenus émotionnels.
Claude Opus 4.7 apporte un raisonnement contextuel approfondi au traitement visuel, et propose souvent des interprétations plus nuancées des expressions complexes ou ambiguës que des classifieurs plus simples interpréteraient complètement à l’envers.
Kimi K2.5 de Moonshotai accepte également les images en plus du texte, et constitue une autre option solide pour explorer les émotions à partir de photographies.
Ces modèles ne produisent pas de codes AU bruts ni de vecteurs de probabilités comme le font les API de reconnaissance émotionnelle dédiées. Ils fournissent en revanche des descriptions riches et contextuelles, souvent plus utiles lorsque vous devez évaluer la qualité émotionnelle d’un portrait plutôt que simplement le classer dans une catégorie.
Prompter pour une authenticité émotionnelle
Si vous avez déjà tenté de demander à un générateur d’images par IA une expression émotionnelle précise et obtenu un résultat qui paraît faux, vous vous êtes heurté au même problème de fond que celui auquel sont confrontés les chercheurs en reconnaissance des émotions : l’authenticité émotionnelle au niveau du pixel est extrêmement complexe.
L’approche la plus efficace consiste à être précis dans vos prompts. Plutôt que « une femme heureuse », décrivez les détails au niveau musculaire :
« légère courbure vers le haut des coins des lèvres, plissement de l’orbiculaire de l’œil aux coins externes, joues légèrement relevées, sourcils détendus, léger plissement des yeux compatible avec un sourire de Duchenne sincère, tension naturelle de la peau aux sillons nasogéniens »
Ce langage de prompt correspond directement aux connaissances sur les unités d’action qui sous-tendent l’IA émotionnelle, et il tend à produire des résultats nettement plus convaincants que des étiquettes émotionnelles vagues. Le modèle de génération d’images a vu suffisamment de données faciales étiquetées pour répondre à ce niveau de précision.
Vous pouvez aussi utiliser les modèles de vision de PicassoIA pour évaluer un portrait existant, identifier ce que l’IA lit dans l’expression émotionnelle, puis utiliser ce retour pour affiner votre prompt de génération. Le résultat est une boucle de rétroaction serrée entre reconnaissance et génération, qui produit des portraits dotés de qualités émotionnelles intentionnelles et précises.
Un flux de travail pratique :
- Importez un portrait de référence dans GPT-4o ou Gemini 3 Flash et demandez une lecture émotionnelle détaillée
- Notez les unités d’action que le modèle identifie comme actives
- Reprenez directement ce vocabulaire d’AU dans votre prompt de génération d’images
- Soumettez le résultat au même modèle de vision pour vérifier que le signal émotionnel est bien lu
- Itérez jusqu’à ce que le portrait généré obtienne la même évaluation émotionnelle que votre référence
Ce processus est plus lent qu’un prompt unique, mais la qualité du résultat est systématiquement supérieure.
Commencez à créer des portraits avec une profondeur émotionnelle
L’écart entre un visage techniquement juste et un visage émotionnellement convaincant est précisément là où se joue aujourd’hui le travail le plus intéressant dans le portrait par IA. La génération d’images photoréalistes a largement résolu les problèmes techniques. Le défi restant est l’authenticité émotionnelle, et c’est ce qui rend la recherche sur les expressions faciales directement pertinente pour quiconque travaille avec des portraits aujourd’hui.
PicassoIA vous donne accès aux deux facettes de ce problème. Des modèles dotés de capacités de vision, comme GPT-4o, Gemini 2.5 Flash et Claude Opus 4.7, vous permettent d’évaluer le contenu émotionnel de photos réelles avec une grande précision. Les outils de génération d’images vous permettent d’appliquer ces connaissances pour produire des portraits dotés de signatures émotionnelles spécifiques et intentionnelles.
Commencez par un visage qui vous intéresse. Soumettez-le à un modèle de vision et demandez une lecture émotionnelle détaillée. Utilisez ensuite ce que vous observez pour générer une image qui réussirait la même évaluation, avec la qualité émotionnelle exacte que vous aviez en tête. Les résultats sont systématiquement surprenants, et ils gagnent en netteté à chaque passage de la boucle.


