Comment garder des visages d’anime cohérents avec l’IA : arrêtez de perdre le look de votre personnage
La cohérence des visages d’anime est le défi le plus difficile de la création d’images par IA. Chaque nouvelle génération peut modifier les yeux, la forme du nez ou l’allure générale de votre personnage. Cet article détaille les modèles, les flux de travail et les stratégies de prompt précises qui gardent vos personnages d’anime identiques sur chaque image générée.
Garder le même visage d’anime sur plusieurs images générées par l’IA est vraiment difficile. Vous trouvez le look parfait pour votre personnage, vous enregistrez le prompt, et deux générations plus tard le nez a bougé, les yeux ont une autre forme et la mâchoire ne correspond plus. Cela arrive avec tous les générateurs d’images par IA, et cela arrive constamment avec les styles anime, car l’esthétique repose sur des proportions précises et subtiles que la moindre variation du processus de génération peut perturber.
La bonne nouvelle, c’est qu’il existe des méthodes, des modèles et des flux de travail précis qui résolvent ce problème. Pas parfaitement à chaque fois, mais de façon assez fiable pour constituer des bibliothèques de personnages cohérentes, avec des dizaines d’images dans des scènes et des tenues différentes, et le même visage reconnaissable du début à la fin.
Pourquoi les visages d’anime sont-ils si difficiles à garder cohérents ?
Le problème de l’aléatoire
Chaque génération d’image par IA intègre une part d’aléatoire au niveau de l’échantillonnage. Même avec le même prompt et le même modèle, un seed aléatoire différent produit un visage différent. Les styles anime amplifient ce problème, car de petites variations de proportions donnent des résultats radicalement différents. Un visage large de 5 % paraît être un tout autre personnage en style anime, alors que sur un portrait photoréaliste vous le remarqueriez à peine.
La plupart des modèles de diffusion échantillonnent à partir d’une distribution de probabilité couvrant des millions de configurations de visages possibles. Sans ancrage, vous puisez dans toute cette distribution à chaque fois. Les résultats sont imprévisibles par conception.
Pourquoi les prompts génériques échouent
Décrire votre personnage en texte ne suffit pas pour des visages cohérents. « Fille anime aux yeux bleus et aux cheveux argentés » génère une fille différente aux yeux bleus et aux cheveux argentés à chaque génération. Vous pouvez ajouter des termes plus descriptifs, « yeux en amande bleu cyan larges, arête du nez haute et fine, lèvres fines et définies, menton arrondi et doux », et le résultat dérive quand même, car le modèle interprète ces mots de façon probabiliste, sans reproduire un gabarit géométrique précis.
C’est pourquoi les solutions ci-dessous vont au-delà de la rédaction du prompt. Le texte est une contrainte faible pour les visages. Les images et les contrôles au niveau du modèle sont des contraintes fortes.
L’effet amplificateur du style anime
La photographie de portrait réaliste présente une variation naturelle que l’on accepte. De petites différences de nez sont perçues comme une variation humaine normale. En anime, cette même variation est perçue comme un personnage différent, car les visages d’anime sont définis par un ensemble précis de traits stylisés. Les conventions sont strictes : taille des yeux par rapport au visage, nez minimaliste, forme des lèvres, menton effilé. Dès que l’une de ces caractéristiques s’écarte légèrement, l’identité du personnage se brise.
Cela signifie que les solutions de cohérence qui fonctionnent bien pour les portraits réalistes échouent souvent pour l’anime. Il faut des approches conçues spécifiquement pour les tolérances plus serrées qu’exigent les styles anime.
Les 3 méthodes qui fonctionnent vraiment
Verrouillage du seed et ancrage du prompt
La méthode la plus simple : utilisez le même seed à chaque génération. Quand vous trouvez une génération qui vous plaît, notez son numéro de seed. Chaque génération suivante avec ce seed et ce prompt produira une géométrie faciale presque identique, même si les autres éléments, comme l’arrière-plan, la pose et l’éclairage, varient selon le reste de votre prompt.
Cela fonctionne pour des variations mineures : même scène sous un autre angle, même personnage sous un autre éclairage. Cela ne fonctionne plus quand vous changez nettement la pose ou ajoutez assez de nouveaux tokens au prompt pour que l’attention du modèle se déplace.
L’ancrage du prompt est l’approche complémentaire. Placez les tokens de description du visage au début de votre prompt et marquez-les avec un poids d’attention élevé si votre plateforme le permet. Beaucoup d’interfaces vous laissent utiliser la syntaxe (description:1.3) pour mettre en valeur des termes précis.
💡 Astuce : Enregistrez un modèle d’« ancre de visage » contenant les traits essentiels de votre personnage, dans cet ordre : couleur et forme des yeux d’abord, puis le nez, les lèvres et enfin la forme du visage. Commencez chaque nouvelle génération avec cette ancre exacte avant d’ajouter la description de la scène. Ne modifiez jamais un seul mot de l’ancre.
Référence de style avec IP-Adapter
IP-Adapter est une approche de contrôle qui vous permet de fournir une image existante comme référence de visage, en complément de votre prompt textuel. Le modèle utilise cette image pour contraindre la géométrie du visage, tout en suivant votre texte pour le reste de la composition. C’est nettement plus fiable que le seul prompt textuel pour la cohérence du visage.
Le flux de travail : générez une bonne version du visage de votre personnage, enregistrez-la comme image de référence, puis utilisez-la comme entrée IP-Adapter pour toutes les générations suivantes. La géométrie du nez, l’écartement des yeux et la forme du visage de votre personnage restent verrouillés sur la référence, pendant que votre texte contrôle la scène, la tenue et la pose.
L’avantage principal de la référence par image, c’est qu’elle travaille dans l’espace de la géométrie plutôt que dans l’espace sémantique. Votre texte décrit ce que les choses signifient. L’image de référence montre exactement à quoi ressemble le visage. Le modèle peut s’ancrer dans une géométrie visuelle beaucoup plus précisément que dans des descriptions en mots.
Modèles LoRA pour la cohérence des personnages
Les modèles LoRA (Low-Rank Adaptation) sont de petits fichiers de modèle entraînés sur des personnages ou des styles précis. Un LoRA de personnage entraîné sur 20 à 30 images de votre personnage peut reproduire son visage avec une grande précision, dans des scènes, des poses et des tenues variées.
C’est la méthode la plus puissante, mais aussi celle qui demande le plus de préparation. Il vous faut des images sources pour l’entraînement, ce qui signifie soit les générer vous-même au préalable avec la technique de verrouillage du seed décrite plus haut pour obtenir des images cohérentes, soit utiliser du matériel de référence existant.
Cela en vaut la peine pour tout personnage que vous générerez souvent. Une fois votre LoRA entraîné, vous obtenez une forte cohérence du visage avec un effort minimal à chaque génération.
Comparaison des approches de cohérence :
Méthode
Niveau de cohérence
Temps de préparation
Idéal pour
Verrouillage du seed
Faible à moyen
Aucun
Travail rapide en une seule session
Ancrage du prompt
Moyen
10 minutes
Toute plateforme, itération rapide
IP-Adapter / Flux Kontext
Élevé
5 minutes
Travail régulier sur un personnage
LoRA de personnage
Très élevé
1 à 2 heures
Projets de personnage à long terme
Les meilleurs modèles pour la cohérence des visages d’anime sur PicassoIA
Tous les modèles texte vers image ne gèrent pas la cohérence des visages d’anime de la même façon. Certains sont conçus spécifiquement pour ce problème.
Flux Kontext pour verrouiller le visage
Flux Kontext Face to Many fait partie des outils les plus efficaces pour ce problème précis. Il prend une image de visage de référence et s’en sert pour ancrer l’identité faciale sur plusieurs générations différentes. Vous fournissez le visage de votre personnage une seule fois, et le modèle le conserve quelle que soit la scène ou le style que vous indiquez.
Le modèle complémentaire, Flux Kontext Portrait Series, est spécialisé dans la cohérence des personnages au format portrait, avec un accent fort sur la préservation des repères faciaux. Les deux utilisent l’architecture Flux, qui gère les styles anime avec plus de précision que les anciens modèles basés sur Stable Diffusion.
Pour les résultats les plus rapides, Flux Kontext Fast livre des sorties cohérentes à une vitesse de génération plus élevée, utile quand vous devez parcourir rapidement de nombreuses variantes de scène sans attendre.
Proteus v0.3 pour les styles anime
Proteus v0.3 est conçu spécifiquement pour la génération d’images de personnages d’anime. Là où les modèles généralistes traitent le style anime comme un type de sortie parmi d’autres, Proteus est affiné pour lui, ce qui lui permet d’interpréter les conventions stylistiques des visages d’anime plus précisément que les modèles génériques.
Cela se traduit directement par une meilleure cohérence. Le modèle dispose d’une distribution plus resserrée des formes de visage possibles pour les personnages d’anime, ce qui signifie moins de dérive entre les générations, même sans contrôles de cohérence explicites. Associez-le au verrouillage du seed pour un flux de travail qui produit des résultats fiables sans aucune configuration de référence par image.
La version complémentaire, Proteus v0.2, vaut le détour si vous voulez un rendu un peu plus doux. Les deux versions conservent la cohérence du visage optimisée pour l’anime, qui fait de Proteus un choix solide pour le travail sur les personnages.
Dreamshaper XL pour des personnages cohérents
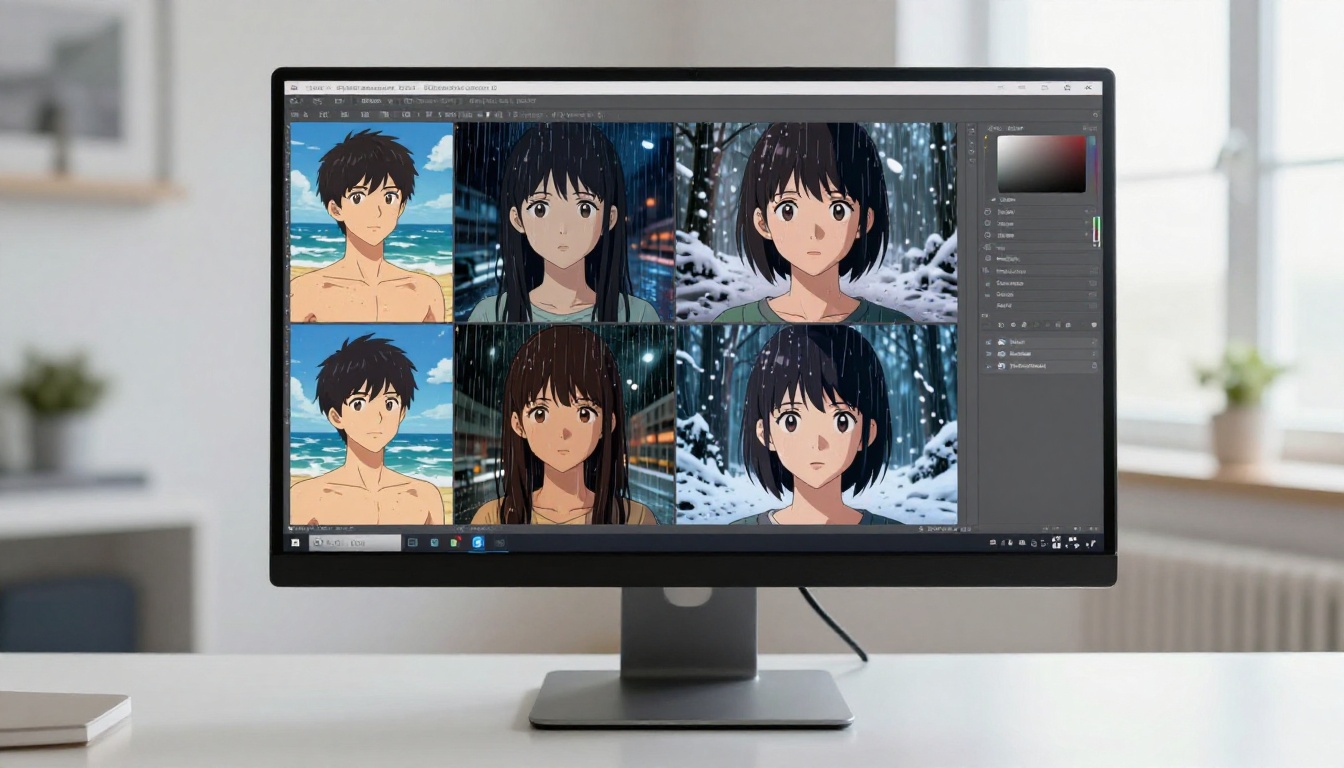
Dreamshaper XL Turbo gère bien les styles de personnages anime et semi-réalistes, avec une cohérence fiable des proportions du visage selon les prompts. Il est particulièrement efficace pour les personnages qui doivent fonctionner dans différentes ambiances visuelles : scènes lumineuses de jour, scènes nocturnes sombres, éclairage intérieur doux, en conservant le même visage à chaque fois.
Seedream pour l’anime haute fidélité
Seedream 4.5 de Bytedance produit des sorties anime nettes et détaillées, avec une bonne fidélité au prompt. C’est une option solide quand vous avez besoin d’une haute qualité d’image en plus de la cohérence, surtout pour des personnages dans des environnements détaillés où le visage et l’arrière-plan doivent tous deux rester lisibles.
Pour la sortie en plus haute résolution dans ce style, Seedream 5 Pro génère jusqu’en 2K et gère des compositions de scène complexes que d’autres modèles peinent à traiter, tout en préservant bien l’identité du personnage.
Krea 2 pour l’anime et les styles picturaux
Krea 2 Medium gère nativement les styles anime et picturaux et produit des visages cohérents, surtout lorsque vous partez d’une référence photographique. Cela ouvre un flux de travail utile : prenez ou trouvez une photographie avec la structure faciale voulue, utilisez une conversion photo vers anime, puis utilisez le résultat comme ancre de cohérence.
Le modèle Photo to Anime de Qwen Image Edit Plus convertit de vraies photographies en style anime tout en préservant la géométrie faciale sous-jacente. Vous obtenez ainsi un visage dont la cohérence photographique est intégrée, car il provient d’une photographie plutôt que d’une génération IA pure.
La démarche : partez d’une photographie d’un visage aux proportions souhaitées, convertissez-la en style anime, puis utilisez le résultat comme référence IP-Adapter. Le visage anime obtenu conservera l’ossature de la photographie d’origine, ce qui tend à être plus stable d’une génération à l’autre qu’un visage de départ entièrement généré par IA.
Comment utiliser Flux Kontext sur PicassoIA
PicassoIA propose Flux Kontext Face to Many directement sur la plateforme, vous n’avez donc besoin d’installer aucun outil local pour utiliser l’ancrage du visage par image.
Étape 1 : créez votre visage de référence
Générez un portrait solide et net de votre personnage avec le modèle de votre choix. Choisissez un angle de face ou de trois quarts où les traits du visage sont bien visibles. Évitez le flou de bougé important, les éclairages extrêmes qui masquent les traits, ainsi que les accessoires (lunettes de soleil, masques) qui cachent le visage.
Cette image devient votre ancre de référence. Chaque génération suivante l’utilisera.
💡 Astuce : Générez 4 à 5 variantes à cette étape et choisissez la meilleure comme référence. Cet investissement initial se rentabilise en cohérence sur toutes les générations suivantes. Générez-les toutes avec le même seed pour obtenir des points de départ similaires, puis retenez la version la plus fidèle à votre personnage.
Étape 2 : importez dans Flux Kontext Face to Many
Sur PicassoIA, ouvrez Flux Kontext Face to Many et importez votre image de visage de référence dans le champ prévu à cet effet. Le modèle lit la géométrie du visage à partir de cette image, et pas seulement le style visuel, ce qui fait son efficacité.
Rédigez la description de votre scène dans le champ du prompt. Concentrez-vous entièrement sur la scène, l’environnement, la pose et l’éclairage. Vous n’avez pas besoin de redécrire le visage, l’image de référence s’en charge.
A young woman standing in a rain-soaked Tokyo street at night,
neon signs reflecting in puddles, soft rain falling,
dark coat, three-quarter profile angle,
cinematic wide shot --ar 16:9
Étape 3 : itérez avec une identité verrouillée
Avec l’image de référence en place, vous pouvez générer le même personnage dans n’importe quel décor sans redécrire ses traits. Changez la scène. Changez la tenue. Changez l’éclairage. Changez l’angle de prise de vue. Le visage reste ancré à votre référence.
Si une génération présente une dérive du visage, régénérez cette image précise avec un paramètre de poids du visage légèrement plus élevé, si l’interface le propose, ou simplifiez votre prompt de scène pour réduire le nombre d’instructions concurrentes qui détournent l’attention du modèle du visage.
Augmenter la résolution sans casser le visage
Les visages d’anime générés en résolution standard perdent parfois des détails subtils qui rendent un personnage reconnaissable. L’upscaling peut corriger cela ou introduire de nouvelles distorsions, selon l’upscaler utilisé et la façon de l’appliquer.
La bonne approche d’upscaling préserve la géométrie du visage tout en ajoutant du détail, au lieu d’halluciner de nouveaux traits qui modifient la forme du visage.
Pour les visages d’anime en particulier, Crystal Upscaler est le choix le plus sûr. Il a été optimisé pour l’upscaling de portraits et gère les dégradés lisses de la peau et des cheveux en anime sans ajouter de texture indésirable ni modifier les proportions.
Si vous voulez une netteté maximale et la meilleure récupération des détails, Clarity Pro Upscaler ajoute une micro-texture qui rend les visages générés nettement plus finis, sans déformer la forme sous-jacente du visage.
Real ESRGAN est l’option gratuite et fonctionne bien pour un upscaling 4x sur des illustrations anime propres. Gardez une force de débruitage faible lors de l’upscaling de visages d’anime. Un débruitage élevé lissera les détails subtils de l’iris et la texture des lèvres, qui rendent un personnage reconnaissable de près.
4 erreurs qui brisent la cohérence du visage
Changer de modèle de base entre les générations
Les différents modèles ont des tendances internes différentes sur ce à quoi doivent ressembler les visages d’anime. Proteus v0.3 et Dreamshaper XL Turbo ont des profils esthétiques différents au niveau du modèle. Passer de l’un à l’autre au milieu d’une série produit presque à coup sûr un visage différent, même avec le même prompt et le même seed.
Choisissez un modèle par personnage et gardez-le pour toutes les générations de cette série.
Ajouter trop de nouveaux tokens
Chaque mot ajouté à un prompt entre en concurrence avec l’attention du modèle. Un prompt propre et resserré maintient le modèle concentré sur les traits de votre personnage. Un prompt long et touffu, plein de détails de scène, peut diluer l’effet d’ancrage du visage.
Gardez des descriptions de scène ciblées. Plutôt que de décrire chaque élément de l’arrière-plan, nommez seulement les deux ou trois plus importants. Laissez le reste aux tendances naturelles du modèle pour ce style.
Négliger le poids du visage dans IP-Adapter
Lorsque vous utilisez une référence par image (comme avec Flux Kontext Face to Many), le paramètre de poids du visage contrôle la force avec laquelle l’image de référence influence le résultat par rapport au prompt textuel. Une valeur trop basse laisse le texte dominer et le visage dérive. Une valeur trop haute peut rendre le personnage identique sur toutes les images, en perdant la variation naturelle.
Le juste milieu se situe généralement entre 0,6 et 0,8. Commencez à 0,7 et ajustez ensuite selon les résultats.
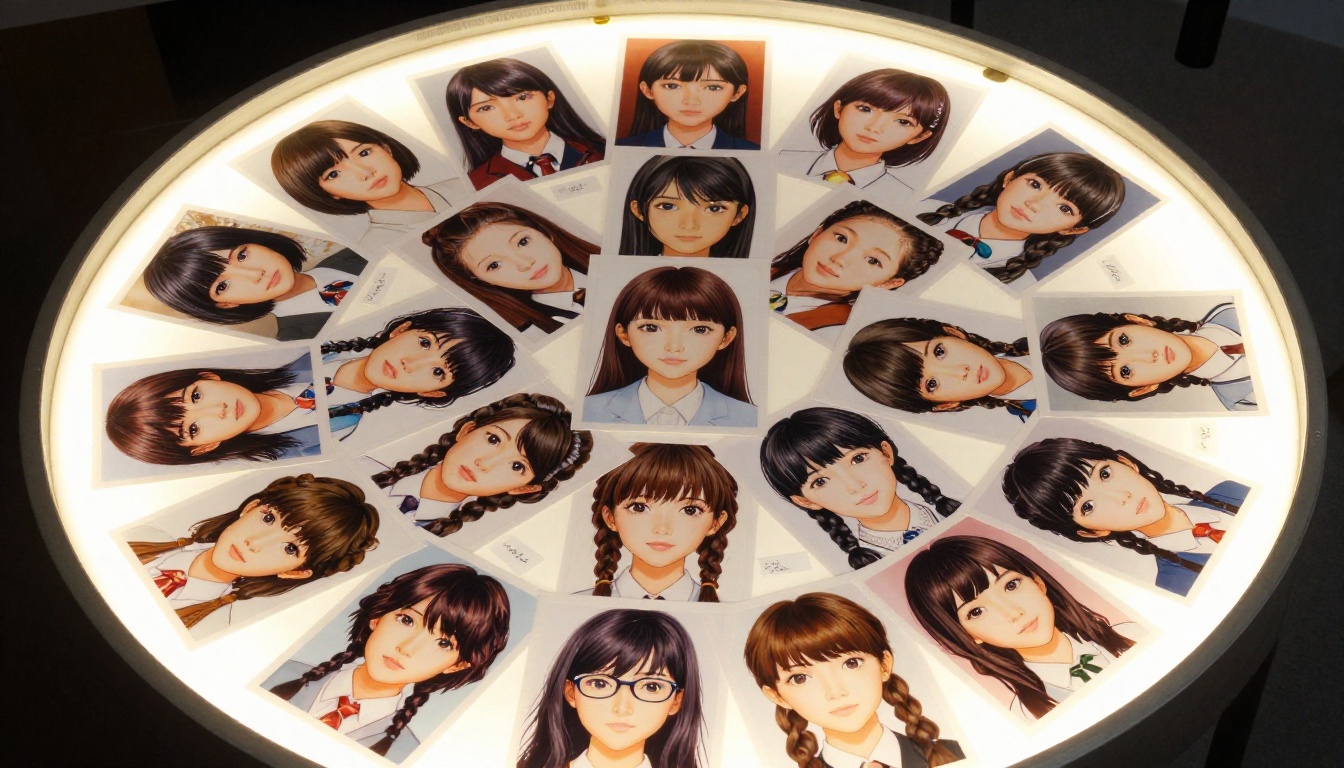
Ne pas constituer d’abord une planche de référence
Beaucoup d’artistes se lancent directement dans la génération de scènes variées sans avoir d’abord créé un ensemble solide d’images de référence sous plusieurs angles. Cela pose des problèmes quand vous avez besoin d’un angle précis qui ne correspond pas à vos références existantes.
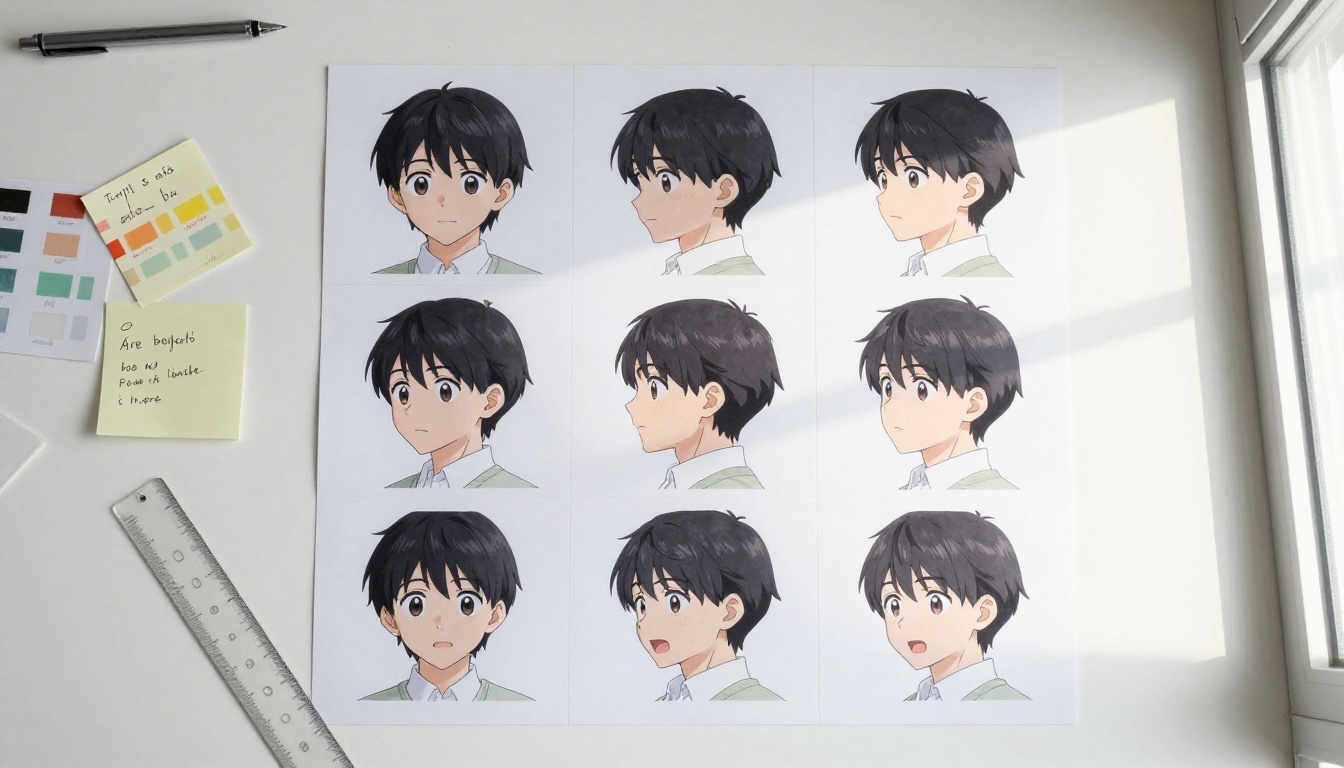
Avant de générer des scènes ou des images narratives, créez une planche de référence du personnage : visage de face, trois quarts gauche, trois quarts droit et gros plan sur les yeux. Conservez ces quatre images. Elles deviendront vos ressources d’ancrage pour chaque génération suivante.
5 conseils pratiques pour de meilleurs résultats
Au-delà des méthodes et du choix des modèles, cinq éléments améliorent systématiquement la cohérence des visages d’anime, quelle que soit l’approche que vous utilisez.
1. Donnez un nom à votre personnage dans le prompt. Attribuez un nom à votre personnage et incluez-le dans chaque prompt. Cela semble anodin, mais cela aide le modèle à associer toutes vos générations à un seul concept d’identité. « Yuki, une jeune femme aux... » donne de meilleurs résultats pour la cohérence qu’une description sans nom, qui change de sens d’une génération à l’autre.
2. Utilisez les prompts négatifs sans modération. Incluez toujours des prompts négatifs qui écartent les distorsions courantes du visage : different face, face change, deformed face, asymmetrical eyes, uneven features. Ils ne corrigent pas la cohérence, mais ils réduisent nettement la fréquence des échecs évidents.
3. Générez par lots et filtrez. Au lieu de générer une image à la fois et de l’accepter telle quelle, générez 4 images d’un coup et choisissez la plus cohérente. La meilleure parmi 4 est presque toujours meilleure que n’importe quelle génération isolée.
4. Gardez un éclairage cohérent tout au long de votre série. Le même personnage paraît être une autre personne sous un éclairage radicalement différent. Si vous voulez que le public reconnaisse le même personnage d’une image à l’autre, gardez une direction et une qualité de lumière similaires tout au long de la série. C’est un choix de direction artistique plutôt que technique, mais il compte autant que n’importe laquelle des approches techniques.
5. Lancez l’upscaling une fois satisfait du visage. N’upscalez pas les versions intermédiaires. Upscalez seulement l’image finale que vous avez choisie, après avoir vérifié que le visage est correct à la résolution d’origine. L’upscaling introduit de petits changements qui peuvent faire sortir un visage à peine cohérent de votre marge acceptable.
💡 Flux de travail avancé : Générez à la résolution d’origine avec des contrôles de cohérence stricts, sélectionnez le meilleur résultat, puis appliquez Crystal Upscaler uniquement à l’image retenue. Ce processus en deux étapes vous donne à la fois le contrôle de la cohérence et la qualité finale de l’image.
Construisez dès maintenant votre bibliothèque de personnages cohérents
La cohérence du visage est un problème solvable. Les bons outils, le bon flux de travail et une seule image de référence solide suffisent pour commencer à construire un personnage reconnaissable et reproductible.
PicassoIA réunit tout sur une seule plateforme : Flux Kontext Face to Many pour le verrouillage du visage par ancrage d’image, Proteus v0.3 et Dreamshaper XL Turbo pour des sorties anime cohérentes, Crystal Upscaler pour la netteté sans déformer le visage de votre personnage, et plus de 90 autres modèles texte vers image pour toutes les directions esthétiques que vous voulez explorer.
Le moyen le plus rapide de commencer : générez un portrait de référence net de votre personnage avec Seedream 4.5 ou Proteus v0.3, puis importez-le dans Flux Kontext Face to Many pour votre première génération avec une scène différente. La différence avec un prompt uniquement textuel est visible dès le tout premier résultat.
Vos personnages peuvent rester cohérents sur chaque image que vous créez. Plus de 91 modèles texte vers image sont disponibles sur picassoia.com/en/all-models.