La plupart des vidéos IA se trahissent dans les deux premières secondes. Le mouvement saccade, la lumière ne tombe jamais tout à fait juste et les objets dérivent au lieu de bouger. Les spectateurs le remarquent même s’ils ne savent pas l’expliquer. Si vos clips semblent proches du réel sans vraiment y ressembler, le problème ne vient généralement pas du modèle : il tient aux entrées, à la structure du prompt et à ce qui se passe une fois la génération terminée.
Pourquoi les vidéos IA paraissent fausses
Le système visuel humain est extraordinairement doué pour détecter les anomalies de mouvement. Nous passons toute notre vie à observer une physique réelle : la façon dont un tissu résiste avant de bouger, la manière dont une ombre se déplace quand un sujet tourne, les micro-tremblements d’une caméra tenue à la main. Les modèles de vidéo IA apprennent à approximer ces schémas, mais sans un prompt soigneux et une post-production adaptée, ils produisent des résultats statistiquement plausibles et perceptivement faux.
Le problème du mouvement
Le signe le plus révélateur d’une vidéo IA reste le mouvement non naturel. Les objets bougent soit trop doucement, soit trop uniformément, soit dans des directions qui ne respectent ni la gravité ni l’inertie. Le mouvement réel est désordonné : les cheveux s’accrochent, les vêtements se froissent, les mains dépassent leur cible puis corrigent. Quand on retire tout cela au profit d’un mouvement continu et propre, le résultat paraît aussitôt synthétique.
La solution ne tient pas toujours au modèle. Elle tient à ce que vous lui demandez de faire. Les prompts qui décrivent des actions précises, guidées par la physique, donnent de meilleurs résultats que les prompts vagues. Comparez :
- Faible : « une femme marche dans la rue »
- Efficace : « une femme fait de petits pas rapides sur un trottoir mouillé, légère inclinaison vers l’avant, les pans de son manteau se balançant à chaque pas, les épaules tournant naturellement avec le balancement des bras »
La seconde version impose au modèle assez de contraintes pour produire un mouvement ancré dans la physique réelle, plutôt qu’un flou de mouvement moyen.
Le piège de l’éclairage
Les modèles d’IA adoptent par défaut un éclairage uniforme, flatteur, de qualité studio, parce que c’est ce que récompensent le plus souvent les données d’entraînement. Les images réelles ne ressemblent pas à cela. Elles présentent des zones trop éclairées, des ombres profondes, une lumière rebondie teintée par les surfaces voisines et une exposition irrégulière d’un bout à l’autre du cadre.
Lorsque vous précisez les conditions d’éclairage, par exemple « lumière diffuse par temps couvert venant du haut, légère dominante froide, aucun reflet spéculaire sur la peau », ou « une seule source tungstène pratique à droite de la caméra, chute d’ombre marquée, couleur chaude à 3200K », vous éloignez le modèle de ses réglages par défaut sûrs et vous le rapprochez d’un rendu qui paraît capturé plutôt que généré.
La précision du prompt change tout
Les prompts vagues donnent des vidéos vagues. Les modèles qui produisent les séquences les plus réalistes, notamment Seedance 2.0, Veo 3 et Kling v3 Video, réagissent tous fortement à la précision. Un prompt de 40 mots donnera un résultat nettement différent d’un prompt de 15 mots, même pour un sujet général identique.
💡 Traitez votre prompt comme un plan de tournage. Décrivez le sujet, l’action, la position de la caméra, le comportement de l’objectif, la source de lumière, l’atmosphère et tout mouvement secondaire présent dans la scène.
Écrire des prompts pour la vidéo IA est fondamentalement différent d’écrire des prompts pour l’image IA. Une image est statique : le modèle n’a qu’une seule image à réussir. La vidéo exige un mouvement cohérent sur de nombreuses images. Chaque élément du prompt doit donc décrire quelque chose qui peut bouger de manière physiquement plausible.
Décrire la physique, pas seulement le visuel
Les prompts vidéo les plus efficaces précisent les forces qui agissent sur la scène, et pas seulement son apparence. S’il y a du vent, écrivez « vent venant de la gauche, faisant bouger les cheveux et les tissus légers ». Si c’est de l’eau, décrivez le comportement de la surface : « légères ondulations avec de petits reflets brillants, sans écume ». Si une personne est immobile, dites-le explicitement : « personnage debout, poids légèrement reporté sur le pied gauche, léger mouvement de la poitrine lié à la respiration ».
Cette approche limite l’espace de génération et force le modèle à produire une physique cohérente plutôt qu’un mouvement plausible mais aléatoire.
Un langage cinématographique qui fonctionne
Emprunter le vocabulaire de la vraie cinématographie améliore nettement les résultats. Ces termes sont présents dans les données d’entraînement issues de films réels :
| Terme | Ce qu’il produit |
|---|
slow dolly-in | Mouvement de caméra avant fluide, paraît ancré |
shallow depth of field | Flou d’arrière-plan qui ressemble à une optique réelle |
handheld with slight shake | Instabilité organique qui signale l’authenticité |
rack focus from foreground to subject | Changement de netteté séquentiel, très cinéma |
natural lens flare | Imperfection optique qui renforce le réalisme |
anamorphic bokeh | Flou d’arrière-plan ovale propre aux objectifs de cinéma |
Des modèles comme Wan 2.7 T2V et LTX 2.3 Pro répondent particulièrement bien à la terminologie cinématographique, car ils ont été entraînés sur des références de films de haute qualité.
Choisir le bon modèle
Tous les modèles de vidéo IA ne se valent pas. Chacun a des points forts différents en matière de réalisme. Choisir le mauvais modèle pour le type de scène est l’une des erreurs les plus fréquentes.
Les meilleurs modèles pour un mouvement naturel
Seedance 2.0 de ByteDance produit l’un des mouvements les plus ancrés dans la physique disponibles. Il gère mieux que la plupart des alternatives le mouvement humain, la dynamique des tissus et les surfaces fluides. Il intègre aussi un audio synchronisé, ce qui évite l’étape de synchronisation audio en post-production.
Kling v3 Video et Kling v2.6 sont de bons choix lorsqu’il faut un mouvement de personnages en 1080p. Le modèle de mouvement de Kling gère bien la marche, les gestes et l’interaction avec les objets, sans l’artefact « flottant » typique de l’IA.
Wan 2.7 I2V est excellent pour animer des photographies fixes. Partir d’une vraie photo comme première image ancre la palette de couleurs, l’éclairage et les proportions du sujet, ce qui donne une impression de séquence captée plutôt que de contenu généré.
Hunyuan Video de Tencent offre une forte cohérence temporelle d’une image à l’autre, réduisant le scintillement et les déformations qui nuisent au réalisme dans les séquences plus longues.
Les meilleurs modèles pour la justesse de l’éclairage
Veo 3 et Veo 3.1 de Google produisent la lumière la plus photoréaliste de tous les modèles actuels. La lumière se comporte comme une vraie lumière : elle rebondit, projette des ombres douces et change de couleur lorsqu’elle se reflète sur des surfaces colorées. Si la justesse de l’éclairage est votre priorité, Veo 3 est aujourd’hui la référence.
Hailuo 02 de Minimax gère bien les éclairages à fort contraste, ce qui en fait une option solide pour les scènes dramatiques aux ombres marquées et aux sources de lumière directionnelles.
LTX 2 Pro génère en résolution 4K, ce qui préserve le détail de l’éclairage à un niveau qui tient à l’examen de près. Si vous destinez votre vidéo à de grands écrans, partir d’une source 4K élimine les artefacts de compression qui trahissent la génération par IA.
💡 Règle de sélection rapide : pour le mouvement humain, utilisez Seedance 2.0 ou Kling. Pour les plans d’environnement et la qualité de l’éclairage, utilisez Veo 3 ou LTX 2 Pro. Pour animer des images fixes, utilisez Wan 2.7 I2V.
Image vers vidéo ou texte vers vidéo
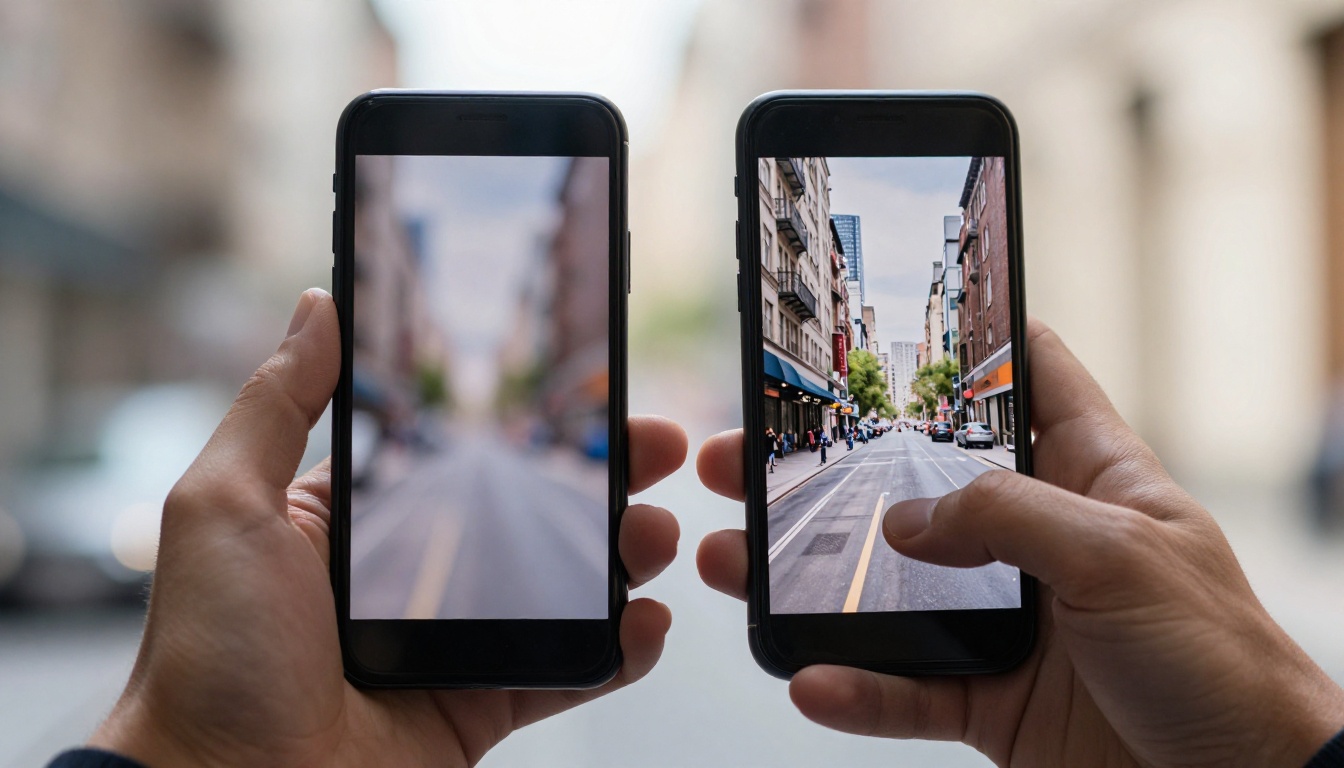
Le choix entre partir d’un texte ou partir d’une image influe sur le réalisme plus que la plupart des gens ne l’imaginent.
Quand partir d’une image
Le texte vers vidéo donne au modèle une liberté créative totale, ce qui joue souvent contre le réalisme. Le modèle doit tout inventer : l’apparence du sujet, l’éclairage, l’environnement, les textures. De petites incohérences dans l’un de ces éléments créent l’effet de vallée de l’étrange.
L’image vers vidéo ancre la génération. Lorsque le modèle dispose d’une image de référence, il préserve les couleurs, les textures et les proportions établies pendant toute la durée de la vidéo. Le résultat donne l’impression que quelqu’un a appuyé sur enregistrer avec une caméra pointée vers une scène réelle, plutôt que quelque chose inventé par un logiciel.
Pour un réalisme maximal, générez ou trouvez une photographie de haute qualité qui correspond à la scène souhaitée, puis transmettez-la à Wan 2.7 I2V, Kling v2.1 ou Ray 2 720p comme image source.
Bien réussir la première image
La première image détermine le plafond de réalisme de la vidéo entière. Si l’image source présente des artefacts d’IA, un éclairage plat ou une perspective incohérente, la vidéo héritera de tous ces problèmes et les amplifiera. Avant d’utiliser une image comme source d’animation, vérifiez :
- La direction de l’éclairage est cohérente pour tous les objets du cadre
- Les ombres existent et pointent dans la bonne direction par rapport à la source de lumière
- Les textures présentent un bruit et un grain appropriés, et non le lissage typique de l’IA
- L’image a été générée ou rendue avec une largeur d’au moins 1024 px
💡 Astuce : utilisez une vraie photographie comme image source chaque fois que c’est possible. Même une photo prise avec un smartphone et correspondant à la scène visée donnera un résultat plus réaliste qu’une source générée par IA.
Post-production pour plus de réalisme
Générer une vidéo IA réaliste ne représente que la moitié du travail. La post-production permet de combler l’écart entre « impressionnant » et « indiscernable ».
Augmenter la résolution de votre rendu
La plupart des modèles de vidéo IA génèrent par défaut en 480p ou 720p. À ces résolutions, les artefacts de compression sont visibles, et le résultat paraît généré par IA lorsqu’il est affiché sur un écran 1080p ou 4K. L’upscaling avec un modèle vidéo dédié règle ce problème.
Crystal Video Upscaler et Video Upscale by Topaz Labs gèrent bien l’upscaling vidéo par IA. Ils ne se contentent pas de redimensionner : ils restaurent les détails fins, réduisent le scintillement temporel et ajoutent la structure de grain qu’une séquence haute résolution possède naturellement. Upscale v1 by Runway est une autre option solide, qui traite les clips rapidement tout en préservant la fidélité du mouvement.
Video Increase Resolution by Bria va plus loin, en prenant en charge l’upscaling jusqu’à 8K, ce qui laisse de la marge pour le recadrage et la recomposition sans perte de qualité visible.
Ajouter un audio synchronisé
Le silence ou un fond sonore générique tuent instantanément le réalisme. Les vraies vidéos comportent un son d’ambiance : vent, circulation, pas, respiration, frottement des tissus. La synchronisation entre les événements visuels et les indices sonores est un élément que la perception humaine vérifie automatiquement.
MMAudio génère des pistes audio tenant compte du contexte et correspondant au contenu visuel du clip. Il analyse la vidéo et produit des effets sonores synchronisés avec ce qui se passe à l’écran. Pour les scènes d’environnement, cette seule étape peut faire passer le résultat de « clairement IA » à « plausiblement réel ».
Thinksound est une autre option solide pour ajouter des couches de son d’ambiance réalistes à une vidéo générée.
Montage et retouche
Une fois votre clip généré et upscalé, Wan 2.7 VideoEdit permet de modifier par texte des sections précises sans régénérer l’ensemble du clip. Si une image présente un artefact ou si le mouvement d’un passage paraît faux, vous pouvez cibler cette section et la revoir tout en conservant le reste intact.
Gen 4.5 de Runway gère aussi efficacement la retouche vidéo ciblée, en particulier pour restyler des éléments visuels précis tout en maintenant la cohérence temporelle des images voisines.
PicassoIA donne accès à plus de 87 modèles de texte vers vidéo ainsi qu’à une suite complète d’outils de montage et de retouche vidéo, réunis en un seul endroit. Le flux de travail pour produire une vidéo IA réaliste sur la plateforme suit une séquence constante.
Flux de travail étape par étape
Étape 1 : choisissez votre méthode de génération. Décidez si vous générez à partir d’un texte ou si vous animez une image. Si vous disposez d’une photographie source solide, partez de l’image vers la vidéo pour gagner immédiatement en réalisme.
Étape 2 : rédigez un prompt détaillé. Appliquez le langage cinématographique présenté plus haut dans cet article. Décrivez la physique du mouvement, la direction de la lumière, le comportement de la caméra et le mouvement secondaire. Visez au minimum 40 à 60 mots.
Étape 3 : sélectionnez le modèle. Pour des sujets humains au mouvement naturel, commencez par Seedance 2.0. Pour les plans d’environnement et de paysage, essayez Veo 3.1 Fast. Pour des scènes cinématographiques en 1080p centrées sur un personnage, Kling v3 Video est un bon choix.
Étape 4 : vérifiez et augmentez la résolution. Après la génération, passez le résultat dans Crystal Video Upscaler ou Topaz Video Upscale.
Étape 5 : ajoutez le son. Utilisez MMAudio pour générer un son d’ambiance synchronisé avec le contenu visuel.
Étape 6 : corrigez les passages problématiques. Si des images ou des segments précis présentent des artefacts, utilisez Wan 2.7 VideoEdit pour revoir ces zones sans régénérer l’ensemble du clip.
Quels modèles choisir en premier
Si vous débutez dans le réalisme de la vidéo IA, cette liste hiérarchisée vous aide à y voir clair :
- Meilleur choix global pour le réalisme : Seedance 2.0 (mouvement et audio intégré)
- Meilleur pour la justesse de l’éclairage : Veo 3
- Meilleur pour animer une image fixe : Wan 2.7 I2V
- Meilleur pour la sortie en 4K : LTX 2 Pro ou LTX 2.3 Pro
- Meilleur pour le mouvement de personnages en 1080p : Kling v3 Video
3 erreurs qui ruinent le réalisme
Trop détailler le mouvement dans le prompt
Demander trop d’éléments en mouvement à la fois produit un mouvement chaotique et invraisemblable. Si tout bouge simultanément, la physique devient incohérente. Concentrez chaque scène sur un ou deux éléments de mouvement principaux. Les éléments secondaires, comme le vent de fond ou les mouvements de foule, peuvent être précisés, mais ils ne doivent pas rivaliser avec l’action principale pour l’attention du modèle.
Ignorer le format
La plupart des images réalistes sont en 16:9 ou plus larges. Générer en 9:16 (vertical) puis convertir crée des bandes noires latérales ou des étirements qui trahissent un traitement et réduisent l’impression de prise de vue réelle. Adaptez le format de sortie à la plateforme visée dès le départ. Pour un réalisme cinématographique, le 16:9 ou l’anamorphique 2,39:1 paraît le plus authentique.
Négliger la post-production
Un rendu brut de vidéo IA est rarement aussi convaincant que le même clip après upscaling, étalonnage et ajout de son. L’étape de génération est la fondation, pas le produit fini. Tout modèle, aussi performant soit-il, produit des résultats qui gagnent à subir au moins une passe de post-production. Sauter cette étape laisse inexploité un potentiel de réalisme important.
💡 Le minimum de post-production : upscaler en 1080p ou plus, étalonner vers un contraste et une saturation de type cinéma, ajouter un son d’ambiance adapté à la scène. Ces trois étapes suffisent à combler l’essentiel de l’écart entre une vidéo générée par IA et une séquence authentique.
Créez vos propres vidéos IA réalistes
Une vidéo IA réaliste ne relève ni de la chance ni de l’attente d’une amélioration des modèles. C’est un savoir-faire aux règles apprenables : rédiger des prompts guidés par la physique, choisir des modèles adaptés au type de scène, ancrer les générations dans des images réelles lorsque c’est possible et investir dans la post-production. L’écart entre une vidéo IA moyenne et une vidéo qui résiste à l’examen tient presque toujours à ces choix, et non au modèle sous-jacent.
PicassoIA vous donne accès à tous les grands modèles vidéo, ainsi qu’aux outils d’upscaling, de montage et de son nécessaires pour mener une génération brute jusqu’à un contenu fini. Qu’il s’agisse de contenus courts pour les réseaux sociaux, de démonstrations de produits ou de séquences cinématographiques, le flux de travail complet, du prompt au résultat soigné, tient sur une seule plateforme.
Commencez avec Seedance 2.0 pour votre première tentative, appliquez la structure de prompt de cet article et constatez la différence que fait la précision. Lorsque vous voudrez aller plus loin, essayez Veo 3 pour les scènes où l’éclairage est déterminant, ou Wan 2.7 I2V pour animer vos propres photographies en clips cinématographiques.
Tous les modèles sont disponibles sur picassoia.com/en/all-models.


