Transformer une photographie plane en actif spatial en trois dimensions exigeait autrefois un dispositif de numérisation 3D dédié, des logiciels spécialisés et des heures de retouche manuelle. L’IA a considérablement réduit ce flux de travail. Aujourd’hui, une seule photo prise avec un smartphone peut alimenter un pipeline d’IA et donner une carte de profondeur texturée, un maillage reconstruit ou une image riche en volume qui se lit comme un objet spatial. Cet article présente les méthodes réelles, les outils concrets et les étapes précises qui produisent des résultats exploitables.
Ce que fait réellement la conversion photo vers 3D par l’IA
Avant de choisir un outil, il est utile de comprendre ce qui se passe dans le processus. « Photo vers 3D » est un raccourci qui désigne plusieurs opérations très différentes, qui produisent des types de résultats différents.
Estimation de profondeur ou reconstruction complète
L’estimation de profondeur est la plus simple des deux. L’IA analyse une seule image et attribue une valeur de profondeur à chaque pixel, généralement représentée sous forme de carte de profondeur en niveaux de gris, où les pixels blancs sont les plus proches et les pixels noirs les plus éloignés. Elle ne produit pas un maillage que vous pouvez faire pivoter dans un logiciel de CAO. Elle produit une interprétation spatiale de la photographie, que d’autres outils peuvent exploiter.
La reconstruction 3D complète va plus loin. À partir de suffisamment de photographies d’un objet prises sous plusieurs angles, l’IA les assemble en un nuage de points, puis construit un maillage polygonal texturé. C’est plus proche de ce que la plupart des gens imaginent lorsqu’ils entendent « modèle 3D à partir d’une photo », et c’est la base des flux de travail utilisés en design de produits, en développement de jeux et en effets visuels de cinéma.
Les données derrière chaque modèle
Les modèles d’IA qui gèrent ces tâches sont entraînés sur des millions de paires d’images : des photographies accompagnées de données de profondeur correspondantes ou de numérisations 3D. À partir de cet entraînement, ils développent une compréhension statistique de la manière dont les objets du monde physique s’éloignent dans l’espace, de la façon dont la lumière se comporte sur différentes surfaces, et de la manière dont les parties visibles d’un objet suggèrent la forme de ses faces cachées.
💡 Astuce : La qualité du résultat de l’IA dépend fortement de la qualité de vos photos d’entrée. Un éclairage homogène, une mise au point nette et une couverture complète du sujet ne sont pas facultatifs.
Les deux principaux flux de travail
Il existe deux grandes façons d’aborder la conversion photo vers 3D par l’IA, adaptées à des situations différentes.
Photogrammétrie : beaucoup de photos, un seul objet
La photogrammétrie est la modélisation 3D basée sur l’image, dans sa forme la plus fiable. Vous photographiez le même objet sous des dizaines d’angles, en veillant à ce que deux prises successives se chevauchent d’au moins 60 à 70 %. Un logiciel dédié identifie ensuite les éléments correspondants sur toutes les images, calcule la position de la caméra pour chaque prise et reconstruit l’objet en trois dimensions.
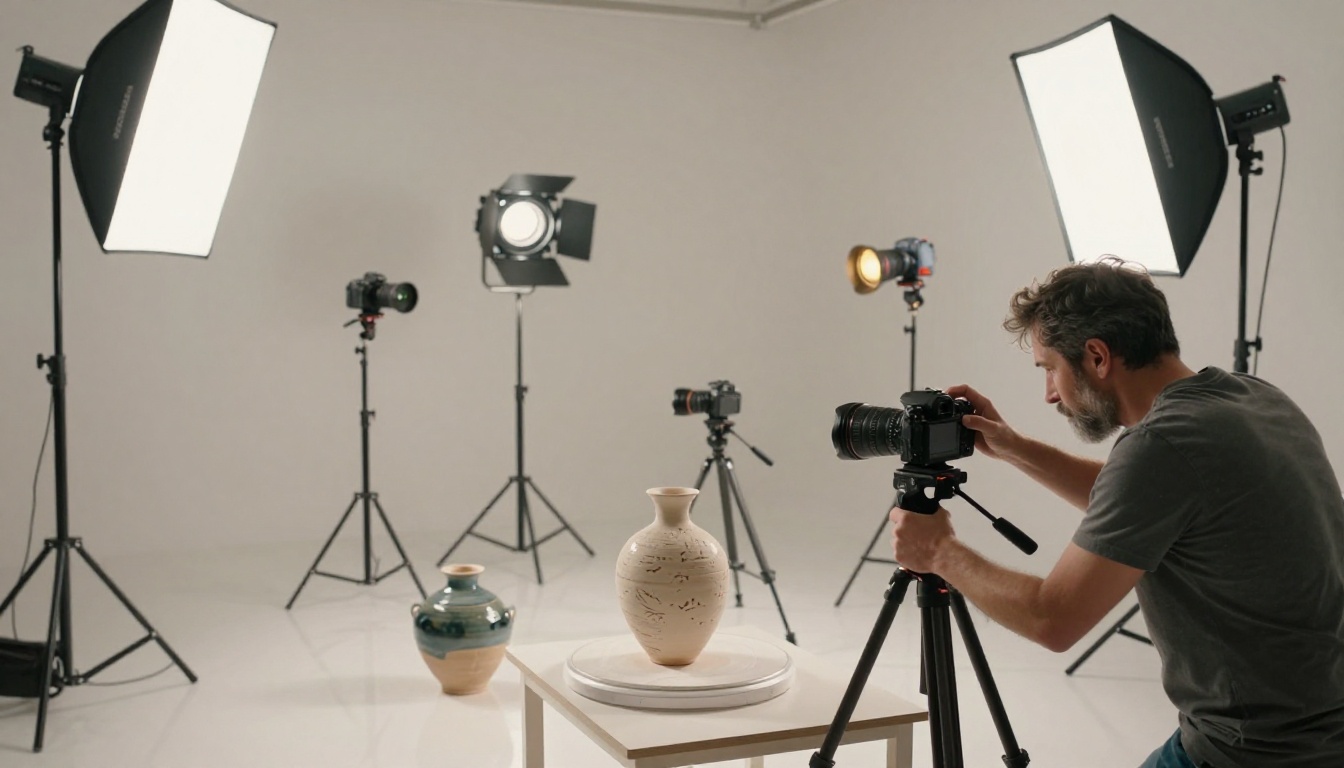
Ce dont vous avez besoin pour la photogrammétrie :
- Au minimum 30 à 50 photos pour un objet simple
- Un éclairage homogène et diffus, sans ombres marquées
- Un tour complet à trois niveaux de hauteur : au niveau des yeux, à 45 degrés vers le bas et en vue du dessus
- Un fond uni ou un plateau tournant pour isoler le sujet
- Une mise au point nette sur le sujet dans chacune des prises
Cette méthode fonctionne bien pour les objets présentant une texture visible, car l’IA a besoin d’éléments de surface pour calculer les correspondances entre les images. Les objets très réfléchissants ou transparents sont réputés difficiles, car leur apparence change à chaque angle.
Approches neuronales : une photo, l’IA complète le reste
Les approches plus récentes, fondées sur les champs de radiance neuronaux et les modèles de diffusion, peuvent déduire une structure 3D à partir d’une seule photographie ou de quelques-unes seulement. Au lieu de calculer la géométrie à partir de pixels correspondants sur plusieurs images, le modèle neuronal s’appuie sur ses données d’entraînement pour émettre une hypothèse sur l’apparence des parties non visibles de l’objet.
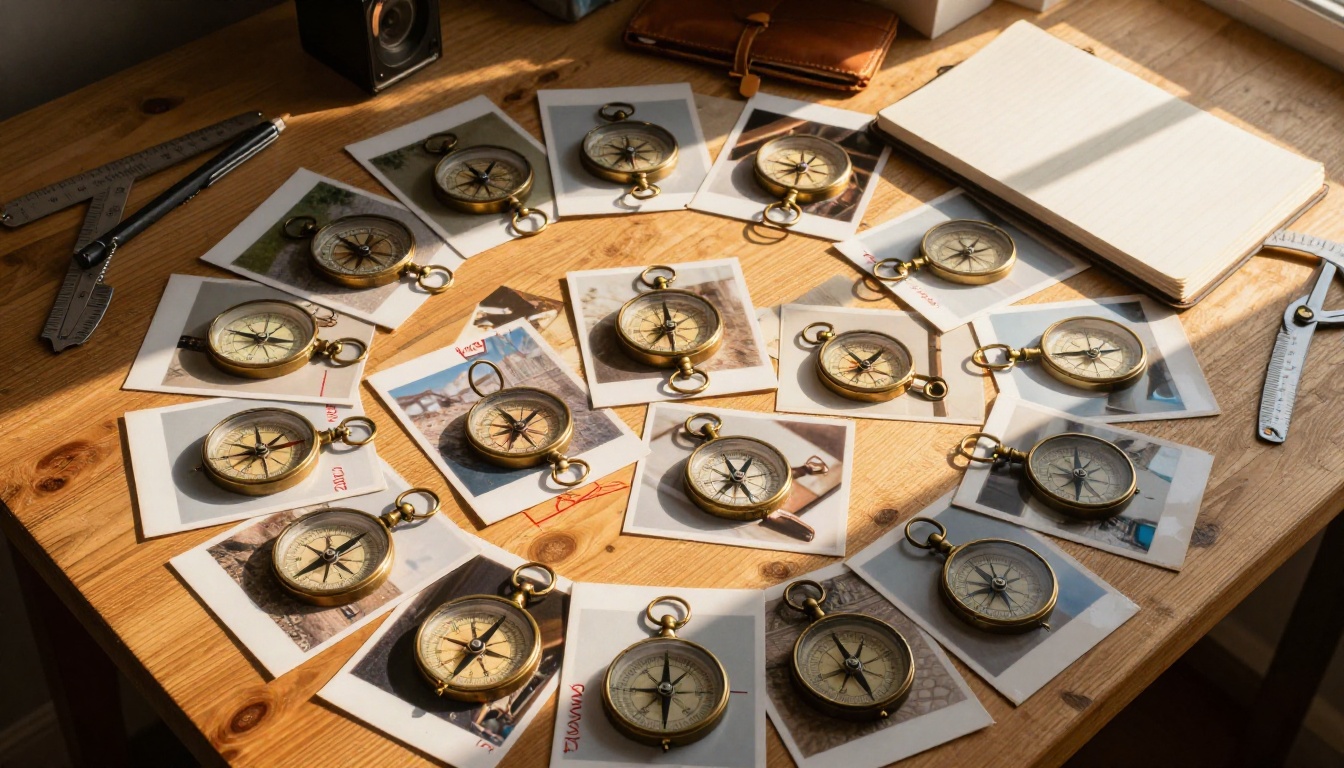
Les méthodes à image unique produisent des résultats plausibles, et non définitifs. L’IA fait des suppositions éclairées sur le dos de l’objet, à partir de schémas statistiques issus des données d’entraînement. Pour de nombreuses applications créatives, cela est tout à fait acceptable. Pour l’ingénierie, la fabrication ou tout ce qui exige une précision dimensionnelle, la photogrammétrie multi-images reste la voie la plus fiable.
| Méthode | Photos requises | Type de résultat | Idéal pour |
|---|
| Photogrammétrie | 30-200 | Maillage texturé | Produits, objets, espaces |
| NeRF/Diffusion | 1-10 | Carte de profondeur, vues inédites | Actifs créatifs, travail de concept |
| Estimation de profondeur | 1 | Carte de profondeur uniquement | Post-traitement, vidéo en parallaxe |
| img2img IA | 1 | Image re-rendue | Narration visuelle, maquettes de design |
Prendre des photos pour de meilleurs résultats
Quel que soit le flux de travail IA utilisé, ce que vous fournissez détermine ce que vous obtenez. Une prise de vue bâclée produit des reconstructions avec des trous, des artefacts et du bruit de surface que nul traitement d’IA ne peut corriger.
Recouvrement et couverture
Pour la photogrammétrie, prenez les photos en trois anneaux horizontaux autour du sujet. Premier anneau au niveau des yeux, deuxième à 45 degrés vers le bas, troisième directement par-dessus. Dans chaque anneau, déplacez-vous par petits incréments afin que deux photos consécutives partagent au moins les deux tiers de leur contenu. Une couverture précipitée ou lacunaire empêche l’IA de trianguler correctement, et le maillage obtenu présentera des trous.
Un éclairage adapté à l’IA
Un éclairage plat et uniforme est idéal pour la photogrammétrie. Les ombres marquées créent des incohérences entre les prises, car leur motif se déplace à mesure que vous tournez autour du sujet. Un ciel couvert convient parfaitement aux sujets en extérieur. En studio, de grandes sources lumineuses diffusées depuis plusieurs directions suppriment les ombres profondes qui perturbent les algorithmes de reconstruction.
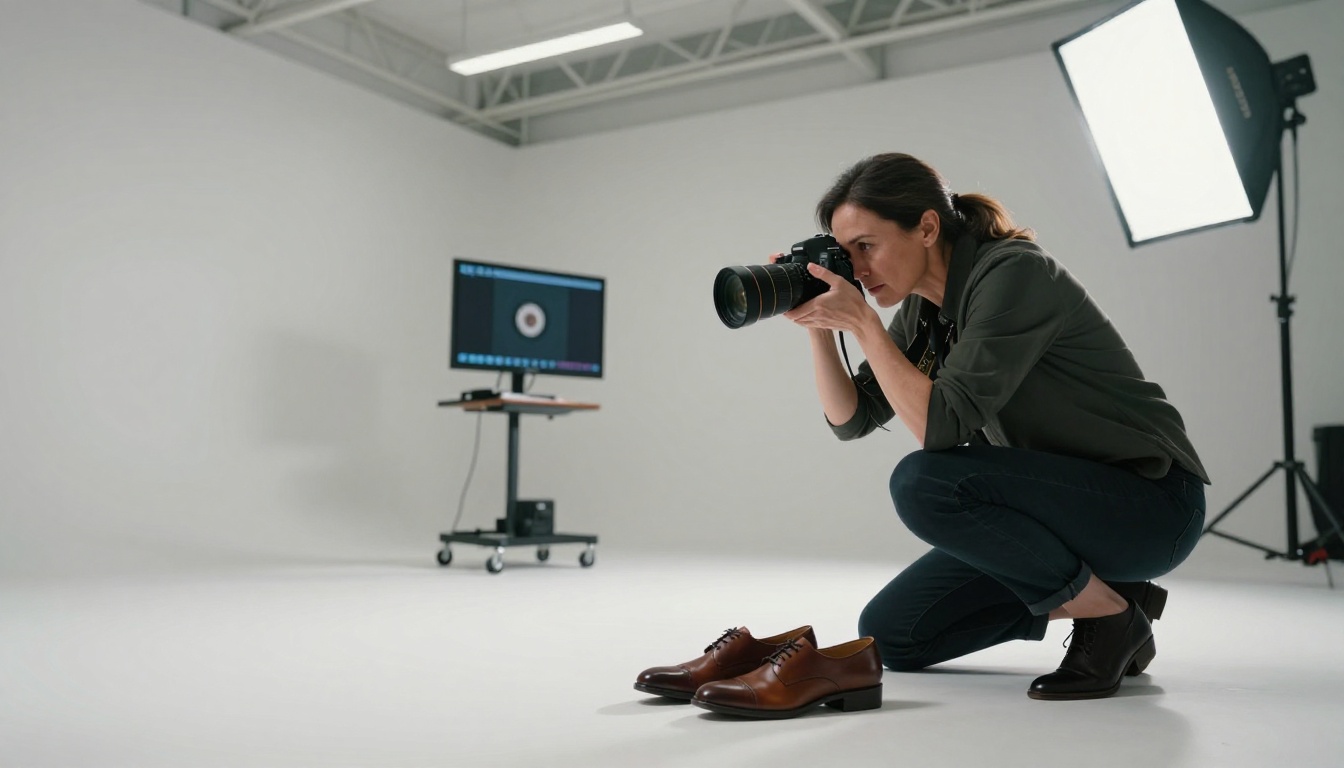
Pour l’estimation de profondeur à partir d’une seule photo, un éclairage plus dramatique est en réalité utile. Les ombres portent des informations sur la courbure des surfaces et sur la profondeur. Une seule source lumineuse forte placée sur un côté crée les ombres que l’IA utilise pour déduire la forme tridimensionnelle.
À éviter
- Objets en mouvement : tout changement du sujet entre deux prises perturbera les algorithmes multi-vues
- Surfaces sans détails : les surfaces blanches unies ou brillantes ne fournissent aucun élément à l’IA pour faire correspondre les images
- Flou de bougé : chaque image doit être prise avec une vitesse d’obturation suffisamment rapide pour éliminer le flou
- Encombrement de l’arrière-plan : les arrière-plans complexes peuvent introduire de fausses correspondances dans la reconstruction
💡 Astuce : Placer votre sujet sur un plateau tournant texturé et photographier depuis une position de caméra constante, tout en faisant pivoter l’objet, vous donne une couverture angulaire précise sans modifier votre dispositif d’éclairage entre les prises.
Utiliser l’IA pour ajouter de la profondeur à vos photos
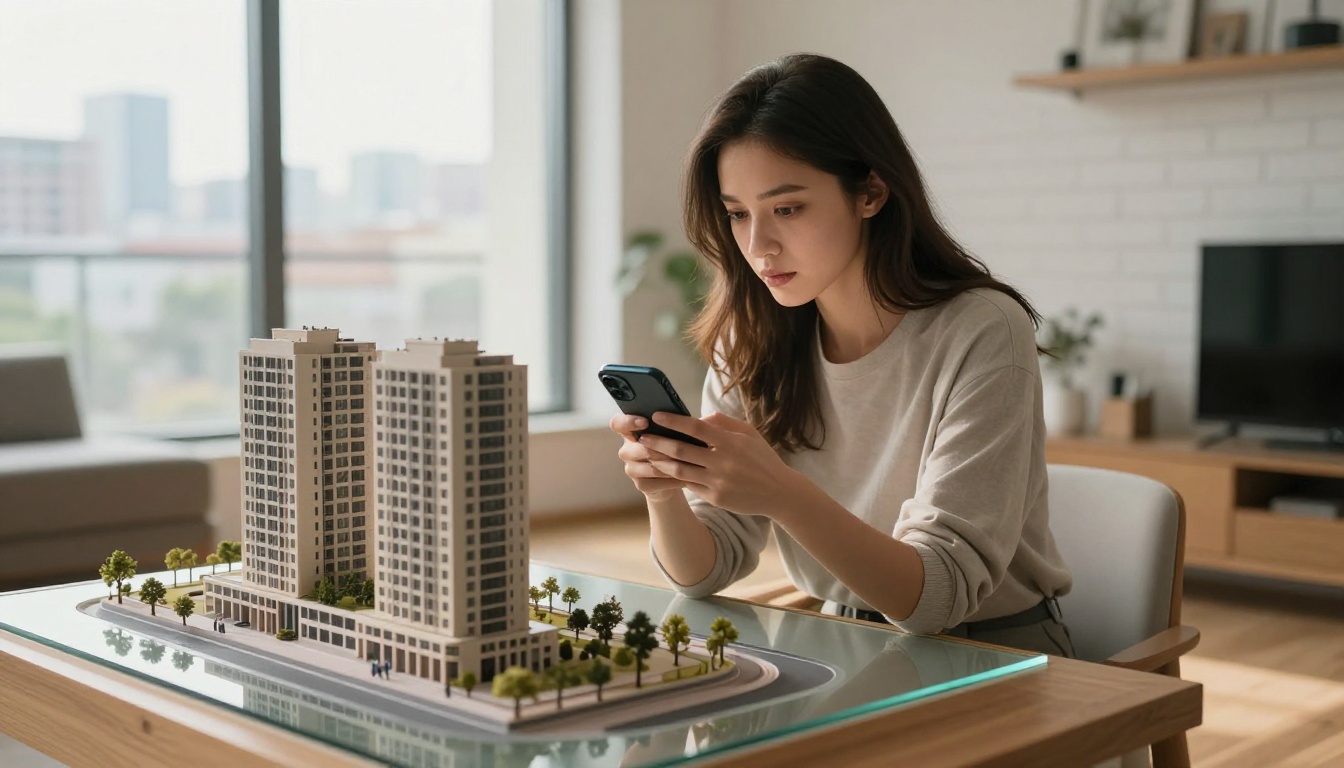
Si votre objectif n’est pas un maillage imprimable, mais une image riche visuellement et convaincante en volume, les modèles d’images d’IA dotés de capacités image vers image offrent un flux de travail plus rapide et plus créatif. Flux Dev sur Picasso IA est l’un des outils les plus performants pour cette approche.
Fonctionnement de l’img2img de Flux Dev
Flux Dev accepte une photographie de référence en entrée et la re-rend selon votre prompt textuel. Le modèle ne reconstruit pas la géométrie, mais produit une image qui réinterprète les relations spatiales de votre photo, en ajoutant de la profondeur, de la texture, de la lumière et des détails atmosphériques absents de l’original. Vous pouvez partir d’une photo de produit plate et mal éclairée et la faire évoluer vers une image pleinement aboutie, riche en volume, qui paraît tridimensionnelle.
Le paramètre prompt_strength contrôle la mesure dans laquelle le modèle s’écarte de votre photo d’origine. Une valeur de 0,4 à 0,6 préserve la composition tout en améliorant la qualité des surfaces et la cohérence spatiale. Une valeur supérieure à 0,8 donne au modèle une grande liberté créative pour réinventer la scène.
Pas à pas avec Flux Dev
Étape 1 : Ouvrez Flux Dev sur Picasso IA
Étape 2 : Importez votre photo de référence à l’aide du champ de saisie d’image
Étape 3 : Rédigez un prompt décrivant les qualités de volume que vous souhaitez. Concentrez-vous sur la direction de la lumière, la texture des surfaces et la profondeur spatiale. Exemple : « photorealistic product shot, strong volumetric lighting from upper left, deep shadow on right side revealing surface curvature, 8K detail »
Étape 4 : Réglez prompt_strength entre 0,45 et 0,6 pour préserver le sujet d’origine tout en améliorant la qualité spatiale
Étape 5 : Réglez guidance sur 3,5 et num_inference_steps sur 35 à 50 pour une fidélité de sortie maximale
Étape 6 : Lancez la génération. Si le résultat s’éloigne trop de l’original, diminuez prompt_strength de 0,1 et relancez
Stable Diffusion 3.5 Large comme alternative
Stable Diffusion 3.5 Large dispose de son propre pipeline image vers image, qui produit un caractère différent de celui de Flux Dev. Là où Flux Dev tend vers le photoréalisme avec des contours nets et propres, SD 3.5 Large excelle dans la diversité stylistique. Si votre flux de travail porte sur la visualisation architecturale, le travail de concept d’intérieur ou toute scène où le rendu atmosphérique compte plus que la fidélité photographique, SD 3.5 Large mérite d’être lancé en parallèle de Flux Dev pour comparaison.
Pour une itération rapide lors des premières phases de concept, Flux Schnell produit des résultats exploitables en moins de 5 secondes par image. Utilisez-le pour des tests directionnels rapides avant de vous engager dans des générations plus longues avec Flux Dev ou SD 3.5 Large.
| Modèle | Vitesse | Photoréalisme | Prise en charge de l’img2img | Meilleur usage |
|---|
| Flux Dev | Moyenne | Très élevé | Oui | Sortie finale de haute qualité |
| Flux Schnell | Très rapide | Élevé | Non | Itération rapide de concepts |
| SD 3.5 Large | Moyenne | Élevé, stylistiquement varié | Oui | Scènes atmosphériques |
Upscaling et finition de votre résultat
Que votre flux de travail produise une carte de profondeur, un rendu de maillage reconstruit ou un résultat img2img, l’upscaling apporte la dernière couche de qualité qui distingue un bon résultat d’un excellent.
Pourquoi l’upscaling compte ici
Les sorties de reconstruction 3D et les re-rendus d’IA sortent souvent à des résolutions inférieures à celles dont vous avez besoin pour l’impression, l’emballage produit ou un affichage haute résolution. Plus important encore, le processus de reconstruction ou de rendu peut introduire du flou, des artefacts de compression et une perte de détails fins que l’upscaling par IA sait précisément traiter.
Meilleurs upscalers sur Picasso IA
Clarity Pro Upscaler : le meilleur choix pour les résultats photoréalistes. Il ajoute des micro-détails comme le grain de surface, le tissage des tissus et la texture fine des matières, tout en préservant la tonalité d’ensemble de votre image. Particulièrement performant sur les portraits et les visuels produits.
Real ESRGAN : un upscaler 4x éprouvé, qui gère bien les entrées bruitées, compressées ou de faible qualité. Idéal pour agrandir les rendus présentant des artefacts de compression JPEG issus du pipeline de reconstruction.
Topaz Image Upscale : propose un agrandissement allant jusqu’à 6x, le facteur le plus élevé disponible sur Picasso IA. Utilisez-le lorsque vous avez besoin d’une résolution adaptée à l’impression à partir d’une image source de taille web.
Recraft Creative Upscale : ajoute des détails interprétatifs qui vont au-delà d’un simple upscaling. Il ajoute une texture et une complexité de surface plausibles qui n’étaient pas présentes dans l’original. Cela fonctionne bien pour les rendus qui nécessitent une plus grande richesse de matière.
💡 Astuce : Passez votre résultat dans Clarity Pro Upscaler avant de l’utiliser dans une application en aval. Les micro-détails ajoutés font la différence entre une image qui paraît plate et une image qui paraît véritablement tridimensionnelle.
Applications concrètes
Design de produits et e-commerce
Les équipes produit utilisent les flux de travail photo vers 3D pour créer des visualiseurs de produits interactifs, générer des rendus à 360 degrés à partir de séances photo et construire des actifs spatiaux pour les expériences d’essayage en RA. Une seule séance photo d’un nouveau produit peut fournir suffisamment de matière pour une bibliothèque complète d’actifs 3D.
Pour le e-commerce en particulier, le flux img2img avec Flux Dev est précieux pour standardiser les visuels produits sur un catalogue. Vous pouvez prendre des photos réalisées dans des conditions différentes et les re-rendre toutes avec un éclairage de studio, une profondeur et une qualité de surface homogènes.
Actifs de jeux et effets visuels
Les studios de jeux vidéo et les sociétés d’effets visuels utilisent depuis des années des pipelines de photogrammétrie pour capturer des objets, des environnements et des acteurs réels, puis les convertir en actifs intégrés au moteur. Les mêmes photographies qui alimentent une bibliothèque de référence de studio peuvent alimenter des outils de reconstruction par IA afin de produire accessoires, éléments d’environnement et références de personnages pour une fraction du coût traditionnel.
Architecture et espaces
Les architectes et les designers d’intérieur utilisent les pipelines photo vers 3D pour capturer des espaces existants, les convertir en nuages de points, puis travailler avec les données spatiales dans leurs logiciels de conception. L’estimation de profondeur par IA à partir d’une seule photographie permet d’extraire des mesures spatiales approximatives et des proportions à partir de photographies d’archives pour lesquelles aucune donnée 3D n’a jamais été capturée.
Créez votre première conversion photo par IA
Le point de départ le plus pratique est le flux img2img sur Picasso IA. Vous n’avez pas besoin de matériel spécialisé, d’un studio contrôlé ni de 50 photographies soigneusement prises. Il vous suffit d’une bonne photo et d’une idée claire de la qualité spatiale recherchée.
Commencez par Flux Dev et une photo que vous possédez déjà. Importez-la, rédigez un prompt décrivant la profondeur et l’éclairage souhaités, puis lancez la génération avec un prompt_strength de 0,5. Comparez le résultat à votre original. Passez le résultat dans Clarity Pro Upscaler et vous obtenez une image finie, riche en volume, prête pour toutes les applications.
Pour un travail de reconstruction plus poussé, commencez par perfectionner votre processus de prise de vue : éclairage homogène, couverture angulaire complète, mise au point nette partout. L’IA produit des résultats remarquables à partir de matériel source bien photographié, mais elle ne peut pas fabriquer des informations spatiales qui n’ont jamais été capturées.
Picasso IA réunit l’ensemble des outils de génération et d’upscaling au même endroit, sans plafond de crédits ni limite d’utilisation. Chaque modèle présenté dans cet article est disponible immédiatement, sans aucune configuration.
Essayez dès maintenant d’importer une photo de produit, un portrait ou une prise de vue architecturale dans Flux Dev. Décrivez la profondeur et le volume souhaités, lancez quelques itérations et observez le résultat. L’écart entre une photographie plane et un actif spatial riche n’est désormais qu’à un seul prompt.


