Kling 3.0 n’est pas une simple mise à jour. Chaque génération précédente de vidéo IA se heurtait aux mêmes trois problèmes : des visages qui dérivent d’une image à l’autre, des mouvements de caméra qui paraissent ajoutés après coup, et une physique qui se dégrade dès qu’un élément souple ou fluide entre dans le cadre. Kling 3.0 traite les trois à la fois, et les résultats sautent aux yeux. Les clips présentent une cohérence d’image en image qui exigeait autrefois des heures de rotoscopie et de compositing pour être simulée.
Cet article explique comment fonctionne Kling v3 Video, comment rédiger des prompts qui donnent un rendu vraiment cinématographique, et comment l’utiliser sur PicassoIA, du premier prompt jusqu’au clip finalisé.
Ce que Kling 3.0 fait différemment
La plupart des modèles de diffusion vidéo traitent les images indépendamment. Chaque image est échantillonnée à partir de la même distribution apprise, sans tenir compte de ce que contenait l’image précédente. C’est pourquoi les personnages dérivent, pourquoi les tissus bougent comme sous l’eau et pourquoi les cheveux deviennent ceux de quelqu’un d’autre à partir de la 12e image. Il s’agit d’un problème d’architecture fondamental, et non d’un problème de prompt.
La couche physique
Kling 3.0 utilise un mécanisme de cohérence temporelle qui reporte l’état physique tout au long du clip. Au lieu de se réinitialiser à chaque image, il suit :
- Les plis des tissus, qui conservent leur position et bougent avec une inertie correcte lorsque le sujet se déplace
- Les liquides, qui suivent la gravité pendant toute la durée du clip au lieu de scintiller en bruit
- Les cheveux, qui gardent une position et un éclairage constants au lieu de changer de style d’une image à l’autre
- La peau et les traits du visage, qui gardent la même identité de la première à la dernière image
Le résultat concret est une séquence qui passe le test du visionnage occasionnel. Une personne qui n’a jamais utilisé la vidéo IA ne la repérera pas immédiatement comme artificielle. Ce seuil compte énormément pour quiconque utilise la vidéo IA en production.
Lire les prompts cinématographiques
Les versions précédentes de Kling avaient un plafond en matière de complexité des prompts. Les instructions de caméra sophistiquées, les descriptions à plusieurs propositions et la terminologie propre au cinéma se traduisaient souvent par un résultat générique. Kling 3.0 interprète ces prompts avec un niveau de fidélité fondamentalement différent.
Demander un « contre-plongée inclinée (Dutch tilt), travelling vers la gauche à hauteur de genou, équivalent 50 mm, contre-jour du soleil du matin venant de la droite » produit désormais exactement cela, et non une approximation grossière. L’écart entre ce que vous décrivez et ce que vous obtenez s’est nettement réduit, ce qui rend le prompting cinématographique précis réaliste plutôt qu’aspirationnel.
Quel modèle utiliser et quand
Avant de rédiger un prompt, il est utile de savoir quelle version de la famille Kling convient à la tâche. PicassoIA propose la gamme complète.
Le flux de travail standard : prototypez sur Kling v2.6 pour la vitesse et l’économie, puis finalisez sur Kling v3 Video pour la qualité. Passez à Kling v3 Motion Control lorsque vous disposez d’une image de référence et avez besoin d’une trajectoire de caméra précise que le prompt texte seul ne peut pas produire de façon fiable.
Des prompts qui fonctionnent vraiment
L’erreur la plus courante en vidéo IA consiste à rédiger le prompt comme une requête de moteur de recherche. « Coucher de soleil en montagne avec nuages dramatiques » est une requête. Ce n’est pas la description d’un plan. Kling 3.0 répond à une précision de niveau directeur de la photographie, et l’écart de qualité entre une requête et une véritable description cinématographique n’a rien de subtil.
La structure en quatre parties
Tout prompt Kling efficace comporte quatre composantes, rédigées dans cet ordre :
- Sujet et action : qui ou quoi, avec des détails précis sur l’apparence, la matière et la couleur des vêtements, et le comportement
- Spécification de caméra : angle, hauteur, type de mouvement et équivalent de focale
- Environnement et éclairage : lieu, moment de la journée, position de la source lumineuse et qualité de la couleur
- Atmosphère et texture : rendu du film argentique, grain, température de couleur, ambiance
Prompt faible :
Une femme qui marche dans une ville pluvieuse la nuit.
Prompt cinématographique utilisant la structure en quatre parties :
Une femme de 30 à 33 ans, vêtue d’un manteau sombre en laine, marche seule dans une rue de la ville luisante de pluie à 2 h du matin, caméra en travelling à hauteur de hanche depuis sa gauche à l’équivalent de 85 mm, faible profondeur de champ qui transforme la guirlande de lampadaires en orbes ambrés chauds derrière elle, lumière volumétrique d’une lampe à vapeur de sodium placée directement au-dessus, créant un halo doux sur ses cheveux sombres, grain de film Kodak Vision 3, ombres bleu-noir avec des hautes lumières chaudes, atmosphère calme et contemplative.
Le second prompt élimine l’ambiguïté à chaque point de décision que le modèle remplirait sinon au hasard. La différence de rendu est spectaculaire.
Ce qu’il faut éviter
Plusieurs ajouts courants nuisent systématiquement à la qualité du rendu :
- Les termes d’ambiance vagues sans ancrage physique : « dramatique », « cinématographique », « puissant » sans préciser ce qui crée ces qualités
- Plus d’un mouvement de caméra principal : combiner « dolly-in » et « orbite » dans un seul clip de 5 secondes produit presque toujours un mouvement spatial incohérent
- Plusieurs actions de personnage simultanées : une seule action principale par clip est fiable ; deux ou plus produisent généralement des artefacts ou des fusions
- Des consignes spatiales contradictoires : demander un très gros plan et un plan en pied dans le même prompt
💡 Astuce : Relisez votre prompt comme si vous briefiez un vrai directeur de la photographie. Si quelque chose est ambigu pour un professionnel humain, il le sera pour le modèle. Préciser la direction de la source lumineuse dans chaque prompt est le changement le plus rentable que la plupart des gens oublient complètement.
Mouvements de caméra et focale
Le mouvement de caméra est le domaine où Kling 3.0 montre la plus nette amélioration par rapport aux versions précédentes de la famille. Le modèle répond désormais à un vocabulaire cinématographique précis d’une façon qui produit des résultats vérifiables et prévisibles, et non des approximations floues.
Les mouvements qui fonctionnent à coup sûr
| Terme de prompt | Ce qu’il produit |
|---|
slow dolly-in | Poussée progressive vers le sujet, propre et stable |
gentle pan left ou pan right | Balayage horizontal, efficace pour les paysages et les révélations |
low-angle upward tilt | Donne aux sujets un aspect imposant, crée une perspective dramatique |
aerial crane descending | Vue à vol d’oiseau qui descend jusqu’au niveau du sol |
handheld slight shake | Réalisme documentaire avec une légère instabilité contrôlée |
orbit 180 degrees | La caméra tourne autour du sujet, efficace pour les révélations de personnage |
rack focus foreground to subject | Mise au point qui crée une transition de profondeur cinématographique |
Utilisez un seul mouvement de caméra par clip. Combiner deux mouvements de caméra dans une même génération produit une incohérence spatiale dès le milieu du clip. Choisissez-en un et exécutez-le complètement.
Choisir sa focale
Kling 3.0 interprète les descriptions de focale comme de véritables instructions de compression spatiale, et non comme de simples marqueurs de style. Préciser une focale modifie la géométrie de la scène :
- 24 mm : grand angle avec contexte environnemental et légère courbure des bords. Efficace pour les plans d’établissement.
- 50 mm : perspective naturelle, la plus proche de la vision humaine. Polyvalente et perceptivement neutre.
- 85 mm : faible profondeur de champ avec une forte séparation du fond. Le cheval de bataille des plans de personnage.
- 135 mm : forte compression de l’arrière-plan qui rapproche visuellement les éléments lointains, pour une impression d’espace comprimé et intime.
💡 Astuce : Par défaut, choisissez 85 mm pour tout plan impliquant une personne. Cette focale met en valeur les sujets, crée une séparation visuelle avec l’arrière-plan et offre le rendu le plus associé au cinéma narratif professionnel. Commencez par là et ne vous en écartez que si le plan exige quelque chose de précis.
Garder les personnages cohérents
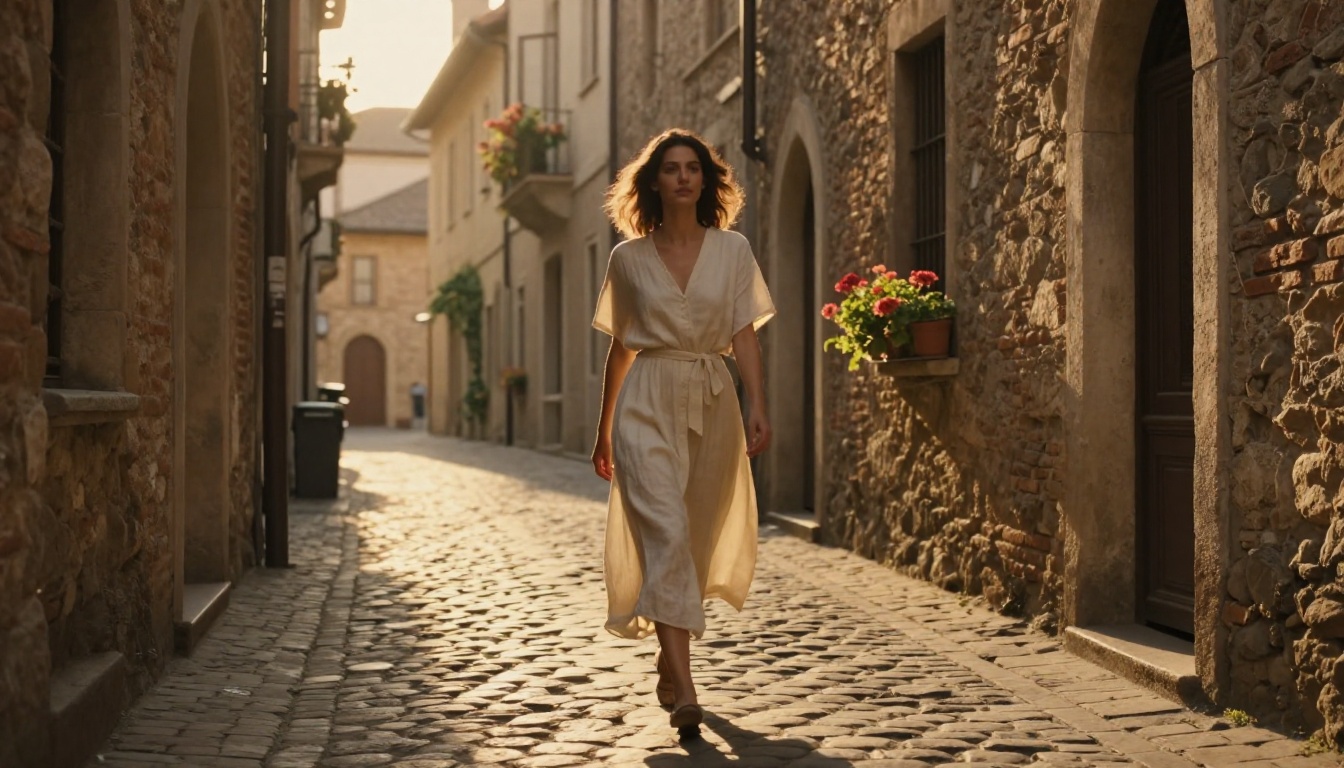
La cohérence des personnages sur une séquence de plusieurs clips est l’un des problèmes les plus difficiles de la génération de vidéos IA. Un visage qui change légèrement d’une génération à l’autre détruit l’illusion d’une scène cohérente. Kling 3.0 gère cela mieux que toutes les versions précédentes de la famille, mais il exige tout de même une discipline de prompting rigoureuse sur l’ensemble d’une séquence.
La méthode de l’image de référence
L’approche la plus fiable pour la cohérence des personnages est la génération d’image vers vidéo. Créez d’abord une image fixe de votre personnage avec un modèle de texte vers image, puis transmettez cette image à Kling v2.1 ou Kling Avatar v2 en mode image vers vidéo. L’image de référence ancre l’apparence du personnage, et le modèle la conserve tout au long du clip avec une grande fidélité.
Pour du travail de personnage en texte vers vidéo pur, sans image de référence, utilisez des descripteurs très précis dans chaque prompt de clip :
- Âge exact, couleur et longueur des cheveux, couleur des yeux
- Vêtement précis avec la texture de la matière et une couleur exacte
- Traits distinctifs : une cicatrice particulière, des taches de rousseur, un accessoire spécifique
- Répétez ces descripteurs à l’identique dans chaque prompt de clip de la séquence
Dès que vous modifiez un descripteur, le modèle y voit l’autorisation de faire varier le personnage.
Relier les plans d’une séquence
Kling 3.0 n’hérite pas automatiquement de l’état entre des générations séparées. Chaque clip est indépendant et n’a aucune mémoire de ce qui précède. Pour maintenir la continuité visuelle d’une séquence :
- Terminez la description du prompt de chaque clip avec le personnage dans une position précise et stable
- Commencez le prompt du clip suivant depuis cette position exacte
- Reportez à l’identique tous les descripteurs du personnage
- Conservez le même dispositif d’éclairage, sauf si vous passez volontairement à un nouvel environnement
C’est le même travail qu’effectue un scripte sur un tournage réel. Le modèle ne peut pas le faire automatiquement, mais il respecte avec précision les informations que vous lui fournissez.
PicassoIA vous donne un accès direct à la gamme complète de Kling v3, sans configuration d’API, sans installation locale ni compte développeur. Le flux de travail, du prompt au clip finalisé, se déroule en cinq étapes.
Étape 1 : choisissez votre modèle. Rendez-vous sur Kling v3 Video pour la génération cinématographique standard de texte vers vidéo. Si vous animez une image de référence avec une trajectoire de caméra précise, ouvrez plutôt Kling v3 Motion Control. Pour animer le visage à partir d’une photo fixe, Kling Avatar v2 est l’outil adapté.
Étape 2 : réglez les paramètres avant de rédiger. Choisissez le format 16:9 pour un rendu cinématographique standard. Réglez la durée sur 5 secondes, la fenêtre idéale pour un mouvement de caméra complet. Sélectionnez 1080p pour tout clip destiné à un montage final. Utilisez 720p uniquement pour les tests.
Étape 3 : rédigez le prompt avec la structure en quatre parties. Sujet, caméra, environnement, atmosphère, dans cet ordre. Visez 80 à 120 mots. En dessous de 50 mots, le modèle comble les vides de façon arbitraire. Au-delà de 150 mots, des détails contradictoires produisent de l’incohérence.
Étape 4 : fixez d’abord le mouvement de caméra. Votre première génération teste si le comportement de la caméra est correct. Si le mouvement est juste, tout le reste est plus facile à corriger par itération. Si le mouvement est faux, le reste n’a pas d’importance. Validez la caméra, puis affinez le sujet et l’atmosphère.
Étape 5 : enchaînez les clips dans votre logiciel de montage. Chaque clip d’une séquence est une génération distincte. Gardez les descripteurs de personnage identiques dans tous les prompts. Ajoutez le son en post-production, car Kling ne génère pas de son natif.
💡 Astuce : Kling v2.1 Master et Kling v1.6 Standard offrent une cohérence de personnage solide à moindre coût. Utilisez-les pour l’itération en amont avant de passer à la v3 pour les versions finales.
Le marché de la vidéo IA compte actuellement plusieurs modèles solides. La place de Kling 3.0 par rapport aux autres dépend de ce dont votre clip précis a besoin.
Comparaison côte à côte
Quand Kling l’emporte
Kling 3.0 est le bon modèle lorsque :
- La stabilité du personnage sur plusieurs clips est indispensable : seul Sora 2 l’égale sur ce point
- La précision du langage cinématographique compte : Kling interprète la terminologie du cinéma plus fiablement que la plupart des alternatives
- Des scènes riches en physique entrent en jeu : l’eau, les tissus, les cheveux et les mouvements de corps mous se comportent plus naturellement que dans des modèles comparables
- Le son sera traité séparément en post-production : l’absence d’audio natif n’est pas une limite si votre flux de travail ajoute le son au montage
Lorsque vous avez besoin d’un audio natif généré avec la vidéo, Seedance 2.0 ou Veo 3 sont les choix pratiques. Lorsque la vitesse brute compte davantage que la qualité maximale, Kling v2.6 livre un rendu 720p rapide tout en conservant la même cohérence temporelle sur laquelle repose la famille v3.
4 erreurs à arrêter de commettre
La plupart des mauvais résultats en vidéo IA proviennent des mêmes quatre erreurs. Les corriger fait passer les résultats dans une gamme de qualité nettement différente.
Aucune direction de lumière dans le prompt
Les descriptions d’éclairage génériques produisent un résultat générique. « Éclairage dramatique » ne dit rien au modèle sur la configuration physique du plan. « Lumière volumétrique venant du haut à gauche à 45 degrés, projetant de longues ombres vers la droite, température de couleur chaude de 3200 K » donne au modèle une configuration physique précise à reproduire. Ce seul changement produit le plus fort gain de qualité visible parmi tout ce que vous pouvez ajuster dans un prompt.
Tester sur la version premium avant que le concept ne fonctionne
Lancer Kling v3 Video avant que le concept du prompt ne soit confirmé fait perdre du temps et des crédits. La bonne méthode consiste à prototyper sur Kling v2.6, à vérifier que le mouvement de caméra et la composition de base fonctionnent, puis à finaliser sur la v3. Le comportement des prompts se transfère bien d’une version à l’autre au sein d’une même famille de modèles.
Modifier plusieurs variables à chaque itération
Lorsqu’une génération sort mal et que vous changez en même temps le sujet, la caméra et l’éclairage, vous perdez la capacité de diagnostiquer ce qui a corrigé le problème. Modifiez une seule variable par itération et considérez chaque génération comme une expérience contrôlée. Le résultat s’améliore plus vite, et vous constituez au passage un vocabulaire de prompting fiable.
Décrire la quantité au lieu de la précision
Un prompt de 200 mots rempli de termes d’ambiance produit un résultat moins bon qu’un prompt de 90 mots avec des spécifications physiques précises. Davantage de mots sur la façon dont quelque chose « donne l’impression » ou « transmet » n’aident pas le modèle. Davantage de mots sur l’emplacement exact de la source lumineuse, la focale et la matière des vêtements du personnage l’aident nettement.
💡 Astuce : Supprimez de votre prompt toute phrase qui ne décrit pas un objet physique, une position, une matière ou une action. Si elle ne figurerait pas sur une fiche de réglage de caméra, elle appartient probablement à un moodboard.
À essayer sur PicassoIA dès maintenant
La suite Kling v3 est le standard de production actuel pour la vidéo IA cinématographique. Kling v3 Video couvre la majorité du travail narratif. Kling v3 Motion Control prend le relais lorsque vous avez besoin d’une trajectoire de caméra précise à partir d’une image de référence. Kling v3 Omni Video couvre les scénarios polyvalents à entrées mixtes.
Au-delà de Kling, PicassoIA propose Seedance 2.0 pour la génération avec audio natif, Kling Avatar v2 pour l’animation de visage et les clips de type présentateur, ainsi que PicassoIA Video pour une génération gratuite et illimitée lorsque vous voulez tester des idées sans contrainte de coût. Le catalogue complet couvre plus de 87 modèles de texte vers vidéo de Google, OpenAI, ByteDance, Luma et Minimax, tous accessibles depuis la même interface.
L’écart entre une vidéo IA ordinaire et une vidéo véritablement cinématographique n’est pas un écart de modèle. C’est un écart de prompting. Le mouvement de caméra, la focale, la direction de la lumière, la référence de pellicule : ce sont les spécifications physiques dont le modèle a besoin pour produire des images qui tiennent réellement à l’écran.
Choisissez une scène que vous imaginez depuis un moment. Appliquez la structure en quatre parties. Rédigez-la avec précision. Lancez-la sur Kling v3 Video. Le premier clip cinématographique réussi change ce que vous croyez possible en vidéo IA. Découvrez ce que tout le catalogue peut faire sur picassoia.com/en/all-models.


