La dernière génération de modèles de langage de Meta introduit deux versions distinctes, conçues pour des cas d’usage différents : Llama 4 Scout et Llama 4 Maverick. Ces modèles représentent un changement stratégique dans la manière dont les systèmes d’IA sont déployés, Scout étant optimisé pour l’efficacité et l’inférence rapide, tandis que Maverick repousse les limites de la précision et du raisonnement complexe.
Si vous hésitez entre ces modèles pour votre prochain projet, ce comparatif détaille leurs architectures, leurs performances mesurées au benchmark, leurs implications financières et leurs applications concrètes. À la fin, vous aurez une idée claire du modèle qui correspond à vos exigences spécifiques.

Architecture des modèles et philosophie de conception
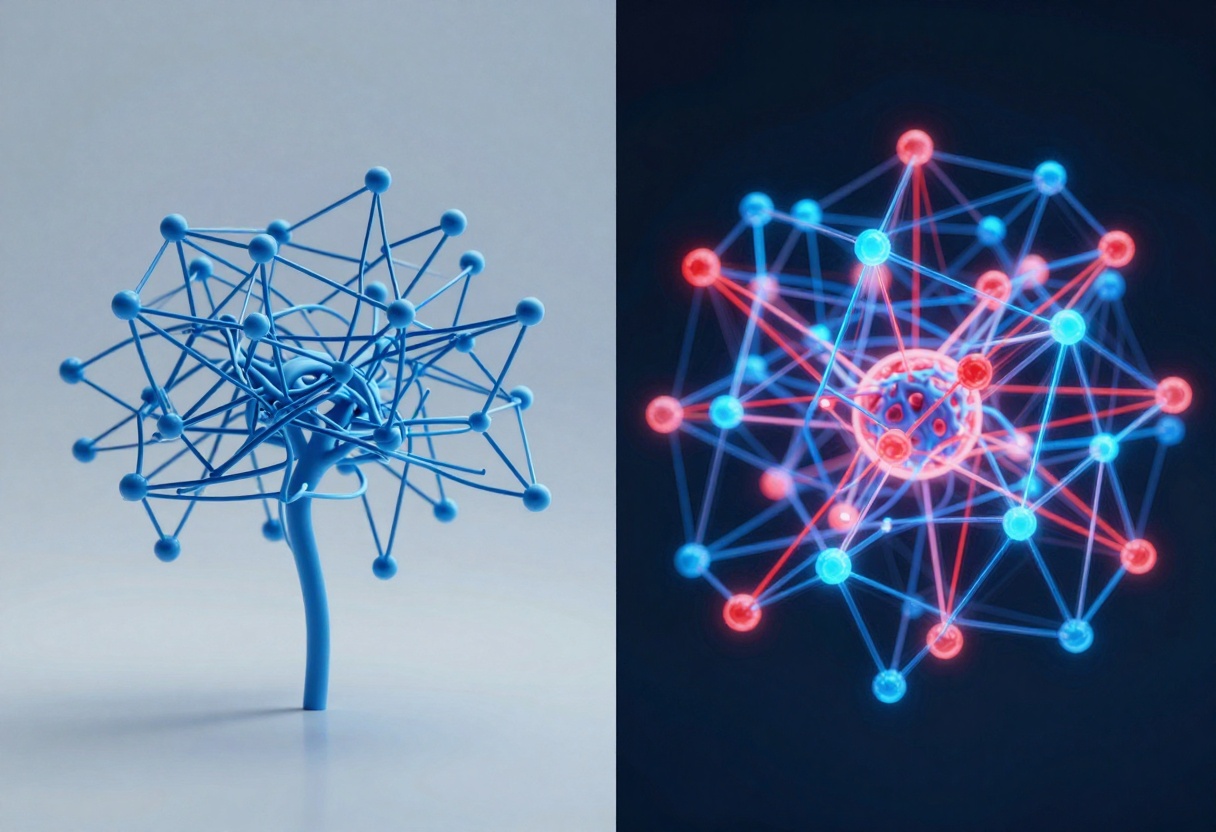
La différence fondamentale entre Scout et Maverick réside dans leur approche architecturale. Llama 4 Scout repose sur une architecture épurée comptant moins de paramètres, environ 20 à 30 milliards, ce qui le rend léger et rapide. Cette conception privilégie le temps de réponse et l’efficacité de calcul, ce qui se traduit par une latence plus faible en environnement de production.
À l’inverse, Llama 4 Maverick possède un nombre de paramètres nettement plus élevé, compris entre 70 et 100 milliards. Cette architecture élargie permet une compréhension contextuelle plus profonde et des capacités de raisonnement plus nuancées. Le compromis tient à des besoins de calcul plus importants et à des temps de traitement plus longs.
Les deux modèles reposent sur l’architecture transformer, devenue standard dans les modèles de langage modernes, mais leur profondeur de couches, leurs mécanismes d’attention et leurs objectifs d’entraînement diffèrent sensiblement. Scout applique une stratégie d’élagage plus agressive pendant l’entraînement, tandis que Maverick conserve une capacité de représentation plus complète sur l’ensemble de ses couches.
Lorsqu’on évalue les performances brutes, les résultats montrent une nette différence entre les deux modèles selon les différents critères.
Vitesse et latence
Llama 4 Scout excelle en temps de réponse, produisant des résultats environ 3 à 4 fois plus vite que Maverick. Concrètement, Scout peut générer 100 tokens en environ 0,5 seconde sur une infrastructure GPU standard, alors que Maverick en nécessite 1,5 à 2 pour la même tâche. Pour les applications exigeant des réponses en temps réel, comme les chatbots ou les assistants interactifs, cet avantage en vitesse devient crucial.
Précision et raisonnement
C’est dans les tâches de raisonnement complexe et de précision que Llama 4 Maverick montre sa supériorité. Sur des benchmarks standardisés comme MMLU (Massive Multitask Language Understanding), Maverick obtient environ 85 à 88 %, contre 78 à 82 % pour Scout. Cet écart s’accentue dans les domaines spécialisés qui exigent une connaissance technique approfondie ou un raisonnement logique en plusieurs étapes.
Maverick affiche également de meilleures performances dans :
- la résolution de problèmes mathématiques
- la génération et le débogage de code
- le raisonnement scientifique
- la cohérence des contenus longs
- la rétention du contexte au fil de conversations prolongées
Tableau comparatif des benchmarks
| Indicateur | Llama 4 Scout | Llama 4 Maverick |
|---|
| Temps de réponse (100 tokens) | 0,5 s | 1,8 s |
| Score MMLU | 80 % | 87 % |
| Précision de génération de code | 75 % | 89 % |
| Fenêtre de contexte | 8K tokens | 32K tokens |
| Besoins en mémoire | 40 Go | 120 Go |
Analyse des coûts
Comprendre les implications financières de chaque modèle est essentiel pour la planification de votre projet et sa montée en charge.
Coûts d’infrastructure
Llama 4 Scout peut fonctionner efficacement sur une infrastructure GPU de milieu de gamme, notamment sur un seul GPU NVIDIA A10 ou T4. Cette accessibilité réduit à la fois l’investissement matériel initial et les dépenses récurrentes en informatique dans le cloud. Pour les organisations aux budgets modestes ou celles qui testent l’intégration de l’IA, Scout constitue un point d’entrée plus abordable.
Llama 4 Maverick exige du matériel haut de gamme, nécessitant généralement des GPU NVIDIA A100 ou H100 pour des performances optimales. Exécuter Maverick en production peut coûter de 3 à 5 fois plus cher que Scout, si l’on tient compte des ressources de calcul, des besoins en mémoire et de l’infrastructure de refroidissement.
Efficacité opérationnelle
Le coût par inférence diffère également de manière importante. Scout traite les requêtes à environ 0,001 $ pour 1K tokens, tandis que Maverick affiche en moyenne 0,004 $ pour 1K tokens. Pour les applications à fort volume, traitant des millions de requêtes par jour, cette différence s’accumule de façon significative.
Toutefois, l’équation des coûts change lorsque l’on considère l’efficacité dans l’accomplissement des tâches. Si Maverick mène à bien des tâches complexes en moins d’itérations grâce à sa précision supérieure, le coût total par tâche accomplie peut en réalité jouer en faveur de Maverick dans certains cas d’usage.
Cas d’usage et applications
Le choix du modèle dépend largement des exigences spécifiques de votre application.
Quand choisir Llama 4 Scout
Scout se distingue dans les scénarios où la vitesse et le rapport coût-efficacité priment sur la précision absolue :
- Chatbots de service client : les réponses en temps réel comptent davantage que la précision parfaite pour les demandes courantes
- Modération de contenu : traitement rapide de grands volumes de contenus générés par les utilisateurs
- Classification de texte simple : analyse de sentiment, catégorisation par thème, détection de spam
- IA conversationnelle : systèmes de dialogue naturel où la latence de réponse influe sur l’expérience utilisateur
- Génération de brouillons : création de contenus initiaux qui seront relus par un humain
- Déploiement mobile et en périphérie : environnements aux ressources limitées
Quand choisir Llama 4 Maverick
Maverick devient le meilleur choix lorsque la précision, la profondeur et le raisonnement complexe sont non négociables :
- Développement logiciel : génération de code, planification d’architecture, aide au débogage
- Recherche et analyse : revue de la littérature scientifique, interprétation de données, génération d’hypothèses
- Documentation technique : création de contenus techniques détaillés et précis
- Juridique et conformité : analyse de contrats, interprétation réglementaire
- Contenus pédagogiques : génération de supports d’étude complets, systèmes de tutorat
- Planification stratégique : veille économique, analyse de marché, aide à la décision
Expérience développeur
Du point de vue du développement, les deux modèles offrent des modes d’intégration similaires via des API standard, mais les considérations opérationnelles diffèrent.
Intégration et déploiement
Scout et Maverick prennent en charge les options de déploiement courantes, notamment les API REST, les bibliothèques Python et les environnements conteneurisés. La principale différence réside dans l’allocation des ressources et les stratégies de montée en charge.
Les besoins en ressources réduits de Scout facilitent son déploiement dans des systèmes distribués, en permettant une montée en charge horizontale sur plusieurs instances. Cette architecture convient bien aux microservices et aux applications natives du cloud.
Les exigences matérielles de Maverick nécessitent souvent une montée en charge verticale et un équilibrage de charge plus rigoureux. Les organisations déploient généralement Maverick dans des clusters dédiés et performants, plutôt que de le répartir sur de nombreuses petites instances.
Adaptation et optimisation du modèle
Le fine-tuning de Scout sur des données propres à un domaine est plus accessible grâce à ses besoins de calcul plus faibles. Les organisations peuvent itérer sur des modèles personnalisés plus rapidement et à moindre coût.
Le fine-tuning de Maverick demande des ressources substantielles, mais peut atteindre une spécialisation remarquable lorsqu’il est correctement entraîné sur des jeux de données de niche. L’investissement est rentable pour les applications exigeant une expertise de domaine approfondie.
Prendre la décision
Le choix entre Llama 4 Scout et Maverick ne consiste pas à savoir lequel est objectivement meilleur, mais lequel correspond à vos exigences.
Grille de décision
Optez pour Scout si :
- un temps de réponse inférieur à 1 seconde est critique
- votre budget limite les investissements en infrastructure
- votre cas d’usage tolère une précision inférieure de 15 à 20 %
- vous traitez de gros volumes de requêtes relativement simples
- un déploiement en périphérie ou une intégration mobile est nécessaire
Optez pour Maverick si :
- la précision et la profondeur du raisonnement sont primordiales
- votre application traite des tâches complexes et nuancées
- votre budget permet de financer des ressources de calcul premium
- des résultats erronés ont des conséquences importantes
- vous avez besoin d’une compréhension du contexte au-delà de 8K tokens
Approches hybrides
Nombre d’organisations déploient avec succès les deux modèles en parallèle, en orientant les requêtes selon leur complexité. Les requêtes simples sont envoyées à Scout pour une réponse rapide, tandis que les tâches complexes sont dirigées vers Maverick. Cette approche par niveaux optimise à la fois le coût et les performances.
Certaines équipes utilisent Scout pour les premiers brouillons ou suggestions, puis font appel à Maverick pour l’affinage et la validation. Ce flux de travail équilibre la rapidité de la phase créative et la qualité du résultat final.
PicassoIA donne accès à des modèles de langage performants comme Claude 4.5 Sonnet, qui offre des capacités comparables à celles de Scout et de Maverick selon votre configuration. Voici comment démarrer avec les modèles de langage avancés sur la plateforme.
Ce qui fait la particularité de Claude 4.5 Sonnet
Claude 4.5 Sonnet représente une approche de pointe du déploiement des modèles de langage, avec des capacités de codage exceptionnelles, un raisonnement avancé et une prise en charge multimodale. Le modèle accepte à la fois du texte et des images en entrée, ce qui le rend polyvalent pour un large éventail d’usages, de la documentation technique à la création de contenus créatifs.
Les principaux atouts sont :
- des fenêtres de contexte étendues allant jusqu’à 8 192 tokens pour les contenus longs
- des prompts système personnalisables pour des réponses adaptées
- un traitement d’image efficace avec une résolution réglable
- de bonnes performances en génération et en relecture de code
- un équilibre optimisé entre vitesse et précision
Utiliser Claude 4.5 Sonnet : étape par étape
Étape 1 : accéder à la page du modèle
Rendez-vous sur la page du modèle Claude 4.5 Sonnet sur PicassoIA. L’interface propose un design épuré et intuitif pour configurer vos requêtes au modèle de langage.
Étape 2 : configurer votre prompt
Le paramètre le plus important est votre prompt, qui indique au modèle ce que vous souhaitez générer. Rédigez des instructions claires et précises pour obtenir de meilleurs résultats. Par exemple :
- « Rédigez un article de blog technique sur les techniques d’optimisation des bases de données »
- « Générez du code Python pour une API REST avec authentification »
- « Analysez ces retours clients et proposez des pistes d’action concrètes »
Étape 3 : régler les paramètres avancés
Si le prompt est obligatoire, plusieurs paramètres facultatifs vous permettent d’affiner le résultat :
- Max Tokens (par défaut : 8192) : contrôle la longueur maximale de la réponse. Choisissez une valeur basse pour des résultats concis, plus élevée pour des contenus détaillés.
- System Prompt : fournit le contexte ou les instructions sur le rôle et le comportement du modèle. Utilisez-le pour définir le ton, le niveau d’expertise ou des consignes précises.
- Max Image Resolution (par défaut : 0,5 mégapixel) : si vous fournissez une image en entrée, ce réglage contrôle la résolution de traitement pour équilibrer qualité et coût.
Étape 4 : ajouter des entrées multimodales (facultatif)
Si votre tâche implique une analyse visuelle, importez une image avec le paramètre Image. Cela permet des usages comme :
- analyser des schémas ou des graphiques
- extraire du texte de captures d’écran
- décrire un contenu visuel
- combiner contexte visuel et textuel
Étape 5 : générer et relire
Cliquez sur le bouton de génération pour traiter votre requête. Le modèle renverra un résultat textuel selon votre configuration. Relisez les résultats et ajustez vos prompts si nécessaire pour obtenir le résultat souhaité.
Applications pratiques
Claude 4.5 Sonnet excelle dans des scénarios qui reflètent à la fois l’efficacité de Scout et les capacités de Maverick :
- Rédaction et relecture automatisées de code : générez du code prêt pour la production, avec une gestion des erreurs et une documentation adéquates
- Création de contenus techniques : rédigez des articles, guides et documentations précis et bien structurés
- Synthèse de documents : condensez des rapports, transcriptions ou articles de recherche volumineux en points clés
- Assistants propulsés par l’IA : développez des chatbots et des assistants virtuels dotés de solides capacités de raisonnement
- Recherche multimodale : combinez analyse d’images et interprétation de texte pour une extraction de données complète
Optimiser vos résultats
Pour tirer le meilleur parti des modèles de langage sur PicassoIA :
- Soyez précis dans vos prompts : au lieu de « écrivez sur l’IA », essayez « rédigez une explication technique de 500 mots sur l’architecture transformer destinée aux développeurs »
- Utilisez les prompts système de façon stratégique : définissez le contexte une seule fois plutôt que de le répéter dans chaque prompt
- Itérez et affinez : commencez par un prompt simple, examinez le résultat, puis ajustez les paramètres pour améliorer les résultats
- Équilibrez les limites de tokens : un nombre de tokens plus élevé coûte davantage mais permet des réponses plus complètes
- Exploitez les capacités multimodales : lorsque c’est pertinent, combiner images et prompts textuels donne une analyse plus riche
L’avenir de la spécialisation des modèles
La divergence représentée par Scout et Maverick annonce une tendance plus large dans le développement de l’IA. Plutôt que de poursuivre un modèle unique « idéal », l’industrie s’oriente vers des versions spécialisées, optimisées pour des cas d’usage distincts.
Cette approche devrait continuer de se développer, avec des modèles adaptés à des secteurs, des environnements de déploiement et des profils de performance spécifiques. Le choix ne se fera pas entre bons et mauvais modèles, mais entre des modèles qui correspondent ou non à vos exigences particulières.
Llama 4 Scout et Maverick ont tous deux leur place dans l’écosystème de l’IA. Comprendre leurs forces et leurs limites vous aide à prendre des décisions éclairées, qui équilibrent performance, coût et capacités selon vos besoins spécifiques. Que vous choisissiez l’efficacité de Scout, la puissance de Maverick ou que vous combiniez les deux dans une approche hybride, l’essentiel est d’aligner le choix du modèle sur les exigences uniques de votre application.
Prêt à créer avec des modèles de langage performants ? Découvrez Claude 4.5 Sonnet sur PicassoIA et voyez comment l’IA avancée peut transformer vos projets.


