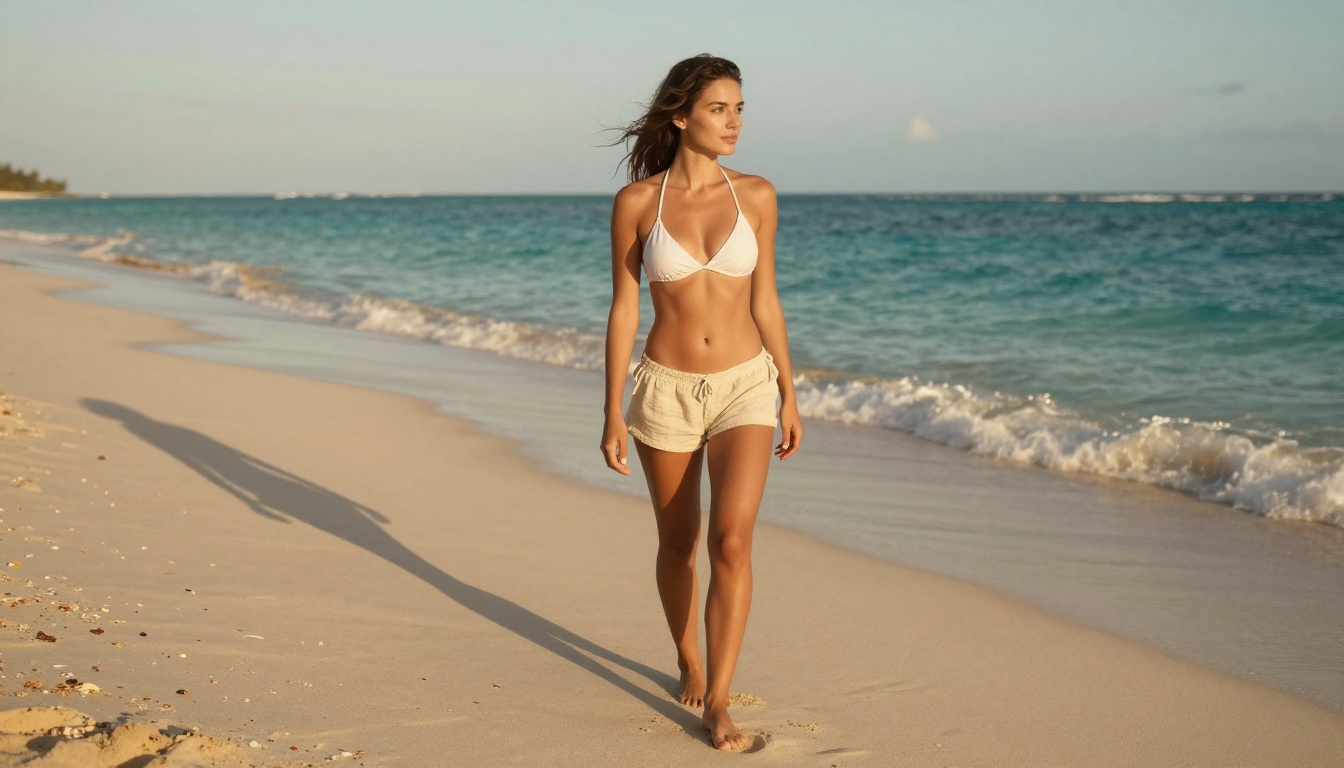
Vous importez une seule photographie. Trente secondes plus tard, elle bouge : les cheveux captent une brise invisible, l’arrière-plan vit avec une profondeur et une atmosphère subtiles. C’est ce que fait MiniMax I2V, et ce n’est pas tant de la magie que des mathématiques appliquées à une échelle que la plupart des gens n’imaginent pas.
La technologie derrière la génération de vidéos à partir d’images par IA (image-to-video, I2V) a progressé plus vite au cours des 18 derniers mois que pendant la décennie de recherche précédente. MiniMax, le laboratoire d’IA chinois à l’origine de la série Hailuo et des modèles Video 01, se trouve au cœur de cette accélération. Ses systèmes I2V produisent certains des résultats les plus cohérents dans le temps et les plus naturels en matière de mouvement parmi tous les modèles actuellement disponibles, et plusieurs de ces modèles sont accessibles directement via PicassoIA.
Cet article détaille précisément le fonctionnement interne de MiniMax I2V, ce qui le distingue de la génération de vidéos à partir de texte, comment rédiger des prompts qui donnent de très bons résultats, et comment y accéder pas à pas.
Ce que fait réellement MiniMax I2V
D’un pixel immobile à une scène en mouvement
La génération image vers vidéo consiste à prendre une image statique et à synthétiser une séquence d’images formant une vidéo crédible et continue. L’image d’origine devient la première image, et le travail du modèle est de construire chaque image suivante de manière visuellement cohérente avec ce qui était déjà présent.
Cela semble simple. Ce n’est pas le cas. Une photographie ne contient aucune information sur la façon dont les objets qu’elle représente devraient bouger. La robe sur la photo n’a aucune donnée physique. L’eau n’a pas de direction d’écoulement. La personne n’a pas de trajectoire de pose. Le modèle doit déduire tout cela à partir de :
- Des indices contextuels visuels (de l’eau près d’un rivage suggère un mouvement horizontal)
- Des relations spatiales (des cheveux près d’un visage suivent vraisemblablement les mouvements de la tête)
- Des signaux sémantiques (une personne debout sur une plage a de fortes chances de se balancer légèrement, et non de se téléporter)
- Des indications dans le prompt (vous pouvez préciser exactement le type de mouvement souhaité)
La vidéo obtenue n’est pas la photo d’origine « rendue vivante ». C’est une toute nouvelle séquence d’images synthétiques générée par un réseau de neurones entraîné à traiter le mouvement dans le monde physique.
Pourquoi la cohérence est le problème difficile
Le véritable défi de l’I2V est la cohérence temporelle : faire en sorte que le sujet de l’image 1 soit visuellement identique au sujet de l’image 60, sans scintillement, déformation ni dérive. Les premiers modèles de diffusion vidéo échouaient lourdement sur ce point. Le visage d’une personne changeait subtilement d’une image à l’autre, les cheveux variaient en longueur, et les arrière-plans pulsaient avec des variations de texture non voulues.
L’architecture de MiniMax répond à ce problème grâce à un mécanisme d’attention spatio-temporelle : le modèle peut prendre simultanément en compte les caractéristiques spatiales (ce qui figure dans l’image) et temporelles (comment ces caractéristiques doivent évoluer dans le temps). Le résultat est une vidéo où le sujet reste stable, même lorsque le mouvement se déploie autour de lui et à travers lui.
L’architecture qui alimente le mouvement
La diffusion latente pour la synthèse vidéo
MiniMax I2V repose sur une architecture de diffusion vidéo latente. Si vous avez déjà utilisé des générateurs d’images, vous connaissez le principe de la diffusion : le modèle part d’un bruit et le débruite progressivement pour obtenir une image cohérente. Pour la vidéo, le même processus s’applique à chaque image simultanément, avec la contrainte supplémentaire que les images doivent être cohérentes entre elles.
Le processus, simplifié :
- Votre image d’entrée est encodée dans une représentation latente, une description mathématique compressée de l’image
- Du bruit est ajouté à une séquence d’images latentes vierges
- Le réseau de débruitage supprime le bruit par itérations, guidé par la représentation latente de l’image et votre prompt textuel
- La séquence de latentes débruitées est décodée en images vidéo dans l’espace des pixels
L’innovation principale de l’approche de MiniMax se situe à l’étape 3. La plupart des modèles de diffusion vidéo antérieurs débruitaient chaque image indépendamment, puis tentaient après coup de garantir la cohérence. L’architecture de MiniMax débruite l’ensemble de la séquence conjointement, ce qui signifie que la cohérence est intégrée au processus de génération plutôt que rajoutée à la fin.
Comment le modèle lit votre image
Lorsque vous fournissez une image à un modèle MiniMax I2V, elle n’est pas simplement « placée » au début de la vidéo. L’image est traitée par un encodeur d’image qui extrait :
- Le contenu sémantique : les objets, personnes et scènes présents
- La disposition spatiale : la position des éléments les uns par rapport aux autres
- Les conditions de couleur et d’éclairage : les valeurs tonales exactes que toutes les images générées doivent respecter
- Les signatures de texture et de détail : les détails fins qui doivent rester cohérents dans le temps
Cette représentation encodée devient un signal de conditionnement pour l’ensemble du processus de débruitage. Chaque image générée prend simultanément en compte ce signal, ce qui explique pourquoi la vidéo finale préserve avec une grande fidélité des détails comme la texture des tissus, la couleur des cheveux et l’architecture de l’arrière-plan.
💡 Astuce pro : les images avec une séparation de profondeur nette (premier plan net, arrière-plan flou) s’animent généralement mieux, car le modèle peut plus facilement déduire les relations spatiales et appliquer un mouvement en couches.
Les modèles MiniMax I2V sur PicassoIA
PicassoIA héberge plusieurs modèles MiniMax conçus spécifiquement pour l’animation image vers vidéo. Chacun offre un équilibre différent entre vitesse, résolution et capacités.
Video 01 Live : l’animateur d’images de référence
Video 01 Live est le modèle dédié de MiniMax pour transformer une image fixe en vidéo. Il prend une seule photo et un prompt textuel, puis produit un clip vidéo de 6 secondes en haute résolution. C’est le modèle à privilégier lorsque vous disposez d’une photographie précise que vous souhaitez mettre en mouvement.
Points forts de Video 01 Live :
- Excellente préservation du sujet : la personne ou l’objet de votre photo reste visuellement cohérent du début à la fin
- Mouvement fluide et naturel, sans coupure brusque ni saccade entre les images
- Bonne réponse aux prompts de mouvement : vous pouvez indiquer ce qui bouge et comment
- Bonne gestion des scènes complexes comportant plusieurs sujets
Hailuo 02 et Hailuo 2.3 : sortie en plus haute résolution
Hailuo 02 produit une sortie en 1080p à partir d’entrées textuelles comme d’images. Pour les contenus où la résolution compte, comme la photographie de mode, la présentation de produits ou l’animation de paysages, Hailuo 02 vous offre nettement plus de pixels à exploiter.
Hailuo 2.3 est la dernière itération, avec une naturalité du mouvement améliorée et une meilleure gestion des sujets humains. Si vous animez des portraits, Hailuo 2.3 restitue des micro-expressions faciales crédibles et une physique des cheveux remarquablement précise.
Pour un délai de génération plus court à une résolution légèrement inférieure, Hailuo 02 Fast et Hailuo 2.3 Fast offrent la même qualité, avec une génération environ 40 % plus rapide et un plafond de sortie de 512p.
Video 01 Director : ajouter le contrôle de caméra
Video 01 Director est une variante spécialisée qui ajoute un contrôle explicite des mouvements de caméra. Au lieu de seulement décrire ce que les sujets doivent faire, vous pouvez indiquer directement les comportements de la caméra :
| Commande de caméra | Ce qu’elle fait |
|---|
pan left / pan right | Balayage horizontal de la caméra sur la scène |
tilt up / tilt down | Rotation verticale de la caméra |
zoom in / zoom out | Changement simulé de la distance focale |
push in | La caméra se déplace physiquement vers le sujet |
crane up | Mouvement vertical ascendant de la caméra |
static | La caméra reste immobile, le sujet se déplace |
Cela fait de Video 01 Director le choix idéal lorsque vous recherchez un rendu de qualité cinématographique plutôt qu’une simple photo qui bouge.
Également disponible : Video 01, la variante texte vers vidéo du même modèle de base, pour générer des scènes à partir de zéro plutôt que d’animer une image existante.
Des prompts qui donnent de vrais résultats
Le prompt textuel que vous rédigez influence fortement le type de mouvement généré, même lorsque c’est l’image qui fait l’essentiel du travail. Une structure précise produit systématiquement de meilleurs résultats.
Structurer votre prompt de mouvement
Un prompt I2V bien structuré comporte trois éléments :
- Action du sujet : ce que le sujet principal doit faire (« la femme tourne lentement la tête vers la droite »)
- Comportement de l’environnement : ce qui se passe autour du sujet (« le vent traverse l’herbe derrière elle »)
- Comportement de la caméra : la manière dont la perspective évolue (« léger travelling avant vers son visage »)
Exemple de prompt faible :
« Une belle femme sur une plage. »
Cela ne donne au modèle aucune information au-delà de l’image elle-même. Le résultat sera probablement une vidéo où presque rien ne bouge, ou bien où des éléments aléatoires bougent de façon imprévisible.
Exemple de prompt efficace :
« La femme lève lentement le regard vers l’horizon, ses cheveux se soulevant dans une douce brise marine, les vagues derrière elle déferlant doucement, la caméra reste fixe. »
Ce qui nuit à la qualité du mouvement
Plusieurs éléments dégradent systématiquement le résultat I2V :
- Prompts surchargés : décrire dix mouvements différents à la fois déroute le modèle. Choisissez-en deux ou trois et décrivez-les clairement.
- Images sources à faible contraste : les images à l’éclairage plat et uniforme fournissent moins d’informations spatiales au modèle. Les images plus contrastées s’animent de façon plus fiable.
- Gros plans extrêmes sans contexte environnemental : le modèle n’a alors rien d’autre à animer que le sujet, ce qui entraîne souvent une dérive faciale subtile ou un scintillement de la texture.
- Mouvements contraires à la physique : si l’image montre une pièce calme, demander « une forte pluie dehors » donnera des résultats incohérents.
La règle de la précision
💡 La précision l’emporte toujours sur la longueur. « Sa main gauche s’ouvre lentement » vaut mieux que « elle fait un geste gracieux de la main dans un mouvement ample et fluide ».
Un prompt de 15 mots qui décrit précisément un seul mouvement obtient systématiquement de meilleurs résultats qu’un prompt de 60 mots qui évoque vaguement plusieurs gestes. Soyez concret, situez les éléments dans l’espace et utilisez un langage directionnel chaque fois que c’est possible.
PicassoIA propose Video 01 Live directement dans sa collection. Voici le processus exact :
Étape 1 : préparez votre image source
Votre image doit être :
- Nette, bien éclairée et précise
- D’au moins 512 x 512 pixels
- Montrant le sujet dans une pose naturelle, non extrême
- Au format JPEG ou PNG
Étape 2 : ouvrez Video 01 Live
Rendez-vous sur Video 01 Live dans la collection PicassoIA. Vous verrez la zone d’import de l’image et le champ de saisie du prompt.
Étape 3 : importez votre image
Cliquez sur la zone d’import et sélectionnez votre image source. PicassoIA affiche un aperçu confirmant que l’image a bien été chargée avant de passer à la suite.
Étape 4 : rédigez votre prompt de mouvement
Utilisez la structure en trois éléments décrite plus haut. Précisez ce qui bouge, la direction du mouvement et ce que fait la caméra (ou si elle reste fixe).
Étape 5 : réglez vos paramètres
| Paramètre | Réglage recommandé | Remarques |
|---|
| Durée | 6 secondes | Standard pour la plupart des usages |
| Résolution | 1080p | Une sortie plus élevée demande plus de temps de traitement |
| Intensité du mouvement | Moyenne | Des réglages élevés peuvent provoquer une instabilité visuelle |
Étape 6 : générez et vérifiez le résultat
Cliquez sur générer. La génération prend généralement de 60 à 120 secondes. Examinez le résultat en portant attention à la cohérence du sujet tout au long du clip, à la présence du mouvement demandé, ainsi qu’aux éventuels scintillements ou artefacts de déformation.
Étape 7 : itérez
Si le mouvement est trop discret, augmentez l’intensité ou reformulez le prompt de manière plus explicite. Si vous constatez des artefacts, essayez un recadrage légèrement différent de l’image source, ou réduisez le nombre de mouvements que vous demandez au modèle d’exécuter simultanément.
I2V ou texte vers vidéo : quand utiliser chacun
Le choix entre image vers vidéo et texte vers vidéo ne dépend pas de la qualité. Il dépend du contrôle.
| Situation | Utiliser I2V | Utiliser texte vers vidéo |
|---|
| Vous disposez d’une photo précise à animer | Oui | Non |
| Vous voulez un style visuel cohérent à partir d’une référence | Oui | Non |
| Vous avez besoin d’une scène qui n’existe pas encore | Non | Oui |
| Vous voulez un contrôle total sur l’apparence du sujet | Oui | Non |
| Générer à grande échelle avec des scènes variées | Non | Oui |
| L’identité du sujet doit être préservée à l’identique | Oui | Non |
Les modèles texte vers vidéo comme Hailuo 2.3 et Video 01 vous laissent plus de liberté créative, mais moins de contrôle sur les détails. L’I2V offre l’inverse : un contrôle serré sur l’apparence du sujet, et un contrôle guidé sur ce qu’il fait.
Pour la plupart des créateurs de contenu, le flux de travail optimal consiste à générer d’abord une image saisissante avec la collection texte vers image de PicassoIA, puis à l’animer avec Video 01 Live. Cette combinaison offre à la fois une liberté créative et une cohérence visuelle dans un seul enchaînement.
5 cas d’usage concrets dès aujourd’hui
1. Contenus pour les réseaux sociaux à partir de photos de produits
Les marques de e-commerce animent leurs photos de produits : un flacon de parfum d’où s’élèvent des volutes de brume, une robe qui ondule légèrement sous une brise. L’identité du produit reste parfaitement fidèle, car elle est ancrée dans l’image source plutôt que générée à partir d’une description textuelle.
2. Vidéo de portrait pour les créateurs
Un seul portrait professionnel devient une courte vidéo en boucle pour un site web ou un profil de réseau social. Hailuo 2.3 gère les micro-mouvements du portrait (clignements, légère inclinaison de la tête, respiration) mieux que presque tous les autres modèles concurrents disponibles aujourd’hui.
3. Contenus de paysage et de nature
Les photographes animent leurs meilleurs clichés : eau qui coule, nuages qui dérivent, arbres agités par le vent. Le modèle Wan 2.7 I2V est une autre option solide pour les scènes naturelles si vous souhaitez comparer les résultats entre différentes architectures.
4. Mode et éditorial
Une seule photo de mode éditoriale devient un court métrage. Le modèle préserve le vêtement exact, l’identité du mannequin et l’éclairage tout en ajoutant un mouvement naturel. Associez-le à Crystal Video Upscaler pour porter le résultat en 4K pour la publication.
5. Animation de photos historiques
Des photographies de famille anciennes, des images d’archives ou des portraits historiques peuvent être animés pour créer des contenus narratifs chargés d’émotion. Video 01 Live gère les visages de toutes les époques avec une forte cohérence visuelle.
Post-traitement de votre sortie I2V
Générer la vidéo n’est que la première étape. La rendre prête à être publiée implique généralement deux étapes supplémentaires.
Upscaling pour la diffusion
Video 01 Live produit une sortie de haute qualité, mais si vous avez besoin d’une 4K prête pour la diffusion, passer le résultat dans Crystal Video Upscaler ou Topaz Video Upscale ajoute une résolution et une netteté importantes sans régénérer la vidéo depuis le début.
Ajouter du son
Une vidéo muette a un impact bien moindre que la même vidéo accompagnée de son. Les outils audio de PicassoIA vous permettent d’ajouter une voix off grâce aux modèles de synthèse vocale, ou de générer une bande son personnalisée grâce aux modèles de génération de musique par IA, adaptée à l’ambiance et au rythme de votre vidéo.
💡 Astuce de flux de travail : générez votre image, animez-la avec Video 01 Live, upscalez-la avec Topaz Video Upscale, puis ajoutez une bande son générée. Quatre outils, un seul livrable soigné.
Ce que signifient réellement les paramètres
Lorsque vous voyez des modèles I2V décrits avec des réglages, voici ce que chacun affecte réellement :
| Paramètre | Ce qu’il contrôle | Effet concret |
|---|
| Intensité du mouvement | Le degré d’écart du modèle par rapport à la source | Plus élevée = plus de mouvement, risque de dérive accru |
| Étapes | Itérations de débruitage | Plus d’étapes = qualité supérieure, génération plus lente |
| Échelle CFG | Le degré de fidélité du modèle au prompt textuel | Plus élevée = interprétation plus littérale |
| Seed | Motif de bruit initial aléatoire | Même seed + mêmes entrées = résultat reproductible |
| Durée | Nombre d’images générées | Les clips plus longs demandent davantage de temps de calcul |
Pour la plupart des usages I2V, laisser l’intensité du mouvement sur moyen et l’échelle CFG sur la valeur par défaut constitue le point de départ idéal. Ajustez seulement une fois que vous disposez d’un premier résultat à améliorer.
Vos photos sont déjà une matière première
Chaque photographie nette et bien éclairée que vous avez prise est un clip vidéo potentiel. La technologie permettant de la transformer en mouvement véritablement cinématographique s’exécute dans le cloud, coûte quelques centimes par génération, et produit des résultats qui auraient nécessité une équipe de production complète il y a seulement quelques années.
L’architecture I2V de MiniMax, notamment Video 01 Live, Hailuo 02 et Hailuo 2.3, figure parmi les meilleures solutions accessibles au public à l’heure actuelle. Tous sont disponibles sur PicassoIA sans GPU local, sans installation de logiciel et sans configuration technique.
Choisissez une photo. Rédigez un prompt de mouvement. Observez ce que fait le modèle. La première tentative n’a que rarement vocation à être la dernière.