Tous ceux qui publient des démonstrations de Sora 2 Pro vous montrent les rendus les plus séduisants, obtenus avec les prompts les plus sages. Une femme qui marche dans des feuilles d’automne. Un chien qui court sur une plage. Un chef qui émince des légumes avec une technique de couteau parfaite.
Ce n’est pas ainsi que l’on découvre ce qu’un modèle sait vraiment faire.
Cet article soumet Sora 2 Pro aux tests qui comptent : foules denses, simulations de physique complexes, mouvements rapides, visages humains en gros plan, rendu de texte et scènes à plusieurs éléments où le raisonnement spatial s’effondre pour la plupart des générateurs. Pas de prompts sous tutelle. Pas de tri des rendus les plus flatteurs. Voici ce que vous obtenez quand vous cessez de faire dans la dentelle.
Ce que signifie vraiment le mode sans filtre
L’expression « sans filtre » dans les tests de génération de vidéos par IA ne signifie pas générer des contenus inappropriés. Elle désigne le retrait du coussin de prompt engineering : ces précisions et ces formulations adoucies que la plupart des créateurs ajoutent pour obtenir un meilleur résultat d’un modèle qui, sans cela, laisserait voir ses faiblesses.
Les créateurs professionnels de vidéos par IA sur-spécifient régulièrement leurs prompts : « mouvement lent et doux », « mouvement de caméra minimal », « arrière-plan simple », « un seul personnage ». Ce sont autant de béquilles qui masquent ce avec quoi le modèle peine. Retirez-les et vous commencez à voir la situation réelle.
Pourquoi la plupart des tests de Sora sont aseptisés
Les démonstrations marketing sont conçues pour maximiser l’attrait visuel, pas pour révéler les modes de défaillance. C’est vrai pour toutes les entreprises, pas seulement pour OpenAI. Quand un modèle peine avec les mains, la démonstration évite les mains. Quand les scènes de foule perdent leur cohérence spatiale, la démonstration montre un seul sujet. Quand le rendu du texte s’effondre, la démonstration retire toute signalétique de la scène.
Le travail créatif en conditions réelles n’a pas ce luxe. Un réalisateur qui utilise des outils de vidéo par IA pour une production doit savoir exactement où le modèle se désagrège avant de s’engager sur un projet qui dépend de capacités précises. La différence entre « ça a l’air génial en démo » et « ça fonctionne pour mon tournage réel », c’est l’écart que cet article cherche à combler.
Les vrais tests de stress
Cinq catégories révèlent systématiquement les limites des modèles de génération de vidéos :
- Physique complexe : dynamique des fluides, simulation de tissu, comportement lors des collisions
- Scènes de foule : plusieurs humains en mouvement qui conservent chacun leur identité
- Mouvements extrêmes : action rapide, panoramiques brusques, moments d’impact
- Anatomie humaine : mains, doigts, cohérence du visage d’une image à l’autre
- Rendu de texte : texte lisible qui reste cohérent pendant le mouvement
Ce sont les cinq scénarios qui distinguent les modèles qui impressionnent dans un GIF de deux secondes de ceux qui tiennent sur un plan de production de cinq secondes.
Sora 2 Pro face à la concurrence
Sora 2 Pro se situe au sommet de la gamme de génération vidéo d’OpenAI. Ce n’est pas un modèle léger. C’est le système phare d’OpenAI pour le texte vers vidéo, fondé sur une architecture de transformeur de diffusion et doté de ce que l’entreprise décrit comme des capacités de simulation du monde. Le modèle est entraîné pour prédire des évolutions physiquement plausibles, et non seulement des séquences d’images esthétiquement agréables.
Ce qui distingue Sora 2 Pro
Trois éléments distinguent Sora 2 Pro des modèles de vidéo générique par diffusion :
Cohérence temporelle : La plupart des générateurs de vidéo hallucinent d’une image à l’autre. Une main change de forme. Un objet d’arrière-plan se téléporte. L’architecture de Sora 2 Pro est spécialement conçue pour maintenir l’identité des objets sur toute la durée du clip.
Plausibilité physique : Le modèle a été entraîné sur des données de physique du monde réel. Lorsque vous demandez une éclaboussure d’eau, elle ne ressemble pas seulement à une éclaboussure d’eau : elle se comporte comme telle. Les trajectoires des gouttelettes, le comportement de la tension superficielle et le déplacement du fluide suivent des règles.
Fidélité au prompt : Le modèle dispose d’une large fenêtre de contexte pour le traitement des instructions. Vous pouvez rédiger des prompts complexes à plusieurs propositions et vous attendre à retrouver un plus grand pourcentage de ces détails dans le rendu, par rapport aux modèles plus petits.
Comment il se compare
| Modèle | Cohérence temporelle | Fidélité physique | Gestion des foules | Rendu de texte |
|---|
| Sora 2 Pro | Excellente | Solide | Bonne | Faible |
| Veo 3 | Solide | Excellente | Bonne | Correcte |
| Kling v3 Video | Bonne | Correcte | Correcte | Faible |
| Seedance 2.5 | Correcte | Correcte | Faible | Faible |
| Ray 3.2 | Bonne | Bonne | Correcte | Faible |
Il ne s’agit pas d’un benchmark académique. C’est une évaluation pratique fondée sur des catégories de tests qui comptent pour de vraies productions.
Les tests de limites
Voici ce qui se passe quand on fait passer Sora 2 Pro dans chaque catégorie sans adoucir les prompts.
Physique complexe et dynamique des fluides
La simulation de fluides est l’un des problèmes les plus difficiles de la génération vidéo. L’eau n’a pas de forme fixe, réagit à chaque surface qu’elle touche et se comporte différemment selon le volume, la vitesse et les conditions environnementales. C’est le type de physique qui révèle les failles de tout système génératif.
Prompt testé : « Un ballon d’eau rempli à sa capacité maximale qui éclate au ralenti sur une surface en béton, filmé à trois pieds de distance, à hauteur des yeux. L’eau jaillit dans toutes les directions. La membrane en caoutchouc est visible au moment où elle se déchire. Tourné à 1000 fps. »
Résultat : Sora 2 Pro gère le mouvement général (le ballon se gonfle puis éclate), mais les détails fins de la membrane qui se déchire présentent des incohérences d’une image à l’autre. Les gouttelettes d’eau de la projection n’ont pas la répartition de trajectoires physiquement exacte que l’on observerait dans une vraie séquence à haute vitesse. L’éclaboussure est impressionnante pour une vidéo générée par IA. Elle ne résiste pas à un examen minutieux.
Pour une production créative, ce rendu est plus que suffisant. Pour de la visualisation scientifique, il est insuffisant.
💡 Conseil pratique : Pour les plans de physique des fluides, combinez un clip Sora 2 Pro avec une passe de super-résolution grâce à LTX 2.3 Pro. Le modèle gère l’upscaling en 4K, qui ajoute des détails fins convaincants aux motifs d’éclaboussures après la génération.
Scènes de foule et visages
C’est là que presque tous les modèles vidéo actuels peinent. Le défi : dix personnes qui marchent vers la caméra dans une rue de la ville, chacune conservant sa propre identité, ses vêtements et son rythme de marche sur un clip de cinq secondes.
Prompt testé : « Un trottoir animé en plein après-midi à Midtown Manhattan, dix piétons nettement distincts marchant vers la caméra, âges et vêtements variés. Lumière couverte. Plan moyen. Travelling avant lent. »
Résultat : Sora 2 Pro génère une foule convaincante. Les piétons conservent des vêtements cohérents tout au long du clip. Il n’y a pas de « fusion de piétons », cet artefact visuel où deux membres de la foule se confondent en une seule personne lorsqu’ils se chevauchent. Les visages restent cohérents, mais présentent un léger lissage qui trahit une génération synthétique à l’examen de près.
La gestion des foules par le modèle est la meilleure disponible actuellement dans le catalogue de texte vers vidéo de PicassoIA. Pour les arrière-plans et les plans d’établissement, le rendu atteint une qualité de diffusion. Pour les travaux de foule en gros plan, combiner Sora 2 Pro avec une passe de correction des visages en post-production donne des résultats nettement meilleurs.
💡 Les plans larges et les distances moyennes masquent mieux les coutures de la vidéo IA que les gros plans. Concevez votre production en conséquence.
Mouvements rapides et séquences d’action
L’action à grande vitesse est une faiblesse connue des modèles de diffusion vidéo. La cohérence d’une image à l’autre devient plus difficile à maintenir quand les sujets se déplacent sur de grandes distances entre deux images. Le système visuel dispose de moins de temps pour établir à quoi ressemble un objet avant de devoir le montrer dans une nouvelle position.
Prompt testé : « Un sprinteur de 100m franchissant la ligne d’arrivée au ralenti, filmé à 10 pieds à hauteur de piste. Muscles visibles. Sueur en suspension. Foulée à extension complète. Lumière dorée de fin d’après-midi. »
Résultat : C’est là que Sora 2 Pro se distingue réellement de ses concurrents. Le modèle gère bien la physique du ralenti. La déformation musculaire suit une logique anatomique, les trajectoires des gouttes de sueur sont plausibles et le flou de bougé en arrière-plan s’adapte correctement à la vitesse de lecture implicite. En lançant le même prompt sur Kling v3 Video, on observe une déformation anatomique nettement plus marquée en pleine foulée. Sur Seedance 2.5, la physique du mouvement paraît approximative plutôt que précise.
Pour la production sportive et les contenus d’action, Sora 2 Pro est actuellement l’option de vidéo par IA la plus performante.
Ce en quoi il excelle
Respect du prompt
Sora 2 Pro lit mieux les prompts complexes à plusieurs propositions que tout autre modèle disponible actuellement. Lorsque vous rédigez un prompt avec sept descripteurs distincts (direction de l’éclairage, angle de caméra, action du sujet, détails de l’arrière-plan, ambiance, météo et vitesse du mouvement), vous obtenez des rendus qui en traitent la plupart. Les modèles concurrents réduisent souvent les prompts à plusieurs éléments à leur lecture la plus simple, produisant une scène qui capture le sujet mais ignore tout le reste.
Cela compte dans les flux de travail de production, car cela réduit le nombre d’itérations. Moins de temps à regénérer, plus de temps à utiliser les rushes que vous vouliez vraiment.
Composition cinématographique
Le modèle a manifestement été entraîné sur des références de cinématographie de haute qualité. Le cadrage par défaut suit des règles de composition : règle des tiers, lignes de fuite, mouvement de caméra motivé. Vous obtenez des rendus cinématographiquement compétents sans avoir à écrire « cinématographique » dans le prompt. La différence est visible par rapport à des modèles comme Wan 2.7 T2V, qui produit une vidéo techniquement correcte, avec un cadrage plus neutre et moins dirigé.
Ce qui casse
Mains et doigts
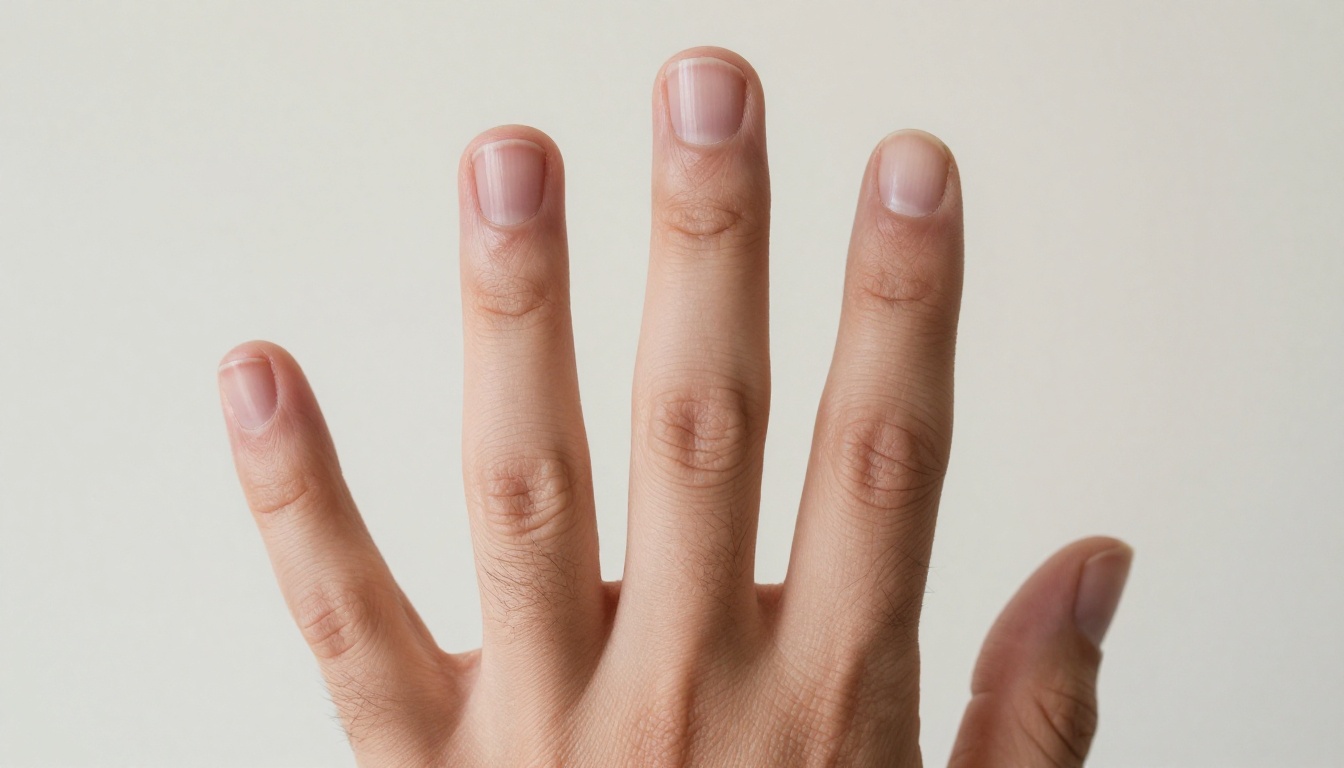
Les mains restent le point de défaillance le plus systématique de tous les modèles de génération vidéo, et Sora 2 Pro n’y échappe pas. Quand une main est le sujet principal d’un plan serré, clairement cadrée et bien décrite au centre de l’image, le modèle produit des mains anatomiquement correctes avec une grande fidélité. Le problème apparaît quand les mains sont accessoires : un personnage fait un geste en parlant, saisit un objet ou désigne quelque chose en arrière-plan.
Dans ces cas, attendez-vous à des doigts en trop, à des articulations pliées en arrière ou à des doigts qui fusionnent puis se séparent d’une image à l’autre. Ce n’est pas propre à Sora 2 Pro. C’est là que la génération actuelle de modèles vidéo peine uniformément.
💡 Solution de contournement : Formulez vos prompts de manière à ce que les mains ne soient jamais accessoires. Si un personnage doit gesticuler, faites du geste l’action principale du clip. Le modèle accorde davantage d’attention à ce que vous décrivez comme important. Les mains en arrière-plan d’un plan sont presque toujours une erreur.
Rendu de texte
Si votre scène exige un texte lisible, un panneau, un titre de livre, une ardoise, Sora 2 Pro produira quelque chose qui ressemble à du texte sans être du texte lisible. Les lettres dérivent et se transforment d’une image à l’autre. Le modèle sait à quoi ressemble un texte mieux qu’il ne sait ce que le texte signifie.
C’est une limite fondamentale de l’approche par diffusion. Le modèle apprend à partir de motifs de pixels, et le texte est un motif de détails haute fréquence que les modèles de diffusion gèrent mal lorsqu’il doit rester stable d’une image à l’autre.
Solutions de contournement :
- Retirez tout texte de vos prompts de vidéo par IA et ajoutez-le en composition en post-production
- Utilisez une « texture de texte » très floue ou lointaine plutôt qu’un texte précis et lisible
- Acceptez un pseudo-texte stylisé comme choix artistique lorsque l’illisibilité paraît intentionnelle
Cohérence avec les prompts longs
Il existe une zone idéale pour la complexité des prompts avec Sora 2 Pro. En dessous d’environ 80 mots, le modèle produit des rendus qui paraissent légèrement génériques. Au-delà d’environ 150 mots, le respect du prompt commence à se dégrader. Le modèle semble accorder plus de poids aux instructions placées en début de texte qu’à celles placées plus loin.
Concrètement, placez vos spécifications les plus importantes au début du prompt, et non à la fin. Si votre exigence critique concerne l’angle de caméra, elle vient en premier. Si la condition d’éclairage compte le plus, elle vient en premier. Tout ce dont dépend le plan doit figurer dans la proposition d’ouverture.
Utiliser Sora 2 Pro sur PicassoIA
Sora 2 Pro est disponible directement sur PicassoIA, sans configuration, sans clé d’API et sans liste d’attente. Voici le flux de travail étape par étape qui donne les meilleurs résultats, d’après nos tests réels.
Étape 1 : rédiger d’abord le cœur du prompt
Commencez uniquement par l’action : « Une femme marche dans une rue de la ville, la nuit, sous la pluie. » Lancez le rendu. Observez vers quoi le modèle se dirige par défaut. C’est votre référence. Elle vous indique l’interprétation naturelle du modèle avant que vous n’ajoutiez des couches de spécifications.
Étape 2 : ajouter les spécifications par ordre de priorité
Ajoutez une spécification à la fois, par ordre d’importance pour votre plan :
- Position de la caméra : « Prise de vue à hauteur des yeux, travelling avant lent »
- Éclairage : « Réverbères ambre chauds, reflets sur le trottoir mouillé »
- Détail du sujet : « Femme d’une quarantaine d’années, manteau sombre, allure tranquille »
- Atmosphère : « Pluie fine qui tombe encore, vapeur sortant d’une bouche d’égout près du trottoir »
Cette approche itérative vous permet d’isoler les spécifications qui sont respectées et celles qui sont ignorées, afin d’ajuster sans deviner.
Étape 3 : régler la résolution au maximum
Sélectionnez toujours la résolution la plus élevée disponible pour les rendus de Sora 2 Pro. Les détails fins du modèle (pluie, reflets, texture des vêtements) ne ressortent qu’en haute résolution. Les rendus réduits perdent une grande partie de ce qui rend ce modèle plus intéressant que des alternatives plus rapides et moins chères comme Seedance 2.5.
Étape 4 : itérer avant de valider
Lancez trois variantes avant de valider un rendu final. Le modèle présente une variance importante d’un lancement à l’autre pour un même prompt. Votre meilleur rendu est rarement la première génération. Cette variance fait partie de la plage créative du modèle, et non d’un défaut : traitez-la comme un échantillon d’une distribution et choisissez le meilleur résultat.
💡 Astuce de texture : Si vous obtenez une peau de visage en gros plan trop lisse, d’aspect un peu plastique, ajoutez « grain de film, texture naturelle de la peau, tourné en 35 mm » à la fin de votre prompt. Cela oriente le modèle vers une référence photographique plutôt que numérique, pour des rendus plus naturels.
D’autres modèles à essayer
Sora 2 Pro n’est pas le bon outil pour chaque plan. Le catalogue de PicassoIA propose d’excellentes alternatives pour des usages précis, et savoir quand changer fait gagner du temps et du budget.
Pour la génération rapide : Seedance 2.5 produit des clips de 30 secondes à une qualité compétitive, avec un délai d’exécution bien plus court. Quand vous itérez rapidement et que vous avez besoin de volume plutôt que de perfection, c’est le meilleur choix. Il gère aussi très efficacement les scènes à mouvement simple et les plans de type face caméra.
Pour la sortie en 4K : LTX 2.3 Pro de Lightricks offre une véritable génération en 4K. La qualité de mouvement n’égale pas celle de Sora 2 Pro sur les scènes complexes, mais pour des contenus statiques ou à mouvement lent en résolution maximale, il donne de beaux résultats qui dépassent ce que son prix laisse attendre.
Pour la vidéo avec audio natif : Veo 3 de Google génère des vidéos avec un son synchronisé natif (dialogues, ambiance sonore, effets), intégré directement au clip. Si votre production exige un son synchronisé, c’est actuellement la meilleure option de la plateforme. Sora 2 Pro ne génère pas de son : il faudra l’ajouter séparément.
Pour le long format cinématographique : Ray 3.2 de Luma gère un rendu cinématographique en HDR avec une forte cohérence temporelle sur des sujets à mouvement plus lent. Pour les projets de fiction exigeant un étalonnage de qualité, il rivalise directement avec Sora 2 Pro dans certains scénarios.
Pour le texte vers vidéo à grande échelle : Wan 2.7 T2V produit du 1080p et gère efficacement les flux de génération à fort volume. Pour les contenus sociaux et la publicité, où la quantité compte, c’est un bon compromis qui ne vide pas votre solde de crédits sur un seul projet.
Vous pouvez parcourir et comparer tous les modèles de texte vers vidéo disponibles, dont Sora 2, Pixverse v6 et plus de 100 autres, sur picassoia.com/en/all-models.
Commencez à générer dès maintenant
L’écart entre « regarder des démonstrations de Sora 2 Pro » et « savoir ce qu’il fait réellement » ne se comble que lorsque vous lancez de vrais prompts sur de vrais scénarios. Lire sur les modes de défaillance est utile. Les tester soi-même est la seule chose qui vous prépare réellement à utiliser le modèle en production.
PicassoIA réunit Sora 2 Pro et tout le champ concurrentiel, dont Veo 3, Kling v3 Video, Ray 3.2 et Seedance 2.5, sur une seule plateforme, sans clés d’API séparées, sans contrainte de palier d’utilisation ni engagement minimum. Vous lancez le test, vous voyez le résultat, vous passez au modèle suivant.
C’est ainsi que l’on construit réellement un flux de travail de production vidéo par IA fiable : non pas en lisant ce que les modèles peuvent faire en théorie, mais en les mettant volontairement à l’épreuve jusqu’à savoir exactement ce qu’ils délivrent. Arrêtez de regarder les démonstrations soignées. Commencez à lancer vous-même les tests de stress sur picassoia.com.


