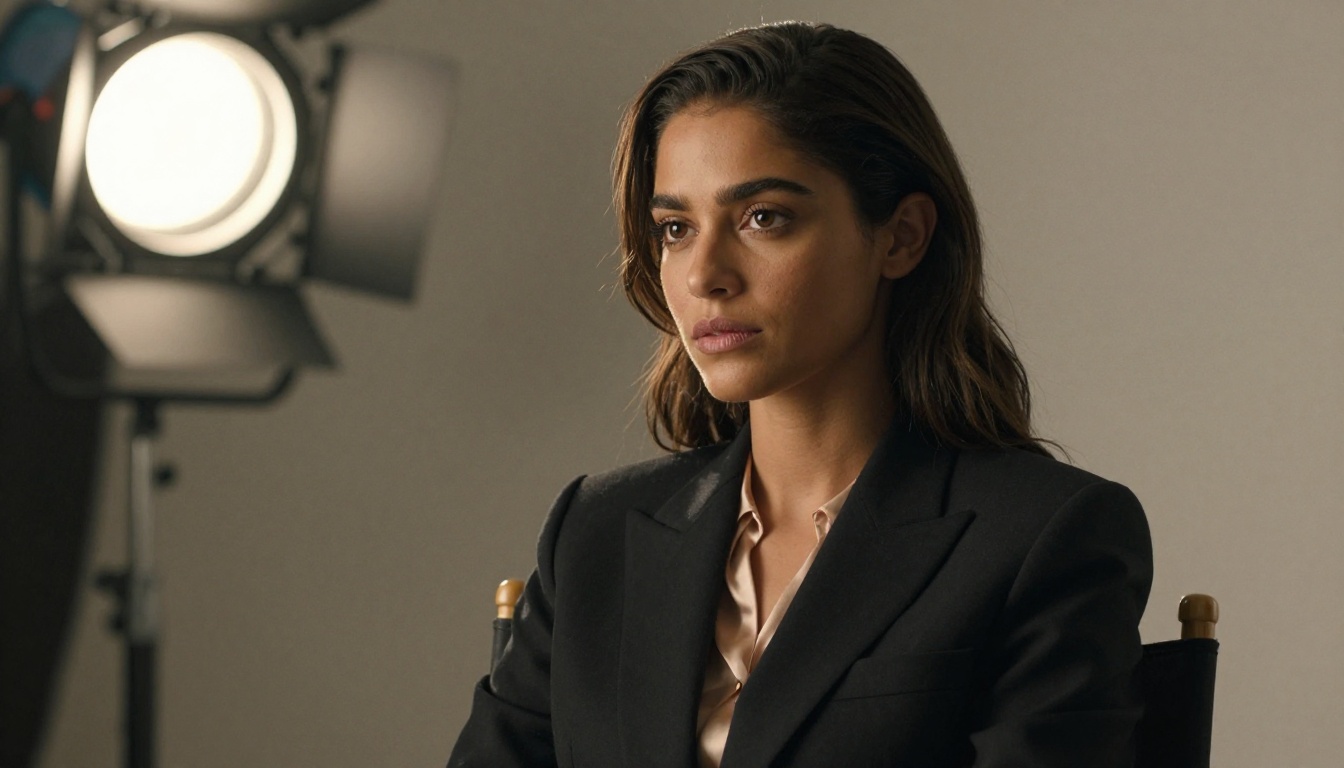
Il y a quelque chose de presque absurde à voir une seule phrase devenir un plan de 10 secondes digne d’Hollywood. Pas d’équipe, pas de location de matériel, pas de directeur de la photographie qui discute de l’ouverture du diaphragme. Un simple prompt suffit, et Seedance 2.0 fait le reste. ByteDance a lancé ce modèle sous les acclamations, mais ce qu’il produit dépasse le battage médiatique : un mouvement fluide, une profondeur cinématographique, des déplacements conformes à la physique et, désormais, un audio natif intégré à chaque clip. C’est le genre de bond qui donne l’impression que les outils de texte vers vidéo de la génération précédente ne sont que des brouillons.
Ce que Seedance 2.0 fait réellement
Seedance 2.0 est un modèle de texte et d’image vers vidéo développé par ByteDance. Il prend une description écrite et renvoie un clip vidéo doté d’une fidélité de mouvement remarquable, d’un éclairage photoréaliste et d’un son synchronisé. Contrairement aux modèles antérieurs, qui traitaient le son comme un détail à ajouter en post-production, Seedance 2.0 génère l’audio nativement avec le contenu visuel, en considérant les deux comme les parties indissociables d’un même résultat.
Les résultats parlent d’eux-mêmes :
- Cohérence temporelle : les objets, les visages et les arrière-plans restent cohérents d’une image à l’autre
- Mouvement conforme à la physique : l’eau se déplace comme de l’eau, le tissu se plisse comme du tissu, les cheveux réagissent au vent avec une inertie crédible
- Synthèse audio native : les ambiances sonores, les bruits de mouvement et l’audio environnemental apparaissent en synchronisation avec l’action à l’écran
- Intelligence du cadrage cinématographique : le modèle comprend la profondeur de champ, les mouvements de caméra et le langage de composition
- Rendu photoréaliste : les textures de la peau, les tissages des tissus et les matériaux de surface atteignent une qualité qui résiste à l’examen
Lorsque vous écrivez « une femme en robe blanche traverse lentement un champ de blé à l’heure dorée », Seedance 2.0 renvoie quelque chose qui paraît sorti d’une bobine de production cinématographique, et non d’une démonstration IA sans intérêt. C’est cette constance qui distingue ce modèle de la vague d’outils de texte vers vidéo qui l’ont précédé.
La technologie en coulisses
ByteDance a construit Seedance 2.0 sur une base de synthèse vidéo par diffusion, combinée à un corpus d’entraînement audiovisuel à grande échelle. Le modèle a été entraîné sur des millions de clips vidéo de haute qualité associés à des descriptions textuelles précises, ce qui lui donne une compréhension approfondie de la manière dont le monde physique se déplace et produit des sons. Ces données d’entraînement permettent au modèle de généraliser de façon convaincante à des prompts qu’il n’a jamais rencontrés.
Ce qui distingue cette architecture des premiers générateurs de vidéo par IA, c’est sa manière de représenter le temps. Les modèles de diffusion d’images classiques travaillent en deux dimensions spatiales. La synthèse vidéo en exige une troisième, temporelle, et la plupart des premiers modèles la géraient en générant les images indépendamment, puis en les assemblant. Le résultat était cohérent sur une image isolée, mais se délitait au fil du clip, avec des effets de fantômes et de déformation qui donnaient aux premières vidéos IA un aspect étrange.
Comment le mouvement gagne en qualité
Seedance 2.0 aborde la cohérence temporelle grâce à une architecture hybride qui traite simultanément les informations spatiales et temporelles, au lieu de les séparer en passes distinctes. Le modèle ne génère pas d’abord la première image, puis la deuxième. Il modélise l’ensemble du clip comme une structure spatiotemporelle unifiée, ce qui explique pourquoi les objets conservent leur identité et leur physique dans le temps.
La gestion des mouvements de caméra est particulièrement aboutie. Si vous demandez un travelling avant dans votre prompt, la parallaxe entre les objets du premier plan et ceux de l’arrière-plan se déplace exactement comme sur un vrai plateau doté d’un chariot sur rails. Demandez un panoramique lent sur une ligne de toits de ville, et l’éclairage des bâtiments évolue naturellement à mesure que l’objectif virtuel balaie l’espace. Ce n’est pas un simple zoom ni un recadrage. Le modèle génère de véritables changements de perspective, avec des relations de profondeur exactes.
Conseil d’expert : utilisez un langage de caméra cinématographique dans vos prompts. Des expressions comme « plan suivi en contre-plongée », « perspective de drone en plongée » ou « lent rapprochement sur le sujet » activent des comportements que le modèle a appris à partir de séquences réelles de films et de productions télévisuelles.
Un audio natif qui s’accorde au cadre
C’est la fonctionnalité qui distingue Seedance 2.0 de presque tout ce qui figure actuellement en tête des classements de texte vers vidéo. Le modèle ne génère pas une vidéo muette à laquelle il ajoute ensuite un son dans une étape de post-traitement. Il synthétise les deux dans un processus génératif unifié, où les signaux visuels et audio s’influencent mutuellement.
Concrètement, cela donne :
- Une scène de foule comprenant un bruit de fond, des conversations qui se chevauchent et le son des mouvements
- Un plan de falaise côtière produisant du vent et du ressac qui correspondent à l’intensité visuelle des vagues
- Une scène de cuisine animée avec le grésillement et le cliquetis des ustensiles, et le brouhaha de fond d’un restaurant
- Une scène de forêt calme générant un chant d’oiseaux discret et le léger bruissement des feuilles dans le vent
L’audio n’est pas toujours parfait au niveau d’une diffusion professionnelle, mais il est remarquablement adapté au contexte. Pour les créateurs de contenu qui ont besoin d’un montage brut complet rapidement, cela supprime toute une étape de production qui exigeait auparavant des outils séparés et une passe de sound design.
Seedance 2.0 face à la concurrence
Le marché du texte vers vidéo n’a jamais été aussi concurrentiel. Plusieurs modèles repoussent simultanément les limites de la génération vidéo cinématographique par IA. Voici une comparaison honnête de la place qu’occupe Seedance 2.0 :
Le tableau rend les compromis clairs. Veo 3 de Google devance Seedance 2.0 en qualité visuelle brute sur les scènes complexes, mais il tourne nettement plus lentement et coûte plus cher par génération. Sora 2 d’OpenAI produit des séquences exceptionnelles, mais il n’a pas d’audio natif et exige une solide maîtrise du prompt pour atteindre son plein potentiel.
Kling v3 est le concurrent le plus proche de Seedance 2.0 en matière de qualité de mouvement. Sur certains types de scènes, notamment les sujets humains et les gros plans dramatiques, il produit des résultats indiscernables. Mais l’absence d’audio natif constitue une véritable limite pour les créateurs qui veulent un clip complet sans travail de production supplémentaire.
Seedance 2.0 occupe un juste milieu très pratique : une qualité cinématographique, un audio natif, une vitesse accessible et un coût qui rend l’itération réaliste. Pour la plupart des créateurs, cet équilibre compte davantage que les gains marginaux de qualité d’un système qui coûte deux fois plus cher et prend trois fois plus de temps.
Seedance 2.0 est disponible directement sur PicassoIA, sans aucune installation locale. Pas de GPU requis, pas d’environnement Python, pas de clés API à gérer. Vous ouvrez un onglet de navigateur, écrivez un prompt et lancez la génération. Tout s’exécute sur l’infrastructure de PicassoIA.
Étape 1 : rédigez votre prompt
L’écart de qualité entre un prompt faible et un prompt solide est énorme avec Seedance 2.0. Le modèle est capable de produire des séquences cinématographiques, mais il a besoin de consignes claires pour orienter cette capacité dans la bonne direction. Un prompt efficace comprend tous ces éléments :
- Sujet : qui ou quoi occupe le cadre, avec une précision physique
- Action : ce qui se passe, formulé avec des verbes actifs au présent
- Environnement : où se déroule la scène, avec trois ou quatre détails concrets
- Éclairage : moment de la journée, direction de la source, qualité (dure ou douce) et ambiance
- Caméra : type de plan, angle et direction du mouvement
Prompt faible : « une femme sur une plage »
Prompt solide : « Une femme en robe rouge fluide se tient dans le ressac jusqu’aux chevilles au lever du soleil, une lumière rose chaude projette de longues ombres derrière elle sur le sable mouillé, la caméra glisse lentement vers la gauche dans un travelling latéral fluide, les vagues captent la lumière de l’aube en s’écoulant autour de ses pieds »
La différence dans le résultat n’est pas progressive. Elle est de nature.
Étape 2 : réglez vos paramètres
Sur PicassoIA, vous contrôlez la durée, la résolution et l’intensité du mouvement. Pour des résultats de qualité cinématographique :
- Durée : de 5 à 10 secondes donnent la meilleure qualité pour un plan unique. Les clips plus longs peuvent introduire une dérive de cohérence
- Résolution : utilisez le réglage le plus élevé disponible pour tout contenu que vous comptez publier
- Intensité du mouvement : les réglages moyens préservent les détails fins tout en produisant un mouvement crédible et perceptible
Astuce : réduisez l’intensité du mouvement pour les scènes de conversation statiques ou les gros plans intimes. Une intensité plus élevée convient aux séquences d’action, aux environnements naturels comme les océans et les forêts, et à toute scène dont le prompt décrit un mouvement explicite.
Étape 3 : relisez et itérez
Votre première génération n’est presque jamais la meilleure. Seedance 2.0 produit des résultats sensiblement différents à chaque essai, en raison de la nature stochastique de l’échantillonnage par diffusion. Un flux de travail type se présente ainsi :
- Si le mouvement paraît trop statique, ajoutez des consignes de mouvement explicites au prompt
- Si l’audio semble déconnecté de l’image, décrivez directement les éléments sonores dans le texte du prompt (« le fracas du ressac », « un roulement de tonnerre lointain », « une cuisine animée pendant le service du midi »)
- Si l’étalonnage des couleurs paraît terne ou trop saturé, ancrez votre description de l’éclairage à un moment précis de la journée et à un angle de source donné
Utilisez Seedance 2.0 Fast pour les cycles d’itération rapides pendant que vous affinez votre prompt, puis passez au modèle complet pour le rendu final de production.
Quels types de vidéos pouvez-vous créer
La question que l’on pose généralement est « quelles sont ses limites ? ». Mais après avoir réellement passé du temps avec Seedance 2.0, la question la plus intéressante devient : « que rend facile ce qui exigeait auparavant un budget de production complet ? »
Courts métrages cinématographiques
Seedance 2.0 gère les séquences narratives avec une véritable conviction. Des scènes qui exigeaient une équipe complète, des autorisations de tournage et une demi-journée de préparation ne se trouvent plus qu’à un prompt. Un détective qui marche dans les rues de la ville sous la pluie à minuit. Un couple qui partage un instant calme sur un balcon baigné de soleil. Une silhouette solitaire qui contemple une vaste chaîne de montagnes à l’aube. Une séquence d’action dans le couloir d’un immeuble en feu. Le modèle traite ces mises en scène avec le type d’intelligence spatiale et temporelle qui exigeait autrefois des directeurs de la photographie prenant des décisions sur le plateau.
Pour les créateurs de contenu court, cela ouvre la narration visuelle à une échelle qui était financièrement impossible auparavant.
Vidéos produit et publicités
Le contenu commercial figure parmi les applications les plus rentables de la génération vidéo par IA. Une basket de course immergée dans l’eau sous un éclairage contrasté par le bas. Un flacon de parfum posé sur une surface en marbre, avec la lumière douce du matin qui glisse sur ses facettes. Une montre mécanique au poignet lors d’une poignée de main assurée dans une salle de conseil. Ce sont exactement les types de plans que les agences de publicité paient des milliers de dollars de l’heure sur des plateaux physiques.
Seedance 2.0 rend ces plans accessibles aux marques indépendantes et aux créateurs solo. Combiné à Seedance 1.5 Pro pour les flux de travail conditionnés par image, vous pouvez prendre une photo de produit existante et l’animer en un clip commercial complet, avec mouvement, profondeur et son d’ambiance.
Contenu social à grande échelle
Les plateformes de contenu court fonctionnent sur le volume. Un créateur qui publie régulièrement a besoin de plusieurs dizaines de clips originaux par semaine pour maintenir sa portée. Seedance 2.0 rend ce volume soutenable. Rédigez dix variantes de prompt en une matinée, générez-les en parallèle, puis sélectionnez-les avant la fin de l’après-midi. La sortie audio native signifie que les clips sont souvent prêts à être publiés sans passe de sound design séparée.
Cela change de façon significative l’économie de la création de contenu. Une qualité qui exigeait auparavant une équipe de production de deux personnes est désormais accessible à un seul créateur muni d’un ordinateur portable.
La rédaction de prompts qui fonctionne vraiment
La rédaction de prompts pour les modèles vidéo est un savoir-faire qui diffère de celle des prompts pour les générateurs d’images. La vidéo exige de penser en temps autant qu’en espace. Une image fixe peut être décrite par ce qu’elle contient. Une vidéo doit aussi décrire ce qui change, la manière dont cela change et à quelle vitesse.
Ces principes donnent systématiquement de meilleurs résultats avec Seedance 2.0 :
Décrivez explicitement le mouvement. Ne partez pas du principe que le modèle animera la scène. Indiquez ce qui bouge. « La caméra avance lentement. » « Ses cheveux flottent dans le vent côtier. » « La fumée monte en spirales lentes depuis une cheminée. » Sans consignes de mouvement, le modèle adopte par défaut un déplacement minimal, ce qui peut donner des clips qui paraissent figés.
Ancrez votre éclairage. Un vocabulaire d’éclairage générique produit des résultats incohérents. « Éclairage dramatique » ne veut rien dire de précis pour le modèle. « Une lumière principale venue du haut à gauche, projetant une ombre triangulaire sur sa joue, et une ombre profonde sur le côté droit du visage » lui indique exactement ce qu’il doit produire et active son entraînement cinématographique.
Utilisez le vocabulaire de la production cinématographique. Des termes comme « mise au point déportée », « bokeh », « reflets anamorphiques », « flou de bougé sur les mouvements rapides » et « faible profondeur de champ » sont reconnus et activés par l’entraînement du modèle sur une vraie cinématographie. Ce langage exprime l’intention plus efficacement qu’une description simple.
Maîtrisez la complexité de l’environnement. Les scènes chargées, avec de nombreux éléments simultanés, produisent davantage d’artefacts temporels. Pour des résultats plus propres, limitez la description de l’environnement à trois ou quatre détails précis et laissez le modèle compléter les éléments secondaires. Le modèle gère mieux les descriptions sobres et précises que les descriptions exhaustives et denses.
Erreur à éviter : rédiger un prompt de 200 mots rempli de tous les détails imaginables. Au-delà d’une certaine densité, les prompts produisent de la confusion plutôt que de la précision. Visez entre 60 et 80 mots, avec une précision chirurgicale sur les éléments les plus importants.
Des modèles PicassoIA à associer
Seedance 2.0 atteint pleinement son potentiel lorsqu’il s’inscrit dans un flux de travail en plusieurs étapes, plutôt que d’être utilisé isolément. PicassoIA héberge tous les modèles nécessaires pour construire autour de lui des chaînes de production de niveau professionnel.
Chaîne image vers vidéo : générez une image fixe photoréaliste avec l’un des modèles de texte vers image de PicassoIA, puis transmettez-la à Seedance 2.0 ou à Seedance 1.5 Pro comme image de conditionnement pour la génération d’image vers vidéo. Vous gardez ainsi un contrôle visuel précis avant de vous engager dans l’animation, ce qui résout un problème majeur des flux purement textuels : le modèle interprète différemment, à chaque essai, les descriptions ambiguës.
Générer puis améliorer : passez votre clip dans les outils d’amélioration vidéo par IA de PicassoIA après la génération pour augmenter la résolution (upscaling) et stabiliser les petits artefacts de mouvement qui apparaissent dans les scènes exigeantes. Le résultat tient la route sur les grands écrans, sans la dégradation de la qualité visuelle que provoque le redimensionnement d’une sortie vidéo IA brute.
Prototype rapide puis finition : utilisez Seedance 2.0 Fast pour générer quinze variantes de prompt dans le temps qu’exige une seule exécution du modèle complet. Identifiez les deux ou trois prompts qui donnent la bonne direction visuelle, puis passez-les dans Seedance 2.0 standard pour une qualité de sortie maximale sur vos éléments finaux.
Pour les créateurs qui travaillent sur des projets complexes, PicassoIA propose également Kling v3 Omni Video et LTX-2.3 Pro comme moteurs de génération alternatifs à tester lorsque l’esthétique par défaut de Seedance 2.0 ne correspond pas aux exigences spécifiques du projet.
Où en est la vidéo par IA aujourd’hui
Seedance 2.0 arrive à un point d’inflexion précis. Il y a douze mois, le texte vers vidéo signifiait des clips de 3 secondes avec un scintillement visible, des visages qui se déforment et une esthétique qui se trahissait comme artificielle dès la première image. Aujourd’hui, cela signifie des scènes photoréalistes de 10 secondes, avec un audio synchronisé, qui résistent à un examen attentif sur un grand écran.
Les modèles qui se disputent la tête de ce domaine, Kling v3, Veo 3, Sora 2 Pro et Seedance 2.0, ne sont pas des jouets pour l’expérimentation occasionnelle. Ce sont des outils capables de produire en contexte professionnel, qui ont leur place dans le flux de travail de toute personne créant des contenus visuels à titre professionnel ou semi-professionnel.
Ce que ByteDance a particulièrement bien réussi avec Seedance 2.0, c’est l’intégration de l’audio natif comme sortie de premier plan, et non comme fonctionnalité ajoutée après coup. Ce choix, combiné à la qualité cinématographique du mouvement et à un coût accessible, en fait l’option de texte vers vidéo de haute qualité la plus pratique pour l’éventail le plus large de créateurs aujourd’hui.
L’écart entre la vidéo générée par IA et les séquences tournées professionnellement se referme plus vite que quiconque l’avait prévu. Les professionnels qui construisent dès maintenant leur flux de travail autour de ces outils, avant que le grand public ne rattrape son retard, se trouveront dans une position très différente de ceux qui attendent.
Commencez à créer dès maintenant
Si vous attendiez que le texte vers vidéo soit assez performant pour un travail réel, ce moment est arrivé avec Seedance 2.0. Il supprime chaque obstacle technique qui se dressait entre une idée créative et un clip vidéo finalisé.
Pas d’équipe de production. Pas de location de matériel. Pas de serveur équipé d’un GPU dans votre bureau. Pas de chaîne logicielle complexe à maintenir. Il vous faut une description claire de ce que vous voulez voir, le temps d’itérer sur quelques variantes, et un accès à PicassoIA, qui prend en charge chaque génération sur son infrastructure.
La meilleure façon de vous faire une idée précise de ce que Seedance 2.0 peut produire consiste à le tester sur un sujet propre à votre travail créatif. Prenez un concept visuel que vous avez en tête et rédigez-le sous forme de description de scène, en suivant la structure de prompt présentée dans cet article : sujet, action, environnement, éclairage, caméra. Observez le résultat.
La plupart des gens sont sincèrement surpris la première fois. Non pas parce que la vidéo IA est surprenante en soi, mais parce que Seedance 2.0 produit précisément une qualité de séquence cinématographique qui franchit le seuil entre « impressionnant pour un outil d’IA » et « une séquence que j’utiliserais dans un vrai projet ».
PicassoIA vous donne accès à Seedance 2.0, à Kling v3, à Veo 3, à Seedance 2.0 Fast et à plus de 80 autres modèles de texte vers vidéo, au même endroit. Lancez votre première génération aujourd’hui et voyez par vous-même à quoi ressemble une sortie de qualité Hollywood lorsqu’elle naît d’une simple zone de texte.