Vous n’avez besoin ni d’un directeur de casting, ni d’une équipe de tournage, ni d’un budget de production à six chiffres pour ressembler à une star de cinéma. En 2027, une seule photo et le bon modèle d’IA peuvent vous placer sur un tapis rouge, dans une scène cinématographique dramatique, ou même dans une vidéo d’avatar parlant qui paraît sortie d’un studio professionnel. La technologie est arrivée à un point où l’écart entre une personne ordinaire et un visuel de qualité hollywoodienne tient simplement à un prompt bien construit et à 60 secondes de temps de calcul.
Il ne s’agit pas de filtres gadgets. Il ne s’agit pas d’appliquer un préréglage sur votre selfie. Les modèles disponibles aujourd’hui reconstituent la physique de l’éclairage, simulent la diffusion sous-cutanée de la peau et appliquent une profondeur de champ propre à un appareil photo, avec une précision auparavant réservée aux services d’effets visuels disposant de budgets à sept chiffres. Les résultats paraissent réels parce qu’ils reposent sur les mêmes principes qui font paraître vraie la photographie réelle.
Ce que fait réellement cette technologie
L’expression « générateur de stars de cinéma par IA » sonne comme du marketing, mais le fonctionnement réel est plus intéressant que le discours commercial. Ces modèles sont entraînés sur des milliards de paires image-texte, dont beaucoup proviennent de la photographie professionnelle, du cinéma et du travail éditorial. Ils ont intégré non seulement l’apparence des choses, mais aussi la manière dont elles sont photographiées : les rapports d’éclairage utilisés en portrait, le comportement de la profondeur de champ de certains objectifs, la structure du grain de différentes pellicules, la façon dont le velours absorbe la lumière différemment du satin.
De la photo de téléphone à l’image cinématographique
Le processus de base fonctionne ainsi : le modèle prend votre description textuelle, y compris des détails sur votre apparence, la scène, l’éclairage et l’appareil photo, puis génère une image qui respecte toutes ces contraintes à la fois. Lorsque vous décrivez « une femme en robe dorée longue jusqu’au sol, debout sur un tapis rouge la nuit, objectif 85 mm, grain de film Kodak Portra 400, spot doré volumétrique venant de la gauche », le modèle génère cette image avec un éclairage physiquement plausible, une texture de tissu réaliste et un flou d’arrière-plan qui correspond au comportement réel d’un objectif 85 mm à grande ouverture.
Le résultat n’est ni un montage ni un filtre. C’est une photographie entièrement synthétisée, construite pixel par pixel selon la compréhension apprise par le modèle de ce à quoi ressemble un cinéma photoréaliste.
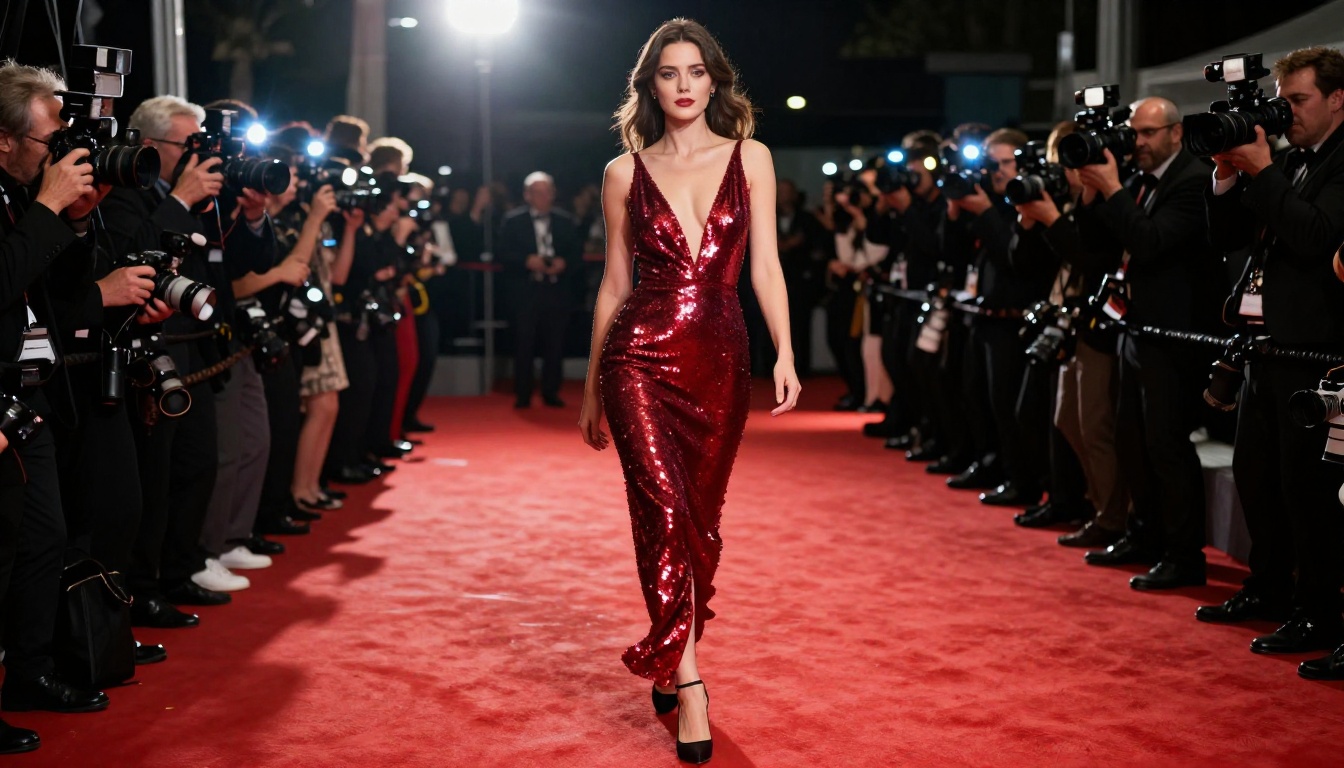
Ce n’est pas un filtre, c’est une production complète
Cette distinction a des conséquences pratiques. Un filtre d’application mobile ajuste les pixels existants de votre photo. Un modèle de génération par IA crée une nouvelle image à partir de zéro. Vous n’êtes donc pas limité par ce qui figurait sur votre photo d’origine : l’arrière-plan, l’éclairage, le costume, l’angle de prise de vue et la profondeur de champ peuvent être entièrement différents de l’image source. Vous importez un selfie et vous obtenez en retour une photographie qui n’a jamais été prise, d’une version de vous qui n’a jamais été à cet endroit, vêtue de vêtements que vous ne possédez pas, éclairée par des lumières qui n’existent pas chez vous.
💡 Pourquoi c’est important : le résultat est un contenu que vous pouvez réellement publier. Pour les réseaux sociaux, les dossiers de presse, les pochettes de musique ou les photos de comédien, la qualité atteint le niveau requis pour un usage professionnel. Cela change qui peut se permettre de produire du contenu visuel haut de gamme, c’est-à-dire désormais à peu près tout le monde.
Les meilleurs modèles pour le travail
Le choix du modèle détermine le plafond de qualité de votre résultat. Différents outils se spécialisent dans différents types de sorties : images fixes, clips animés ou vidéos de type tête parlante. Voici comment associer le bon outil à ce que vous voulez créer.
Pour l’animation du visage
Si vous voulez aller au-delà d’une image fixe et vous voir réellement bouger dans une scène cinématographique, les modèles image vers vidéo sont ce qu’il vous faut. Ils prennent une photo de votre visage et l’animent avec un mouvement réaliste, une géométrie faciale cohérente et un mouvement de caméra cinématographique.
| Modèle | Spécialité | Qualité de sortie |
|---|
| Kling Avatar v2 | Animation du visage à partir de n’importe quelle photo | 1080p |
| Dreamactor M2.0 | Mouvement du personnage à partir d’une pose de référence | 1080p |
| Wan 2.7 I2V | Image vers vidéo avec un mouvement naturel | HD |
| Hailuo 02 | Photo vers vidéo cinématographique | 1080p |
| Kling v2.6 | Texte vers vidéo cinématographique | 1080p |
Kling Avatar v2 est particulièrement puissant : importez votre photo, fournissez un prompt de mouvement ou une vidéo de référence, et il génère un clip animé réaliste où votre visage reste cohérent avec vos traits réels. Les expressions du visage, les mouvements de la tête et le comportement des yeux sont naturels, et non caricaturaux.
Dreamactor M2.0 procède autrement : vous fournissez un mouvement de référence (une autre vidéo), et il transfère ce mouvement à votre visage et à votre corps. C’est utile lorsque vous voulez appliquer à votre ressemblance un geste cinématographique précis ou un cycle de marche.
Pour les vidéos parlantes
C’est là que la technologie devient vraiment surprenante. Les modèles de synchronisation labiale et d’avatars parlants prennent une photo fixe et un fichier audio, puis génèrent une vidéo de cette personne qui parle, avec des mouvements de bouche qui correspondent précisément à l’audio et des mouvements de tête qui paraissent naturels.
- Omni Human 1.5 : prend une seule photo et génère une vidéo parlante en pied, synchronisée sur n’importe quel audio que vous fournissez. Le langage corporel, les expressions du visage et la synchronisation labiale fonctionnent ensemble pour un résultat remarquablement vivant.
- Kling Lip Sync : prend une vidéo existante et fait correspondre précisément les mouvements de la bouche à une nouvelle piste audio. Idéal lorsque vous avez un clip cinématographique et voulez changer ce que dit le personnage.
- Lipsync Precision : conçu spécifiquement pour la précision. Lorsqu’un discours ou un monologue cinématographique doit tomber parfaitement juste, ce modèle offre la synchronisation la plus serrée.
💡 La combinaison qui fonctionne : générez une image fixe cinématographique de vous, puis transmettez-la à Omni Human 1.5 avec un clip audio. Deux outils, un résultat qui ressemble à un extrait de court-métrage.
Pour la génération de scènes complètes en vidéo
Lorsque vous voulez générer une scène cinématographique complète à partir d’un prompt textuel, sans photo source, ces modèles produisent les sorties de la plus haute qualité :
- Kling v3 Omni Video : du texte à la vidéo en 1080p, avec un mouvement cinématographique, un bon respect du prompt et une physique de l’éclairage naturelle.
- Seedance 1.5 Pro : du texte à la vidéo avec génération audio intégrée. L’un des modèles les plus solides pour la production de scènes complètes.
- Sora 2 : texte vers vidéo haute fidélité, avec une excellente compréhension des prompts pour des scénarios cinématographiques complexes.
Votre moment tapis rouge en 3 étapes
Le flux de travail est plus simple que ce que la plupart des gens imaginent. Voici la démarche, de la photo de téléphone ordinaire au résultat cinématographique digne d’une star.
Étape 1 : partez de la bonne photo
Toutes les photos source ne fonctionnent pas aussi bien. La qualité de l’entrée détermine la qualité de la sortie. Pour de meilleurs résultats :
- Utilisez une photo bien éclairée où votre visage est clairement visible, sans ombres marquées
- Choisissez un arrière-plan neutre ou simple pour que le modèle se concentre sur les traits de votre visage
- Privilégiez un angle de 3/4 ou de face plutôt que des profils extrêmes
- Évitez les filtres ou retouches lourds sur la photo source : l’IA a besoin de vos traits réels
- Une résolution plus élevée est préférable, mais une photo de smartphone nette à résolution normale fonctionne très bien
Un selfie simple en bonne lumière naturelle donne systématiquement de meilleurs résultats qu’un portrait de studio fortement retouché utilisé comme image source.
Étape 2 : choisissez le format de sortie
Décidez de ce que vous voulez réellement créer avant de choisir l’outil :
Étape 3 : rédigez un vrai prompt
C’est ici que la plupart des gens perdent en qualité. Un prompt vague donne un résultat générique. Un prompt précis et détaillé donne exactement ce que vous aviez imaginé.
Faible : « Faites-moi ressembler à une star de cinéma sur le tapis rouge »
Solide : « Une femme dans ses 30 ans aux cheveux bruns ondulés, vêtue d’une robe longue jusqu’au sol en velours bordeaux profond à encolure bardot, debout sur un tapis rouge la nuit, une foule de photographes visible dans un arrière-plan bokeh doux, spots dorés volumétriques venant de la gauche et de la droite créant des reflets chauds sur ses pommettes, objectif 85 mm f/1.4 avec flou d’arrière-plan naturel, grain de film Kodak Portra 400, photographie RAW 8K photoréaliste »
La version solide indique au modèle : qui, ce qu’elle porte, où, ce que fait l’éclairage, quel objectif est utilisé et quel style esthétique adopter. Chacun de ces détails rapproche le résultat de votre vision.
Pourquoi les résultats paraissent si réels
Le réalisme des portraits générés par IA moderne provient de plusieurs facteurs techniques qui se cumulent et agissent ensemble pour produire des images que l’œil humain accepte comme des photographies.
La simulation de la lumière, pas la peinture de la lumière
Les modèles actuels simulent la lumière au lieu de la dessiner. La diffusion sous-cutanée est le phénomène par lequel la lumière traverse la surface de la peau, rebondit à l’intérieur, puis ressort, ce qui donne à la peau son éclat chaud plutôt qu’un aspect mat et opaque. Les modèles entraînés sur des données photographiques de haute qualité ont intégré ce comportement et l’appliquent correctement aux portraits. Le résultat est une peau qui ressemble à de la peau.
Les reflets spéculaires fonctionnent de la même façon. Le modèle sait que la soie réfléchit la lumière autrement que le coton mat, qu’une surface mouillée a des reflets plus nets qu’une surface sèche, et qu’un bijou en métal reflète l’environnement qui l’entoure. Ces distinctions sont calculées implicitement à partir des données d’entraînement, et non codées à la main.
Texture et micro-détails
Ce qui trahit une image truquée se situe généralement dans les micro-détails. Les modèles de génération actuels réussissent la plupart d’entre eux :
- Pores de la peau : visibles à des échelles appropriées selon la focale
- Mèches de cheveux fines : y compris les cheveux individuels, les cheveux follets et les variations naturelles de couleur
- Tissage du tissu : la structure des fils du vêtement est visible de près
- Profondeur de champ réaliste : flou d’arrière-plan qui correspond fidèlement à l’objectif et à l’ouverture spécifiés
- Grain de film : une structure de grain analogique plutôt que du bruit numérique, que l’œil perçoit comme « de la vraie photographie »
Le langage de la caméra
Les modèles entraînés sur des données cinématographiques comprennent le langage de la caméra comme un système. Un objectif 85 mm produit une compression d’arrière-plan spécifique. Un plan en contre-plongée modifie le rapport de force avec le sujet. Un contre-jour venant de l’arrière crée un halo de séparation qui paraît cinématographique. Lorsque vous précisez ces éléments dans votre prompt, le modèle les reproduit avec la même logique interne qu’un directeur de la photographie.
Des cas d’usage concrets (pas seulement pour s’amuser)
Ce qu’il y a de plus pratique dans cette technologie, c’est à quel point elle est immédiatement applicable. Ces flux de travail sont utilisés dès maintenant par de vraies personnes, à des fins professionnelles bien réelles.
Créateurs de contenu et influenceurs
Les YouTubeurs, les podcasteurs et les créateurs sur les réseaux utilisent les portraits cinématographiques générés par IA pour :
- Des miniatures de vidéo stylisées comme des affiches de film, qui surpassent systématiquement les captures d’écran classiques
- Des photos de profil qui créent une première impression immédiate et soignée
- Des bannières promotionnelles pour des formations, du merchandising et des communautés payantes
- Des photos de dossier de presse pour les partenariats de marque et les apparitions dans les médias
Une séance photo professionnelle coûte entre 300 $ et 3 000 $ selon le photographe. Un ensemble de portraits cinématographiques générés par IA coûte une fraction de ce prix et livre des résultats en quelques minutes, et non en plusieurs jours.
Professionnels du personal branding
Toute personne qui construit une marque personnelle en ligne a besoin de visuels cohérents et de haute qualité sur toutes les plateformes. La génération cinématographique par IA vous permet de :
- Créer une identité visuelle unifiée qui paraît haut de gamme et réfléchie
- Générer des images adaptées à chaque contexte : conférencier, leader d’opinion, expert au ton décontracté
- Renouveler votre image sans reprendre rendez-vous avec un photographe chaque fois qu’une plateforme modifie ses dimensions recommandées
Musiciens et artistes visuels
Pochettes d’album, photos de presse et images fixes de clips musicaux profitent toutes de la génération cinématographique par IA. Kling v2.6 et Seedance 1.5 Pro peuvent produire de courts clips cinématographiques à partir d’une photo ou d’un prompt, qui servent de teasers de clips, de reels pour les réseaux sociaux et de contenus promotionnels, sans nécessiter d’équipe de production vidéo.
Jusqu’où peut-on vraiment aller ?
Réponse honnête : très bien, avec des limites spécifiques qu’il vaut la peine de connaître.
Ce que l’IA actuelle gère extrêmement bien
- Éclairage et atmosphère : ambiances cinématographiques, lumière de l’heure dorée, dispositifs de studio complexes
- Vêtements et mode : texture des tissus, tombé réaliste, rendu des matières à un très bon niveau
- Narration environnementale : tapis rouges, galas, décors de studio, lieux extérieurs
- Qualité de la peau : variations naturelles de teint, éclat sous-cutané réaliste, détail réaliste des pores
- Composition : règle des tiers, lignes directrices et cadrage cinématographique émergent naturellement de bons prompts
Là où il reste des lacunes
| Difficulté | État actuel |
|---|
| Ressemblance exacte avec une photo source | Solide, mais pas toujours parfaite |
| Mains dans des positions complexes | Erreurs occasionnelles, une nouvelle tentative les corrige en général |
| Visage cohérent sur plusieurs plans | Nécessite un contrôle du seed et des prompts détaillés |
| Rendu du texte dans les images | Peu fiable sans techniques spécifiques |
| Scénarios d’éclairage extrêmes | Les scènes très sombres ou très lumineuses peuvent perdre des détails |
Pour un usage professionnel, les images générées gagnent à faire l’objet d’une rapide relecture. Le bon modèle, un prompt solide et, parfois, une deuxième génération avec un seed différent résolvent la plupart des problèmes.
💡 Cohérence entre les plans : si vous avez besoin de plusieurs images avec le même visage, fixez un numéro de seed et décrivez le visage de façon identique dans chaque prompt. C’est la méthode qui donne les résultats les plus cohérents sur un ensemble d’images.
Créez votre propre look cinématographique
Le fait de ressembler à une star de cinéma n’a jamais été aussi accessible. Une seule photo et un prompt bien construit suffisent pour produire un contenu cinématographique qui exigeait, il y a encore quelques années, une équipe de production complète et un budget conséquent.
Les modèles sur PicassoIA sont prêts à l’emploi dès maintenant, et l’éventail de ce que vous pouvez créer est large : un portrait de tapis rouge saisissant, un avatar parlant animé avec votre visage, une scène vidéo cinématographique construite entièrement à partir d’une description textuelle. Les outils sont là pour chaque format :
- Images fixes cinématographiques : génération texte vers image avec des prompts de portrait détaillés
- Scènes animées à partir de votre photo : Kling Avatar v2 ou Dreamactor M2.0
- Vidéos d’avatars parlants : Omni Human 1.5 pour le pipeline photo vers vidéo parlante le plus réaliste
- Scènes vidéo cinématographiques complètes : Kling v3 Omni Video ou Seedance 1.5 Pro pour une production pilotée par texte
Choisissez le scénario qui correspond à ce que vous voulez créer. Rédigez le prompt le plus précis possible. Lancez la génération. L’IA s’occupe du reste. Votre moment de star de cinéma n’est qu’à une génération de distance, et cela prend moins de temps que de réserver un photographe.


